
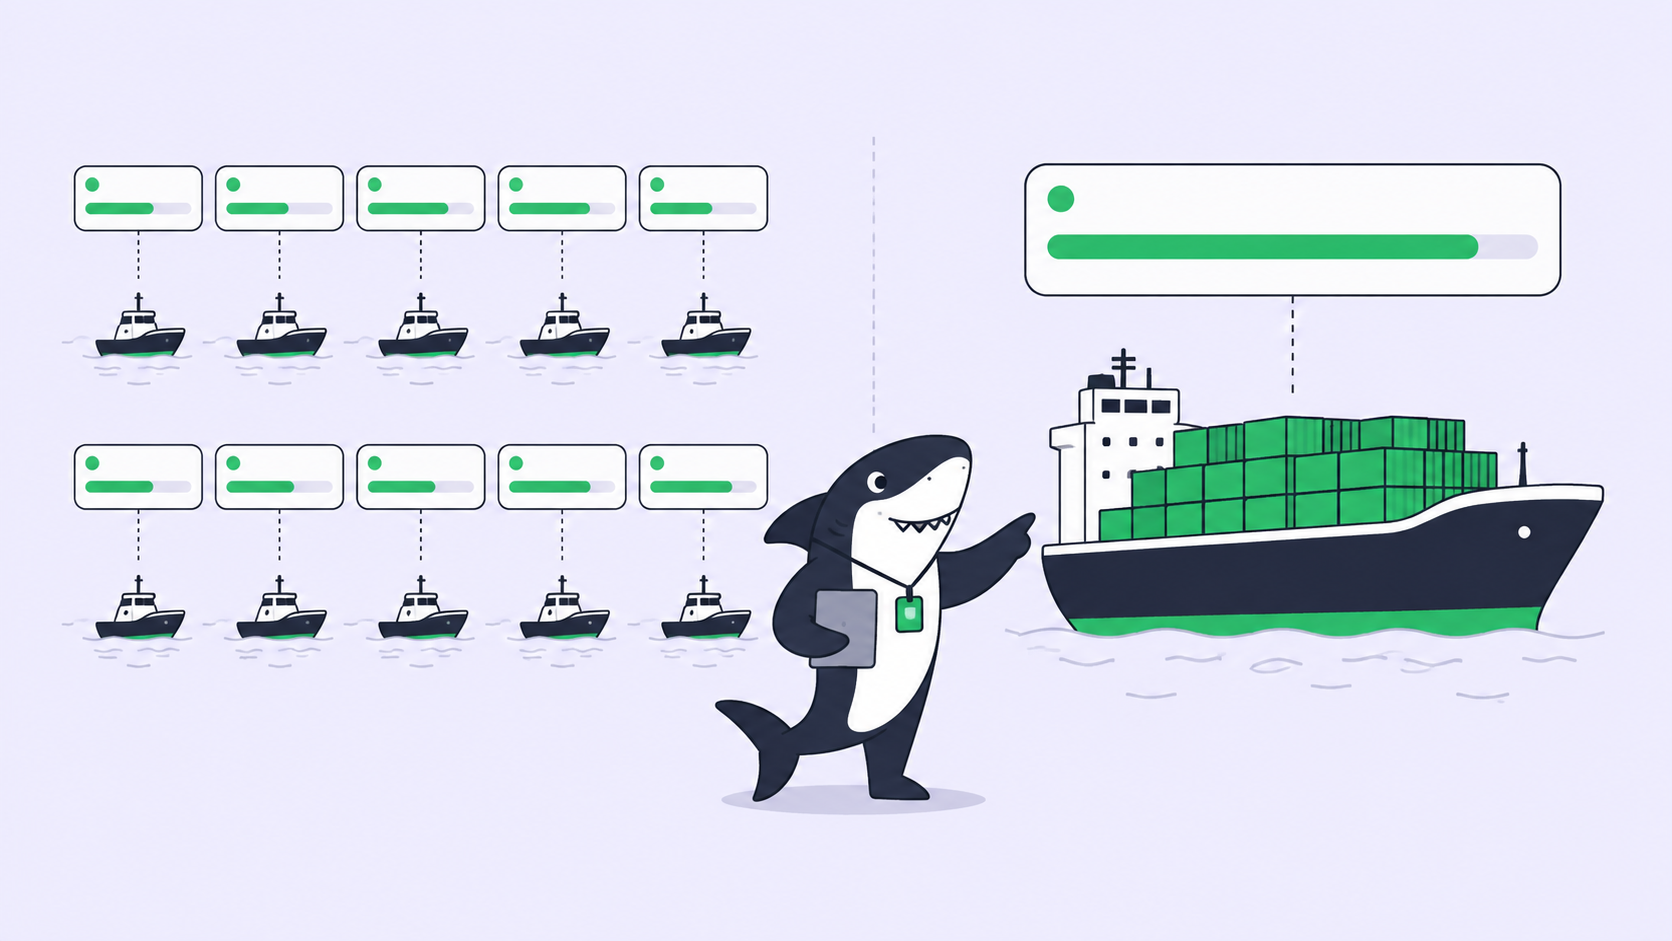
คุณมีจำนวนผู้ตรวจสอบที่จำกัด และตั้งแต่ 2026-09-22 เป็นต้นมา ค่าโมเดลก็ไม่ได้ตัดสินใจอะไรแทนคุณอีกต่อไป GPT-6 Luna ตั้งราคาที่ $0.10 ต่อล้านโทเค็นอินพุต และ $0.50 ต่อล้านเอาต์พุต API id คือ gpt-6-luna ส่วน Claude Opus 5.5 ตั้งราคาที่ $4 และ $20 API id คือ claude-opus-5-5 นั่นคือส่วนต่าง 40 เท่าในทั้งสองด้านของมิเตอร์ ซึ่งเป็นการคำนวณของเราจากราคาตั้งของทั้งสองผู้ให้บริการเอง และมันเปลี่ยนคำถามที่เคยเป็นแค่เรื่องทฤษฎีให้กลายเป็นการตัดสินใจจัดตารางงานรายสัปดาห์ ด้วยงบเท่ากัน คุณจะรัน Agent ราคาถูกสิบตัวหรือตัวเดียวราคาแพง?
การตั้งค่าทั้งสองแบบไม่ใช่สิ่งที่ใช้แทนกันได้ สิ่งที่แยกความแตกต่างไม่ใช่คุณภาพของโมเดล และมันจะปรากฏให้เห็นตอนท้ายของการรัน ไม่ใช่ตอนเริ่ม เพราะแต่ละแบบวางปริมาณงานที่แตกต่างกันไว้ตรงหน้าคน
คณิตศาสตร์ที่ทำให้คำถามนี้เป็นจริง
OpenAI เผยแพร่ต้นทุนต่อภารกิจไว้ข้าง ๆ คะแนน ซึ่งมีประโยชน์กว่ารายการราคา บน DeepSWE 1.1 เมื่อตั้ง reasoning effort สูงสุด Luna ทำคะแนนได้ 66.6% ซึ่ง OpenAI อธิบายว่าเทียบเคียงได้กับ Claude Opus 5 และ Fable 5 ที่ effort ระดับกลาง โดยมีต้นทุนต่อภารกิจต่ำกว่า Opus 5 อยู่ 93% และต่ำกว่า Fable 5 อยู่ 96%
ลองคำนวณจากตัวเลขแรกย้อนกลับ หนึ่งภารกิจของ Opus 5 จะเทียบเท่าประมาณสิบสี่ภารกิจของ Luna ดังนั้นการรัน Luna สิบครั้งจึงมีต้นทุนประมาณเจ็ดส่วนสิบของการรัน Opus 5 เพียงครั้งเดียวบน harness นั้น การคูณนี้เป็นของเรา ซึ่งได้มาจากตัวเลข 93% ที่ OpenAI ระบุไว้
Anthropic ระบุว่า Opus 5.5 มีต้นทุนการรันต่ำกว่า Opus 5 อยู่ 40% เมื่อนำมาใช้ อัตราส่วนจะลดลงเหลือประมาณเก้าต่อหนึ่ง ตัวเลขนั้นเป็นการนำการวัดของสองผู้ให้บริการที่ทำบน harness ต่างกันมาเชื่อมต่อกัน ดังนั้นให้มองเป็นทิศทางมากกว่าจะเป็นตัวเลขที่แน่นอน เพราะไม่ว่าคุณจะคำนวณแบบไหน การลองสิบครั้งแบบราคาถูกกับการลองหนึ่งครั้งแบบราคาแพงตอนนี้มีต้นทุนพอ ๆ กัน
| GPT-6 Luna | Claude Opus 5.5 | |
|---|---|---|
| API id | gpt-6-luna |
claude-opus-5-5 |
| อินพุต / เอาต์พุตต่อ 1M | $0.10 / $0.50 | $4 / $20 |
| อินพุตที่แคชไว้ | อ่านถูกลง 90% | อ่าน $0.20 เขียน $5 |
| หน้าต่างบริบท | 1M | 1M |
| คำกล่าวอ้างเรื่องงานระยะยาวของผู้ให้บริการ | ไม่มีระบุ | ทำงานต่อเนื่องได้ 18+ ชั่วโมง |
| ดัชนี Artificial Analysis | 37 | 58 จัดอันดับ #1 จาก 212 |
มีข้อควรระวังสองข้อที่ควรมากับตารางนั้น พาดหัวข่าวของ OpenAI คือ Sol และ Luna ต่างก็ถูกกว่า GPT-5.6 ราคา promotional อยู่ 50% และคำว่า "promotional" ก็เป็นคำของ OpenAI เอง การเปรียบเทียบนี้เทียบกับอัตราที่ลดราคาแล้ว ไม่ใช่ราคาตั้ง และโพสต์เปิดตัวทั้งสองชิ้นก็ไม่ใช่การเทียบแบบตัวต่อตัว ผู้ให้บริการทั้งสองรายรายงานคะแนน AutomationBench ในวันเดียวกัน แต่ใช้ harness เวอร์ชันต่างกันและ effort ระดับต่างกัน การนำเปอร์เซ็นต์สองตัวนั้นมาไว้ในแถวเดียวกันจะสร้างการเปรียบเทียบที่ทั้งสองห้องแล็บไม่ได้ทำ อัตราส่วนต้นทุนต่อภารกิจข้างต้นยังใช้ได้ เพราะมันมาจากการวัดภายในของผู้ให้บริการรายเดียว
สามรูปแบบที่ดูเหมือนเป็นการแลกเปลี่ยนเดียวกัน
"สิบเอเจนต์หรือหนึ่ง" จริง ๆ แล้วคือสามรูปแบบ และแต่ละแบบมีพฤติกรรมต่างกันในขั้นตอนการตรวจสอบ
| รูปแบบ | สิ่งที่มาถึงขั้นตอนตรวจสอบ | ใครเลือกผู้ชนะ | เหมาะเมื่อ |
|---|---|---|---|
| Agent ราคาถูกสิบตัว สิบ Task | สิบ diff สิบการตัดสินใจ | คน สิบครั้ง | งานค้างมีปริมาณมากและแต่ละรายการยอมรับได้อย่างเป็นอิสระ |
| Agent ราคาถูกสิบตัว หนึ่ง Task | หนึ่ง diff หนึ่งการตัดสินใจ | ชุดทดสอบของคุณ | เครื่องสามารถจัดอันดับความพยายามได้โดยไม่ต้องมีคนอ่าน |
| Agent ราคาแพงหนึ่งตัว หนึ่ง Task | หนึ่ง diff หนึ่งการตัดสินใจ | คน หนึ่งครั้ง | ระยะยาว สัญญาณอัตโนมัติอ่อน หรือการเปลี่ยนแปลงที่ต้องใช้วิจารณญาณตลอดทาง |
แถวกลางคือสิ่งที่การลดราคาปลดล็อกได้จริง และเป็นแถวที่ทีมส่วนใหญ่ข้ามไป การรัน Task เดิมสิบครั้งแล้วเก็บความพยายามที่ผ่าน typecheck การทดสอบ และ build เป็นกลยุทธ์ที่เพิ่งจะจ่ายไหวเมื่อการลองหนึ่งครั้งไม่ต้องเสียเงินจริงอีกต่อไป ด้วยอัตราผ่าน benchmark ใกล้สองในสาม หนึ่งในสามของการลองเดี่ยวจะล้มเหลว หากการลองแต่ละครั้งล้มเหลวอย่างเป็นอิสระจากกัน การลองสิบครั้งก็แทบจะไม่ล้มเหลวทั้งหมด แต่พวกมันไม่ได้ล้มเหลวอย่างอิสระจากกัน เพราะงานที่มีข้อกำหนดคลุมเครือหรือขาด fixture จะทำให้ทุกความพยายามพ่ายแพ้ในแบบเดียวกัน Fan-out ซื้อความแปรปรวนให้คุณ ไม่ใช่การรับประกัน
แถวแรกคือแถวที่ทีมส่วนใหญ่เอื้อมไปหาจริง ๆ และเป็นแถวที่แพง ไม่ใช่แพงเป็นเงิน แต่ Agent สิบตัวบนสิบ Task สร้างสิบ diff และทุกอันต้องมีคนอ่าน ทำความเข้าใจว่า Agent เลือกอะไร และรับผิดชอบในการ merge มัน ต้นทุนนั้นไม่ได้ลดลงเมื่อ 2026-09-22 และไม่มีโมเดลใดที่เปิดตัวมาแตะต้องมันได้ เราเคยเขียนเกี่ยวกับทำไมการตรวจสอบโดยมนุษย์จึงเป็นคอขวดในงาน agent แบบขนาน และเกี่ยวกับหนึ่งวันทำงานของคนรองรับวันทำงานของ agent ได้กี่วัน การคำนวณตรงนั้นไม่เปลี่ยนไปเพราะโทเค็นที่ถูกลง
Agent สิบตัวบน Luna ไม่ใช่ผลลัพธ์สิบเท่า แต่เป็นงานที่มาถึงสิบเท่า โมเดลที่ถูกลงซื้อความพยายามได้ แต่มันไม่ได้ซื้อความสามารถในการตรวจสอบ และสองสิ่งนี้สับสนกันได้ง่ายเมื่อใบแจ้งหนี้เป็นตัวเลขเดียวที่ถูกจับตาดู
ต้นทุนต่อการเปลี่ยนแปลงที่ได้รับการยอมรับคือตัวเลขที่เทียบกันได้
ต้นทุนต่อการเปลี่ยนแปลงที่ได้รับการยอมรับคือค่าใช้จ่ายที่ทีมของคุณจ่ายไปกับ inference สำหรับทุก diff ที่มีคนอ่านและยอมรับจริง ๆ มันเป็นตัวเลขต้นทุนของ agent ตัวเดียวที่เชื่อมโยงกับงานที่ส่งมอบได้ เพราะความพยายามที่ไม่มีใครตรวจสอบไม่ได้ส่งมอบอะไรเลย
นิยามนี้จัดเรียงสามรูปแบบได้ทันที Fan-out บนหนึ่ง Task กระจายความพยายามสิบครั้งไปสู่การตัดสินใจตรวจสอบหนึ่งครั้ง ดังนั้นความพยายามที่ถูกลงจะลดต้นทุนต่อการเปลี่ยนแปลงที่ได้รับการยอมรับแบบเส้นตรง ส่วนความกว้างบนสิบ Task กระจายความพยายามหนึ่งครั้งไปสู่การตัดสินใจตรวจสอบหนึ่งครั้งซ้ำสิบรอบ ดังนั้นความพยายามที่ถูกลงจะลดเส้นค่า inference ขณะที่เส้นการตรวจสอบคงที่และกลายเป็นข้อจำกัดแทน ความลึกบน Agent ราคาแพงหนึ่งตัวซื้อโอกาสที่สูงขึ้นว่าความพยายามเดียวที่อยู่ตรงหน้าผู้ตรวจสอบของคุณจะเป็นอันที่คุ้มค่าแก่การ merge
ยังมีผลกระทบที่สองซึ่งจะปรากฏเฉพาะในทางปฏิบัติ การลองสิบครั้งแบบราคาถูกกับการลองหนึ่งครั้งแบบราคาแพงให้ความรู้สึกในการทำงานไม่เหมือนกัน Artificial Analysis วัดโมเดลเหล่านี้ในเวอร์ชัน max reasoning ได้ 124.23 วินาทีถึงโทเค็นแรกสำหรับ Luna และ 102.15 วินาทีสำหรับ Sol ซึ่งเป็นตัวเลขจากบุคคลที่สามสำหรับเวอร์ชัน max โดยเฉพาะ และควรตรวจสอบยืนยันก่อนจะวางแผนโดยอิงกับมัน Agent สิบตัวที่แต่ละตัวเงียบไปสองนาทีก่อนจะสร้างตัวอักษรออกมาหนึ่งตัวไม่ใช่ไปป์ไลน์ที่เร็ว แต่เป็นสิบการรันที่ดูเหมือนค้างพร้อมกันหมด ซึ่งเป็นปัญหาเรื่องสถานะ ไม่ใช่ปัญหาเรื่องโมเดล
คู่การตัดสินใจ
ใช้ Agent ราคาถูกสิบตัวเมื่อเครื่องเป็นผู้ตัดสิน นั่นหมายความว่า Task นั้นมีสัญญาณการยอมรับจริงที่ทำงานได้โดยไม่ต้องมีคน เช่น การทดสอบที่วันนี้ล้มเหลวและต้องผ่าน, typecheck, build, กฎ lint, สคริปต์จำลองปัญหา งาน triage, การติดป้ายกำกับ, การวางโครงสร้างการทดสอบ และการ refactor เชิงกลไกเข้าเกณฑ์ทั้งหมด เช่นเดียวกับการเปลี่ยนแปลงใด ๆ ที่คำถามว่า "มันได้ผลไหม" เป็นคำสั่งมากกว่าความคิดเห็น
ใช้ Agent ราคาแพงหนึ่งตัวเมื่อคนเป็นผู้ตัดสิน หากการยอมรับการเปลี่ยนแปลงต้องอาศัยการอ่านโค้ดและสร้างมุมมอง ความพยายามที่เพิ่มขึ้นก็ไม่ได้ช่วย แต่จะทวีการอ่านให้มากขึ้นเป็นเท่าตัว เช่นเดียวกันกับงานระยะยาว Anthropic ระบุว่า Opus 5.5 ทำงานต่อเนื่องได้ 18 ชั่วโมงขึ้นไป และการรันที่ยึดเป้าหมายไว้ได้ตลอดทั้งบ่ายมีค่ามากกว่าสิบการรันที่แต่ละอันเริ่มต้นใหม่จากความเข้าใจบางส่วนแบบเดียวกัน
อย่าใช้ fan-out เพื่อเลี่ยงการเขียนสัญญาณการยอมรับ สิบ diff ที่ดูสมเหตุสมผลโดยไม่มีผู้ตัดสินอัตโนมัตินั้นแย่กว่าหนึ่ง diff เพราะการเลือกระหว่างสิบ diff ที่ดูสมเหตุสมผลเป็นงานที่ยากกว่าการตรวจสอบอันเดียว และมันเป็นงานที่ตกลงบนบ่าของคนที่คุณพยายามปกป้อง
สิ่งที่การตั้งค่าแบบกว้างต้องการจากเลเยอร์ด้านบน
Agent สิบตัวที่รันพร้อมกันเป็นปัญหาเรื่องการประสานงานก่อนที่จะเป็นปัญหาเรื่องต้นทุน ชิ้นส่วนต่าง ๆ เป็นที่รู้จักกันดี: แต่ละการรันอยู่ใน worktree ของตัวเอง เพื่อที่ว่า Agent สองตัวแก้ไฟล์เดียวกันจะไม่กลายเป็นเหตุการณ์, หนึ่ง Assignee ต่อหนึ่ง Task เพื่อให้ความเป็นเจ้าของไม่กำกวม, และสถานะที่แยกแยะระหว่าง running, waiting และ failed ได้
Agent กำหนดว่างานควรถูกจัดการอย่างไร Computer จัดหาโฮสต์และทรัพยากรท้องถิ่น Runtime ดำเนินเซสชัน ส่วน Task ยังคงเป็นบันทึกที่ใช้ร่วมกัน เมื่อการรันสิบครั้งเสร็จสิ้นห่างกันภายในหนึ่งชั่วโมง ส่วนสุดท้ายนี่แหละที่ทำให้ชั่วโมงนั้นไม่กลายเป็นการค้นหาของในสิบเทอร์มินัล
การรัน Luna ที่เสร็จสิ้นควรส่งคืนอะไรประมาณนี้กลับไปยัง Task ของมัน ไม่ใช่ไปยังบันทึกเซสชันส่วนตัว:
SH-312  Add retry with backoff to the webhook dispatcher
Runtime   gpt-6-luna (fan-out, 8 attempts, 3 passed the suite)
Selected  attempt 6, smallest diff of the passing set
Evidence  typecheck ok, 214 tests pass, build ok, coverage +0.4%
Known limit  no test for the 429 path, dispatcher is not idempotent yet
Status    Ready for review, waiting on a human
บรรทัด Selected คือส่วนที่สำคัญ เพราะมันบอกว่าอะไรเป็นตัวตัดสิน ผู้ตรวจสอบจะได้รู้ว่ากำลังยืนยันการเลือกของเครื่องหรือกำลังเลือกเอง การลองสิบครั้งที่ไม่มีบันทึกการเลือกคืองานสิบเท่าที่แสร้งทำเป็นหนึ่ง Task
คำตอบ
Agent ราคาถูกสิบตัวส่งมอบได้มากกว่าเมื่อชุดทดสอบเป็นตัวตัดสินและมีงานค้างมากพอที่จะทำให้พวกมันไม่ว่าง ส่วน Agent ราคาแพงหนึ่งตัวส่งมอบได้มากกว่าเมื่อการตัดสินใจยอมรับเป็นของคน ระยะยาว หรือสัญญาณอัตโนมัติอ่อน ทีมส่วนใหญ่ต้องการทั้งสองแบบ โดยเลือกใช้ตามประเภทของ Task มากกว่าตามความชอบ ซึ่งเป็นข้อโต้แย้งในการจับคู่โมเดลกับบทบาทของ agent
ไม่ว่าการตั้งค่าแบบไหนก็ไม่ได้เปลี่ยนขั้นตอนสุดท้าย Agent ค้นคว้า ลงมือทำ ทดสอบ และรายงาน ส่วนคนกำหนดทิศทาง มอบอำนาจ และยอมรับผลลัพธ์ ราคาโมเดลขยับ 40 เท่าในวันเดียว แต่จำนวนการเปลี่ยนแปลงที่ทีมของคุณสามารถยอมรับได้อย่างมีความรับผิดชอบไม่ได้ขยับเลย
หากคุณรัน agent หลายตัวอยู่แล้ว Sharkly มอบที่เดียวให้คุณเก็บบริบท ความคืบหน้า อุปสรรค ผลลัพธ์ และการตรวจสอบโดยมนุษย์ให้มองเห็นได้ตั้งแต่คำขอจนถึงการปล่อย ไม่ว่า runtime ใดจะเป็นตัวสร้าง diff


