
Özet: GPT-6.2 hız limitleri API'de Astra ve Sol için aynıdır: Build katmanında 5.000 RPM ve 1.000.000 TPM, Launch'ta 10.000 RPM ve 4.000.000 TPM, Grow'da 15.000 RPM ve 40.000.000 TPM. Limitler organizasyon ve proje başına uygulanır, dolayısıyla tek bir anahtardaki tüm ajanlar aynı limiti paylaşır. Ajan ekiplerinde önce dakikadaki token (TPM) tükenir, istek sayısı (RPM) değil.
OpenAI, 17 Kasım 2026'da GPT-6.2 Astra ve GPT-6.2 Sol modellerini duyurdu. Astra, en zorlu işler için frontier model; Sol ise daha ucuz, günlük kullanım modeli ve OpenAI'ın kendi ifadesiyle "ölçekte ajanları çalıştırmak" için tasarlandı.
Tek bir ajan nadiren limite takılır. Tek bir API anahtarında çalışan altı ajan öğle vaktine kadar limite ulaşır. Bu rehber GPT-6.2 hız limitlerini, Codex plan limitlerini ve ajan ekibinizi kuyruğa nasıl alacağınızı (hata vermeden önce) anlatacak. Halihazırda birden fazla kodlama ajanı çalıştırıyorsanız, Sharkly, aynı anda kaç tanesinin çalışacağını ayarladığınız yerdir.
Kullanım katmanına göre GPT-6.2 hız limitleri
GPT-6.2 Astra ve GPT-6.2 Sol, OpenAI'ın Sol model sayfasında ve Astra model sayfasında tek bir standart hız limiti tablosunu paylaşır. RPM dakikadaki istek sayısı; TPM dakikadaki token sayısıdır. Hangisini önce tüketirseniz o sizi durdurur.
| Katman | Hak kazanma (toplam kredi alımı) | Aylık kullanım limiti | RPM | TPM |
|---|---|---|---|---|
| Build | $5 | $500 | 5.000 | 1.000.000 |
| Launch | $100 | $5.000 | 10.000 | 4.000.000 |
| Grow | $500 | $200.000 | 15.000 | 40.000.000 |
Hak kazanma ve aylık kullanım sütunları OpenAI'ın hız limitleri rehberinden alınmıştır. Toplam kredi alımlarınız her eşiği aştığında katmanınız otomatik olarak yükselir. Aylık kullanım limiti, kendinizin belirlediği harcama limitlerinden bağımsız ayrı bir sınırdır.
Astra, token başına dört kat daha pahalıdır (milyon başına $8 girdi, $40 çıktı; Sol için $2 ve $10), ancak hız limiti aynıdır. Ne zaman limite takılacağınız, ajanlarınızın ne kadar token tükettiğine bağlıdır.
GPT-6.2 kullanım limitleri Codex'te nasıl çalışır
Ajanlarınız bir API anahtarı yerine ChatGPT planı üzerinden Codex ile çalışıyorsa, farklı bir limit uygulanır. OpenAI'ın Codex fiyatlandırma sayfası, her beş saatlik pencere için yerel mesaj sayısını aralık olarak verir; çünkü görev boyutu her mesajın maliyetini değiştirir.
| Model | Plus | Standard Business |
|---|---|---|
| GPT-6.2 Astra | 6 ila 50 | 6 ila 50 |
| GPT-6.2 Sol | 17 ila 180 | 17 ila 180 |
| GPT-6.1 Sol | 15 ila 160 | 15 ila 160 |
| GPT-6 Astra | 5 ila 45 | 5 ila 45 |
Ajan ekipleri için dört ayrıntı önemlidir:
- Pro planlarında şu anda beş saatlik bir limit yok, ancak haftalık limitler yine de geçerli olabilir.
- Yerel mesajlar ve bulut sohbetleri tek bir kotayı paylaşır. Bir bulut görevi, yerel bir mesajdan daha fazlasını kullanabilir.
- Hız kotaya mal olur. Hızlı mod, GPT-6.2 modellerinde dahili kullanımın 2 katını; Ultrafast ise 6 katını harcar.
- Uzun oturumlar mesaj başına daha pahalıdır. OpenAI, daha fazla bağlam tutan görevlerin kotanın "önemli ölçüde daha fazlasını" kullandığını belirtir.
Bir deposunun yarısını okumuş bir ajan her turda büyük bir bağlam gönderir; dolayısıyla mesaj sayısı hızla düşer. Aynı deseni Anthropic'in planları için Claude Code kullanım limitleri yazımızda ele almıştık ve Codex Pro limit kesintisine verilen tepki de aynı mantığı izliyor.
Bir ajan ekibini neden TPM sınırlar, RPM değil
Bir kodlama ajanı binlerce küçük istek göndermez; birkaç büyük istek gönderir. Her turda şimdiye kadarki konuşmayı yeniden gönderir: talimatlar, okuduğu dosyalar, araç çıktıları ve kendi önceki akıl yürütmeleri.
Örnek bir ajan düşünelim: turda 80.000 girdi token'ı ve dakikada 6 tur. Bu, 6 RPM ve yaklaşık 480.000 TPM demektir. Build katmanına göre:
- RPM: 5.000'in 6'sı kullanılmış. Hiç yakın değil.
- TPM: 1.000.000'ın 480.000'i kullanılmış. İki ajan bunu doldurur.
Sizin sayılarınız farklı olacaktır; oran aynı kalacaktır. Ajanlar token-yoğun ve istek-azdır. Bu örnek ajan için ham üst sınır, Build'de proje başına iki ajan, Launch'ta sekiz ajandır. Aşağıdaki boyutlandırma adımlarındaki yüzde 30 payı korursanız bu, Build'de bir ajana ve Launch'ta beş ajana düşer. Grow'da hız limiti artık darboğazınız olmaz ve $200.000 aylık sınır ya da kendi bütçeniz devreye girer.
Limitler organizasyon genelinde paylaşılır
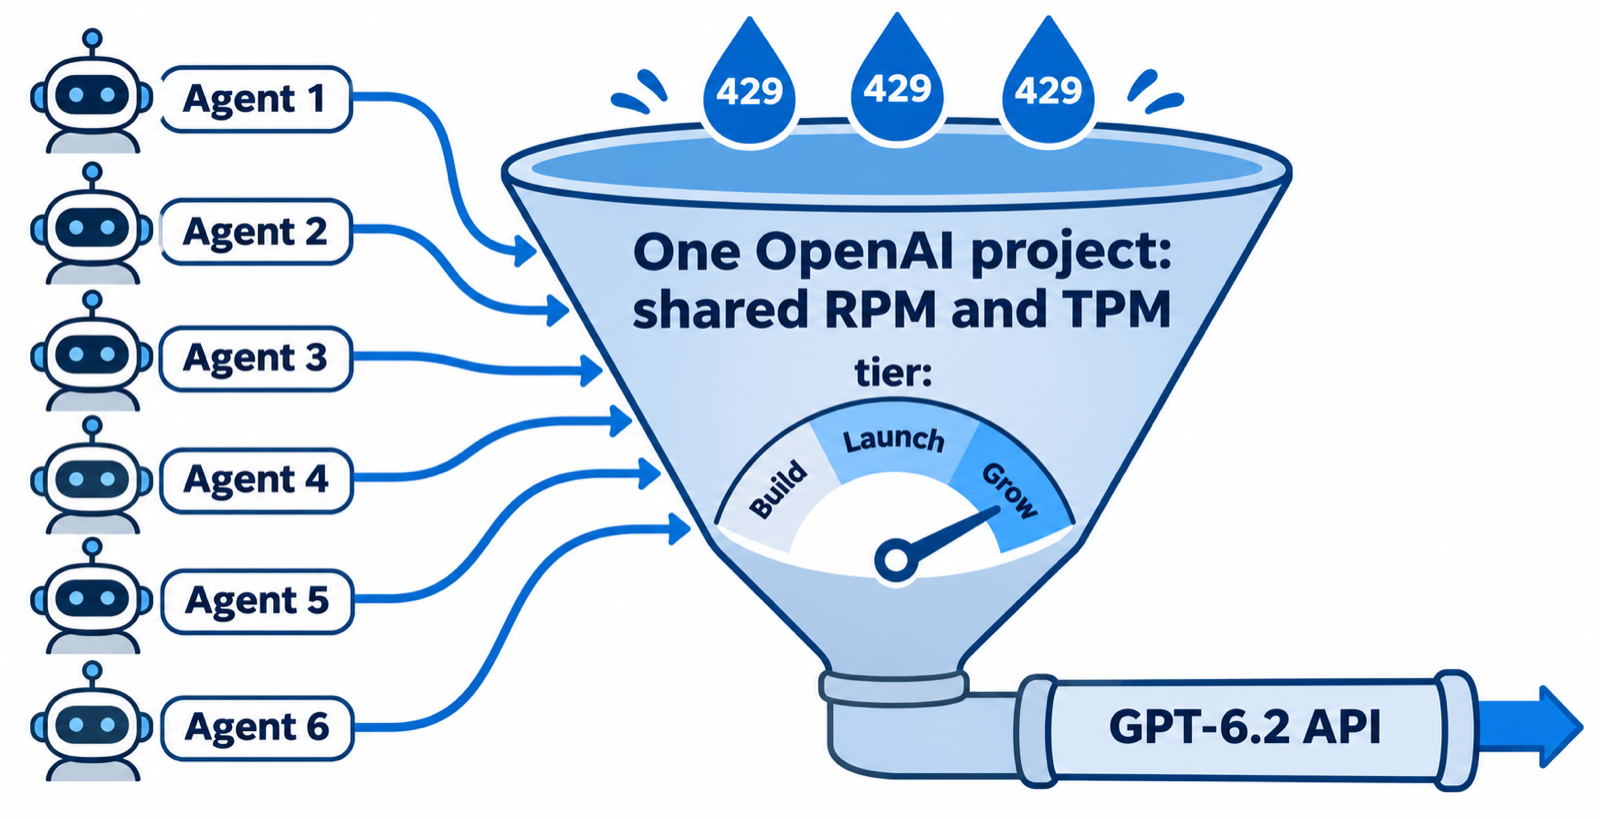
OpenAI hız limitlerini kullanıcı başına değil, organizasyon ve proje düzeyinde tanımlar. Tek bir projeden anahtar kullanan her ajan aynı havuzdan çeker. Bazı model aileleri ayrıca limitler sayfanızda listelenen paylaşılan bir limite sahiptir; böylece bir modele giden trafik başka bir modelin limitine de sayılabilir.
Ajan eşzamanlılığını GPT-6.2 katmanınıza göre nasıl boyutlandırırsınız
Çözüm, aynı anda kaç ajanın çalışacağını sınırlamaktır; böylece fazla iş, API'de çarpışmak yerine kuyrukta bekler. İşe yarayan sıralama şöyle:
- OpenAI platformunda Ayarlar, Organizasyon, Limitler bölümünden katmanınızı bulun.
- Tek bir gerçek ajan çalıştırmasını ölçün. Runtime'ınızın kullanım çıktısından tur başına girdi token'ı ve dakikadaki tur sayısını not edin.
- TPM'inizi tek bir ajanın TPM'ine bölün ve zirveler için yüzde 30 pay bırakın.
- Bu sayıyı, projeyi kullanan tüm ajanlar için eşzamanlılık sınırı olarak belirleyin.
- Bir hafta boyunca 429 hatalarını izleyin, sonra sınırı tek tek adımlarla yükseltin.
Sharkly'de her Ajan için Maksimum eşzamanlılık (atanan görevler) ayarı, dakika cinsinden Maksimum çalışma süresi ve saat cinsinden Kuyruk zaman aşımı bulunur. Sınır dolduğunda, yeni görevler bir yer açılana kadar Kuyruğa alındı durumunda bekler. Sohbetler aynı limiti paylaşabilir; böylece bir konuşma sınırı gizlice aşamaz.

Bir Computer'ın da kendi görev eşzamanlılık sınırı vardır. Sharkly dokümantasyonu, daha yüksek eşzamanlılığın daha fazla CPU, bellek, disk, sağlayıcı kapasitesi ve depo bant genişliği kullandığını belirtir; bu yüzden yükseltmeyi yalnızca mevcut yük sorunsuz çalışırken yapın.
Ajanları OpenAI projelerine dağıtın
Proje düzeyindeki limitler, ajan gruplarını ayırmanıza olanak tanır. İnceleme ajanlarınıza bir OpenAI projesi, toplu yeniden düzenleme (refactor) ajanlarınıza başka bir proje verin. Böylece kontrolden çıkan bir refactor, kendi proje limitine takılır ve inceleme ajanlarını aç bırakmaz. Organizasyon limiti yine de toplamı sınırlar; yani bu öncelik belirler, kapasite eklemez.
Bir API anahtarıyla kimlik doğrulayan bir Runtime için, anahtarı Ajan üzerinde bir ortam değişkeni olarak ayarlayın. Sharkly, Ajan ortam değişkenlerini ajan süreci başlarken içine enjekte eder. Her ajan grubuna kendi OpenAI projesinden bir anahtar verin; böylece trafiği doğru limite düşer.
Görev başına token'ı izleyin
Sharkly'deki Ajan başlığı, atanan görevleri, toplam çalıştırma sayısını ve kullanılan token'ı gösterir. Yalnızca aylık toplamı değil, görev başına token'ı okuyun. Diğerlerinin üç katı token yakan bir görev türü, Astra yerine Sol'a geçmek veya görev tanımını sıkılaştırmak için ilk adayınızdır.
Toplu işleri yoğun olmayan saatlere kaydırın
Her Ajanın Runtime ayarları, işleri yoğun olmayan saatlere planlamak için bir Çalışma saatleri anahtarı içerir. Bunu test üretimi, bağımlılık güncellemeleri ve dokümantasyon taramalarına yönlendirin. Bu görevler gece boyunca çalışır ve gündüz kapasitesini, insanların beklediği işlere bırakır.
GPT-6.2 429 hatası nasıl ele alınır
Bir sınır koysanız bile ara sıra bir 429 göreceksiniz. OpenAI'ın rehberi ne yapılması gerektiği konusunda nettir:
Retry-Afterbaşlığı mevcutsa ona uyun ve onu asgari değer olarak kabul edin.- Başlık yoksa, rastgele jitter içeren üstel geri çekilme (exponential backoff) kullanın.
- Ne kadar yaklaştığınızı görmek için
x-ratelimit-remaining-tokensvex-ratelimit-reset-tokensbaşlıklarını okuyun. - Yeniden denemeleri iç içe geçirmeyin: kodunuz yeniden deneme yapıyorsa SDK'nın kendi yeniden denemelerini kapatın, yoksa ikisi çarpılır.
- Kota veya faturalandırma hatalarını yeniden denemeyin. Bunlar bir insan müdahalesi gerektirir.
server_is_overloaded ile gelen bir 503, modelin meşgul olduğu anlamına gelir; sizin hatanız değildir. Aynı geri çekilmeyle ele alın.
import random
import time

import openai

client = openai.OpenAI(max_retries=0)  # one retry layer only


def call_with_backoff(prompt: str, max_attempts: int = 6) -> str:
    delay = 1.0
    for attempt in range(max_attempts):
        try:
            response = client.responses.create(model="gpt-6.2-sol", input=prompt)
            return response.output_text
        except (openai.RateLimitError, openai.InternalServerError) as err:
            if attempt == max_attempts - 1:
                raise
            retry_after = err.response.headers.get("retry-after")
            wait = float(retry_after) if retry_after else delay
            time.sleep(wait + random.uniform(0, 1))
            delay = min(delay * 2, 60)
    raise RuntimeError("unreachable")
Astra mı Sol mu: hangi model limitlerinizi daha uzağa taşır
Hız limitleri aynı olduğundan seçim token kullanımına ve fiyata döner. Mimari değişiklikler, zor hatalar ve uzun otonom çalıştırmalar için Astra'yı kullanın. Rutin her şey için Sol'u kullanın. Plus'taki Codex'te Sol, beş saatlik pencerede Astra'nınkinden kabaca üç kat fazla mesaj alır; bu da maliyet farkının en net göstergesidir.
Karma bir ekip genellikle en iyi cevaptır: bir Astra ajanı liderlik eder, birkaç Sol ajanı parçaları üstlenir; tıpkı GPT-6 Astra as your Crew leader yazısındaki gibi. Rutin işler daha ucuz bir modele aittir; GPT-6 Luna for the boring 80 percent yazısının ardındaki mantık da budur.
Daha fazla GPT-6.2 verimliliği elde etmenin diğer yolları
- Batch API. Senkron hız limitlerinizin dışında çalışır ve standart fiyatların yüzde 50'sine mal olur. Değerlendirme (eval) ve toplu sınıflandırma için iyidir; etkileşimli bir ajan için yanlıştır.
2hveya8hpenceresiyle Arka plan modu. Canlı TPM'iniz yerine ayrı bir Batch/Background kuyruğu limitine sayılır.- Prompt önbellekleme. Önbelleğe alınan girdi, Astra'da milyon başına $0,40, Sol'da $0,10'dur; aynı bağlamı yeniden gönderen ajanlar için büyük bir tasarruftur.
Sonuç
GPT-6.2 hız limitleri istek başına cömert, token başına sıkıdır. Bir ajan ekibi için fiili sınır, katmanınızın TPM'sinin tek bir ajanın tükettiği miktara bölünmesiyle bulunur ve bu sınır projedeki tüm ajanlar tarafından paylaşılır. Tek bir çalıştırmayı ölçün, eşzamanlılığı bu sayının altında tutun, gürültülü ajan gruplarını kendi projelerine ayırın ve gerisini kuyruğun emmesine izin verin.
Bunu betikler ve bir semafor ile kurabilir veya Sharkly'de Ajan başına ayarlayabilirsiniz. Bir Computer bağlayın, Codex üzerinde GPT-6.2 Sol ile bir Ajan oluşturun, maksimum eşzamanlılığını 2'ye ayarlayın ve ona sıkıcı bir iş verin. Ajanları yan yana çalıştırma hakkında daha fazlası için How to run 10 AI coding agents at once yazımıza bakın.
SSS
GPT-6.2 hız limitleri nelerdir?
API'de GPT-6.2 Astra ve Sol aynı limitleri paylaşır: Build'de 5.000 RPM ve 1.000.000 TPM, Launch'ta 10.000 RPM ve 4.000.000 TPM, Grow'da 15.000 RPM ve 40.000.000 TPM.
GPT-6.2 Astra'nın hız limitleri Sol'dan daha mı düşük?
Hayır. OpenAI her katmanda her iki model için de aynı RPM ve TPM değerlerini listeler. Astra token başına daha pahalıdır; dolayısıyla hız limitine değil, bütçenize daha hızlı ulaşır.
Daha yüksek bir OpenAI kullanım katmanına nasıl geçerim?
Katmanlar toplam kredi alımına göre otomatik yükselir: Build için $5, Launch için $100, Grow için $500.
Hız limitleri API anahtarı başına mı, organizasyon başına mı?
Organizasyon ve proje başına. Bir projedeki her anahtar aynı havuzdan çeker; yani aynı projede on anahtar üzerinde çalışan on ajan bile tek bir limiti paylaşır.
Codex'te kaç GPT-6.2 Astra mesajı alırım?
Plus ve Standard Business'ta OpenAI, GPT-6.2 Astra için beş saatlik pencerede 6 ila 50, Sol için 17 ila 180 yerel mesaj tahmin eder. Pro planları şu anda beş saatlik limite sahip değil; ancak haftalık limitler uygulanabilir.
RPM iyi görünürken ajanlarım neden 429 hatası alıyor?
Ajanlar büyük bağlamlar gönderir; bu yüzden dakikadaki istek sayısını doldurmadan çok önce dakikadaki token'i tüketir. Yanıt başlıklarındaki x-ratelimit-remaining-tokens değerini kontrol edin.
Sharkly kendi model limitlerini ekliyor mu?
Hayır. Sharkly, halihazırda kullandığınız kodlama ajanlarını çalıştırır; model kotası, ekibinizin bağladığı araçlara, planlara ve API hesaplarına bağlıdır. Sharkly, her Ajanın aynı anda kaç görev çalıştıracağını kontrol eder.