Đánh giá Claude Fable 5.2 trên các tác vụ tiêu biểu của kho mã nguồn (repository) với tiêu chí chấp thuận rõ ràng, môi trường thử nghiệm đồng nhất và một quy trình đối chuẩn (baseline) mà bạn đang sử dụng. Hãy cùng lúc đo lường các thay đổi được chấp thuận, công sức review mã nguồn, thời gian xử lý và tổng chi phí. Chạy lặp lại nhiều lần, lưu lại các trường hợp thất bại và đưa ra quyết định ứng dụng theo từng danh mục tác vụ thay vì chỉ dựa vào một điểm số benchmark duy nhất.
Anthropic đã công bố Fable 5.2 vào ngày 9 tháng 11 năm 2026. Thông báo này nêu bật những cải tiến về khả năng lập trình và suy luận. Tuy nhiên, đó chỉ là tuyên bố từ nhà cung cấp dựa trên các bài đánh giá và thử nghiệm nội bộ của họ. Chúng chưa thể chứng minh mô hình này sẽ thể hiện ra sao trước hệ thống phụ thuộc (dependencies), quy ước lập trình cũng như các yêu cầu phát hành thực tế của riêng bạn.
Quá trình đánh giá nên tập trung trả lời một câu hỏi cụ thể hơn: bạn có thể giao phó những công việc nào mà vẫn giữ khối lượng review ở mức chấp nhận được? Nếu bạn đã và đang sử dụng nhiều coding agent cùng phối hợp làm việc, Sharkly sẽ là nền tảng giúp bạn quản lý các tác vụ và ngữ cảnh review tương ứng một cách khoa học.
Bài hướng dẫn này đề xuất một phương pháp thử nghiệm và không chứa kết quả so sánh định lượng thực tế.
Xây dựng bộ tác vụ tiêu biểu
Đánh giá trên repository là việc so sánh có kiểm soát các quy trình coding dựa trên chính những yêu cầu phát sinh từ dự án thực tế của bạn. Đơn vị đo lường thành công ở đây là một thay đổi mã nguồn được phê duyệt (accepted change), bao gồm cả bộ kiểm thử (test) đi kèm và quá trình review. Một bản vá trông có vẻ hợp lý, một lệnh kiểm thử báo pass hay một thông báo hoàn tất đầy tự tin vẫn chưa đủ để kết luận tác vụ đã đạt yêu cầu nghiệm thu.
Hãy bắt đầu với mười hai tác vụ được trích xuất từ các công việc bảo trì gần đây. Con số này là quy mô đề xuất cho giai đoạn thử nghiệm (pilot), không mang tính bảo chứng về mặt thống kê. Bộ tác vụ nên bao gồm sửa lỗi (bug fix), bổ sung tính năng nhỏ, tái cấu trúc mã (refactor) và điều tra sự cố theo tỷ lệ tương đồng với backlog thực tế của bạn.
Hãy chọn những tác vụ có commit khởi đầu rõ ràng và có người review am hiểu hành vi kỳ vọng của hệ thống. Tránh chỉ chọn những vấn đề có sẵn câu trả lời quá rõ ràng. Hãy đưa vào ít nhất một tác vụ mà phản hồi chính xác đòi hỏi agent phải đặt câu hỏi làm rõ hoặc chỉ ra một dependency còn thiếu.
Đối với các issue đã giải quyết trong quá khứ, hãy lược bỏ phần giải pháp khỏi ngữ cảnh cung cấp cho mô hình. Hãy ghi nhận lại liệu bản sửa lỗi đó đã từng được công khai hay chưa, vì mô hình có thể đã từng tiếp cận nó trong dữ liệu huấn luyện. Đồng thời, hãy giữ một bộ tác vụ chưa từng công khai riêng biệt để phục vụ cho vòng xác nhận sau này.
Hãy xác định tiêu chí chấp thuận (acceptance criteria) trước khi thực hiện bất kỳ lượt chạy nào. Chẳng hạn với lỗi phân trang API, cần nêu rõ các trường hợp: kết quả rỗng, ranh giới trang, con trỏ (cursor) không hợp lệ và tính tương thích ngược với các client hiện tại. Hãy nêu cụ thể phạm vi thay đổi cho phép cùng các bước kiểm tra bắt buộc để được nghiệm thu.
| Danh mục | Tác vụ ví dụ | Bằng chứng chấp thuận |
|---|---|---|
| Sửa lỗi (Bug fix) | Xử lý chính xác ranh giới con trỏ (cursor boundary) | Regression test và toàn bộ test suite hiện có đều pass |
| Bổ sung tính năng nhỏ | Thêm bộ lọc request tùy chọn | Contract test đạt chuẩn và giá trị mặc định được ghi chép tài liệu đầy đủ |
| Tái cấu trúc (Refactor) | Tách phần kiểm tra tính hợp lệ (validation) bị trùng lặp | Hành vi bên ngoài (public behavior) không đổi và vượt qua review |
| Điều tra sự cố | Chẩn đoán lỗi timeout gián đoạn | Tái hiện được lỗi và đưa ra giải thích nguyên nhân có cơ sở |
Hãy sử dụng tác vụ nhỏ khi bạn cần một kết quả so sánh rõ ràng, rành mạch. Sử dụng tác vụ lớn hơn khi mục tiêu đánh giá bao gồm cả khả năng phối hợp, và chấm điểm thử nghiệm đó một cách độc lập.
Cố định môi trường thử nghiệm trước khi chạy agent
Ghi lại commit của repository, hệ điều hành, các file lock dependency, phiên bản công cụ, định danh mô hình và cấu hình chi tiết. Bạn cũng cần cố định (pin) harness của agent: harness chính là phần mềm cung cấp công cụ, ngữ cảnh và cơ chế thực thi bao quanh mô hình.
Hãy so sánh Fable 5.2 với quy trình làm việc hiện tại của bạn. Khi so sánh giữa các mô hình, bạn cần giữ nguyên harness (nếu được hỗ trợ). Còn khi so sánh quy trình làm việc, bạn có thể dùng các công cụ khác nhau, nhưng kết luận đánh giá bắt buộc phải nêu rõ toàn bộ cấu hình cụ thể đó.
Giữ nguyên sự tương đương về quyền hạn, quyền truy cập mạng, ngữ cảnh ban đầu và giới hạn thời gian. Hãy quy định rõ liệu thời gian cài đặt dependency có được tính vào tổng thời gian thực thi hay không. Tuyệt đối không để cấu hình này kế thừa các file đã chỉnh sửa, cache chứa sẵn đáp án hay lịch sử hội thoại từ lượt chạy khác.
Sử dụng một bản checkout mới hoặc một worktree cô lập cho mỗi lượt thử nghiệm. Tài liệu về worktree của Git giải thích chi tiết cách nhiều working tree cùng chia sẻ một repository. Việc cô lập file không đồng nghĩa với việc cô lập cơ sở dữ liệu, cổng mạng (port) hay các dịch vụ bên ngoài; hãy cấp phát tài nguyên thử nghiệm riêng biệt cho cả những thành phần này.
Thiết lập quy tắc can thiệp rõ ràng. Ví dụ: chỉ cho phép một phản hồi làm rõ duy nhất chứa thông tin mà mọi cấu hình đều có thể tiếp cận được. Ghi lại toàn bộ thời gian can thiệp. Việc người review âm thầm sửa đổi bản triển khai sẽ làm sai lệch bản chất của những gì bài thử nghiệm muốn đo lường.
Chạy thử nghiệm song song theo cặp và lưu lại các lượt thất bại
Chạy từng cấu hình trên cùng một tập tác vụ. Hãy luân phiên thứ tự thực thi để tình trạng nghẽn mạng hay dịch vụ chậm đột xuất không vô tình tạo ưu thế cho một ứng viên cụ thể. Lặp lại các lượt thử nghiệm nếu tài nguyên cho phép, với số lần lặp cố định được xác định trước khi xem kết quả.
Một đợt thử nghiệm thực tế có thể áp dụng 3 lượt chạy cho mỗi cấu hình trên từng tác vụ. Hãy xem đây là điểm khởi đầu mang tính kỹ thuật. Một mẫu thử nhỏ không thể đưa ra khẳng định chắc chắn về các lỗi hiếm gặp hay sự vượt trội toàn diện.
Lưu trữ prompt, cấu hình, mốc thời gian, toàn bộ nhật ký hội thoại (transcript), bản vá (patch), kết quả đầu ra của công cụ và trạng thái xử lý cuối cùng của mỗi lượt thử nghiệm. Hãy ghi nhận các trường hợp quá thời gian (timeout) hoặc bị hủy bỏ như một kết quả thực tế. Nếu loại bỏ chúng, các lượt chạy thành công sẽ trông có vẻ rẻ hơn và nhanh hơn nhiều so với quy trình mà bạn sẽ triển khai trong thực tế.
Tách biệt test fixture và thông tin xác thực (credential) khỏi môi trường production. Tuân thủ đúng quy trình kiểm thử hiện có của repository. Đối với các repository Python, tài liệu của pytest mô tả chi tiết về fixture và cách thực thi test; tuy nhiên framework không thể quyết định liệu tiêu chí chấp thuận của bạn đã bao quát hết yêu cầu hay chưa.
Đánh giá độ chính xác trước tốc độ
Nếu có thể, hãy để người review kiểm tra bản vá mà không biết nhãn mô hình tạo ra nó (review ẩn danh). Áp dụng một biểu mẫu đánh giá cố định bao gồm: mức độ đáp ứng yêu cầu, nguy cơ lỗi hồi quy (regression risk), khả năng bảo trì, chất lượng kiểm thử và việc phát sinh thay đổi ngoài phạm vi cần thiết.
Vượt qua bài test là điều bắt buộc khi tác vụ yêu cầu, nhưng bản thân các bài test đôi khi cũng có thể cài đặt sai hành vi mong muốn. Hãy đối chiếu các câu lệnh assertion với yêu cầu ban đầu. Cần cảnh giác với các đoạn kiểm tra bị vô hiệu hóa, dung sai bị nới rộng, lỗi bị bỏ qua (swallowed errors) hoặc các sửa đổi đi đường vòng né tránh luồng gây lỗi.
Phân loại thành ba trạng thái kết quả: chấp thuận nguyên trạng, chấp thuận sau khi sửa đổi, và từ chối. Hãy ghi lại số phút sửa đổi và bản chất của từng chỉnh sửa đó. Cần quyết định trước liệu các thay đổi phải sửa chữa có được tính vào tỷ lệ chấp thuận chính hay không.
Đối với các tác vụ điều tra, hãy chấm điểm chuỗi bằng chứng. Một báo cáo hữu ích cần nêu rõ các quan sát thực tế, phân biệt rạch ròi các giả thuyết và đưa ra bước tiếp theo có thể tái hiện được. Đừng đánh giá cao một kết luận chẩn đoán đầy tự tin nhưng thiếu bằng chứng xác thực.
Tính toán chi phí trên mỗi thay đổi được chấp thuận
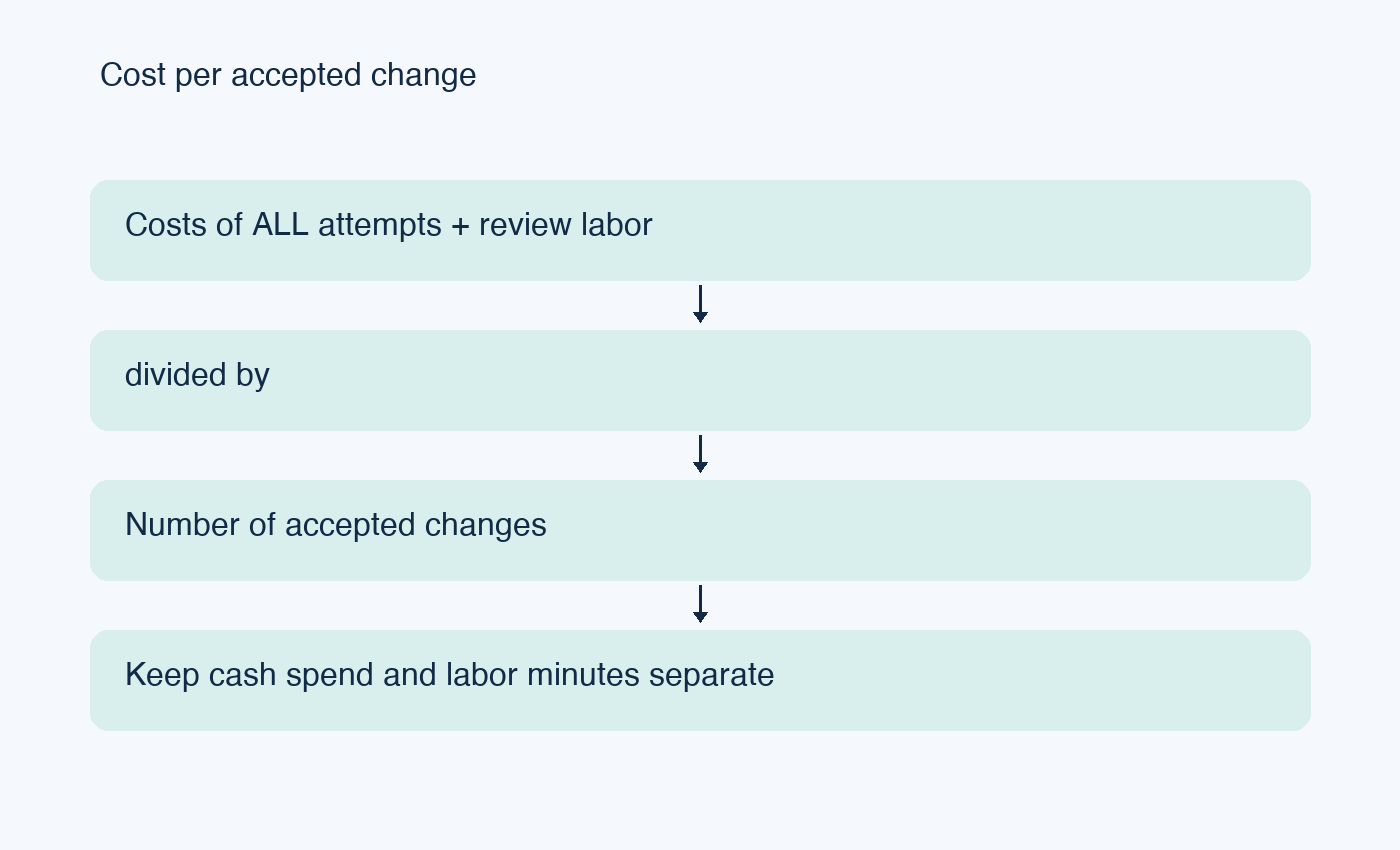
Chi phí trên mỗi thay đổi được chấp thuận được tính bằng cách lấy tổng chi phí đánh giá chia cho số lượng thay đổi được chấp thuận theo quy tắc đã định trước. Cần tính cả các lượt thử nghiệm thất bại vào tử số. Nếu không có thay đổi nào được chấp thuận, hãy báo cáo tổng chi phí cùng số lượt chấp thuận là 0; khi đó tỷ số này không có giá trị hữu hạn.
Hãy theo dõi đồng thời các chỉ số sau:
- Tỷ lệ chấp thuận theo từng danh mục tác vụ.
- Thời gian thực tế (wall-clock time) từ lúc bắt đầu tác vụ đến khi có kết quả sẵn sàng để review.
- Số phút con người bỏ ra để review và sửa đổi.
- Chi phí sử dụng mô hình và công cụ cho tất cả các lượt chạy.
- Chi phí hạ tầng nếu phát sinh đáng kể.
- Các lỗi hồi quy phát hiện được trong khung thời gian theo dõi.
Ghi lại lượng token tiêu thụ và nguồn biểu giá theo ngày cùng với số tiền bị tính phí thực tế. Token trong bộ nhớ đệm (cached tokens), số lần thử lại (retries) và các công cụ thực thi đều có thể làm thay đổi chi phí. Đừng chỉ ước tính hóa đơn dựa trên độ dài của kết quả đầu ra.
Nếu bạn quy đổi thời gian của người review thành chi phí tiền tệ, hãy ghi chú rõ đó là giả định nội bộ. Hãy hiển thị riêng biệt chi phí tài chính trực tiếp và số phút làm việc để người đọc có thể tự tính toán lại phép so sánh. Một lượt sinh mã có chi phí API rẻ hơn vẫn có thể đòi hỏi nhiều thời gian can thiệp của kỹ sư hơn.
Lưu trữ bằng chứng đánh giá đi liền với công việc
Sharkly quản lý các luồng công việc xoay quanh coding agent. Quy trình chuẩn của nền tảng kết nối Tasks, Agents, Computers, ngữ cảnh thực thi và bước review của con người. Hãy tham khảo tài liệu của Sharkly để nắm bắt các thuật ngữ sản phẩm và cách thiết lập hiện hành.
Đối với thử nghiệm này, hãy đưa tiêu chí chấp thuận vào từng Task và lưu bản vá, bằng chứng kiểm thử cùng kết quả cuối cùng vào chung một bản ghi công việc. Bạn có thể lưu bảng theo dõi đánh giá trong bảng tính hoặc file dữ liệu có quản lý phiên bản nếu thấy thuận tiện cho việc phân tích. Đừng mặc định rằng nền tảng sẽ tự động tính toán các chỉ số thử nghiệm của bạn.
Hãy sử dụng một Agent đơn lẻ cho bài thử nghiệm có phạm vi giới hạn. Chỉ đưa Crew vào khi bản thân khả năng phối hợp là một yếu tố cần đánh giá. Việc thay đổi cấu trúc đội ngũ giữa chừng sẽ làm phát sinh thêm biến số ngoài ý muốn.
Agent chịu trách nhiệm thực thi và báo cáo bằng chứng. Con người xác định tiêu chuẩn nghiệm thu, kiểm tra các thay đổi và phê duyệt phát hành. Sự phân định vai trò này luôn hữu ích ngay cả khi mã nguồn vượt qua mọi bài kiểm tra tự động.
Quyết định ứng dụng theo từng danh mục tác vụ
Hãy xây dựng quy tắc chấp thuận trước khi xem kết quả. Yêu cầu tiên quyết phải là độ chính xác ở mức chấp nhận được, sau đó mới so sánh chi phí và thời gian thực thi giữa các cấu hình đáp ứng được tiêu chuẩn đó. Hãy để các danh mục nhạy cảm về bảo mật hoặc có độ bao phủ kiểm thử (test coverage) thấp nằm ngoài phạm vi triển khai ban đầu.
Báo cáo số lượng cụ thể cùng với tỷ lệ phần trăm. Kết quả 2 trên 3 tác vụ được chấp thuận mang ý nghĩa hoàn toàn khác với 200 trên 300 tác vụ. Hãy mô tả mức độ biến thiên không chắc chắn và các dạng lỗi thường gặp thay vì vội vàng tuyên bố một người chiến thắng tuyệt đối.
Hãy lặp lại quá trình đánh giá sau mỗi thay đổi đáng kể về prompt, harness, phiên bản mô hình hoặc cấu trúc repository. Lưu giữ lại cấu hình cũ để các cải tiến sau này luôn có một baseline có thể tái lập được để đối chiếu.
Hãy bắt đầu với một tác vụ bảo trì tiêu biểu trong Sharkly, gắn kèm tiêu chí chấp thuận rõ ràng và so sánh bằng chứng thu được với quy trình làm việc hiện tại của bạn. Chỉ mở rộng quy mô sau khi bạn đã có thể giải thích rõ ràng cả nguyên nhân thành công lẫn thất bại.
Câu hỏi thường gặp
Các benchmark lập trình công khai có thể thay thế bài đánh giá này không?
Benchmark công khai có thể giúp bạn sàng lọc ứng viên. Tuy nhiên, nó không phản ánh được các quy ước, dependencies, tiêu chuẩn review hay các ràng buộc vận hành cụ thể trong repository của bạn.
Có cần dùng prompt hoàn toàn giống nhau cho mọi lượt thử nghiệm không?
Hãy cung cấp thông tin tác vụ tương đương nhau và tuân thủ chiến lược prompting đã định trước. Hãy ghi nhận lại các đoạn mã bọc (wrapper) đặc thù theo từng công cụ để có thể kiểm tra và đối chiếu các điểm khác biệt.
Các bản vá phải qua chỉnh sửa có được tính là thành công không?
Hãy quyết định quy tắc này từ trước. Báo cáo tách biệt giữa các trường hợp chấp thuận nguyên trạng và chấp thuận sau khi sửa đổi, đồng thời tính cả thời gian sửa đổi vào phần so sánh quy trình làm việc.
Các trường hợp timeout nên được tính điểm như thế nào?
Hãy ghi nhận chúng là thất bại theo hạn mức thời gian đã chọn. Đồng thời, đưa chi phí và thời gian đã tiêu tốn của chúng vào kết quả chung.
Khi nào đội ngũ nên mở rộng quy mô triển khai?
Chỉ nên mở rộng khi một danh mục tác vụ đáp ứng tốt quy tắc chấp thuận qua nhiều lần thử nghiệm lặp lại, và đội ngũ reviewer đã hiểu rõ các dạng lỗi thường gặp của nó.
Tài nguyên bổ sung
Tham khảo tài liệu của Git về việc cô lập repository, hướng dẫn về fixture trong pytest để thiết lập môi trường test có kiểm soát, và Sharkly để tổ chức công việc của agent cùng quy trình review của con người.