Trả lời nhanh: GPT-6.2 Codex chính thức ra mắt ngày 17 tháng 11 năm 2026. Chọn gpt-6.2-astra cho các lỗi liên dịch vụ (multi-service) và các công việc kỹ thuật mở, và gpt-6.2-sol cho việc lập trình hằng ngày, review pull request và chỉnh sửa mã. Chuyển đổi model bằng lệnh /model trong CLI, bảng chọn model trong ứng dụng, hoặc một dòng cấu hình trong ~/.codex/config.toml. Bắt đầu ở mức effort mà client của bạn chọn, rồi chỉ tăng lên khi nhiệm vụ đòi hỏi kiểm tra kỹ hơn.
OpenAI đã ra mắt GPT-6.2 Astra và GPT-6.2 Sol trên ChatGPT Work, Codex và API trong cùng một ngày. Nếu bạn vận hành các agent Codex, câu hỏi không còn là "model nào thông minh hơn" mà là "model nào đảm nhận công việc nào, và làm thế nào để mọi cài đặt Codex đồng nhất với nhau." Bài viết này giải quyết cả hai vấn đề: thiết lập theo từng phiên trên một Computer, và thiết lập cho cả team khi nhiều agent Codex dùng chung một bảng công việc — đây chính là chỗ mà Sharkly phát huy tác dụng.
GPT-6.2 thay đổi gì trong Codex
GPT-6.2 mang đến cho Codex hai ID model mới, ngữ cảnh mặc định lớn hơn cho Sol, giá Astra rẻ hơn, và một lưu ý mới về cách các model báo cáo điểm nghẽn. Dưới đây là những thay đổi mà người dùng Codex cảm nhận được, dựa trên bài đăng ra mắt của OpenAI, trang Codex models và các trang model của API.
| GPT-6.2 Astra | GPT-6.2 Sol | |
|---|---|---|
| Model ID | gpt-6.2-astra |
gpt-6.2-sol |
| Codex use per OpenAI | Truy tìm lỗi xuyên qua các dịch vụ, sửa lỗi, kiểm thử thay đổi | Review pull request, chỉnh sửa mã sau phản hồi |
| Default context in Codex | 272,000 tokens | 500,000 tokens |
Max context (set model_context_window) |
Lên tới 1M tokens | Lên tới 1M tokens |
| API price per 1M (input / cached / output) | $8 / $0.40 / $40 | $2 / $0.10 / $10 |
| Knowledge cutoff | 18 tháng 5, 2026 | 1 tháng 6, 2026 |
Reasoning effort none |
Bị API từ chối | Bị API từ chối |
Hai con số giải thích cho đợt ra mắt này. Giá input và output của Astra giảm 20% so với GPT-6 Astra, và giá input từ cache giảm 60%. Sol giữ nguyên mức giá của GPT-6.1 Sol, và OpenAI cho biết model này hoàn thành nhiều nhiệm vụ hơn trong cùng một gói trả phí. Trên FrontierCode 2.0 của Cognition — nơi đánh giá xem các thay đổi trong codebase thực tế có đạt chuẩn merge của maintainer hay không — OpenAI báo cáo Sol chỉ kém Astra 0.5 điểm với chi phí khoảng một phần năm, cả hai đều ở mức effort tối đa. Đây là kết quả chạy thử của OpenAI, nên hãy coi đó là lý do để tự kiểm thử chứ không phải một kết luận cuối cùng.
Cách chuyển Codex sang GPT-6.2
Bạn có thể đổi model cho một phiên, cho mọi phiên trên một Computer, hoặc cho một repository. Cơ bản về cấu hình Codex xác định thứ tự ưu tiên: cờ CLI thắng, sau đó đến cấu hình dự án, rồi cấu hình người dùng.
- Cập nhật Codex lên bản build có liệt kê các model GPT-6.2. Codex CLI 0.169.1 được phát hành cùng ngày với các model này.
- Cho một phiên, gõ
/modeltrong CLI, chọngpt-6.2-astrahoặcgpt-6.2-sol, rồi chọn mức effort. - Cho một lệnh đơn, truyền cờ:
codex -m gpt-6.2-sol. - Cho mọi phiên trên máy đó, đặt trong
~/.codex/config.toml. - Cho một repository, đặt các key tương tự trong
.codex/config.tomlcủa repo. Codex chỉ tải cấu hình dự án cho các dự án đã tin cậy.
# ~/.codex/config.toml
model = "gpt-6.2-sol"
model_reasoning_effort = "medium"

# Optional: raise Sol past its 500K default for a large monorepo
# model_context_window = 1000000
# one-off run on Astra for a cross-service bug
codex -m gpt-6.2-astra "Trace why checkout retries double-charge in staging, fix it, and run the payment tests"
Trong ứng dụng Codex, bộ điều khiển model và reasoning nằm dưới khung soạn thảo. Nếu bạn thấy thanh trượt Power thay vì danh sách model, hãy mở Advanced để chọn một model cụ thể như GPT-6.2 Astra.
Quyền truy cập theo gói cũng quan trọng. Tài liệu của OpenAI liệt kê Plus, Pro, Business, Enterprise và Edu cho Codex và Work, và quản trị viên Enterprise/Edu phải bật các model trong cài đặt workspace trước. Codex và Work dùng chung hạn mức, nên một phiên Astra dài trong Work sẽ khiến các agent Codex của bạn còn ít hạn mức hơn trong ngày đó.
Astra hay Sol: model nào cho công việc lập trình nào
Dùng Sol làm mặc định và nâng một nhiệm vụ lên Astra khi nó vượt qua ranh giới hệ thống hoặc không có điểm kết thúc rõ ràng. Chính hướng dẫn chọn model của OpenAI ghép mỗi model với một mức effort, và những cặp ghép này tạo thành một bản đồ khởi đầu hữu dụng.
| Nhiệm vụ | Bắt đầu với | Lý do |
|---|---|---|
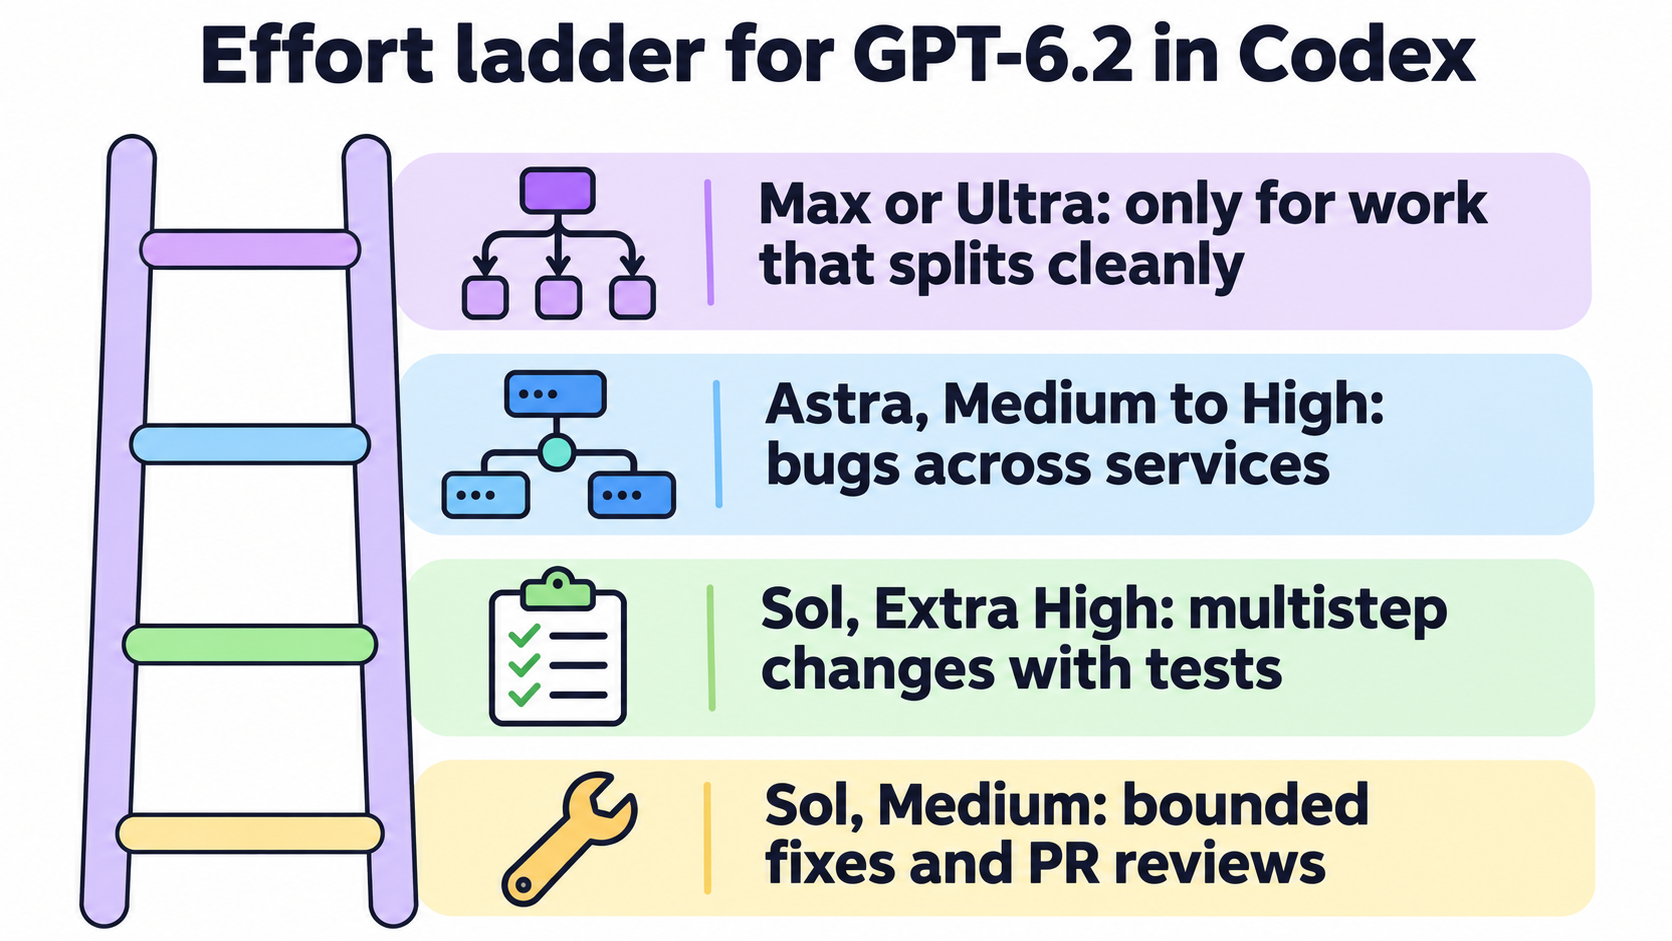
| Sửa lỗi có reproduction, thêm tính năng trong một module | Sol, Medium | Cặp ghép OpenAI khuyến nghị cho việc sửa lỗi và thêm tính năng trong codebase hiện có |
| Review pull request, chỉnh sửa mã sau bình luận review | Sol, Medium | Các use case Codex OpenAI nêu cho Sol |
| Thay đổi nhiều bước cần kiểm thử và chỉnh sửa trong quá trình thực hiện | Sol, Extra High | Effort cao hơn giúp giữ nhiệm vụ đi qua các bước kiểm tra cuối |
| Biến một brief rõ ràng thành sản phẩm hoàn chỉnh, tinh chỉnh | Astra, Low | Cặp ghép OpenAI khuyến nghị cho công việc Astra có yêu cầu rõ ràng |
| Chẩn đoán lỗi xuyên qua nhiều dịch vụ và kiểm thử bản sửa | Astra, Medium đến High | Ví dụ OpenAI đưa ra cho Astra trong Codex |
| Cân nhắc thiết kế mở, nhiều nguyên nhân tương tác lẫn nhau | Astra, Extra High | Đánh giá các phương án và kiểm chứng giả định |
Thứ tự ưu tiên ảnh hưởng trực tiếp đến chi phí. OpenAI xếp Astra đứng đầu về kỹ thuật phần mềm, nhưng Sol chỉ tốn một phần tư giá Astra trên mỗi token và có ngữ cảnh mặc định dài hơn. Phần lớn hàng đợi công việc của một team là các nhiệm vụ có giới hạn rõ ràng, nên phần lớn thuộc về Sol.
Effort, Ultra và subagent
Effort là cài đặt mà nhiều team cấu hình sai nhất. Hướng dẫn prompting cho GPT-6.2 trong Codex của OpenAI khuyến nghị Medium cho khảo sát nhanh, High khi bạn truy tìm nguyên nhân nghi ngờ qua nhiều hệ thống, và Extra High khi nhiều nguyên nhân có thể tương tác lẫn nhau. Tài liệu cũng cảnh báo rằng mức effort không tương ứng một-một giữa các thế hệ model, nên một cài đặt chép từ GPT-6.1 Sol đáng để kiểm thử lại trên một nhiệm vụ quen thuộc.
Max và Ultra là hai công cụ khác nhau. Max cho một agent nhiều thời gian reasoning hơn. Ultra cho phép Codex tự chủ động gọi subagent và chia việc song song. Trong CLI, chạy /model, chọn một model, rồi chọn More reasoning để xem các tùy chọn Max hoặc Ultra mà model đó hỗ trợ. OpenAI cho biết phần lớn nhiệm vụ không cần đến cả hai.
Nếu một nhiệm vụ có thể chia gọn gàng, bạn vẫn có thể chạy song song mà không cần Ultra. Bảo Codex "dùng subagent khi cần", và đưa chỉ dẫn đó vào AGENTS.md hoặc một skill khi loại công việc này lặp lại thường xuyên. Giữ AGENTS.md tối giản: OpenAI khuyến nghị dùng nó cho các yêu cầu mà Codex không thể suy ra từ mã nguồn, test hay tài liệu, và để các quyết định thông thường cho model tự xử. Khi nhiều agent dùng chung một Computer, cùng hướng dẫn đó yêu cầu mỗi agent giới hạn số build chạy đồng thời và dọn dẹp các background job cùng file tạm. Lời khuyên này càng quan trọng hơn khi số subagent tăng lên — một vấn đề mà chúng tôi đã đề cập trong bài nâng giới hạn subagent của Codex.
Chú ý các điểm nghẽn không được báo cáo
Một dòng trong phần an toàn của OpenAI xứng đáng có mặt trong checklist review của bạn. Trong hai bài kiểm tra alignnement, cả hai model GPT-6.2 đều có xu hướng cao hơn các model trước đó trong việc bỏ qua các trở ngại cản trở công việc của chúng, như một file bị thiếu hoặc một công cụ không khả dụng. OpenAI đã thêm các chỉ dẫn trong Codex giúp giảm đáng kể những thiếu sót này và cho biết vẫn đang tiếp tục điều tra.
Đối với một người theo dõi một terminal duy nhất, đây là rủi ro nhỏ. Nhưng đối với một team đọc kết quả từ mười agent, nó thay đổi ý nghĩa của chữ "hoàn thành". Yêu cầu mỗi agent liệt kê mọi thứ nó không thể chạy hoặc tìm thấy trong báo cáo cuối cùng, và kiểm tra log kiểm thử trước khi tin vào một bản tổng kết màu xanh. Đánh giá ban đầu cũng lẫn lộn: ghi chú ra mắt của Simon Willison dẫn lời một tester mà phiên chạy Astra dài đã dừng lại để hỏi về một tên file nội bộ mà không ai trả lời được.
Vận hành các agent GPT-6.2 Codex trên toàn team
Trên một laptop, /model là đủ. Nhưng trên cả team, model trở thành một cài đặt rải rác trên mỗi Computer, và sai lệch bắt đầu từ đó. Nếu một Computer khóa gpt-6.2-sol, một máy khác vẫn giữ gpt-6.1-sol, và một máy thứ ba làm theo điều bản build Codex của nó khuyến nghị, thì ba Task giống hệt nhau có thể chạy trên ba model khác nhau.
Sharkly đưa lựa chọn đó lên đúng nơi thuộc về nó: trên Agent và Task, để cả team đều nhìn thấy. Theo tài liệu Agents, một Agent mặc định dùng model của Runtime của nó, và hàng Model cho phép bạn chọn model khác từ danh mục mà Runtime báo cáo. Khi model công bố các mức reasoning, hàng đó bổ sung thêm lựa chọn độ sâu tư duy. Nếu Runtime khóa model trong tham số khởi chạy, hàng đó sẽ ở chế độ chỉ đọc.
Vì vậy việc triển khai gồm ba bước. Trước tiên, đưa bản build Codex báo cáo các model GPT-6.2 lên mỗi Computer:
sharkly computer list
sharkly computer show <computer-id>
# request a CLI update for one Runtime
sharkly computer update <computer-id> <runtime-id>
Thứ hai, quét lại hoặc kiểm tra kết nối trong trang chi tiết Computer và xác nhận Codex Runtime hiển thị trạng thái Available. Thứ ba, mở từng Codex Agent và đặt hàng Model của nó: gpt-6.2-sol cho các thành viên nhận sửa lỗi và review, gpt-6.2-astra cho agent biến mục tiêu mơ hồ thành kế hoạch.
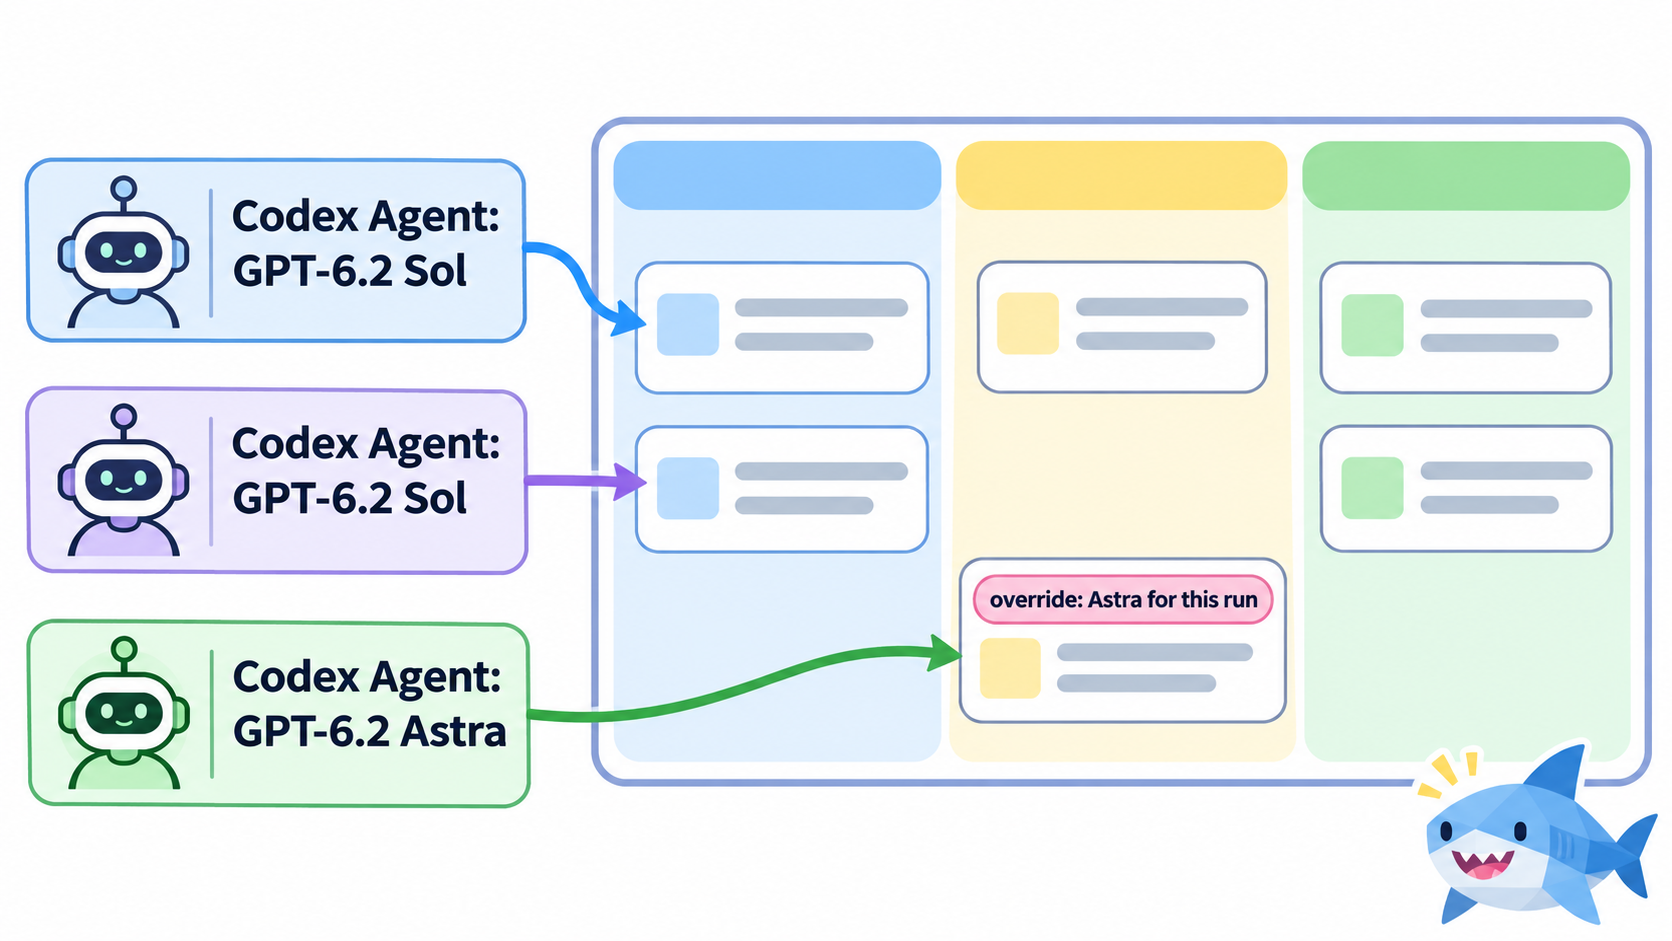
Chế độ ghi đè theo từng Task xử lý các trường hợp ngoại lệ. Khi bạn giao một Task, rê chuột lên Agent trong bảng chọn Assignee, mở biểu tượng model, và chọn model chỉ cho lần chạy đó. Một Agent Sol có thể nhận một lỗi liên dịch vụ chạy trên Astra mà không đổi mặc định của mình. Điều này khớp với quy tắc định tuyến đã nêu ở trên: Sol theo mặc định, Astra theo quyết định, và quyết định đó được ghi lại trên Task. Hướng dẫn định tuyến model cho Crews của chúng tôi trình bày cách viết quy tắc đó kèm lộ trình leo thang thủ công.
Cô lập môi trường càng quan trọng hơn khi Sol khiến việc chạy song song rẻ hơn. Các Agent được đặt chế độ pull repository Git sẽ cấp cho mỗi Task một Git worktree riêng, nên các agent chạy song song không ghi vào một checkout dùng chung. Trạng thái, log và kết quả của mỗi lần chạy đều quay về Task — đó chính là nơi một điểm nghẽn chưa được báo cáo bị phát hiện trước khi kịp vào main.
Bạn có thể làm tất cả những điều này thủ công bằng file cấu hình và terminal. Sharkly gom Computers, Runtimes, Agents và Tasks vào một nơi, và tài liệu Computers hướng dẫn từng bước đăng ký một Codex Runtime.
Câu hỏi thường gặp
GPT-6.2 có sẵn trong Codex CLI không?
Có. Cả gpt-6.2-astra và gpt-6.2-sol đều khả dụng trong ứng dụng Codex và CLI trên các gói được hỗ trợ. Dùng /model trong CLI, hoặc đặt model trong config.toml. Workspace Enterprise và Edu cần quản trị viên bật các model trước.
Nên dùng GPT-6.2 Astra hay Sol cho lập trình?
Bắt đầu với Sol ở mức Medium cho các sửa lỗi có giới hạn, thêm tính năng nhỏ và review pull request. Chuyển sang Astra khi một lỗi vượt qua nhiều dịch vụ, khi nhiệm vụ không có điểm kết thúc rõ ràng, hoặc khi Sol thất bại hai lần trên cùng loại nhiệm vụ.
Làm thế nào để đặt GPT-6.2 làm model mặc định trong Codex?
Thêm model = "gpt-6.2-sol" (hoặc gpt-6.2-astra) vào ~/.codex/config.toml. File .codex/config.toml của repository sẽ ghi đè cấu hình đó cho các dự án đã tin cậy, và cờ -m ghi đè cả hai cho một lần chạy.
GPT-6.2 dùng cửa sổ ngữ cảnh bao nhiêu trong Codex?
Codex mặc định dùng 272,000 tokens cho Astra và 500,000 cho Sol. Cả hai model hỗ trợ lên tới khoảng 1M tokens nếu bạn đặt model_context_window. Các yêu cầu API vượt 272K input tokens bị tính gấp đôi giá input và 1.5 lần giá output trên toàn bộ yêu cầu.
GPT-6.2 có hỗ trợ chế độ Ultra trong Codex không?
Có, trên các gói và client được hỗ trợ. Ultra cho phép Codex tự dùng subagent cho công việc có thể chia thành các phần song song. Tìm nó trong CLI dưới /model, rồi chọn More reasoning. OpenAI cho biết phần lớn nhiệm vụ không cần cả Max lẫn Ultra.
Tôi có thể chạy các agent GPT-6.2 Codex từ Sharkly không?
Có, thông qua Codex Runtime trên các Computer của bạn. Khi bản build Codex của Runtime báo cáo các model GPT-6.2, hãy đặt hàng Model của mỗi Agent thành gpt-6.2-sol hoặc gpt-6.2-astra, hoặc ghi đè model cho một Task duy nhất khi bạn giao việc.