
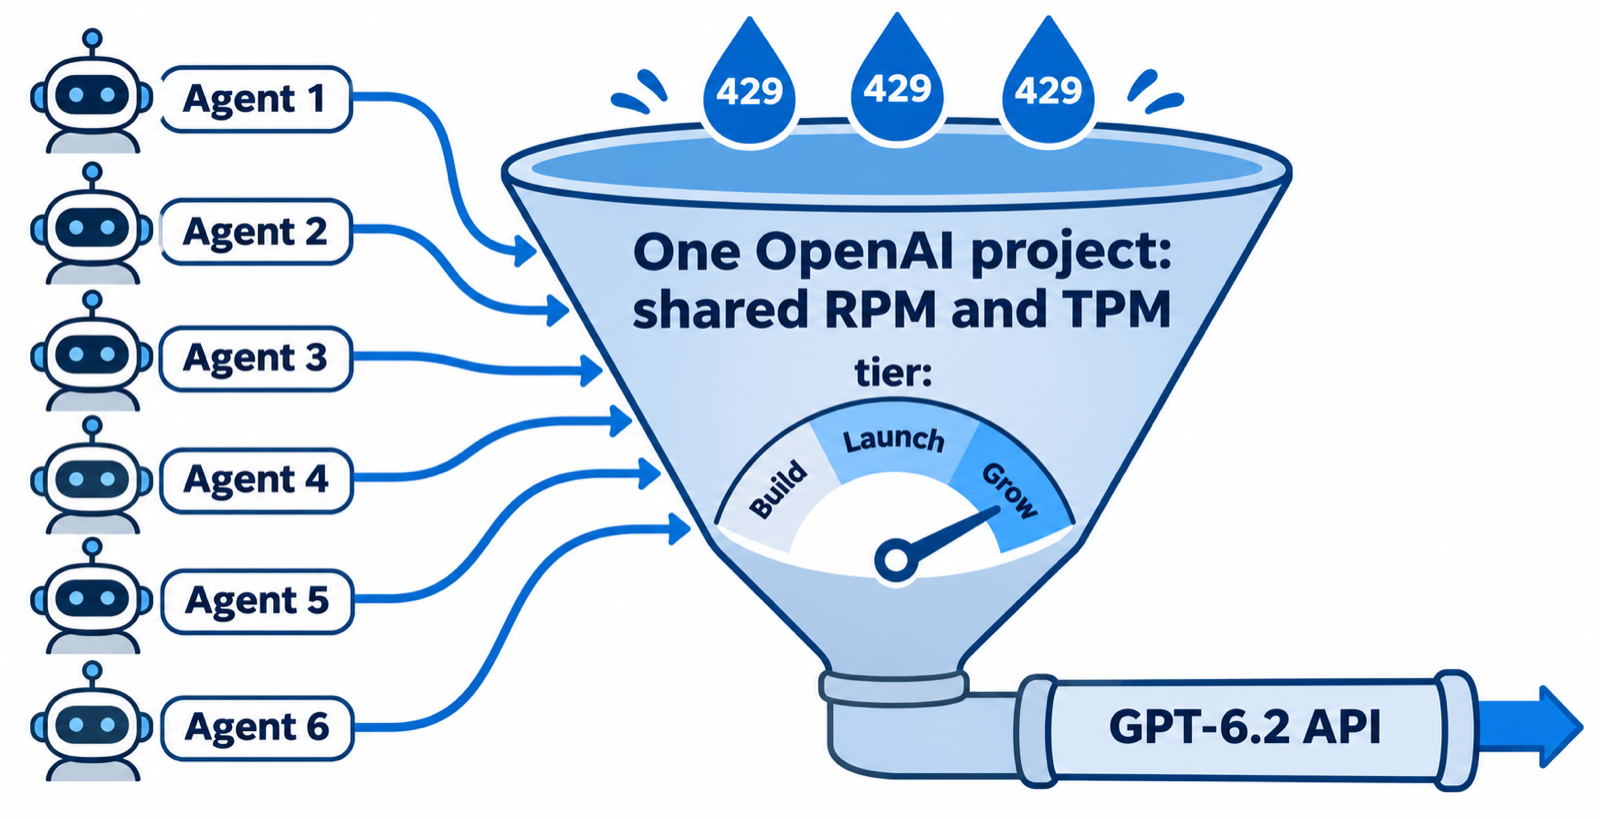
TL;DR: Giới hạn tốc độ của GPT-6.2 là như nhau cho Astra và Sol trên API: 5.000 RPM và 1.000.000 TPM ở bậc Build, 10.000 RPM và 4.000.000 TPM ở Launch, và 15.000 RPM và 40.000.000 TPM ở Grow. Giới hạn áp dụng theo từng organization và từng project, nên mọi agent dùng chung một key đều chia sẻ giới hạn đó. Với đội agent, tokens mỗi phút cạn trước, không phải số request.
OpenAI đã phát hành GPT-6.2 Astra và GPT-6.2 Sol vào ngày 17 tháng 11 năm 2026. Astra là mô hình tiên phong cho những công việc khó nhất; Sol là mô hình thường ngày giá rẻ hơn, được xây dựng để "vận hành agent ở quy mô lớn" theo lời của chính OpenAI.
Một agent hiếm khi chạm giới hạn. Sáu agent dùng chung một API key sẽ chạm vào ngay trước bữa trưa. Bài viết này bao gồm giới hạn tốc độ của GPT-6.2, giới hạn của các gói Codex, và cách quy mô đội agent để nó xếp hàng chờ thay vì bị lỗi. Nếu bạn đã chạy nhiều coding agent, Sharkly là nơi bạn đặt số agent chạy đồng thời.
Giới hạn tốc độ GPT-6.2 theo từng bậc sử dụng
GPT-6.2 Astra và GPT-6.2 Sol dùng chung một bảng giới hạn tốc độ chuẩn trên trang mô hình Sol và trang mô hình Astra của OpenAI. RPM nghĩa là số request mỗi phút; TPM nghĩa là số token mỗi phút. Bạn cạn cái nào trước thì cái đó chặn bạn.
| Tier | Đạt được khi (tổng số tiền nạp credit) | Giới hạn sử dụng hàng tháng | RPM | TPM |
|---|---|---|---|---|
| Build | $5 | $500 | 5.000 | 1.000.000 |
| Launch | $100 | $5.000 | 10.000 | 4.000.000 |
| Grow | $500 | $200.000 | 15.000 | 40.000.000 |
Hai cột điều kiện và giới hạn sử dụng hàng tháng lấy từ hướng dẫn giới hạn tốc độ của OpenAI. Bậc của bạn được nâng cấp tự động khi tổng số tiền nạp credit vượt qua từng ngưỡng. Giới hạn sử dụng hàng tháng là một giới hạn riêng, khác với các giới hạn chi tiêu do bạn tự đặt.
Astra đắt gấp bốn lần mỗi token ($8 đầu vào, $40 đầu ra mỗi triệu, so với $2 và $10 của Sol), nhưng giới hạn tốc độ thì như nhau. Điều bạn chạm vào phụ thuộc vào số token mà agent của bạn tiêu thụ.
Cách giới hạn sử dụng GPT-6.2 hoạt động trong Codex
Nếu agent của bạn chạy qua Codex trên gói ChatGPT thay vì dùng API key, một giới hạn khác sẽ áp dụng. Trang giá Codex của OpenAI đưa ra số tin nhắn local mỗi cửa sổ năm giờ dưới dạng khoảng, vì kích thước task thay đổi chi phí của mỗi tin nhắn.
| Mô hình | Plus | Business chuẩn |
|---|---|---|
| GPT-6.2 Astra | 6 đến 50 | 6 đến 50 |
| GPT-6.2 Sol | 17 đến 180 | 17 đến 180 |
| GPT-6.1 Sol | 15 đến 160 | 15 đến 160 |
| GPT-6 Astra | 5 đến 45 | 5 đến 45 |
Bốn chi tiết quan trọng với đội agent:
- Gói Pro hiện không có giới hạn năm giờ, nhưng giới hạn hàng tuần vẫn có thể áp dụng.
- Tin nhắn local và chat đám mây dùng chung một định mức. Một task trên đám mây có thể tiêu tốn nhiều hơn một tin nhắn local.
- Tốc độ phải trả bằng định mức. Chế độ Fast tiêu tốn gấp 2 lần định mức trên các mô hình GPT-6.2; Ultrafast tiêu tốn gấp 6 lần.
- Phiên dài tốn nhiều hơn mỗi tin nhắn. OpenAI cho biết các task giữ nhiều ngữ cảnh sử dụng "đáng kể hơn" định mức.
Một agent đã đọc được nửa repository sẽ gửi ngữ cảnh lớn ở mỗi lượt, nên số tin nhắn của nó giảm nhanh. Chúng tôi đã đề cập cùng mẫu hình này với các gói của Anthropic trong bài Claude Code usage limits, và phản hồi với việc cắt giới hạn Codex Pro cũng theo cùng logic.
Vì sao TPM, chứ không phải RPM, giới hạn một đội agent
Một coding agent không gửi hàng nghìn request nhỏ. Nó gửi vài request lớn. Mỗi lượt gửi lại toàn bộ hội thoại: hướng dẫn, các file đã đọc, output công cụ, và phần suy luận trước đó của chính nó.
Hãy lấy một agent ví dụ: 80.000 token đầu vào mỗi lượt và 6 lượt mỗi phút. Đó là 6 RPM và khoảng 480.000 TPM. So với bậc Build:
- RPM: dùng 6 trên 5.000. Còn xa lắc.
- TPM: dùng 480.000 trên 1.000.000. Hai agent là đầy.
Số liệu của bạn sẽ khác, nhưng tỷ lệ thì không. Agent nặng về token và nhẹ về request. Với agent ví dụ này, trần tối đa là hai agent mỗi project trên Build và tám trên Launch. Giữ phần dự phòng 30% từ các bước quy mô phía dưới thì con số giảm còn một agent trên Build và năm trên Launch. Trên Grow, giới hạn tốc độ không còn là điểm nghẽn của bạn và trần hàng tháng $200.000 hoặc ngân sách tự đặt của bạn mới là thứ quyết định.
Giới hạn được chia sẻ trong toàn organization
OpenAI định nghĩa giới hạn tốc độ ở cấp organization và cấp project, không phải theo từng người dùng. Mọi agent dùng key từ một project đều rút từ cùng một nguồn. Một số dòng mô hình còn có giới hạn chung hiển thị trên trang limits của bạn, nên lưu lượng tới một mô hình có thể tính vào mô hình khác.
Cách quy mô agent chạy đồng thời phù hợp với bậc GPT-6.2 của bạn
Cách giải quyết là giới hạn số agent chạy đồng thời, để công việc dư chờ trong hàng đợi thay vì va nhau ở API. Đây là thứ tự các bước hiệu quả:
- Tìm bậc của bạn trong Settings, Organization, Limits trên nền tảng OpenAI.
- Đo một lần chạy agent thực tế. Ghi lại token đầu vào mỗi lượt và số lượt mỗi phút từ output sử dụng của Runtime.
- Chia TPM của bạn cho TPM của một agent và giữ 30% dự phòng cho các đột biến.
- Đặt con số đó làm trần chạy đồng thời cho mọi agent dùng chung project.
- Theo dõi lỗi 429 trong một tuần, sau đó nâng trần từng bước một.
Trong Sharkly, mỗi Agent có cài đặt Max concurrency (assigned tasks), Max run duration tính bằng phút, và Queue timeout tính bằng giờ. Khi trần đã đầy, task mới sẽ ở trạng thái Queued cho đến khi có slot trống. Các chat có thể dùng chung giới hạn này, nên cuộc hội thoại không thể lọt qua ngoài giới hạn.

Một Computer cũng có giới hạn task đồng thời riêng. Tài liệu Sharkly lưu ý rằng mức đồng thời cao hơn tiêu tốn nhiều CPU, bộ nhớ, ổ đĩa, năng lực nhà cung cấp và băng thông repository, nên chỉ nên nâng khi tải hiện tại chạy ổn định.
Tách agent ra nhiều OpenAI project
Giới hạn cấp project cho phép bạn rào các nhóm agent. Cho các agent review một OpenAI project, và các agent refactor hàng loạt một project khác. Một đợt refactor mất kiểm soát khi đó chỉ chạm giới hạn của chính project nó, thay vì đói tài nguyên với phần review. Giới hạn organization vẫn chặn tổng thể, nên cách này thiết lập mức ưu tiên; nó không tăng thêm năng lực.
Với một Runtime xác thực bằng API key, hãy đặt key làm biến môi trường trên Agent. Sharkly tiêm biến môi trường của Agent vào tiến trình agent khi khởi động. Cho mỗi nhóm agent một key từ OpenAI project riêng, để lưu lượng của nó rơi vào đúng giới hạn.
Theo dõi token mỗi task
Phần tiêu đề Agent trong Sharkly hiển thị các task được giao, tổng số lần chạy, và token đã dùng. Hãy đọc token mỗi task, chứ đừng chỉ nhìn tổng số hàng tháng. Một loại task tiêu tốn gấp ba lần token so với các loại khác là ứng viên đầu tiên chuyển sang Sol thay vì Astra, hoặc cần mô tả task chặt chẽ hơn.
Chuyển công việc hàng loạt ra giờ thấp điểm
Cài đặt Runtime của mỗi Agent có công tắc Working hours để lên lịch công việc ngoài giờ cao điểm. Hãy dùng nó cho việc sinh test, nâng dependency, và các đợt viết tài liệu. Những task đó chạy qua đêm và để lại năng lực ban ngày cho công việc mọi người đang chờ.
Cách xử lý lỗi 429 của GPT-6.2
Ngay cả khi đã có trần, bạn vẫn sẽ thỉnh thoảng gặp 429. Hướng dẫn của OpenAI rất cụ thể về việc cần làm:
- Làm theo header
Retry-Afterkhi có mặt, và coi đó là mức tối thiểu. - Nếu không có, dùng exponential backoff với jitter ngẫu nhiên.
- Đọc
x-ratelimit-remaining-tokensvàx-ratelimit-reset-tokensđể biết bạn còn cách giới hạn bao xa. - Đừng lồng các lần retry vào nhau: nếu code của bạn tự retry, hãy tắt retry của SDK, nếu không hai lớp sẽ nhân lên.
- Đừng retry các lỗi quota hoặc thanh toán. Chúng cần con người xử lý.
Một lỗi 503 kèm server_is_overloaded nghĩa là mô hình đang bận, không phải phía bạn. Xử lý nó bằng cùng cơ chế backoff.
import random
import time

import openai

client = openai.OpenAI(max_retries=0)  # one retry layer only


def call_with_backoff(prompt: str, max_attempts: int = 6) -> str:
    delay = 1.0
    for attempt in range(max_attempts):
        try:
            response = client.responses.create(model="gpt-6.2-sol", input=prompt)
            return response.output_text
        except (openai.RateLimitError, openai.InternalServerError) as err:
            if attempt == max_attempts - 1:
                raise
            retry_after = err.response.headers.get("retry-after")
            wait = float(retry_after) if retry_after else delay
            time.sleep(wait + random.uniform(0, 1))
            delay = min(delay * 2, 60)
    raise RuntimeError("unreachable")
Astra hay Sol: mô hình nào giúp giới hạn của bạn đi xa hơn
Giới hạn tốc độ giống hệt nhau, nên lựa chọn phụ thuộc vào mức sử dụng token và giá. Dùng Astra cho các thay đổi kiến trúc, bug khó, và các phiên chạy tự động dài. Dùng Sol cho mọi việc thông thường. Trong Codex trên gói Plus, Sol nhận được khoảng gấp ba số tin nhắn mỗi cửa sổ năm giờ so với Astra, tín hiệu rõ nhất về khoảng cách chi phí.
Một đội kết hợp là câu trả lời thông thường: một agent Astra dẫn dắt, vài agent Sol làm các phần việc, như trong bài GPT-6 Astra as your Crew leader. Việc thông thường nên giao cho mô hình rẻ hơn — chính là logic đằng sau GPT-6 Luna cho 80% công việc nhàm chán.
Các cách khác để tăng thông lượng GPT-6.2
- Batch API. Nó chạy ngoài giới hạn tốc độ đồng bộ của bạn và chỉ tốn 50% giá chuẩn. Phù hợp cho eval và phân loại hàng loạt; không phù hợp cho agent tương tác.
- Chế độ Background với cửa sổ
2hhoặc8h. Nó tính vào một giới hạn hàng đợi Batch/Background riêng, thay vì TPM trực tiếp của bạn. - Prompt caching. Đầu vào được cache chỉ tốn $0,40 mỗi triệu trên Astra và $0,10 trên Sol — tiết kiệm lớn cho các agent gửi lại cùng một ngữ cảnh.
Kết luận
Giới hạn tốc độ GPT-6.2 hào phóng theo request nhưng chặt theo token. Với một đội agent, giới hạn thực tế là TPM của bậc bạn chia cho mức tiêu thụ của một agent, được chia sẻ bởi mọi agent trong project. Đo một lần chạy, đặt trần chạy đồng thời thấp hơn con số đó, tách các nhóm agent ồn ào sang project riêng, và để hàng đợi hấp thụ phần còn lại.
Bạn có thể xây dựng điều này bằng script và một semaphore, hoặc đặt theo từng Agent trong Sharkly. Kết nối một Computer, tạo một Agent trên Codex với GPT-6.2 Sol, đặt max concurrency là 2, và giao cho nó một việc gì đó nhàm chán. Thêm về cách chạy nhiều agent song song trong bài How to run 10 AI coding agents at once.
Câu hỏi thường gặp
Giới hạn tốc độ của GPT-6.2 là bao nhiêu?
Trên API, GPT-6.2 Astra và Sol dùng chung giới hạn: 5.000 RPM và 1.000.000 TPM ở Build, 10.000 RPM và 4.000.000 TPM ở Launch, và 15.000 RPM và 40.000.000 TPM ở Grow.
GPT-6.2 Astra có giới hạn tốc độ thấp hơn Sol không?
Không. OpenAI liệt kê cùng mức RPM và TPM cho cả hai mô hình ở mọi bậc. Astra đắt hơn mỗi token, nên nó khiến bạn chạm ngân sách nhanh hơn, chứ không phải chạm giới hạn tốc độ.
Làm thế nào để lên bậc sử dụng OpenAI cao hơn?
Bậc được nâng cấp tự động theo tổng số tiền nạp credit: $5 cho Build, $100 cho Launch, $500 cho Grow.
Giới hạn tốc độ tính theo API key hay theo organization?
Theo organization và theo project. Mọi key trong một project rút từ cùng một nguồn, nên mười agent dùng mười key trong một project vẫn chia sẻ một giới hạn.
Tôi được bao nhiêu tin nhắn GPT-6.2 Astra trong Codex?
Trên Plus và Business chuẩn, OpenAI ước tính 6 đến 50 tin nhắn local mỗi cửa sổ năm giờ cho GPT-6.2 Astra và 17 đến 180 cho Sol. Gói Pro hiện không có giới hạn năm giờ, tuy nhiên giới hạn hàng tuần vẫn có thể áp dụng.
Vì sao agent của tôi gặp lỗi 429 dù RPM có vẻ ổn?
Agent gửi ngữ cảnh lớn, nên chúng cạn token mỗi phút trước khi cạn request mỗi phút lâu rồi. Hãy kiểm tra x-ratelimit-remaining-tokens trong response header.
Sharkly có thêm giới hạn mô hình riêng không?
Không. Sharkly chạy các coding agent mà bạn đã dùng, và quota mô hình phụ thuộc vào công cụ, gói, và tài khoản API mà đội của bạn kết nối. Sharkly kiểm soát số task mỗi Agent chạy đồng thời.