

Jev là một mô hình mới từ TypeSafe AI, và nó không dùng để viết code hay tạo văn bản. Bạn cung cấp cho nó một phần trạng thái chương trình, khai báo các câu hỏi cần giải đáp, và nó sẽ trả về câu trả lời có kiểu dữ liệu rõ ràng kèm theo xác suất đã được hiệu chuẩn. TypeSafe gọi đây là System One Model. Mô hình này vừa cập bến Vercel AI Gateway vào ngày 16 tháng 9 năm 2026, và đó là lý do vì sao nó bất ngờ xuất hiện tràn ngập trên mọi bảng tin.
Đối với một đội ngũ đang vận hành nhiều coding agent, điểm thú vị không nằm ở bản thân mô hình. Điều đáng chú ý là vị trí của một mô hình ra quyết định trong ngăn xếp công nghệ (stack). Các agent của bạn sẽ tạo ra kết quả công việc. Vấn đề nan giải, như chúng tôi từng phân tích trong bài viết tại sao việc con người đánh giá là điểm nghẽn cổ chai, là việc quyết định phải làm gì với kết quả đầu ra của năm lượt chạy cùng một lúc: lượt nào cần con người can thiệp, lượt nào có thể merge, và lượt nào đang bị tắc nghẽn. Jev được xây dựng chính xác để giải quyết những câu hỏi như vậy. Bài viết này sẽ giải thích Jev là gì, nó không phải là gì, và nó nằm ở đâu trong tầng quản lý phía trên các agent của bạn.
Jev là gì
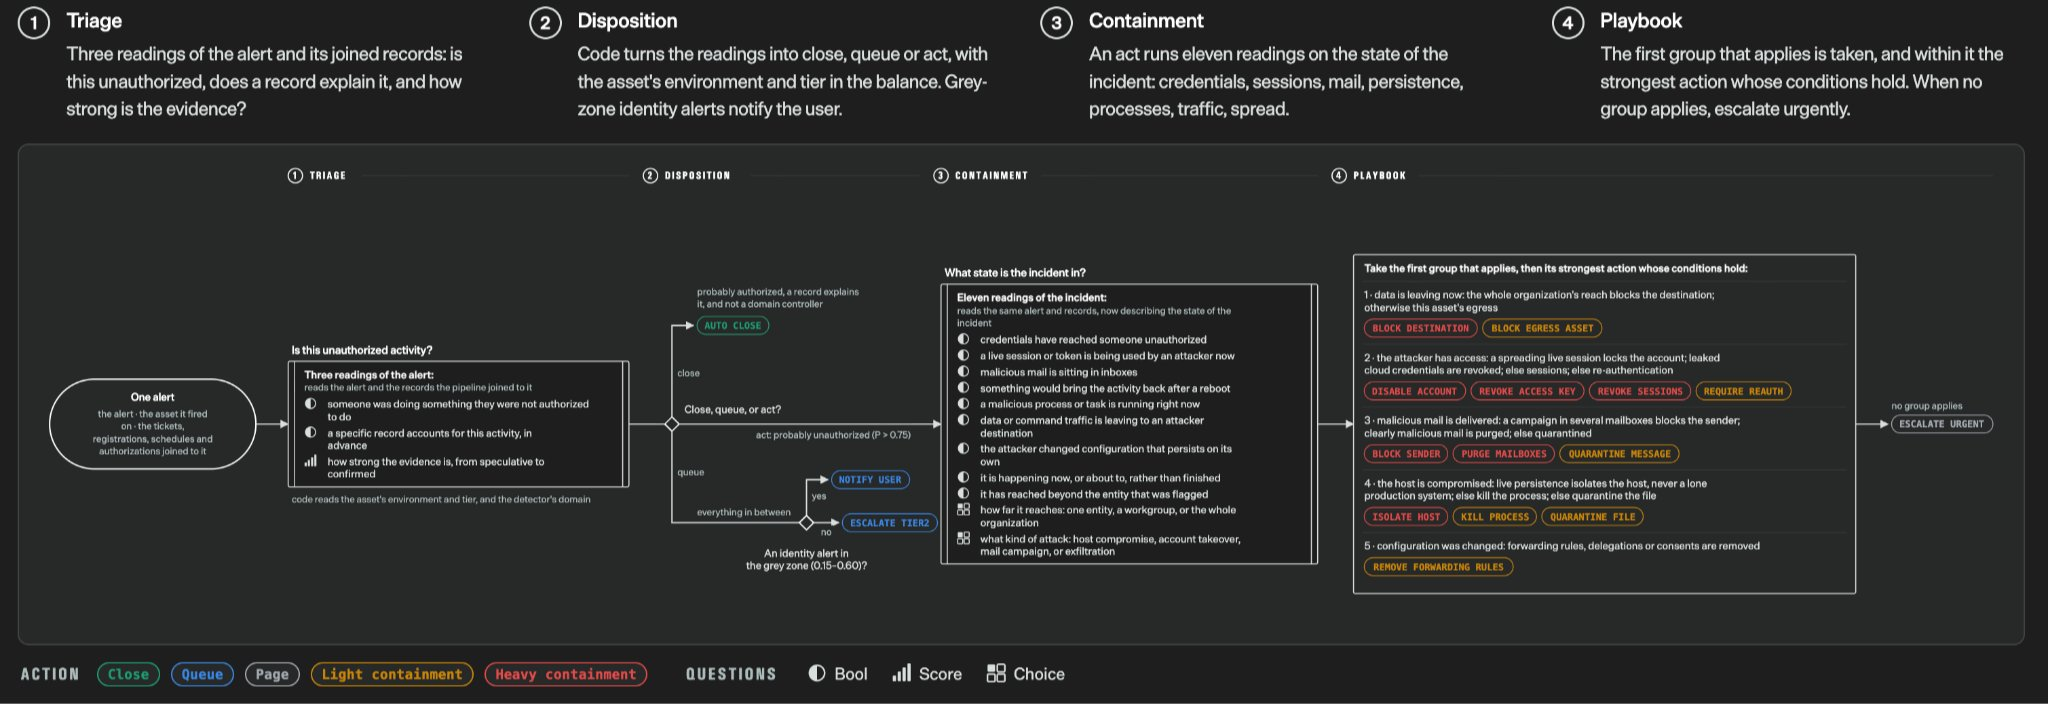
System One Model là mô hình trả về quyết định thay vì văn bản. Bài viết ra mắt của TypeSafe tóm gọn rằng: “đầu vào là trạng thái phi cấu trúc, đầu ra là các quyết định xác suất có kiểu dữ liệu”. Có ba đặc tính quan trọng cần lưu ý.
Cấu trúc đầu ra được khai báo trước khi thực hiện lệnh gọi. Bạn định nghĩa trước kiểu dữ liệu cho từng câu hỏi, và mô hình chỉ có thể trả lời đúng theo khuôn khổ đó. Bạn không cần phải parse văn bản và cũng không lo gặp lỗi lệch cấu trúc (schema mismatch).
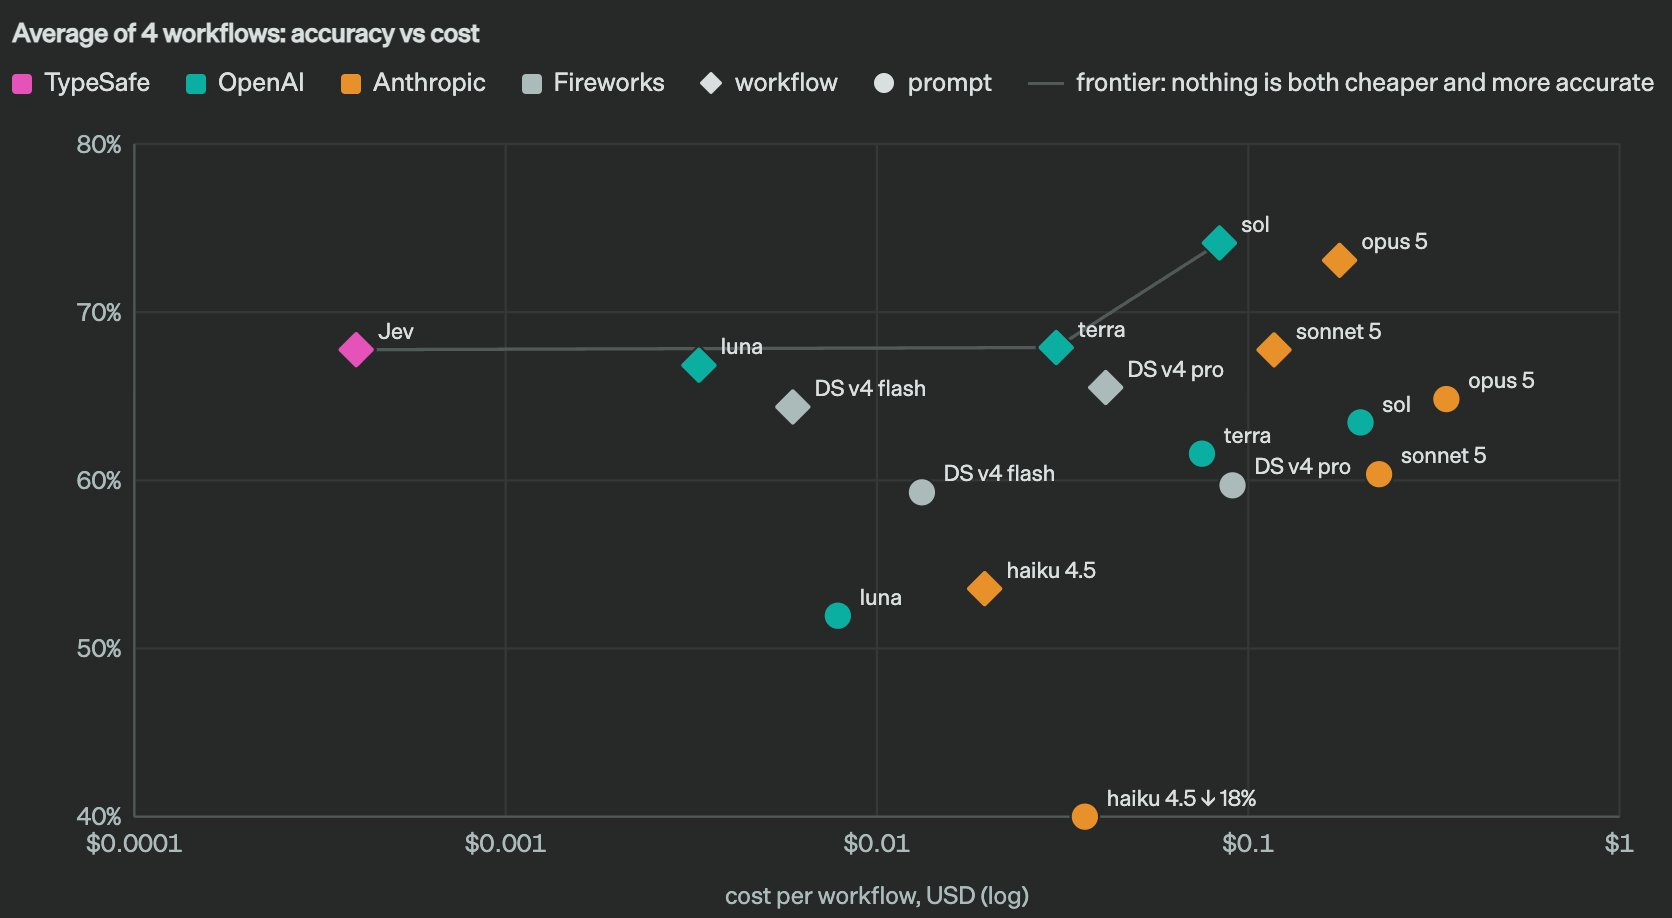
Mọi câu trả lời đều đi kèm một giá trị xác suất. Một câu hỏi có/không sẽ trả về 0.97 chứ không phải true. Một lựa chọn dạng trắc nghiệm sẽ trả về phân phối xác suất đầy đủ trên tất cả các phương án. TypeSafe đã huấn luyện mô hình bằng phương pháp có tên Học tăng cường cho các quyết định được hiệu chuẩn (Reinforcement Learning for Calibrated Decisions), với khẳng định rằng độ tin cậy càng cao thì độ chính xác càng lớn. Nhờ đó, bạn có thể thiết lập một ngưỡng: tự động hóa đối với những kết quả vượt ngưỡng, và chuyển phần còn lại cho con người xử lý.
Tất cả các câu hỏi đều được xử lý song song trong một yêu cầu duy nhất. Đó là lý do TypeSafe đưa ra con số thời gian phản hồi đầu-cuối từ 70ms đến 500ms. Dù đây là số liệu từ nhà cung cấp chứ không phải một bài benchmark độc lập, nhưng kiến trúc của mô hình đã lý giải cho điều đó: không có bất kỳ thứ gì được sinh ra theo từng token.
Ba kiểu câu hỏi
API của Jev cung cấp ba kiểu nguyên thủy. Mỗi kiểu là một JSON object nằm dưới một key do bạn chỉ định, tất cả đều được đánh giá dựa trên cùng một state.
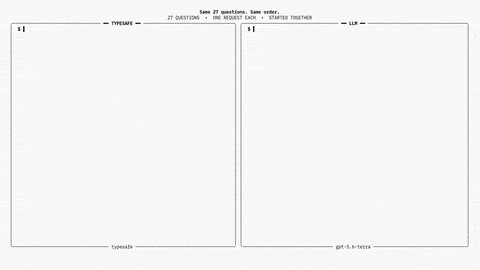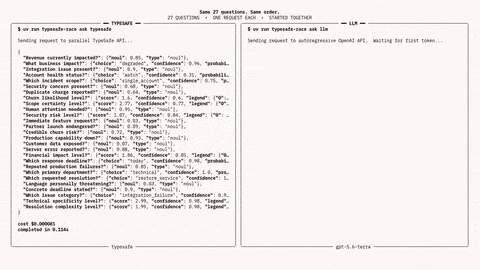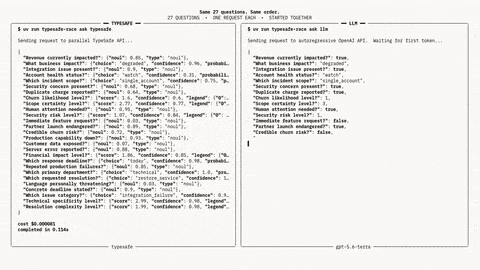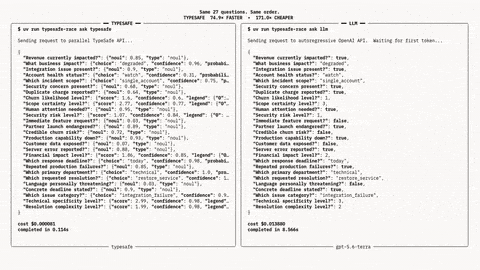
Noul là xác suất dạng có/không. Lệnh gọi {"type": "noul", "instructions": "Does this run need a human before merge?"} sẽ trả về {"noul": 0.91}. Bạn có thể tự đặt ngưỡng cho nó trong mã nguồn.
Choice lựa chọn một phương án từ một danh sách có tên chứa tối đa 255 mục. Bạn truyền vào criteria để ánh xạ tên phương án với phần mô tả, và câu trả lời sẽ bao gồm phương án được chọn, toàn bộ phân phối xác suất và chỉ số độ tin cậy.
Score xếp hạng trạng thái theo một thang tiêu chí có thứ tự từ 2 đến 10 mức. Câu trả lời là vị trí được tính theo trọng số xác suất, vì vậy một lỗi có thể đạt số điểm 1.3, nằm giữa mức “có giải pháp tạm thời” và “gây chặn hoàn toàn”.
Thông qua Vercel AI SDK, kiểu có/không được gọi là boolean và trường dữ liệu là probability; còn với endpoint riêng của TypeSafe thì nó là noul. Cùng chung bản chất, chỉ khác tên khóa.
Mô hình ra quyết định nằm ở đâu phía trên các agent của bạn
Dưới đây là mô hình tư duy mà chúng tôi áp dụng. Các mô hình tạo ra token. Những coding agent (Claude Code, Codex, Gemini CLI, OpenCode) biến token thành những thay đổi thực tế trên Máy tính (Computer). Tầng quản lý sẽ quyết định ai làm việc gì và xử lý kết quả đó ra sao. Jev thuộc về tầng cao nhất này, chứ không nằm ở tầng giữa. Nó không phải là một agent và không thể chỉnh sửa file. Nó là lời giải đáp nhanh chóng, có kiểu dữ liệu rõ ràng cho một câu hỏi mang tính điều phối quản lý.
Có ba câu hỏi luôn xuất hiện trên bất kỳ bảng quản lý nào vận hành các agent song song, và mỗi câu hỏi đều tương ứng với một kiểu nguyên thủy của Jev.
Người nhận việc (Assignee) nào nên đảm nhận Task này? Sử dụng Choice trên danh sách các Agent của bạn, với criteria mô tả thế mạnh của từng agent. Trạng thái (state) bao gồm tiêu đề Task, phần mô tả và kho mã nguồn liên kết. Đây chính là bước phân loại mà chúng tôi đã đề cập trong bài quản lý và phân loại backlog bằng AI, được thực hiện chỉ bằng một lệnh gọi 100ms thay vì một người phải ngồi đọc qua bốn mươi ticket.
Lượt chạy này có cần con người kiểm duyệt trước khi merge không? Sử dụng Noul dựa trên tóm tắt diff, kết quả kiểm thử và các đường dẫn file bị tác động. Nếu trên 0.85, giữ lại để review; dưới 0.15, để cổng phê duyệt tự động thông qua; còn ở giữa hai mức đó thì gắn cờ cảnh báo. Mục tiêu ở đây không phải là loại bỏ người review, mà là đảm bảo thời gian buổi chiều của họ được dành trọn cho những lượt chạy thực sự cần thiết.
Thay đổi này có mức độ rủi ro ra sao? Sử dụng Score từ mức “chỉ là giao diện/thẩm mỹ” cho đến “chạm vào xác thực hoặc thanh toán”, áp dụng cho cùng trạng thái đó. Điểm số này giúp sắp xếp hàng đợi review — vốn là mục đích chính của việc theo dõi công việc do coding agent hoàn thành.
Cộng đồng đã nhanh chóng đi trước một bước. Chỉ trong vòng một tuần sau khi ra mắt, các nhà phát triển đã phát hành một quy trình code review phân tầng xây dựng trên Jev, một plugin cho Claude Code thay thế các bản tóm tắt nén ngữ cảnh bằng các quyết định của Jev về việc giữ lại lệnh gọi công cụ nào, và cả một “quản đốc xưởng phần mềm” giúp điều phối công việc với nó. Tất cả những ứng dụng đó đều là một tầng ra quyết định nằm trên agent — và đó chính là mô hình cốt lõi đáng giá.
Một nguyên tắc ra quyết định thực tế
Hãy sử dụng Jev khi câu hỏi có một tập hợp câu trả lời cố định và bạn cần một giá trị xác suất đi kèm: định tuyến công việc, mức độ nghiêm trọng, “có cần review không”, “có đang bị tắc không”, “mô tả PR này có trung thực không”. Đó là những câu hỏi mà một bảng quản lý dự án phải đặt ra hàng trăm lần mỗi ngày.
Đừng dùng Jev khi câu hỏi đòi hỏi sự phán đoán vượt ra ngoài thông tin có trong trạng thái. “Đây có phải là kiến trúc phù hợp không” không phải là một Choice. “Khách hàng có chấp nhận điều này không” không phải là một Score. Xác suất gán cho những câu hỏi đó chỉ là một con số trông có vẻ giống như một quyết định. Đối với ranh giới đó, hãy để con người, hoặc một mô hình ngôn ngữ có khả năng giải thích lập luận của nó, đảm nhận.
Và đừng để một giá trị xác suất thay thế hoàn toàn cổng kiểm duyệt. Điểm số 0.96 cho việc “an toàn để merge” là một tín hiệu rõ ràng để đưa lượt chạy đó lên đầu hàng đợi của người đánh giá, chứ không phải lý do để bỏ qua con người. Ranh giới mà Sharkly vạch ra là: tự động hóa dừng lại ở nơi cần đến sự phán đoán của tập thể đội ngũ, và mô hình ra quyết định không làm xê dịch ranh giới đó. Nó chỉ giúp hàng đợi ở phía con người trở nên ngắn hơn và được sắp xếp trật tự hơn.
Cách gọi mô hình
Gọi trực tiếp: POST https://api.typesafe.ai/v1/systemone với Bearer key từ console.typesafe.ai, model jev-latest (hiện tại là jev-1.13.0). Thông qua Vercel AI Gateway: model typesafe-ai/jev qua experimental_evaluate trong AI SDK 7, và lưu ý rằng tài liệu của Gateway nêu rõ tính năng đánh giá chỉ khả dụng thông qua AI SDK chứ không hỗ trợ các endpoint tương thích với OpenAI.
Một lệnh gọi phân loại trả lời cả ba câu hỏi cùng lúc:
{
  "model": "jev-latest",
  "state": { "task": "Fix double charge on retry", "diff_summary": "touches billing/retry.ts, adds idempotency key", "tests": "42 passed" },
  "questions": {
    "assignee": { "type": "choice", "instructions": "Which Agent should take this?",
      "criteria": { "codex": "backend and payments", "claude_code": "refactors and tests", "gemini_cli": "frontend" } },
    "needs_review": { "type": "noul", "instructions": "Does this change need a human before merge?" },
    "risk": { "type": "score", "instructions": "How risky is this change?",
      "criteria": ["cosmetic", "logic change with tests", "touches auth, billing, or data"] }
  }
}
Mức giá theo trang mô hình của TypeSafe: $0.042 cho mỗi triệu input token, không tính phí output, tối đa 64k token mỗi yêu cầu với 32k dành cho state, chỉ hỗ trợ văn bản. Với mức giá đó, lệnh gọi phân loại ở trên chỉ tốn một phần nhỏ của một cent, khiến cho việc kích hoạt nó trên mọi Task và mọi lượt chạy trở nên hoàn toàn khả thi.
Mối liên hệ giữa mô hình này với Sharkly
Sharkly không thay bạn gọi Jev, và bản thân nó cũng không phải là một mô hình ra quyết định. Nó là tầng trung gian dùng chung để quản lý task, Máy tính (Computer), ngữ cảnh và quy trình đánh giá xoay quanh các agent bạn đang chạy. Những gì một mô hình như Jev đem lại cho bạn là một phương thức tiết kiệm chi phí, có kiểu dữ liệu rõ ràng để đưa ra các quyết định định tuyến và review mà tầng này hiển thị: Assignee nào, hàng đợi nào, mức độ khẩn cấp ra sao. Bạn có thể tích hợp nó vào một Automation giúp tạo Task và chọn Agent, hoặc chạy nó trên kết quả đầu ra của một lượt chạy đã hoàn thành trước khi chuyển đến người đánh giá. Dù theo cách nào, quyết định đó cũng sẽ hiển thị ở nơi mà con người có thể quan sát được — đó là nguyên tắc phải luôn được bảo đảm, bất kể xác suất đưa ra là bao nhiêu.
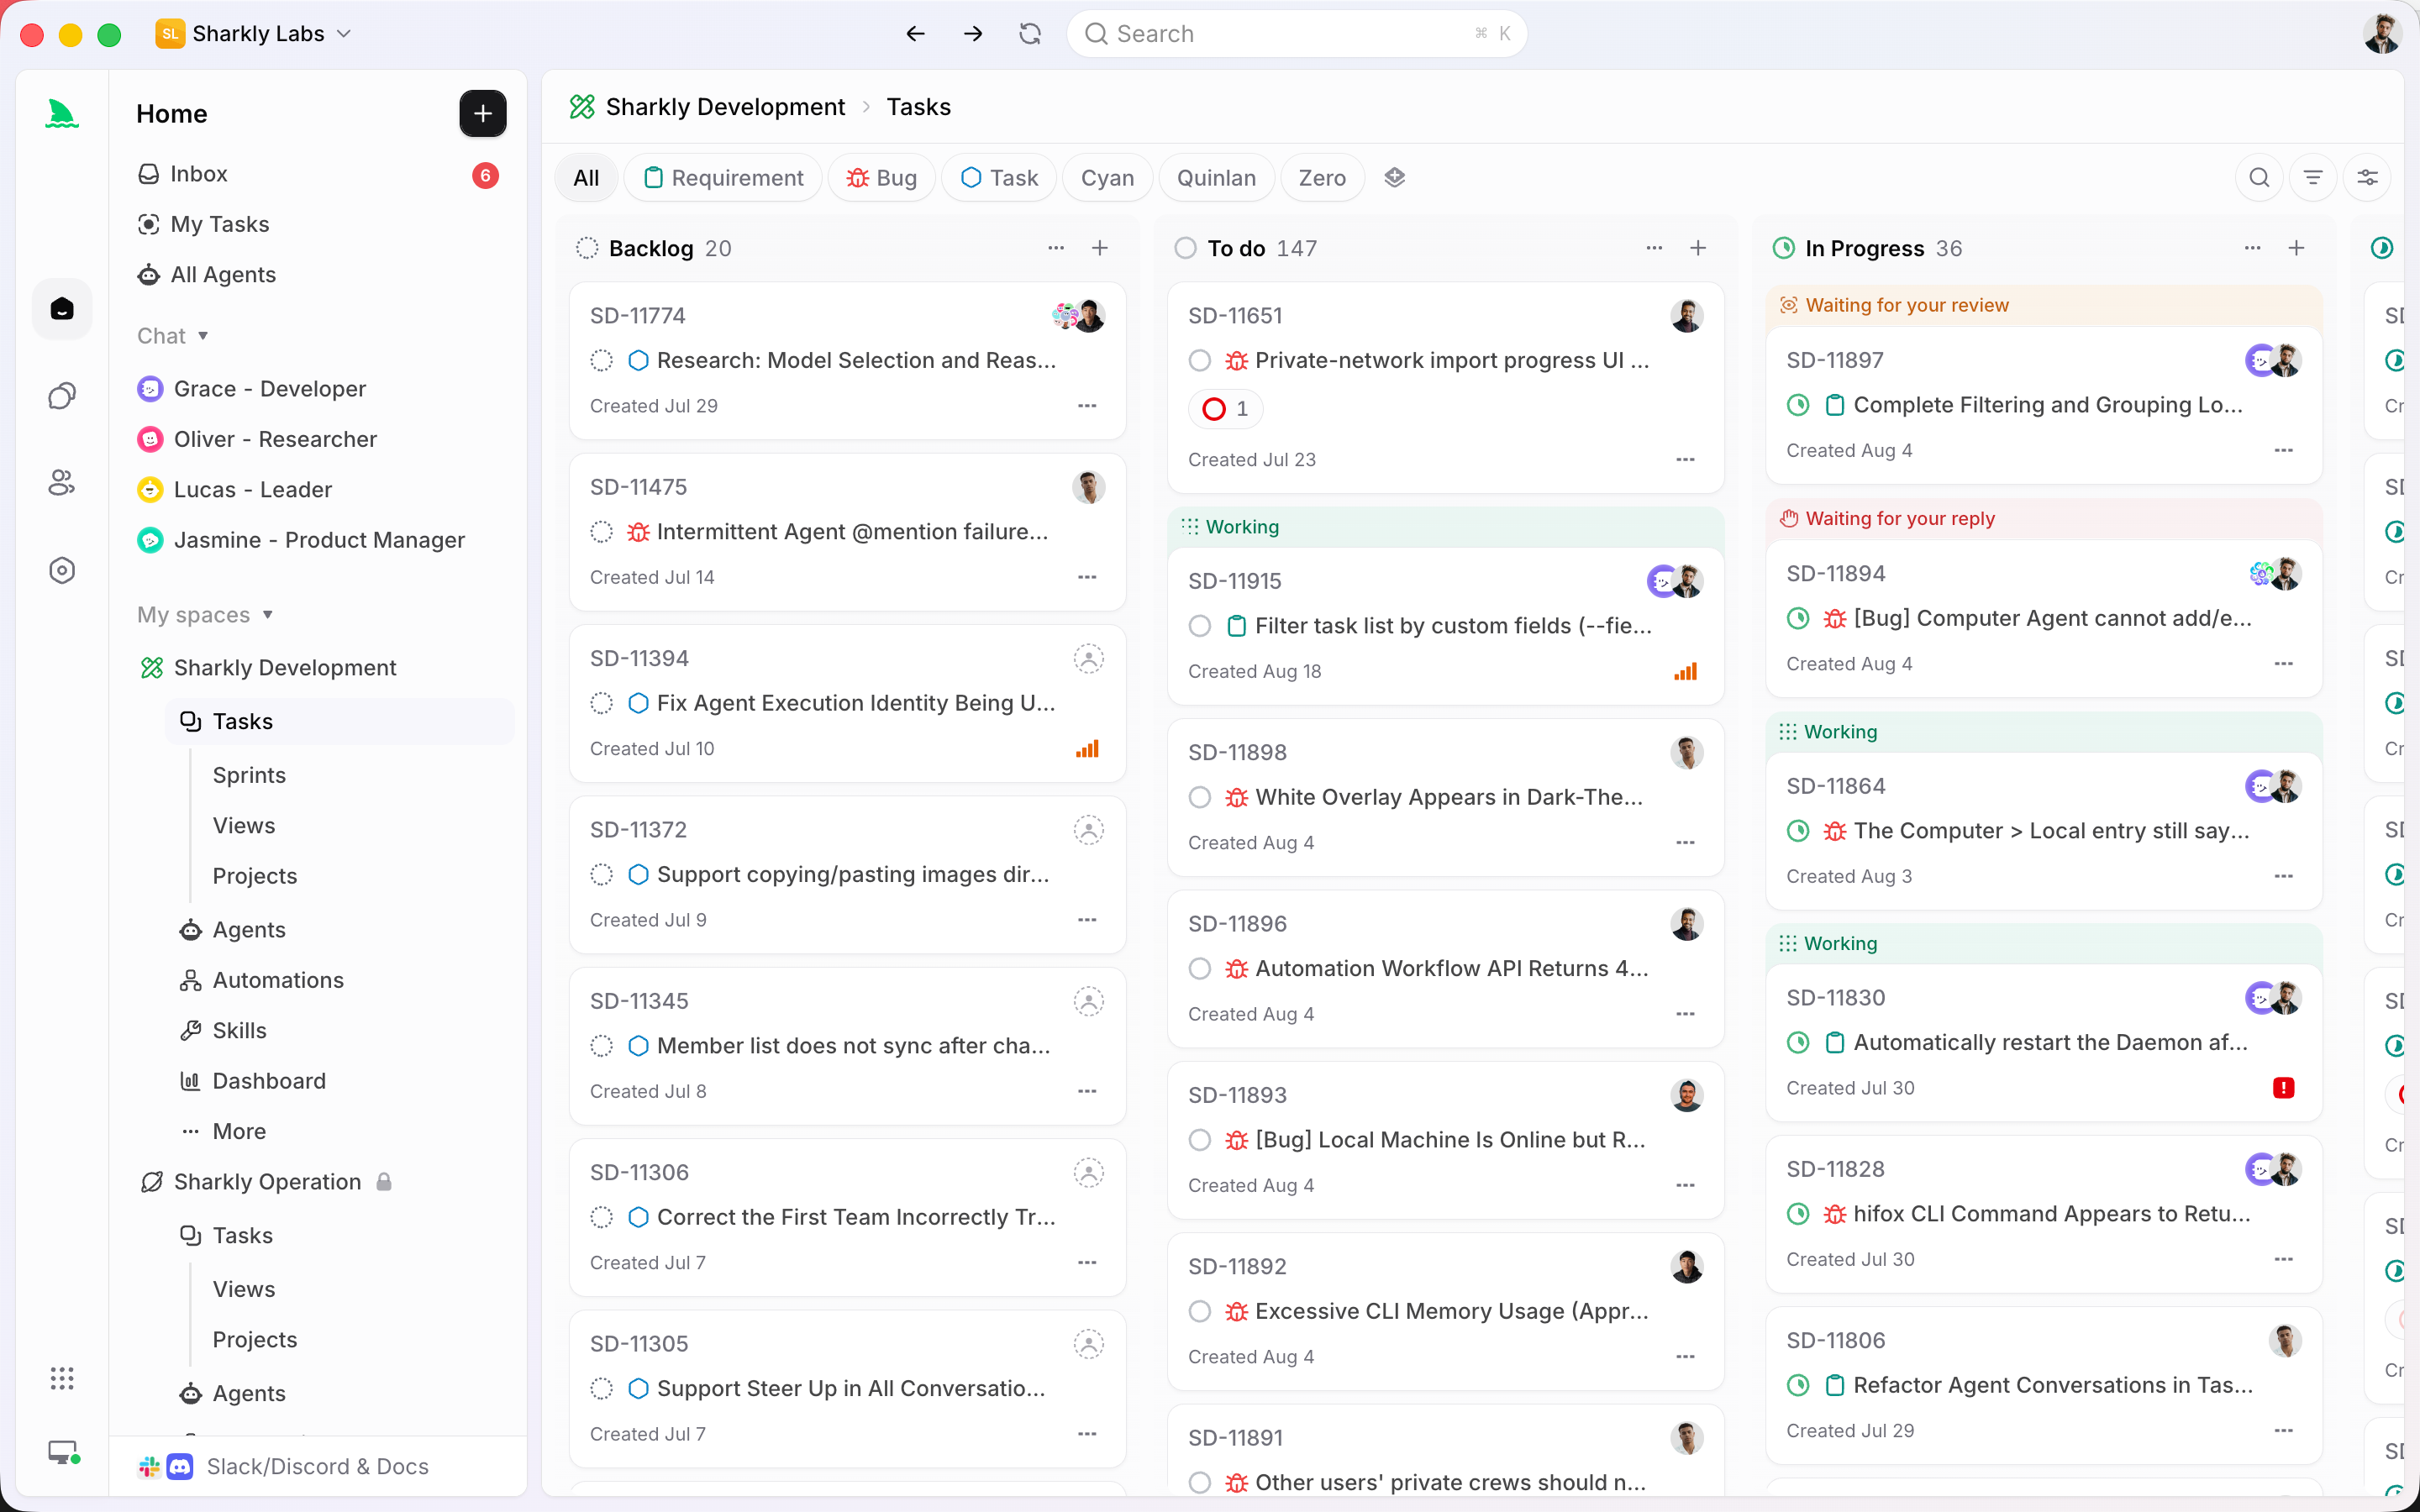
Nếu bạn đang chạy nhiều hơn một agent và hàng đợi review đang là vấn đề gây đau đầu, bài viết bắt đầu với Sharkly sẽ hướng dẫn chi tiết về bảng quản lý, Máy tính và luồng review mà một mô hình ra quyết định có thể tích hợp vào.
Câu hỏi thường gặp
Jev có phải là một coding agent không?
Không. Nó không thể sinh code hay chỉnh sửa file. Nó chỉ trả lời các câu hỏi đã được khai báo về trạng thái mà bạn cung cấp, kèm theo giá trị xác suất. Các agent tạo ra sản phẩm công việc; Jev giúp quyết định cần làm gì với sản phẩm đó.
Nó có thể thay thế việc code review không?
Không, và nó cũng không nên làm vậy. Nó có thể xếp hạng hàng đợi review và lọc ra các trường hợp rõ ràng. Quyết định merge vẫn luôn thuộc về con người, và đó là ranh giới cốt lõi mà toàn bộ quy trình này dựa vào.
“Hiệu chuẩn” (calibrated) nghĩa là gì?
Nếu Jev đưa ra con số 0.9, nó sẽ đúng khoảng 90% số lần đối với kiểu câu hỏi đó. Hãy tự kiểm chứng điều này trên các lượt chạy của chính bạn trước khi đặt niềm tin vào một ngưỡng xác suất: chỉ cần vài chục bản diff đã được gắn nhãn là đủ để biết con số đó có thực sự đáng tin cậy hay không.
Tôi có bắt buộc phải dùng Vercel mới sử dụng được không?
Không. API trực tiếp hoạt động với một Bearer key. Gateway chỉ là một sự tiện lợi nếu bạn đã và đang sử dụng AI SDK.


