
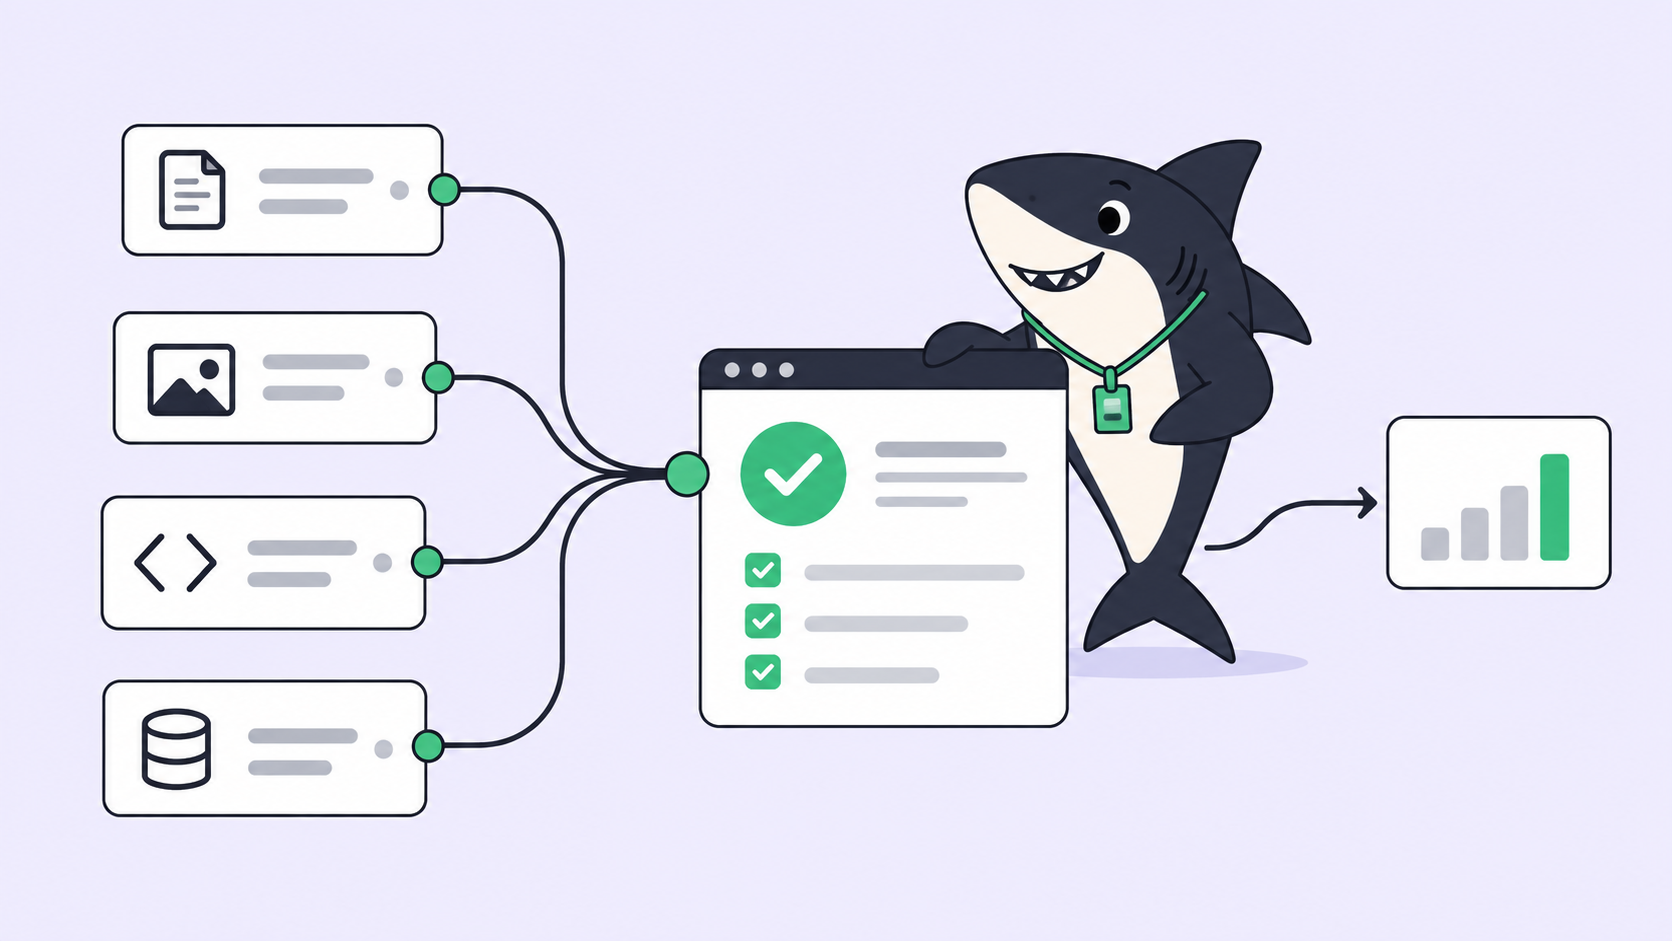
Bảng giá ngày 2026-09-22 đã cho thấy một hình dạng khá rõ ràng. Đặt GPT-6 Luna ở mức $0.10 cho mỗi triệu token đầu vào để làm những việc chẳng ai thích, đặt Claude Opus 5.5 ở mức $4 cho Agent kiểm tra lại, và bạn giữ được phần lớn thông lượng với chi phí chỉ bằng một phần nhỏ. Rất nhiều đội nhóm đang triển khai mô hình này trong tuần này, và phần lớn sẽ xây ra một thứ trông giống như review nhưng thực chất không phải.
Vấn đề không nằm ở mô hình nào. Nó nằm ở thứ đi qua khoảng cách giữa hai mô hình. Một reviewer đọc bản tóm tắt công việc của worker do chính worker viết ra là đang đọc một lời khẳng định, và thứ duy nhất nó có thể trả về là một phán xét về lời khẳng định đó. Diff đã pass, worker nói vậy. Trông ổn đấy, reviewer đáp. Một con người phê duyệt vì hai mô hình đồng ý với nhau — kiểu đồng thuận ít thông tin nhất có thể.
Vậy nên câu hỏi thú vị trong một Crew đa mô hình không phải là mô hình nào đi vào vị trí nào. Mà là bước bàn giao phải mang theo những gì.
Crew đa mô hình là gì
Crew đa mô hình là một nhóm các Agent trong đó Runtime được chọn theo từng vai trò thay vì theo cả đội, và có ít nhất một vai trò chỉ tồn tại để kiểm tra đầu ra của những vai trò khác.
Một reviewer Agent không phải là một sự phê duyệt. Nó là một ý kiến thứ hai có tốn chi phí, được tạo ra trước khi con người xem, để con người đọc một danh sách ngắn hơn. Agent nghiên cứu, thực thi, kiểm thử và báo cáo. Con người định hướng, trao quyền và chấp nhận kết quả. Thêm một mô hình đắt tiền vào giữa câu đó không làm thay đổi mệnh đề cuối cùng.
Ba hạng, đúng như các nhà cung cấp công bố
| Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | |
|---|---|---|---|
| ID API | claude-opus-5-5 |
gpt-6-sol |
gpt-6-luna |
| Đầu vào / đầu ra mỗi 1M | $4 / $20 | $2 / $10 | $0.10 / $0.50 |
| Đầu vào đã cache | đọc $0.20, ghi $5 | giảm 90% khi đọc | giảm 90% khi đọc |
| Ngữ cảnh | 1M | 872k | 1M |
OpenAI mô tả Sol và Luna rẻ hơn 50% so với giá khuyến mãi của GPT-5.6, và "khuyến mãi" là một từ đáng lưu ý: mức nền đã là giá đã giảm. OpenAI cũng nói GPT-6 Astra "vẫn tiếp tục là mô hình tốt nhất của chúng tôi trên mọi mặt".
Một lưu ý trước khi ai đó đọc ra một bảng xếp hạng từ sự phân chia đó. Bài giới thiệu của OpenAI đánh giá Sol và Luna so với Claude Opus 5, vì Opus 5.5 chưa tồn tại khi bài viết ra đời và được phát hành vài giờ sau đó với chi phí vận hành thấp hơn 40% so với Opus 5, theo chính lời Anthropic. Chưa ai chạy lại so sánh đó, và hai nhà cung cấp không dùng chung một harness. Hãy chọn vai trò dựa trên giá và hành vi quan sát được trong chính repo của bạn.
Điều mà mỗi nhà cung cấp nói về mô hình của riêng mình đã đủ để phân chia vai trò. Với Luna, OpenAI báo cáo 66.6% trên DeepSWE 1.1 ở mức nỗ lực suy luận tối đa, rẻ hơn 93% mỗi task so với Claude Opus 5 và rẻ hơn 96% so với Fable 5, và ở mức nỗ lực cao hơn đạt kết quả về độ chính xác sự thật ngang GPT-5.6 Sol với chi phí chỉ bằng khoảng một phần trăm. Đó là mô hình bạn có thể hướng vào khối lượng lớn. Với Opus 5.5, Anthropic báo cáo 66.4% trên Terminal-Bench 4.0, 54.4% trên FrontierCode v1.1, 81.8% trên OSWorld 2.0, đầu ra tối đa 128k, và duy trì đúng nhiệm vụ trong 18 giờ hoặc hơn. Đó là mô hình bạn có thể hướng vào việc phán đoán.
Đọc là phần rẻ của một mô hình đắt tiền
Lý do hình dạng này trụ được khi đụng vào hóa đơn là caching, và sự bất đối xứng đó quyết định thiết kế.
Đầu vào đã cache của Opus 5.5 đọc ở mức $0.20 mỗi triệu. Đó là một phần hai mươi so với giá đầu vào chưa cache của chính nó, và gấp đôi giá chưa cache của Luna. Đầu ra của nó là $20 mỗi triệu, gấp bốn mươi lần $0.50 của Luna. Vậy nên một reviewer đọc một lượng khổng lồ và viết ra hai mươi dòng thì gần như miễn phí, còn một reviewer kể lể dài dòng thì không.
Điều đó cho bạn một nguyên tắc có bằng chứng đằng sau: reviewer đọc tất cả và gần như không nói gì. Hãy đưa cho nó tiền tố repo, các quy ước, diff và gói thông tin bên dưới, rồi giới hạn những gì nó trả về.
Phía worker cũng dùng cache. GPT-6 nâng tỉ lệ hit mặc định với mức giảm 90% cho lượt đọc đầu vào đã cache, thêm các breakpoint tường minh để bạn chọn nơi kết thúc của một tiền tố đã cache, và không còn vô hiệu hóa cache khi bạn thay đổi mức nỗ lực suy luận hoặc tính sẵn có của công cụ. GitHub báo cáo số token prompt cần xử lý mới giảm hơn 50% trên hàng tỷ yêu cầu. Với một đội quân worker Luna đọc đi đọc lại cùng một repo suốt ngày, đó là phần lớn hóa đơn.
Bước bàn giao phải mang theo những gì
Đây là artifact, một mẫu bàn giao được thiết kế cho một mô hình đọc. Worker trả nó về Task khi dừng lại, và reviewer chỉ đọc cái này cộng với diff.
SH-312  Add retry with backoff to the webhook sender
Worker:   Agent "backend-worker" - Runtime Codex on gpt-6-luna
Attempts: 2 (attempt 1 failed on lint)
Diff:     4 files, +118 / -12   (worktree sh-312, commit a91f4c2)

Commands run, verbatim:
  $ pnpm lint            exit 0
  $ pnpm typecheck       exit 0
  $ pnpm test -- sender  exit 0   14 passed, 0 failed, 3 skipped
  $ pnpm build           exit 0

Not done:
  - The 3 skipped tests need a live webhook endpoint. Not run.
  - Did not touch the queue consumer, which has the same bug.

Assumptions made:
  - Max 5 retries, ceiling 30s. No spec said. Copied the values
    already used in payments/retry.ts.

Stopped because: acceptance criteria met.
Bốn đặc tính khiến gói thông tin đó xứng đáng với số token nó tiêu tốn.
Đây là artifact, không phải kể chuyện. Các lệnh và mã thoát có thể chạy lại. "Tôi đã xác minh hành vi này" thì không ai kiểm tra được.
Nó nêu rõ những gì chưa làm. Các bài test bị bỏ qua và queue consumer chưa bị đụng tới là hai thứ mà một bản tóm tắt sẽ bỏ sót, và chúng lại chính là hai thứ reviewer cần nhất. Hãy yêu cầu liệt kê những thiếu sót một cách tường minh, nếu không một bản tóm tắt gọn gàng sẽ không chứa chúng.
Nó ghi lại các giả định. Mọi Task có giới hạn đều chứa một quyết định mà bản đặc tả không đưa ra. Viết ra thì đó là một mục cần review. Bỏ qua thì đó là một bất ngờ trong production một tháng sau.
Nó nêu lý do dừng. Đã xong, bị chặn, hết ngân sách, và thất bại hai lần trông giống hệt nhau trong repo nhưng mang ý nghĩa khác nhau trên bảng trạng thái.
Reviewer trả về những gì
REVIEWER  Agent "review" - Runtime Claude Code on claude-opus-5-5
Reads:  repository prefix (cached), the packet, the full diff
Writes: at most 20 lines

VERDICT      changes requested
CHECKED      4 commands re-run, all exit 0. Backoff ceiling honoured.
UNVERIFIED   3 skipped tests. No evidence the retry path ever runs.
BLOCKING     Retry wraps the 4xx branch. A 422 will be retried 5 times.
FOR A PERSON Queue consumer has the same bug and is out of scope.
             Split SH-312, or widen it?
Dòng UNVERIFIED là thứ khiến reviewer xứng đáng với cái giá của nó. Một worker rẻ tiền sẽ không nói cho bạn biết khẳng định nào của nó chẳng dựa trên gì cả, một phần vì nó không biết. Một mô hình đắt tiền đọc một gói thông tin có cấu trúc có thể tách bạch phần nó đã xác nhận với phần nó tin tưởng suông, và sự tách bạch đó chính là sản phẩm của bước review. Dòng FOR A PERSON là nửa còn lại: reviewer không quyết định phạm vi, nó trả câu hỏi về lại cho Task.
Ranh giới giữ cho việc này trung thực: một reviewer Agent có thể chạy lại lệnh, đọc diff, và đánh dấu khác biệt giữa bằng chứng và lời khẳng định. Nó không thể nói cho bạn biết đây có phải là tính năng đúng đắn hay không. Điều mà một review Agent có thể và không thể xác minh là một danh sách cố định, và nó ngắn đi chứ không dài ra khi reviewer đắt tiền hơn.
Hai kiểu thất bại cần để mắt
Độ trễ là thứ đầu tiên, và nó khá phản trực giác. Artificial Analysis, một bên thứ ba chứ không phải nhà cung cấp nào, đo được các biến thể suy luận "max" mất 124.23 giây để ra token đầu tiên với Luna và 102.15 giây với Sol. [VERIFY] Hãy xác nhận lại những con số này với bảng niêm yết hiện tại trước khi dựa vào chúng. Hình dạng vấn đề quan trọng hơn con số cụ thể: ở mức nỗ lực suy luận cao, các mô hình rẻ không phải là những cái khởi động nhanh, nên một Crew đa mô hình sẽ có worker trông như bị treo và reviewer ngồi chờ chúng. Đó là một vấn đề về trạng thái, không phải vấn đề về mô hình.
Khối lượng review là thứ thứ hai. Mười worker Luna tạo ra mười gói thông tin. Nếu reviewer phê duyệt chín và đẩy một lên cấp cao hơn, bạn đã biến mười lượt chạy agent thành một quyết định của con người — đó chính là mục đích. Nếu nó đẩy sáu lên, bạn đã trả tiền cho việc review mà vẫn còn nợ sáu quyết định, và hàng đợi review vốn đã là điểm nghẽn rồi. Hãy theo dõi tỉ lệ đẩy lên cấp cao hơn theo từng worker Agent trong một Sprint. Nó cho bạn biết gói thông tin có quá mỏng hay các Task quá lớn, rất lâu trước khi hóa đơn cho thấy điều đó.
Khi nào không nên làm điều này
Hãy dùng một mô hình cho mọi thứ khi một người vận hành một hoặc hai Agent trên một repo. Gói thông tin là chi phí phụ trội, reviewer là một hóa đơn thứ hai, và dù sao thì bạn cũng chính là reviewer.
Hãy dùng Crew đa mô hình khi nhiều Agent chạy song song, khi có nhiều hơn một người có thể khởi động một lượt chạy, hoặc khi công việc đã hoàn thành vượt quá thời gian mà bất kỳ ai có để đọc nó.
Và đừng đặt mô hình đắt tiền vào vai trò review khi chính công việc mới là phần khó. Một cuộc migration phải giữ ngữ cảnh hàng giờ liền nên đặt thẳng trên Opus 5.5, với một Agent rẻ viết gói thông tin sau đó. Chọn theo vai trò nghĩa là chọn theo từng Task, không phải chọn một lần cho cả đội, đó là lý do khớp mô hình với vai trò agent là một nguyên tắc bạn viết ra giấy chứ không phải một thói quen mà sáu người âm thầm giữ riêng.
Con số không hề nhúc nhích
Chi phí cho mỗi task hoàn thành đã giảm mạnh ở cả hai phía của đợt ra mắt này. OpenAI báo cáo nhà nghiên cứu trung vị của họ chi hơn $600 mỗi ngày cho các coding agent, với phân vị thứ 90 vượt $7,000. Các đội nằm dưới mức đó giờ có thể chi trả cho lượng công việc agent nhiều gấp vài lần so với tuần trước.
Số giờ của reviewer thì vẫn y nguyên. Một Crew đa mô hình kiếm được chỗ đứng của nó bằng cách biến nhiều đầu ra rẻ thành ít quyết định của con người hơn, và điều đó chỉ xảy ra nếu bước bàn giao mang theo bằng chứng thay vì một bản tóm tắt. Giữ mục tiêu, diff, các lệnh, các điểm chặn, những khẳng định chưa xác minh, và việc con người review quay về với Task từ lúc yêu cầu đến lúc phát hành, thì việc chia mô hình trở thành một cài đặt bạn có thể thay đổi vào quý sau mà không cần thay đổi cách ai đó làm việc.
Sharkly không chạy mô hình và không chọn mô hình thay bạn. Nó là lớp Task, Computer, ngữ cảnh và review dùng chung quanh những công cụ làm việc đó, và đó là nơi một bước bàn giao phải sống nếu cả reviewer lẫn con người đều sẽ đọc nó. Nếu bạn đang chạy nhiều coding agent: kết nối một Computer, tạo một worker Agent và một reviewer Agent, rồi cho worker trả về gói thông tin đó với một việc nhàm chán nào đó.


