
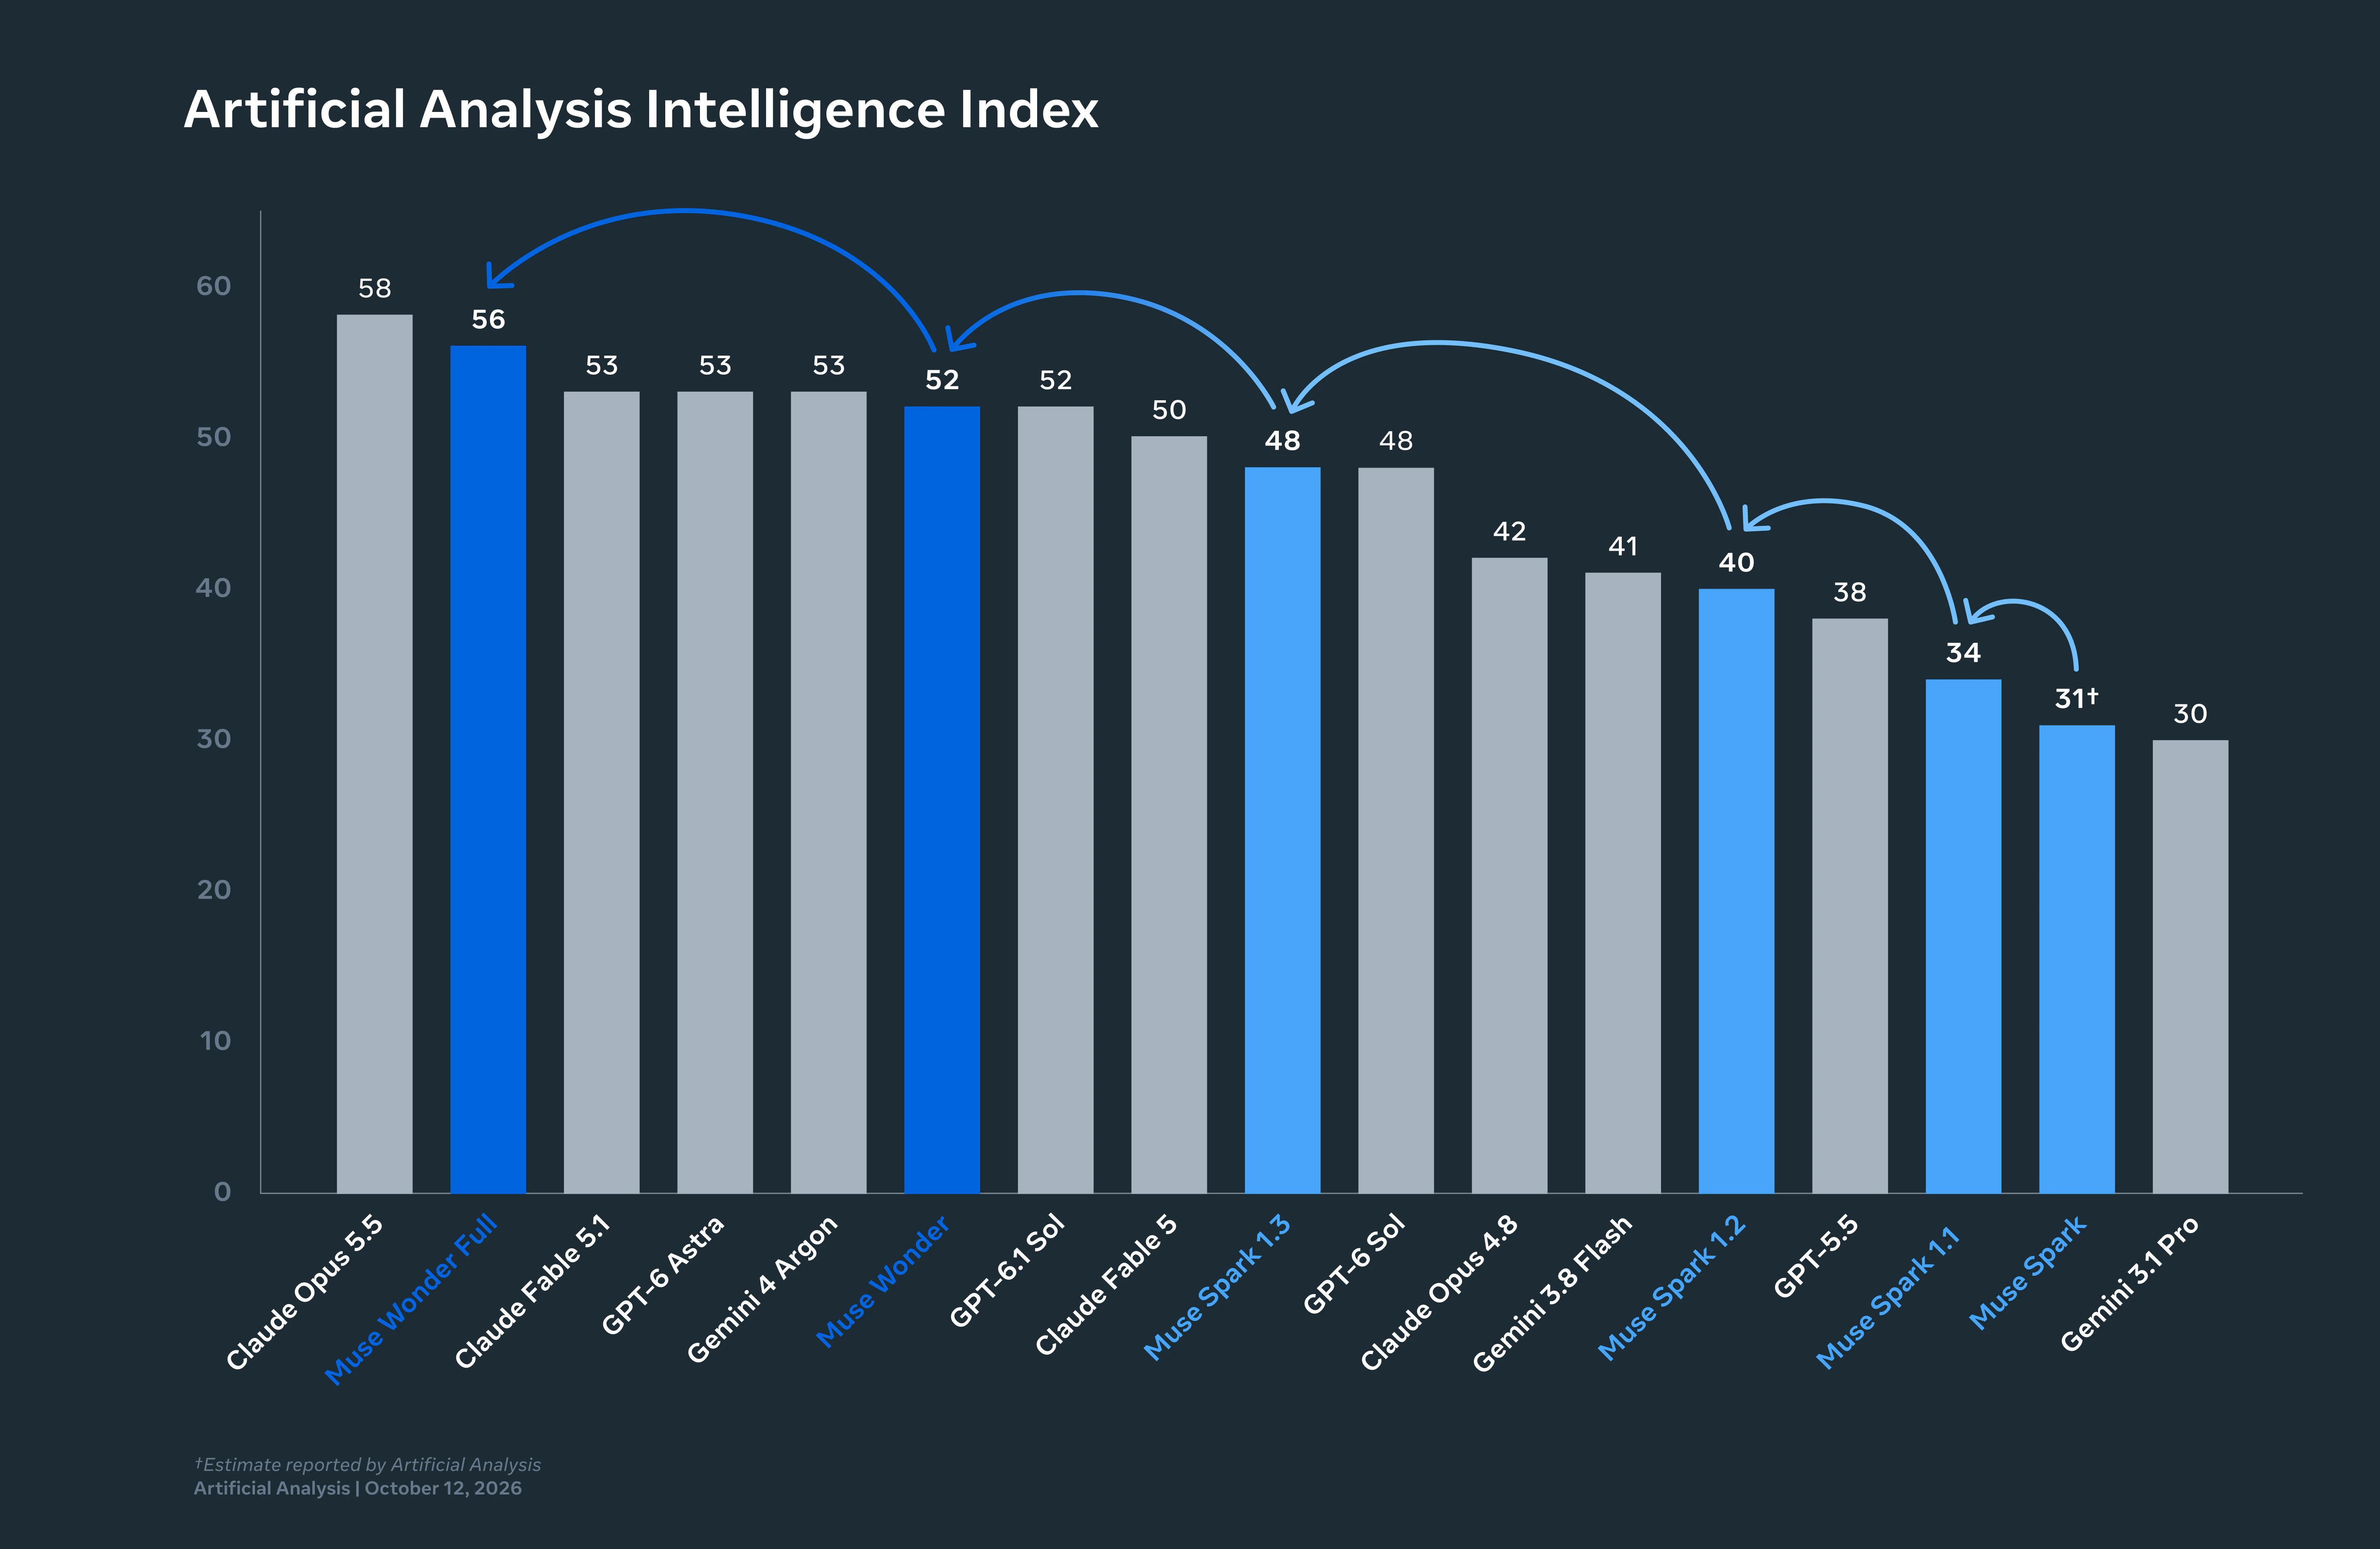
Muse Wonder và Claude Opus 5.5 có cùng mức giá, 4 USD cho mỗi triệu token đầu vào và 20 USD cho mỗi triệu token đầu ra. Do đó, đối với một Crew, việc lựa chọn giữa hai mô hình này không phải là bài toán ngân sách, mà là một quy tắc định tuyến (routing). Model card của Meta cho thấy Wonder dẫn trước ở benchmark đo lường khả năng lập trình tác vụ dài (SWE-Marathon, 53,1 so với 46,3), còn Opus lại vượt trội ở các tác vụ terminal (59,6 so với 52,0), trí tuệ tổng quát (58 so với 52 trên chỉ số độc lập) và khối lượng kiến thức (46 so với 25). Bốn con số này phác họa nên hai Agent hoàn toàn khác biệt, và một bảng phân việc biết định tuyến dựa trên các chỉ số đó sẽ khai thác tối đa sức mạnh của cả hai thay vì chỉ chọn một mô hình mặc định.
Bài viết này sẽ chuyển hóa những con số thành các phân bổ công việc cụ thể: Task nào nên giao cho Muse Wonder Agent, Task nào nên giữ lại cho Opus 5.5, ảnh hưởng của từng mô hình lên hàng đợi đánh giá (review queue), và cách xác định xem quy tắc định tuyến có hiệu quả hay không sau một tuần triển khai. Hướng dẫn thiết lập phân luồng cho Meta có tại cách chạy Muse Wonder agent trong Sharkly.
Những con số quan trọng trong định tuyến
| Chỉ số | Muse Wonder | Claude Opus 5.5 | Nguồn |
|---|---|---|---|
| SWE-Marathon (các phiên lập trình kéo dài) | 53.1 | 46.3 | Meta model card |
| DeepSWE 1.1 | 78.8 | 74.2 | Meta model card |
| Terminal-Bench 4.0 | 52.0 | 59.6 | Meta model card |
| AA-Omniscience (kiến thức) | 25 | 46 | Artificial Analysis |
| Tỷ lệ ảo giác (Hallucination rate) | 27% | thấp hơn, theo xếp hạng của AA | Artificial Analysis |
| Chỉ số trí tuệ (Intelligence Index) | 52 | 58 | Artificial Analysis |
| Chỉ số Coding Agents (Coding Agents Index) | 63 | 66 (Claude Code) | Artificial Analysis |
| Chi phí trên mỗi index task | $4.52 | $5.98 | Artificial Analysis |
| Đầu vào hỗ trợ | Văn bản, hình ảnh, video, âm thanh | Văn bản, hình ảnh, PDF | Tài liệu nhà cung cấp |
Hãy nhìn bảng số liệu này như hai hồ sơ năng lực riêng biệt. Wonder: kiên trì, chi phí trên mỗi tác vụ rẻ hơn nhờ phản hồi ngắn gọn súc tích, khả năng truy xuất kiến thức (recall) yếu hơn, hỗ trợ cả video lẫn âm thanh. Opus: xét tổng thể thì thông minh hơn, thao tác trong shell tốt hơn, hiểu biết rộng hơn, chi phí mỗi tác vụ cao hơn. Không có hồ sơ nào vượt trội tuyệt đối; chúng chỉ phù hợp với những Task khác nhau.
Những Task dành cho Muse Wonder Agent
Điểm chung của nhóm này là các tác vụ kéo dài và gặp nhiều trở ngại. Meta huấn luyện mô hình này theo phương pháp mà họ gọi là Active Focus (Tập trung chủ động) — liên tục thử nghiệm các hướng tiếp cận thay thế và kiên trì vượt qua các chướng ngại vật; và SWE-Marathon chính là benchmark được xây dựng để đo lường năng lực này.
- Refactor nhiều file và cần duy trì bộ test luôn xanh (pass). Quy trình gồm nhiều bước, mỗi bước đều có thể kiểm tra được, khi thất bại đòi hỏi phải thử hướng tiếp cận thứ hai, thứ ba.
- Nâng cấp dependency và framework. Tác vụ dài hơi kinh điển: nâng cấp, phát sinh lỗi, sửa lỗi, lặp lại; nơi nhiệm vụ tối quan trọng của mô hình là không bỏ cuộc ở bước thứ mười một.
- Vòng lặp sửa và xác thực với các bộ test chập chờn (flaky tests). Phiên chạy đòi hỏi mô hình phải phân biệt được đâu là lỗi do chính nó tạo ra và đâu là lỗi vốn có của bộ test.
- Các Task có đầu vào là video hoặc âm thanh. Một video quay màn hình ghi lại lỗi (bug), một bản ghi âm cuộc họp lấy yêu cầu. Opus 5.5 không thể xử lý các định dạng này.
Hãy viết tiêu chí nghiệm thu sao cho phiên chạy có thể tự kiểm tra được. Wonder phát huy hiệu quả tối đa khi Task nêu rõ “tất cả các bài kiểm tra trong packages/api đều pass và changelog đã có nội dung cập nhật”, và hoạt động kém nhất khi bản thân nó phải tự định nghĩa thế nào là hoàn thành.
Những Task nên giữ lại cho Opus 5.5
- Công việc đòi hỏi thao tác nhiều trên terminal. Các script hạ tầng, pipeline triển khai (deploy), bất cứ tác vụ nào mà agent phải hoạt động chủ yếu trong shell. Khoảng cách 7,5 điểm trên Terminal-Bench là một khác biệt thực tế rất rõ ràng.
- Bất cứ tác vụ nào phụ thuộc vào khối lượng kiến thức sẵn có. Điểm Omniscience 25 so với 46 đồng nghĩa với việc Wonder có nguy cơ thiếu hụt kiến thức cao gấp đôi. Đối với các API thư viện chưa từng gặp, các mã lỗi hiếm gặp hoặc kiến thức chuyên ngành đặc thù, Opus có thể trả lời trực tiếp từ bộ nhớ trong khi Wonder phải tìm kiếm hoặc phỏng đoán.
- Vai trò reviewer (người đánh giá). Agent đọc diff của Agent khác và thẩm định xem nó đúng hay sai phải là Agent thông minh nhất mà bạn có. Xét theo chỉ số tổng hợp thì đó chính là Opus, và mô hình Crew kết hợp nhiều mô hình vốn đã bố trí mô hình đắt giá hơn cho vị trí này.
- Các Task ngắn, giải quyết dứt điểm. Trên DeepSWE, hai mô hình bám đuổi sát nút; nhưng xét về trí tuệ tổng quát thì Opus dẫn trước. Nếu phiên chạy chỉ kéo dài mười phút, lợi thế về sự kiên trì của Wonder sẽ không có cơ hội thể hiện.
Tác động của từng mô hình lên hàng đợi đánh giá
Việc định tuyến thay đổi những gì xuất hiện trước mắt người đánh giá (reviewer), và đó mới chính là chi phí thực sự.
Một phiên chạy của Wonder trên một Task dài thường tạo ra một lộ trình dài hơn: nhiều lượt thử hơn, nhiều lần hoàn tác các phương án không thành công hơn, nhiều commit hơn. Đó là lúc mô hình đang thực hiện đúng phận sự của nó, nhưng điều đó cũng đồng nghĩa với việc phần diff không phản ánh toàn bộ câu chuyện. Reviewer cần nhật ký phiên chạy (run log), và đó là lý do vì sao chỉ dẫn (instructions) của Agent nên yêu cầu nó liên tục ghi lại những gì đã thử. Luận điểm đánh giá thủ công là điểm nghẽn càng trở nên đúng đắn hơn bao giờ hết: một mô hình kiên trì sẽ tạo ra nhiều thứ để đánh giá hơn trên mỗi Task, chứ không hề ít đi.
Lỗ hổng kiến thức của Wonder bộc lộ qua việc tự tin đưa ra những chi tiết sai lệch: một flag không hề tồn tại, một phương thức đã được đổi tên từ hai phiên bản trước. Tỷ lệ ảo giác của nó thuộc hàng thấp trong phân khúc, 27% theo đánh giá của Artificial Analysis, nhưng 27% không phải là số không. Hãy chỉ dẫn cho Agent tự xác minh lại trong repository bất cứ điều gì nó không chắc chắn và phải báo cáo rõ ràng khi không thể xác minh, đồng thời yêu cầu reviewer kiểm tra xác suất chính xác những dòng đó.
Ngược lại, một phiên chạy của Opus trên cùng Task đó có xu hướng tạo ra một lộ trình ngắn hơn, dứt khoát hơn và chi phí trên mỗi tác vụ cao hơn. Quá trình review trên mỗi lượt chạy sẽ nhẹ nhàng hơn. Tuy nhiên, khi Task kéo dài và có nhiều trở ngại, Opus lại dễ dừng lại giữa chừng, vô tình đẩy một loại việc khác vào hàng đợi: một Task mới hoàn thành được một nửa và cần phải điều chỉnh lại phạm vi (re-scoping).
Định tuyến thực tế qua ba Task ví dụ
Những ví dụ cụ thể sẽ giúp bạn áp dụng quy tắc này dễ dàng hơn khi phân công nhiệm vụ.
“Nâng cấp ORM từ v5 lên v7 trên toàn bộ các service; đảm bảo tất cả integration tests đều pass.” Chọn Wonder. Hàng chục bước thực hiện, một bộ test sẽ liên tục báo lỗi theo những cách khác nhau ở từng giai đoạn, và một vạch đích rõ ràng. Sự kiên trì của mô hình chính là tài sản quý giá nhất, và phiên chạy có thể tự mình kiểm tra tiêu chí nghiệm thu.
“Viết mã Terraform cho môi trường staging mới và thực thi apply.” Chọn Opus. Đòi hỏi thao tác shell nhiều, cần kiến thức chuyên sâu về hạ tầng, và là một hành động có thể để lại hệ quả. Điểm số Terminal-Bench nghiêng về Opus; còn phạm vi ảnh hưởng (blast radius) đòi hỏi Agent phải dừng lại để hỏi ý kiến trước khi chạy apply, bất kể đang dùng mô hình nào.
“Giải thích lý do vì sao payment webhook bị kích hoạt hai lần và đề xuất giải pháp xử lý.” Chọn Opus cho phần giải thích, bởi vì việc này phụ thuộc vào việc nắm rõ cơ chế retry của nhà cung cấp dịch vụ — một dạng năng lực truy xuất kiến thức (recall). Nếu phương án xử lý đề xuất chuyển thành một đợt sửa đổi nhiều file kèm theo các bài kiểm tra, Task tiếp nối đó có thể bàn giao cho Wonder.
Công thức chung: Chọn Wonder cho các Task được định nghĩa bằng một vạch đích rõ ràng; chọn Opus cho các Task được định nghĩa bằng khối lượng kiến thức cần có. Khi một Task bao gồm cả hai yếu tố, hãy chia nhỏ nó ra. Sharkly được xây dựng chính là để phục vụ việc phân tách như vậy: mỗi Agent phụ trách một Task trên một làn phân luồng riêng, và quá trình bàn giao được ghi nhận trực tiếp trên bảng thay vì chỉ nằm trong đầu của ai đó.
Vận hành song song cả hai và đánh giá kết quả
Hãy áp dụng quy tắc này lên bảng làm việc trong một tuần và để chính các Task đưa ra câu trả lời.
- Tạo Muse Wonder Agent và giữ lại Opus 5.5 Agent. Trong instructions của cả hai Agent, hãy yêu cầu hiển thị model id ở đầu báo cáo, vì Sharkly không hiển thị thông tin này.
- Phân công công việc theo quy tắc nêu trên chứ không dựa vào cảm tính. Giao các tác vụ dài và nhiều trở ngại cho Wonder, tác vụ terminal và đòi hỏi kiến thức cho Opus, còn việc review giao cho Opus.
- Sau một tuần, tổng hợp lại các Task mà mỗi Agent đã hoàn thành và thống kê ba điều: bao nhiêu Task bị trả về kèm câu hỏi thay vì kết quả, bao nhiêu Task cần chạy lại lần hai, và mỗi Agent nhận bao nhiêu nhận xét đánh giá (review comments).
Nếu các Task dài hạn của Wonder hoàn thành với ít lượt chạy lại hơn, còn các Task terminal của Opus cần ít chỉnh sửa hơn, thì quy tắc định tuyến của bạn đã chuẩn xác. Nếu các Task của Wonder thu hút quá nhiều comment đánh giá đến mức không bù đắp nổi số lượt chạy lại tiết kiệm được, hãy thu hẹp phạm vi công việc giao cho nó. Những con số trong bảng chỉ là giá trị trung bình trên các benchmark; chính các Task thực tế của bạn mới là bài kiểm tra quan trọng nhất.
Không khoản chi phí nào trong số này được tính vào hóa đơn của Sharkly. Chi phí sử dụng mô hình được tính trực tiếp qua các API key của Meta và Anthropic đã cấu hình trên Computer, và với cùng một mức giá niêm yết, chênh lệch chi phí duy nhất chỉ nằm ở con số mà khối usage ghi nhận sau mỗi lượt chạy.
Tháng này, các mô hình đã có sự thay đổi. Ngữ cảnh, tiến độ, các điểm nghẽn, kết quả và việc đánh giá của con người vẫn luôn minh bạch từ lúc yêu cầu đến khi phát hành. Bạn có thể tự thiết lập quy trình này bằng worktree, hoặc sử dụng Sharkly để quản lý toàn bộ luồng công việc.


