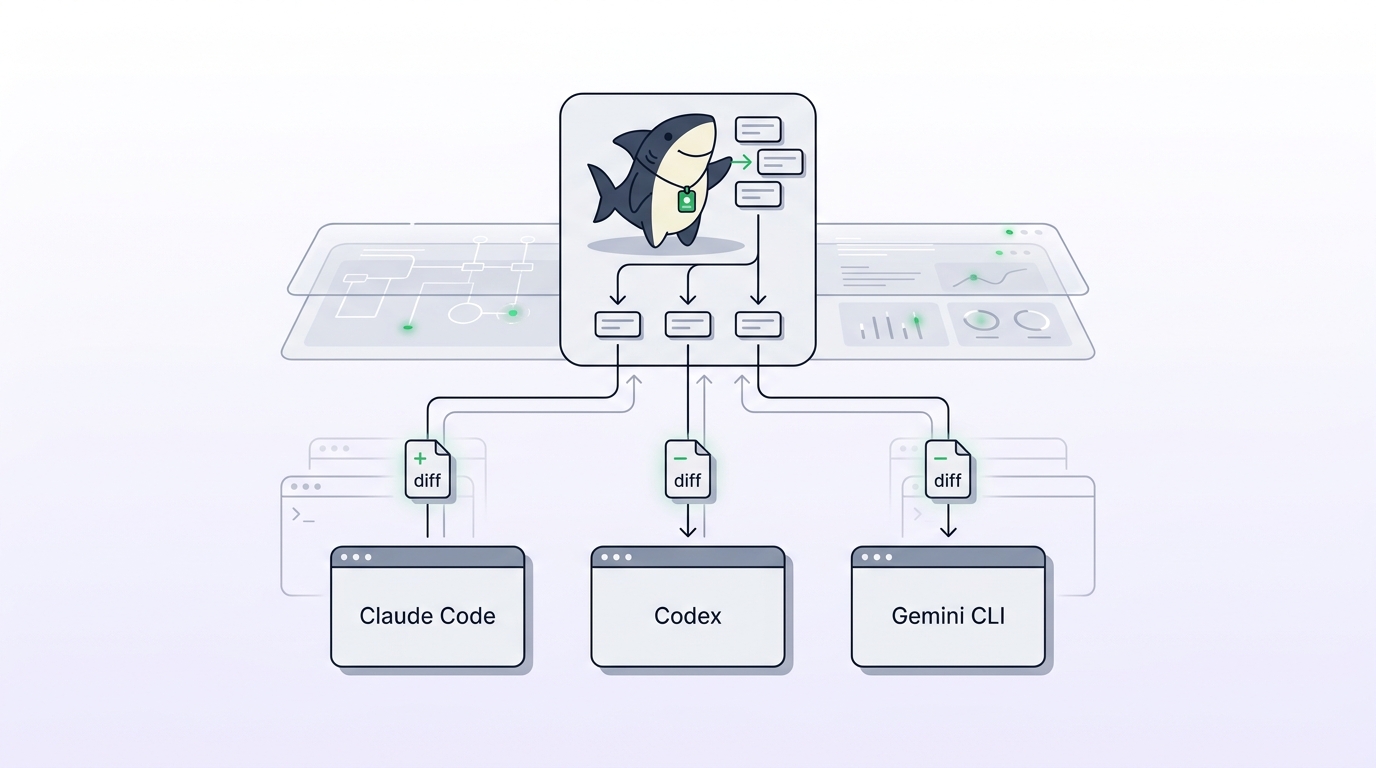
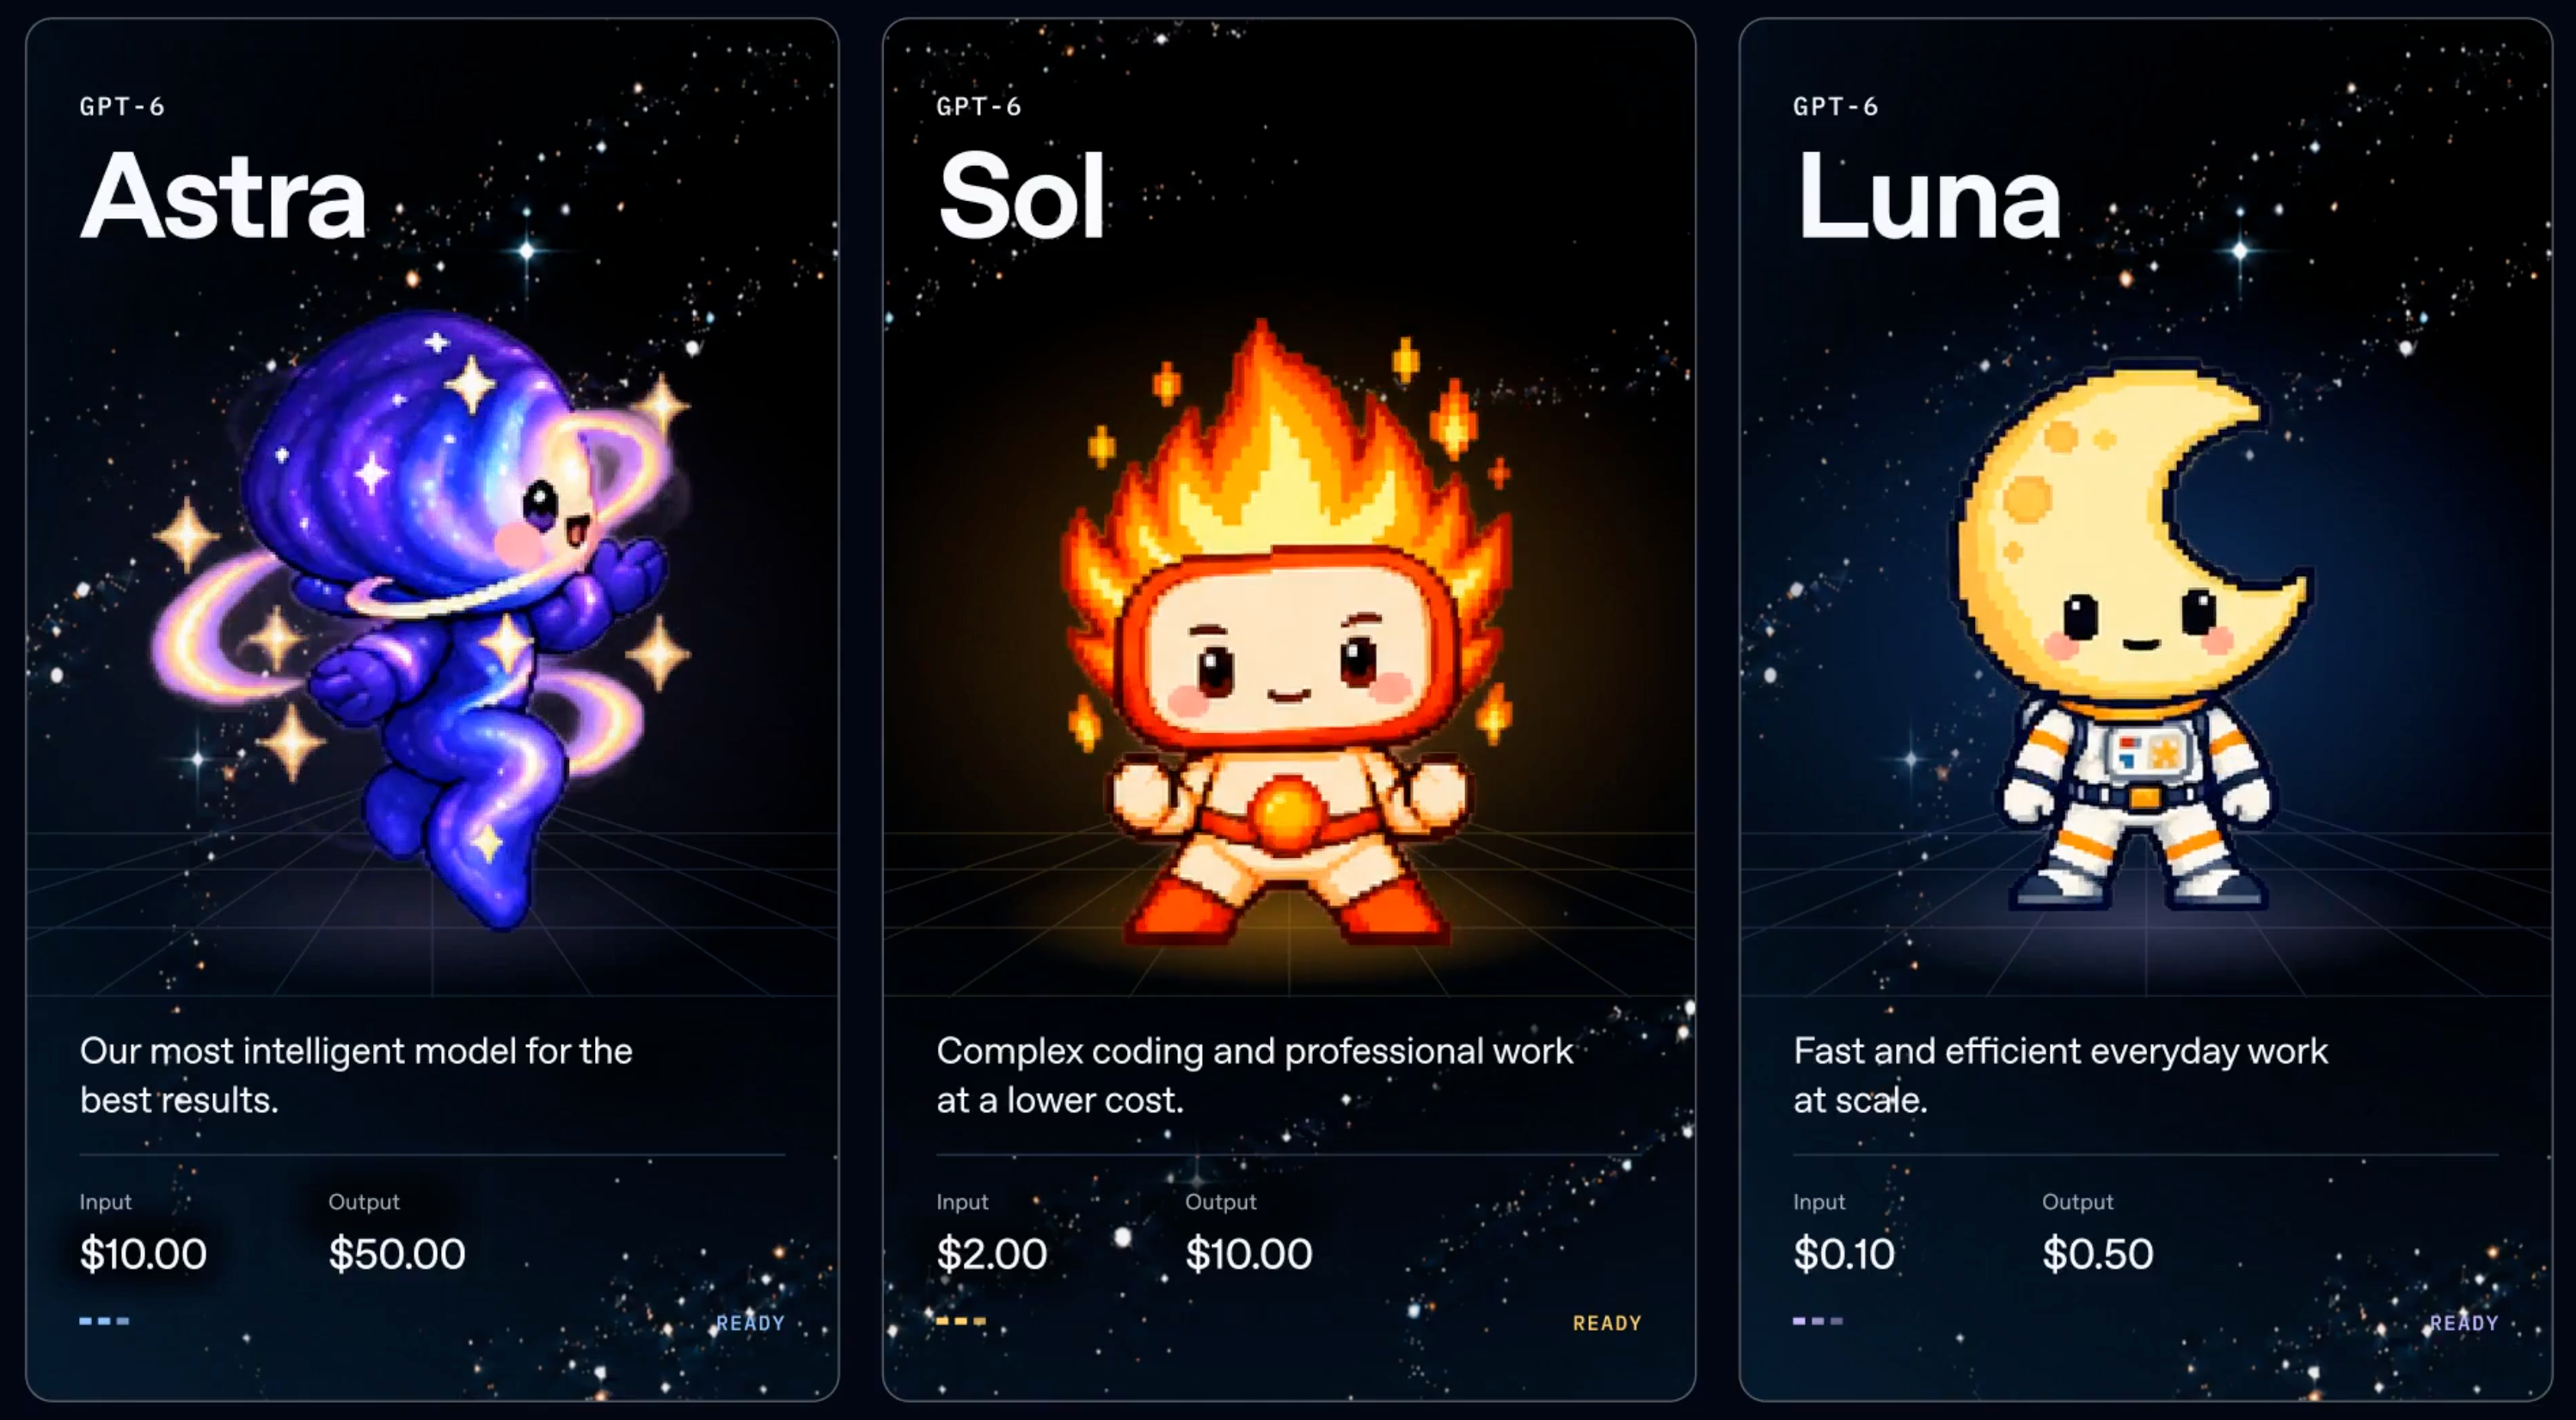
Hóa đơn là con số dễ thay đổi nhất nhưng lại là con số ít đáng chú ý nhất khi theo dõi. Nếu bạn định tuyến các công việc thường nhật của Crew sang GPT-6 Luna với mức giá 0,10 USD và 0,50 USD cho mỗi triệu token, dòng chi phí mô hình sẽ giảm sút chóng mặt chỉ trong vòng một ngày. Hai tuần sau, hóa đơn vẫn ở mức thấp, bảng công việc ghi nhận số lượt chạy hoàn tất nhiều hơn bao giờ hết, nhưng bốn thay đổi từ thứ Ba tuần trước vẫn đang nằm chờ ai đó phê duyệt.
Chẳng có gì trục trặc cả. Bạn chỉ vừa chuyển chi phí từ một mục mình đang theo dõi sang một mục chẳng ai định giá.
Chi phí cho mỗi thay đổi được chấp thuận là tổng số tiền và thời gian của con người bỏ ra cho mọi lượt thử nghiệm dẫn đến một thay đổi được ai đó phê duyệt. Con số này tính cả những lượt chạy thất bại, những phần kết quả không ai merge, và cả những phút giây ai đó phải bỏ ra để đưa ra quyết định cho cả hai khâu đó. Không nhà cung cấp nào công bố con số này, không bài benchmark nào đo lường nó, và đây lại là con số duy nhất thay đổi tương ứng với những gì đội ngũ của bạn thực sự bàn giao.
Tóm tắt nhanh
Một mô hình rẻ hơn sẽ làm giảm chi phí cho mỗi lượt thử nghiệm, nhưng lại làm tăng ba thứ phải trả bằng sự tập trung của người đánh giá: số lượt thử trên mỗi thay đổi được phát hành, lượng kết quả đầu ra trên mỗi lượt thử, và số quyết định phải đưa ra trên mỗi thay đổi được phát hành. Sự tập trung của con người không hề rẻ đi vào ngày 22/09/2026. Phân khúc giá rẻ thực sự tiết kiệm chi phí ở bất kỳ khâu nào máy móc tự quyết định lượt thử có đạt hay không, nhưng lại âm thầm đắt đỏ ở bất cứ nơi nào cần đến con người. Agent nghiên cứu, thực thi, kiểm thử và báo cáo. Con người định hướng, cấp quyền và chấp thuận kết quả. Giải pháp ở đây nằm ở việc thay đổi cách tính toán trước khi thay đổi định tuyến: hãy đo lường số lượt thử và số phút của con người cho mỗi thay đổi được chấp thuận, trên từng Runtime, đồng thời biến công việc đang chờ người xử lý thành một trạng thái có thể định lượng, thay vì chỉ là một cảm giác mơ hồ vào mỗi chiều thứ Sáu.
Ba đơn vị đo lường, và chỉ duy nhất một đơn vị thực sự thuộc về bạn
| Đơn vị | Đối tượng sử dụng | Ý nghĩa mang lại | Yếu tố bị bỏ qua |
|---|---|---|---|
| Trên mỗi triệu token | Trang định giá của nhà cung cấp | Chi phí cho đầu vào và đầu ra | Lượng token công việc của bạn tiêu tốn |
| Trên mỗi tác vụ hoàn thành | Bảng đánh giá benchmark | Chi phí cho một lượt thử được chấm điểm | Các lượt thử thất bại, codebase của bạn, khâu đánh giá |
| Trên mỗi thay đổi được chấp thuận | Đội ngũ của bạn | Chi phí toàn trình cho một thay đổi được phát hành | Không bỏ sót gì, và đó là lý do chẳng ai công bố nó |
Cả hai phòng thí nghiệm đều phát hành vào ngày 22/09/2026, và cả hai đều công bố số liệu theo cột ở giữa. Đừng đọc những bảng biểu đó như thể chúng là cột bên phải.
Chi phí và điểm số thực tế của phân khúc giá rẻ
| GPT-6 Luna | GPT-6 Sol | Claude Opus 5.5 | |
|---|---|---|---|
| API id | gpt-6-luna |
gpt-6-sol |
claude-opus-5-5 |
| Input / output per 1M | $0.10 / $0.50 | $2 / $10 | $4 / $20 |
| Cached input | Giảm 90% lượt đọc | Giảm 90% lượt đọc | $0.20 đọc, $5 ghi |
| Context | 1M | 872k | 1M |
| DeepSWE 1.1 at max reasoning | 66.6% | 68.8% | Không có trong tài liệu ra mắt |
| Artificial Analysis index | 37 | 48 | 58, đứng đầu trong 212 |
Anthropic báo cáo 40,0% trên AutomationBench cho Opus 5.5. OpenAI báo cáo 33,2% cho Sol ở mức reasoning cực cao trên AutomationBench 1.0.6, với chi phí 0,27 USD mỗi tác vụ. Hai phòng thí nghiệm, hai khung kiểm thử (harness), một con số chi phí công bố trên mỗi tác vụ. Cặp số liệu đó không thể so sánh trực tiếp, và việc không thể đối đầu sòng phẳng chính là vấn đề cốt lõi: không bảng dữ liệu nào của nhà cung cấp có thể giúp bạn tính ra chi phí cho mỗi thay đổi được chấp thuận.
Biến số ẩn thứ nhất: số lượt thử trên mỗi thay đổi được chấp thuận
OpenAI công bố Luna ở mức reasoning tối đa đạt 66,6% trên DeepSWE 1.1 và Sol ở mức tối đa đạt 68,8%. Theo tính toán của chúng tôi, điều đó đồng nghĩa với việc cứ khoảng ba lượt thử của Luna thì có một lượt không vượt qua kiểm thử. Repository của bạn không phải là DeepSWE và tỷ lệ của bạn sẽ khác, nhưng xu hướng cốt lõi vẫn giữ nguyên: phân khúc giá rẻ đạt điểm thấp hơn vài phần trăm không chỉ đơn thuần là kém hơn vài điểm trên mỗi lượt chạy, mà nó làm tăng thêm vài phần trăm khả năng trả về một kết quả đòi hỏi phải chạy lại một vòng nữa.
Chi phí tài chính cho vòng chạy lại đó vẫn không đáng kể. OpenAI báo cáo rằng Luna ở mức tối đa rẻ hơn 93% cho mỗi tác vụ so với Claude Opus 5 trên cùng bài benchmark. Cho dù số lượt thử tăng gấp đôi thì theo tính toán của chúng tôi, bạn vẫn tiết kiệm được khoảng 86%. Dòng chi phí mô hình không bao giờ là vấn đề đáng ngại.
Thế nhưng lượt thử thất bại lại tiêu tốn tài nguyên ở mọi khâu khác. Nó tạo ra một branch, một bản tóm tắt thay đổi và một quyết định thuộc về con người. Một lượt chạy thất bại không phải là con số không vô hại. Đó là một hạng mục đánh giá mà rốt cuộc chẳng mang lại bất kỳ thay đổi nào.
Biến số ẩn thứ hai: phân khúc giá rẻ đạt chất lượng tốt bằng cách suy nghĩ lâu hơn
Hãy nhìn vào nguồn gốc những con số ấn tượng của Luna. Con số 66,6% chỉ đạt được ở mức reasoning tối đa, và ghi chú về tính xác thực của OpenAI cho biết Luna khi nâng cao mức nỗ lực suy luận sẽ bắt kịp GPT-5.6 Sol với chi phí chỉ bằng khoảng một phần trăm. Phân khúc giá rẻ đạt được chất lượng chấp nhận được bằng cách bỏ ra nhiều nỗ lực suy luận hơn, và nỗ lực đó chuyển hóa thành lượng token đầu ra cùng thời gian thực tế trôi qua (wall clock).
Artificial Analysis, một bên thứ ba độc lập với hai nhà cung cấp, đo lường các biến thể reasoning tối đa và ghi nhận Luna đạt 153,9 token đầu ra mỗi giây với 124,23 giây cho token đầu tiên, còn Sol đạt 115,2 token mỗi giây với 102,15 giây. Hãy xem những con số này mang tính tham khảo: chúng đến từ bên thứ ba, áp dụng riêng cho các biến thể ở mức tối đa và sẽ biến động khi phòng thí nghiệm đo lường lại.
Hai hệ quả sẽ đổ dồn lên đội ngũ của bạn, chứ không xuất hiện trên hóa đơn. Một lượt chạy im lặng suốt hai phút trông chẳng khác nào một lượt chạy đã bị treo, khiến ai đó phải bỏ dở việc để vào kiểm tra. Và một chuỗi vết thực thi (trace) dài hơn kèm theo một bản diff dài hơn đồng nghĩa với việc có nhiều thứ để đọc hơn trên mỗi lượt thử trước khi ai đó có thể phê duyệt. Khả năng đọc hiểu và rà soát là tài nguyên khan hiếm, và bạn vừa mua thêm thứ tiêu tốn chính tài nguyên đó.
Biến số ẩn thứ ba: những quyết định, chứ không phải diff
Hãy đếm số quyết định của con người từ lúc một Task được giao đến khi một thay đổi được chấp thuận. Trên một Runtime mạnh, quy trình thông thường chỉ có một bước: đọc và phê duyệt. Nhưng trên một Runtime giá rẻ thực hiện công việc khó kiểm chứng tự động, quy trình sẽ rẽ nhánh, và mỗi nhánh đều cần đến con người:
- Lượt chạy thất bại. Thử lại trên cùng Runtime đó hay chuyển cấp (escalate) lên một Runtime mạnh hơn?
- Lượt chạy vượt qua các bài kiểm thử nhưng lại dùng một cách tiếp cận mà bạn không hề mong muốn. Chấp nhận hay yêu cầu làm lại?
- Lượt chạy tạo ra ba kết quả dang dở. Đâu mới là thay đổi cần dùng?
- Lượt chạy dừng lại để hỏi một điều gì đó. Ai sẽ trả lời, và câu trả lời đó được lưu trữ ở đâu?
Không điều nào trong số đó xuất hiện trên hóa đơn tính token. Tất cả chúng đều chiếm dụng lịch làm việc của bất kỳ ai phụ trách khâu con người đánh giá.
Công thức tính toán với số liệu thực tế của bạn
cost per accepted change
  = attempts per accepted change
      x (model cost per attempt + reviewer minutes per attempt x loaded cost per minute)
  + escalation cost when the cheap tier hands the job back
Hãy điền số liệu của chính bạn vào thay vì dùng số liệu của chúng tôi. Ở mức giá 0,10 USD và 0,50 USD cho mỗi triệu token, chi phí mô hình bên trong dấu ngoặc gần như bằng không, do đó toàn bộ biểu thức bị chi phối bởi số phút đánh giá nhân với số lượt thử. Việc chuyển sang một Runtime rẻ hơn sẽ thu nhỏ một mục chi phí vốn đã rất nhỏ, nhưng lại nhân lên gấp bội mục chi phí không hề nhỏ. Đôi khi đó vẫn là một sự đánh đổi hợp lý. Nhưng bạn không bao giờ có thể đánh giá được điều đó chỉ dựa vào trang báo giá.
Khi nào phân khúc giá rẻ thực sự tiết kiệm chi phí
Hãy dùng Runtime giá rẻ khi máy móc có thể tự đánh giá xem lượt thử có đạt hay không. Kiểm tra kiểu dữ liệu (typecheck), unit test, build, lint rule, kiểm tra schema: kết quả đánh giá được đưa ra trước khi con người phải bỏ công sức, và các lượt thử bổ sung được khung kiểm thử tự hấp thụ thay vì ngốn trọn ngày thứ Sáu của bạn. Đó là phần lớn khối lượng công việc trong một Crew đang vận hành, và cũng là lý do xác đáng nhất để định tuyến các tác vụ nhàm chán sang Luna.
Đừng dùng Runtime giá rẻ khi việc chấp thuận đòi hỏi sự phán đoán của con người. Các quyết định về kiến trúc, di chuyển dữ liệu (data migration), bất cứ điều gì liên quan đến bảo mật, hay bất kỳ chỗ nào mà câu hỏi “thế này đã đúng chưa?” không thể trả lời bằng một dòng lệnh. Ở những trường hợp đó, sự chênh lệch về điểm số sẽ chuyển hóa trực tiếp thành số phút rà soát của người đánh giá, và thứ rẻ nhất bạn có thể mua được chính là một lượt thử mà bạn chỉ cần đọc đúng một lần duy nhất.
Hãy quy định rõ quy tắc chuyển cấp thay vì để tùy thuộc vào sở thích cá nhân, bởi sở thích luôn bị đánh bại trước mức giá rẻ hơn. Định tuyến mô hình là một quy tắc đặt khả năng kiểm chứng lên hàng đầu và chi phí xuống hàng thứ hai.
Vì sao không nhà cung cấp nào nói cho bạn điều này
Cả hai phòng thí nghiệm đều công bố benchmark đối đầu nhau trong cùng một ngày, và mốc so sánh của OpenAI là Claude Opus 5 – mô hình mà chỉ vài giờ sau đó đã bị Anthropic thay thế bằng Opus 5.5. Phân khúc giá rẻ của mỗi nhà cung cấp chính là phần đầu phễu tiếp thị của họ. Không ai dại gì công bố câu nói “mô hình giá rẻ của chúng tôi sẽ khiến đội ngũ review của bạn phải tốn thêm một lượt kiểm tra”, và họ cũng chẳng sai khi lược bỏ điều đó: con số thực tế phụ thuộc hoàn toàn vào codebase và con người trong đội ngũ của bạn.
Sharkly không bán token mô hình. Việc sử dụng mô hình vẫn diễn ra thông qua các gói đăng ký hoặc API key đã được cấu hình trong các công cụ mà đội ngũ của bạn đang dùng, do đó bài viết này hoàn toàn khách quan, không phụ thuộc vào việc bạn chọn Runtime nào. Đây là vị thế duy nhất cho phép lập luận này được đưa ra một cách trung thực, và đó cũng là lý do quy trình làm việc của bạn vẫn sẽ đứng vững khi mô hình giá rẻ tiếp theo ra mắt mà không cần phải đập đi xây lại.
Những chỉ số bạn nên đưa lên dashboard thay thế
Số phút của con người trên mỗi thay đổi được chấp thuận, theo từng Runtime. Nếu con số đó tăng lên sau khi chuyển đổi, mô hình rẻ hơn thực chất lại đắt hơn và giờ đây bạn đã có bằng chứng rõ ràng. Chi phí bằng tiền trên mỗi lượt chạy chỉ trả lời cho một câu hỏi vốn đã không còn mang tính quyết định kể từ ngày 22/09/2026.
Số lượt thử trên mỗi thay đổi được chấp thuận, theo từng Runtime. Biến số này quyết định mọi thứ khác và không một nhà cung cấp nào có thể cung cấp nó cho bạn. Bạn có được con số này bằng cách ghi nhận Runtime nào đã tạo ra từng lượt thử, gắn liền với chính Task tương ứng.
Chờ người xử lý như một trạng thái thực tế. Tiến trình thực thi, các điểm nghẽn, kết quả và thảo luận tiếp theo đều được đưa về timeline của Task, nhờ đó hàng đợi cần đến con người có thể định lượng được thay vì chỉ là phỏng đoán cảm tính. Hãy yêu cầu mỗi lượt chạy phải đính kèm đầy đủ bằng chứng:
Before a run reaches a person, the Task carries:
- the change summary
- typecheck, test, and build results
- known limits and what was not attempted
- the attempt number and which Runtime produced it
Ở quy mô nhỏ, bạn không cần đến bất kỳ điều nào trong số này. Nếu chỉ có một người chạy hai Agent và đọc toàn bộ kết quả ngay trong buổi chiều hôm đó, hãy cứ tiếp tục làm như vậy: các trạng thái và hàng đợi lúc này chỉ là gánh nặng phức tạp hóa cho một vấn đề mà bạn chưa gặp phải. Việc tính toán chi tiết chỉ bắt đầu quan trọng khi không ai có thể nhớ nổi có bao nhiêu lượt chạy đã hoàn tất đang nằm chờ duyệt.
Phần chi phí không hề rẻ đi
Hai phòng thí nghiệm cùng giảm giá lượt thử trong cùng một ngày. Nhưng chẳng bên nào phát hành công cụ có thể đọc diff thay cho bạn, và trách nhiệm làm chủ thay đổi cuối cùng vẫn thuộc về con người. Một mô hình rẻ hơn không đồng nghĩa với một quy trình làm việc rẻ hơn. Đó chỉ là một lượt thử rẻ hơn, và các lượt thử đó lại tiếp tục nạp vào một quy trình mà khâu đắt đỏ nhất chính là con người.
Nếu bạn đã và đang vận hành nhiều agent lập trình, Sharkly mang đến cho bạn một nơi duy nhất để theo dõi Runtime nào đã tạo ra lượt thử nào, các bằng chứng đi kèm là gì, và hiện có bao nhiêu công việc đang nằm chờ người xử lý.