
تقول Anthropic إن Claude Opus 5.5 يكلّف 40% أقل للتشغيل من Opus 5. وقد أجرى أحدهم في فريقك بالفعل الحسبة البديهية: الميزانية نفسها، أي نحو 1.7 ضعف من تشغيلات الوكلاء، وبالتالي نحو 1.7 ضعف من العمل المُسلَّم. هذه الحسبة صحيحة حسابيًا وخاطئة تشغيليًا، والأسبوع الذي يُبنى فيه عليها هو الأسبوع الذي يمتلئ فيه مجلس إدارتك بتشغيلات مكتملة لم يقرأها أحد.
لم يكن القيد على تشغيل مزيد من الوكلاء بالتوازي هو فاتورة النموذج قط. بل كان قدرة شخص واحد على قراءة الـ diff، وفهم ما قرّره الوكيل، وقبوله. وتخفيض السعر لا يفعل شيئًا تجاه هذا الرقم. إنه يرفع السرعة التي يصل بها العمل إليه.
باختصار
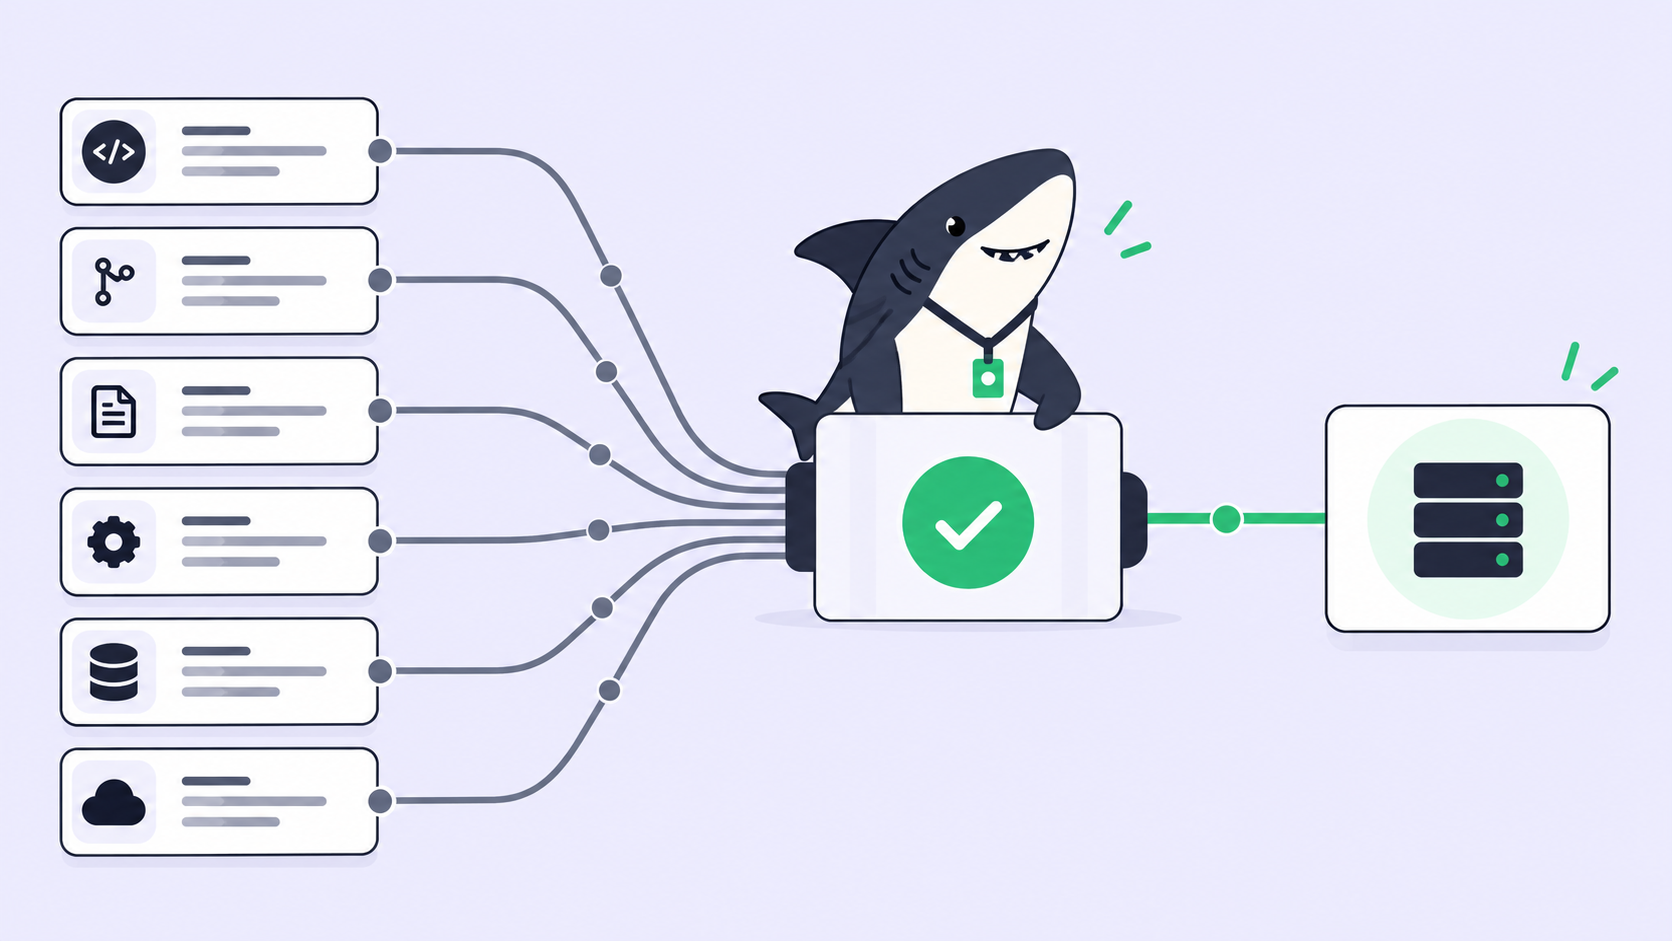
سقف المراجعة هو عدد تشغيلات الوكلاء المكتملة التي يستطيع الفريق فعليًا قراءتها والحكم عليها وقبولها في اليوم، وهو محدَّد بالأشخاص لا بالـ tokens. النماذج الأرخص ترفع معدل الوصول إلى ذلك السقف وتترك السقف نفسه على حاله، لذا فإن أول أثر ظاهر لتخفيض السعر هو طابور أطول، لا إصدار أسرع. الوكلاء يبحثون وينفّذون ويختبرون ويقدّمون التقارير. أما الأشخاص فيحدّدون الاتجاه، ويمنحون الصلاحية، ويقبلون النتيجة. والاستجابة المفيدة هي تقييد التوازي بناءً على عدد المراجعين لا على الميزانية، وفصل عمل الوكلاء الذي يتقارب نحو نتيجة واحدة قابلة للمراجعة عن العمل الذي يتفرّع إلى نتائج كثيرة. تُبقي Sharkly السياق والتقدّم والعوائق والنتائج والمراجعة البشرية ظاهرة على المهمة من الطلب حتى الإصدار، وهذا ما يجعل الطابور قابلًا للعدّ في المقام الأول.
ما الذي أصبح أرخص فعليًا
أطلق مختبران إصداراتهما في 2026-09-22. إليك الجزء الذي يمسّ فاتورتك.
| Claude Opus 5 | Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | |
|---|---|---|---|---|
| معرّف API | claude-opus-5 |
claude-opus-5-5 |
gpt-6-sol |
gpt-6-luna |
| الإدخال لكل مليون token | $5 | $4 | $2 | $0.10 |
| الإخراج لكل مليون token | $25 | $20 | $10 | $0.50 |
| الإدخال المخزّن مؤقتًا | n/a | $0.20 قراءة، $5 كتابة | خصم 90% على القراءات | خصم 90% على القراءات |
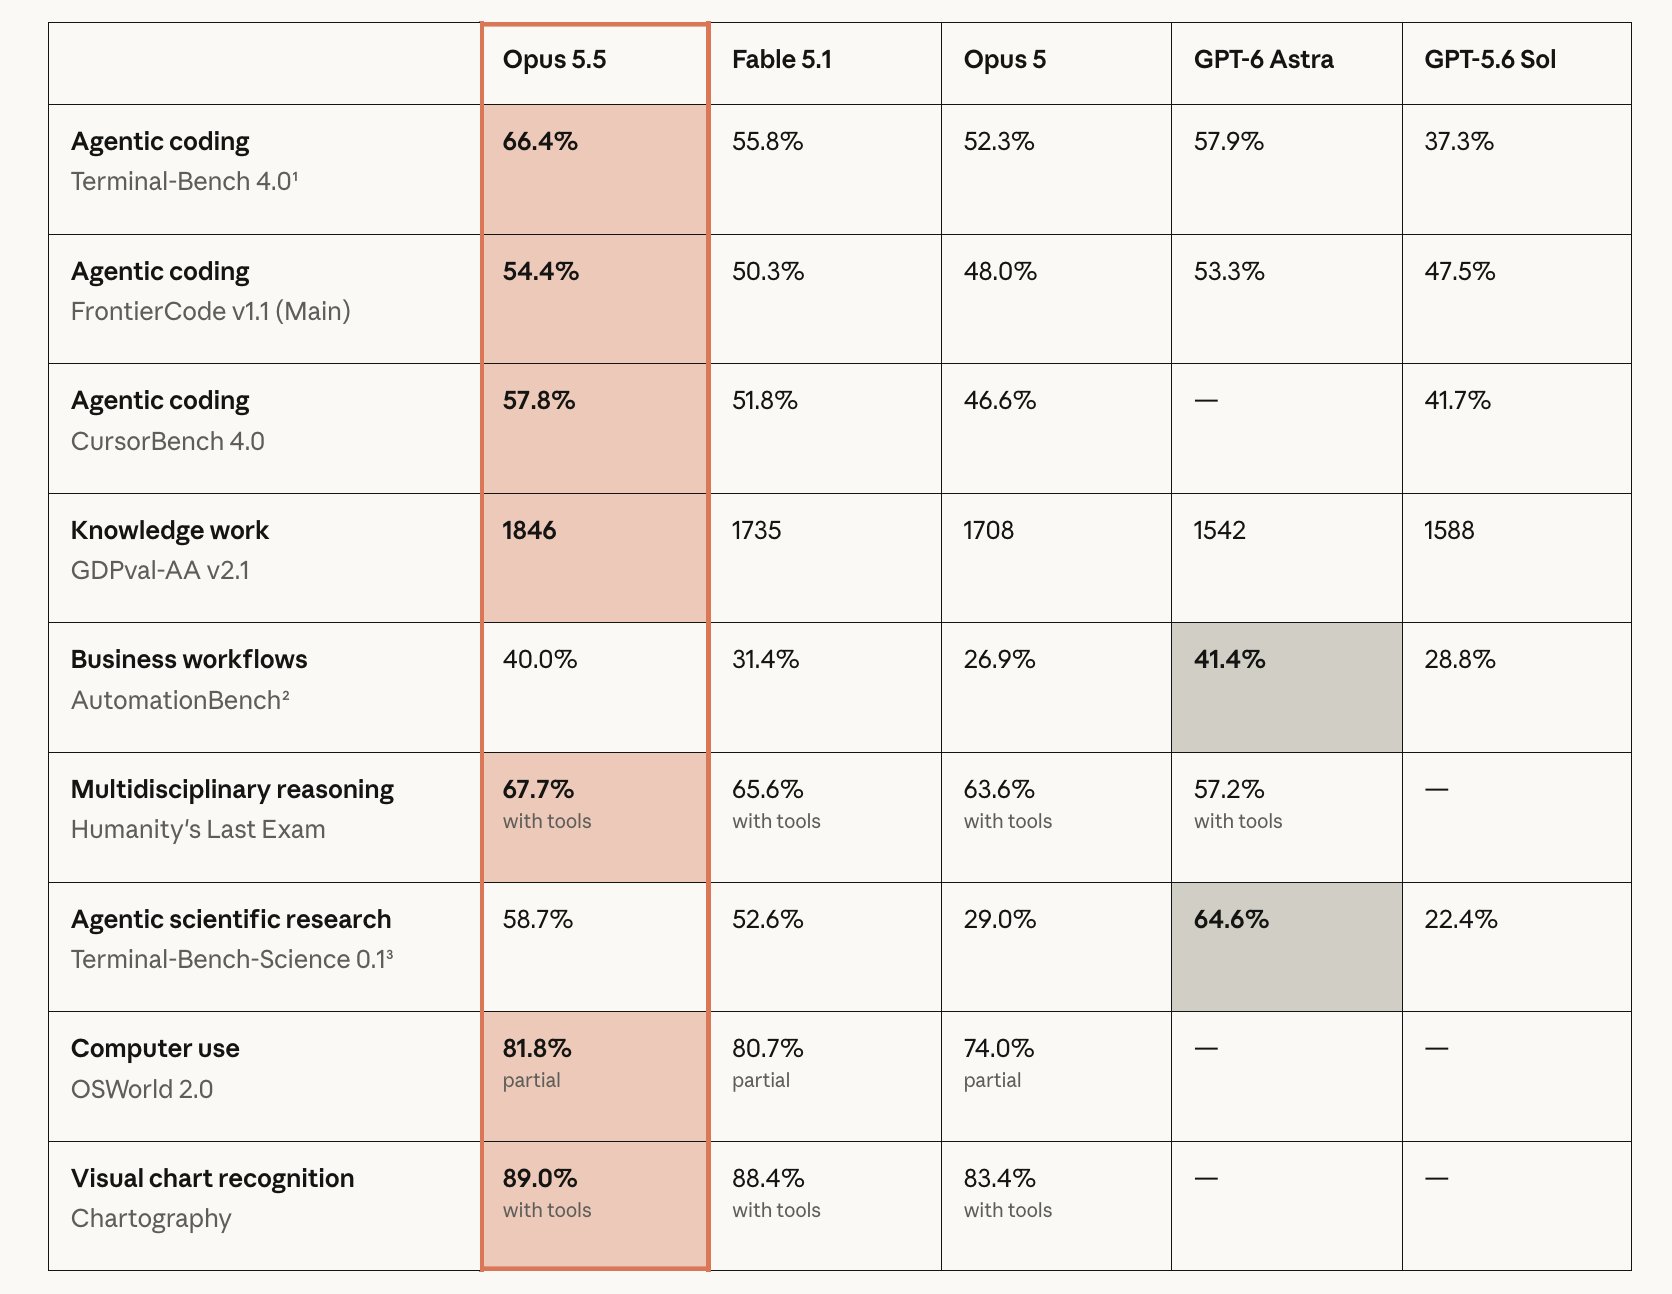
تذكر Anthropic أن Opus 5.5 يكلّف 40% أقل للتشغيل من Opus 5، وينتج مخرجات أسرع بنحو 30%. والأسعار المذكورة أعلاه أقل بنسبة 20% من سعر token Opus 5، وهي حسبتنا الخاصة من رقمين منشورين ومطالبة منفصلة عن الـ 40%. وتذكر OpenAI أن Sol و Luna كلٌّ منهما أرخص بنسبة 50% من التسعير الترويجي لـ GPT-5.6، و"ترويجي" هي كلمة OpenAI نفسها، لذا فإن ذلك العنوان يُقاس مقابل سعر مخفَّض لا مقابل سعر قائمة.
تحرّكت تكلفة المهمة المكتملة أكثر من تكلفة الـ token. فعلى AutomationBench 1.0.6، تُفيد OpenAI بأن GPT-6 Sol عند التفكير العالي جدًا يسجّل 33.2% بتكلفة $0.27 للمهمة، مقابل Claude Opus 5 عند أقصى تفكير بتسجيل 26.9% بتكلفة تفوق نظيرتها في Sol بـ 11.1 ضعفًا. وعلى DeepSWE 1.1، تضع OpenAI نموذج GPT-6 Luna عند أقصى تفكير عند 66.6% وأرخص بنسبة 93% لكل مهمة من Opus 5.
إذن انخفضت تكلفة المحاولة كثيرًا، عبر مورّدين اثنين، في يوم واحد. ولم يتغير أي شيء آخر في أسبوعك.
الحسبة التي أجراها الجميع هذا الأسبوع
ثبّت الإنفاق واقسم. عند تكلفة تشغيل أقل بنسبة 40%، يشتري المبلغ الشهري نفسه نحو 1.67 ضعف من تشغيلات Opus 5.5 مقارنة بتشغيلات Opus 5. وجّه النصف الروتيني من العمل إلى Luna بدلًا من ذلك فيصبح المضاعِف غير مثير للاهتمام، لأن عند $0.10 و$0.50 لكل مليون token لم يعد بند النموذج هو ما تضع له ميزانية.
الآن أجرِ الحسبة الثانية، تلك التي تحدّد هل سيُسلَّم أي من ذلك فعلًا. خُذ عدد التشغيلات المكتملة التي يستطيع أحد مهندسيك قراءتها بشكل صحيح في اليوم. لا قراءة سطحية، ولا موافقة على علامة خضراء: اقرأ الـ diff، وافهم ما اختار الوكيل فعله، وتحمّل مسؤوليته. وأيًا كان هذا الرقم، فقد كان نفسه في 2026-09-21 وسيبقى نفسه في الربع القادم. حسابات سعة المراجعة تنتهي إلى نتيجة سيئة حتى قبل تخفيض السعر، وتخفيض السعر لا يغيّر سوى جانب الإدخال.
تخفيض السعر ليس زيادة في السعة. إنه تغيير في مدى رخص إنتاج شيء لا يزال يحتاج إلى شخص.
الدليل: لم تكن التكلفة هي ما أوقفك
لو كانت تكلفة النموذج هي القيد الملزم، لكانت الفرق تشغّل أرخص إعداد يفي بالغرض. لكنها لم تفعل. أرقام OpenAI نفسها تقول إن الباحث الوسيط في مؤسستها يستهلك أكثر من $600 يوميًا من الاستدلال بأسعار API، وأن الشريحة المئوية التسعين تستهلك $7,000 يوميًا. ويُظهر جدول المعايير المنشور لديها فرقًا تستخدم عن قصد إعدادًا أعلى تكلفة بـ 11.1 ضعفًا لكل مهمة للحصول على نتيجة أدنى، لأن نتيجة تثق بها أغلى قيمة من نتيجة عليك التحقق منها مرتين.
هذا هو شكل القيد الحقيقي. يدفع الناس مضاعفًا كبيرًا مقابل مخرجات تحتاج إلى تدقيق بشري أقل لكل وحدة. المورد النادر الذي يُشترى هو الانتباه، لا الحوسبة، وقد كان يُشترى أصلًا بعلاوة سعرية كبيرة.
وهذا يعني أن تخفيض السعر يسقط بشكل غير متماثل. فهو يجعل جانب التوليد أرخص ويترك جانب القبول تمامًا حيث كان.
التفرّع الذي يتقارب، والتفرّع الذي يصل إلى المجلس
إليك التمييز الذي يجعل النماذج الرخيصة مفيدة حقًا بدلًا من كونها مكلفة في صمت، وهو التمييز الذي يتخطاه معظم الفرق.
بعض التوازي يتقارب. يحاول ثلاثة وكلاء الترحيل نفسه في worktrees معزولة، وتختار مجموعة اختبارات ووكيل قائد المحاولة التي تنجح، فتصل نتيجة واحدة إلى شخص. تضاعفت التكلفة ثلاث مرات ولم يتغيّر عبء المراجعة. هنا يشتري لك تخفيض السعر إنتاجية حقيقية، وهنا تستحق الاقتصاديات الجديدة أن تغيّر إعدادك من أجلها.
وبعض التوازي يتباعد. يلتقط عشرة وكلاء عشر مهام غير مترابطة وينتجون عشرة diffs، وعشرة ملخّصات تغيير، وعشر قرارات قبول. التكلفة هي التشغيلات العشرة نفسها. أما عبء المراجعة فهو عشرة أضعاف وحدة انتباه الشخص الواحد.
| تفرّع متقارب | تفرّع متباعد | |
|---|---|---|
| مثال | 3 محاولات لترحيل واحد، أفضل واحدة تفوز | 10 مهام، 10 مُكلَّفين، 10 diffs |
| ما تشتريه النماذج الأرخص | محاولات أكثر، واحتمال أعلى بأن تكون إحداها جيدة | عمل منتهٍ أكثر في الانتظار |
| عناصر المراجعة المنتَجة | 1 | 10 |
| آمن للتوسّع بناءً على السعر وحده | نعم | لا |
استخدم النماذج الرخيصة لتوسيع التفرّع المتقارب بالقدر الذي تحتمله صبرك على إعادة المحاولات. ولا تستخدمها لتوسيع التفرّع المتباعد بما يتجاوز عدد مراجعيك، مهما أصبحت التشغيلات ميسورة التكلفة. هذا هو زوج القرارات الصادق، والشق الثاني منه هو الذي يكلّف مالًا عند تجاهله.
ما ينبغي تغييره بدلًا من الميزانية
قيّد التوازي بناءً على المراجعين، لا على الإنفاق. اكتب القاعدة في مكان يراه الـ Crew: يجب ألا يتجاوز عدد المهام المفتوحة المنتظرة لقبول بشري عدد المراجعين في الوردية مضروبًا في عدد المراجعات التي ينجزها أحدهم في الوردية. هذان رقماك أنت، لا رقمانا. وعند بلوغ الحد، يتوقف الوكلاء عن المطالبة بمهام جديدة حتى لو سمحت الميزانية بذلك. قاعدة توجيه مكتوبة تتغلب على مجرد تفضيل هنا، لأن التفضيل يخسر بهدوء أمام سعر أرخص.
اجعل "في انتظار شخص" حالة ظاهرة. فالتشغيل الذي انتهى والتشغيل الذي توقف لطرح سؤال يبدوان متماثلين من الخارج، وكلاهما غير مرئي إذا كان السجل الوحيد هو نافذة الطرفية. يجب أن يعود التنفيذ والعوائق والنتائج والنقاش اللاحق إلى الجدول الزمني للمهمة، فيصبح الطابور شيئًا يمكنك عدّه لا شعورًا ينتابك يوم الجمعة.
سعّر المراجعة، لا الـ tokens. تتبّع التكلفة عبر الوكلاء الذي يقدّم الدولارات لكل تشغيل يجيب عن سؤال لم يعد ملزمًا. الرقم الذي يستحق أن يوضع على لوحة معلومات هو دقائق الإنسان لكل تغيير مقبول. وإذا ارتفع هذا الرقم بعد تحوّلك إلى نموذج أرخص، فالنموذج الأرخص أغلى.
أنفق جزءًا من الوفر على الأدلة. فالتشغيل الذي يرفق فحص الأنواع ونتائج الاختبارات وملخّص التغيير والحدود المعروفة يكلّف tokens أكثر وانتباهًا أقل. وعند $0.20 لكل مليون قراءة إدخال مخزّن على Opus 5.5 وخصم 90% على القراءات المخزّنة على GPT-6، تصبح جولة التحقق الإضافية شبه مجانية، وتشتري لك المورد الذي كان نادرًا فعلًا.
إلى أين يترك هذا الأسبوع
خفّض مختبران سعر المحاولة في اليوم نفسه، وأجرى أحدهما قياسًا مقابل نموذج استُبدل بعد ساعات. ولم يُطلق أيٌّ منهما شيئًا يقرأ لك الـ diff. الملكية البشرية للعمل هي الجزء الذي لم يصبح أرخص بنسبة 40%، وهي الجزء الذي يحدّد ما يصل إلى الإنتاج.
إذا كنت تشغّل بالفعل عدة وكلاء برمجة، فالخطوة المفيدة هذا الأسبوع ليست رفع رقم التوازي. بل معرفة سقف مراجعتك الفعلي، ثم ضبط التوازي ليطابقه. يمنحك Sharkly مكانًا واحدًا لرؤية التشغيلات والعوائق والنتائج وطابور العمل المنتظر لقبول شخص له.


