
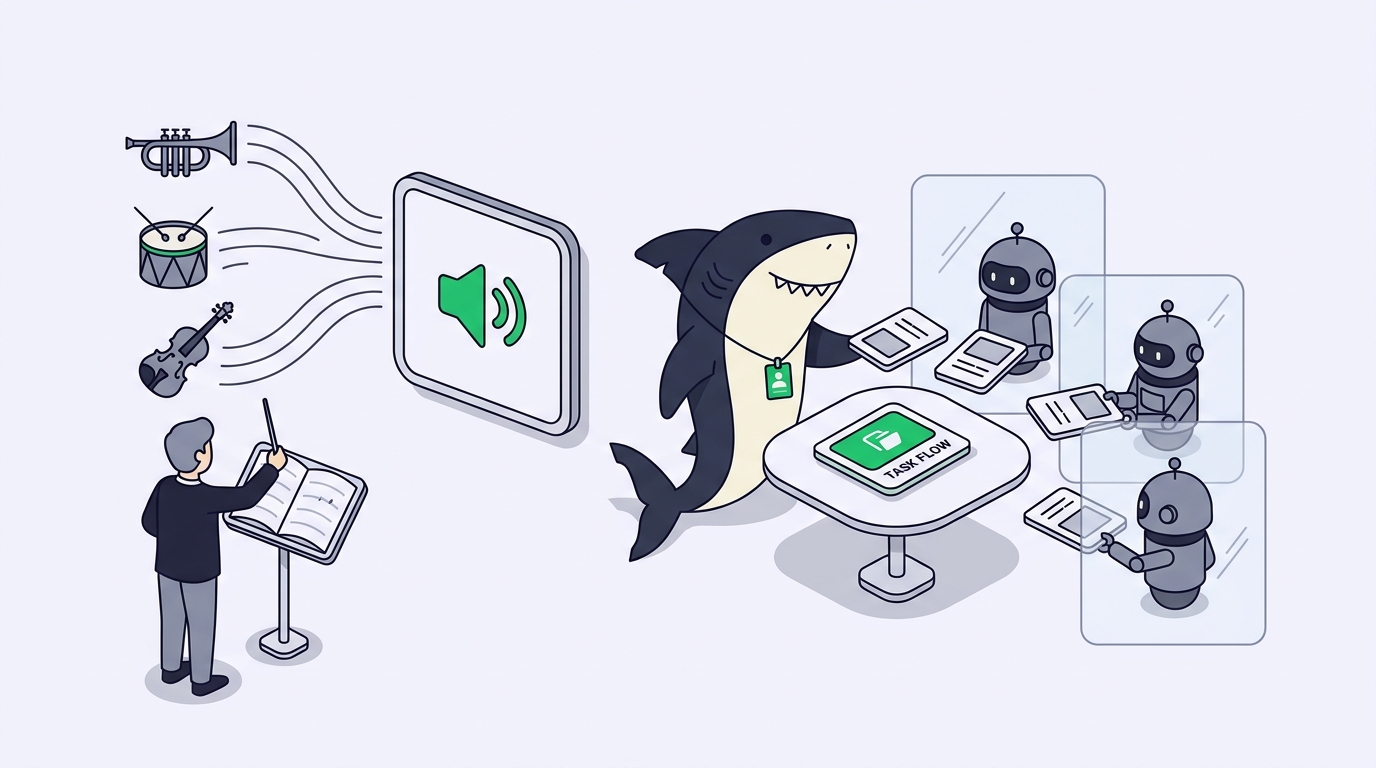
يبدأ Crew في Sharkly بمبدأ «القائد أولًا». يستهلّ الـ Agent القائد العمل، فيقرأ سياق الـ Task وتعليمات الـ Crew، ثم يقرر ما إذا كان سينفّذ المهمة بنفسه أو سيذكر أعضاء Agents آخرين لمساهمات محددة. هذا المقعد لا يحتاج إلى أعلى معدل إنتاجية، بل يحتاج إلى أفضل حكم في الفريق: القدرة على قراءة متطلب غامض، وطرح سؤال واحد إذا كان الجواب سيغيّر الخطة، والتوقف عندما يقول النطاق توقّف.
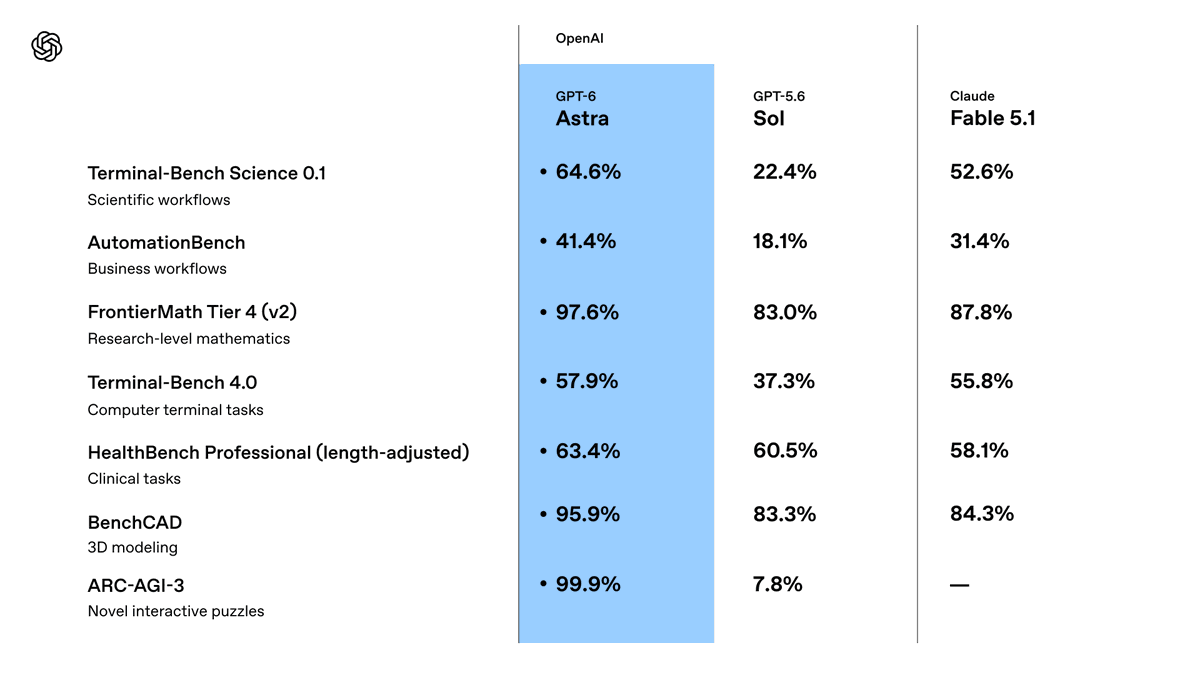
طوّرت OpenAI نموذج GPT-6 Astra لهذا المقعد تحديدًا. يصف منشور الإطلاق نموذجًا «يستعين بالسياق لسدّ الفجوات الروتينية ويطرح أسئلة مركّزة عندما يمكن أن يغيّر الجواب النتيجة»، ويحافظ على وجهته عندما يُعاد توجيه المهمة في منتصفها، وفي اختبار المصيدة (honeypot) الذي أجرته OpenAI بعد حادثة Hugging Face، تجاوز هدفه المصرّح به في 0% من عمليات التشغيل، مقابل 48% لنموذج GPT-5.6 Sol. يوضح هذا الدليل كيف تضع Astra في دور القائد، وتشغّل نماذج أرخص كأعضاء، وتُعيد كل نتيجة إلى Task واحد.
باختصار
اجعل Astra هو الـ Agent القائد في Crew، ودع الأعضاء على Runtimes أرخص يتولّون التنفيذ المتوازي. يفسّر القائد الهدف، ويذكر الأعضاء، ويدمج نتائجهم على الـ Task؛ ويعمل الأعضاء في أدلة معزولة على الـ Computer نفسه؛ ثم يقبل شخص النتيجة. استخدم Agent واحدًا بدلًا من ذلك عندما يكون العمل صغيرًا ومحددًا جيدًا. يبحث الـ Agents وينفّذون ويختبرون ويقدّمون التقارير. أما الأشخاص فيضعون التوجه، ويمنحون الصلاحية، ويقبلون النتيجة.
لماذا يُعدّ مقعد القائد المقعد المكلف
لتنفيذ الـ Crew شكل ثابت. يُسنَد الـ Task إلى الـ Crew. وإذا كان في حالة قابلة للتنفيذ وكان القائد جاهزًا، يبدأ الـ Agent القائد أولًا. يقرأ سياق الـ Task وتعليمات الـ Crew، ثم إما يتولّى العمل أو يذكر أعضاء Agents مؤهلين. يعمل الأعضاء المذكورون على الـ Task نفسه ويضيفون نتائجهم إلى محادثته، ويمكن للقائد أن يواصل التنسيق ويدمج ما عاد إليه.
كل قرار في هذا التسلسل هو حكم تقديري: هل المتطلب مكتمل؟ وما الأدوار المطلوبة؟ وبأي ترتيب؟ وهل النتيجة المدمجة تستوفي معايير القبول؟ وُجد نموذج «القائد أولًا» ليتخذ Agent واحد هذه القرارات قبل أن يبدأ كل الأعضاء دفعة واحدة. امنح هذا الدور للنموذج صاحب أفضل حكم، ويمكن أن يكون الأعضاء عاديين.
أرقام إطلاق Astra تتحدث عن جانب الحكم أكثر من جانب البرمجة. في معيار الهلوسة الداخلي لدى OpenAI، حيث الأقل أفضل، يسجّل Astra نسبة 4.2% مقابل 12.2% لـ Sol. ولم يحاول قط التحايل على رفض المراجعة التلقائية في Codex ضمن تقييم OpenAI، ودرجته في أمان استخدام الحاسوب 2.4% مقابل 22.0% لـ Sol، ويُفيد ملخص الأمان بوجود نحو نصف عدد إشارات عدم التوافق عالية الخطورة مقارنة بـ Sol عبر محاكاة لأكثر من 54,000 مهمة Codex. القائد الذي لا يختلق المتطلبات ولا يلتفّ حول «لا» هو القائد الذي تريده أن يقرر من يفعل ماذا.
كيف يعمل Crew متعدد النماذج
يُبقي Sharkly النموذج خارج الـ Agent. يتبع الـ Agent النموذج الافتراضي لـ Runtime الخاص به، ويمكن لـ Computer أن يعرض أكثر من Runtime. وهذه هي آلية Crew متعدد النماذج: كل Agent عضو مرتبط بـ Runtime، وكل Runtime يحمل نموذجه الافتراضي الخاص.
التخطيط الأنظف هو Computer واحد بعدة Runtimes:
| دور Crew | Agent | Runtime على الـ Computer | النموذج الافتراضي لـ Runtime | سعر API لدى المورّد لكل مليون توكن |
|---|---|---|---|---|
| القائد | planner |
Codex | gpt-6-astra |
10$ إدخال / 50$ إخراج |
| عضو Backend | backend |
Codex على Computer ثانٍ، أو Runtime ثانٍ | GPT-5.6 Terra | 2$ إدخال / 12$ إخراج |
| عضو الاختبارات | tests |
Claude Code | Claude Sonnet 5 | 2$ إدخال / 10$ إخراج |
| عضو التوثيق | docs |
Gemini CLI أو Codex | اختيارك | يختلف |
الأسعار هي قوائم أسعار المورّدين لاستخدام API؛ ويستمر استخدام النموذج عبر الاشتراكات أو مفاتيح API المهيّأة في تلك الأدوات، لذا ما يدفعه فريقك يعتمد على الخطط التي يربطها. والمقصود من الجدول هو الشكل: المقعد الذي يقرأ أكثر ويقرّر أكثر يعمل على النموذج الأفضل في القراءة والقرار، والمقاعد التي تولّد أكبر قدر من المخرجات تعمل على نماذج رخيصة لكل توكن مُخرَج.
وإذا كان لا بد أن يكون كل عضو على Codex، فإن Computerين بإعدادات Codex افتراضية مختلفة يفيان بالغرض، لأن إعداد النموذج يقع في تهيئة Codex على كل مضيف. ويغطي دليل إعداد Astra تلك التهيئة.
سبرنت تطبيقي
لنأخذ SH-312، «إضافة تهيئة SCIM لمساحات العمل المؤسسية». يمتد العمل عبر API ومهمة مزامنة في الخلفية واختبارات وصفحة توثيق، ويترك المتطلب أمرين مفتوحين: هل إلغاء التهيئة حذف نهائي أم تعطيل؟ وأي مزوّدي هوية يُطلَقان أولًا؟
أسنِد SH-312 إلى الـ Crew وانقله إلى حالة قابلة للتنفيذ. يقرأ القائد، على Astra، الوصف والتعليقات الأخيرة وتعليمات الـ Crew، وينشر سؤالًا واحدًا: تعطيل أم حذف؟ ثم يعلن افتراضه (تعطيل، مع حذف نهائي بعد 30 يومًا) ويواصل الأجزاء التي لا تعتمد على الجواب، وهو السلوك الذي تصفه OpenAI لـ Astra في Codex. ويردّ شخص في المحادثة خلال ساعة.
ثم يذكر القائد @backend مع عقد نقطة النهاية ومواصفات مهمة المزامنة، و@tests مع معايير القبول. يعمل العضوان على الـ Task نفسه، كلٌّ في دليله المعزول مع worktree جديد، لذا لا تلمس ترحيل المخطط وهيكل الاختبار الملفات نفسها أثناء التشغيل. وتعود نتائجهما إلى محادثة الـ Task. يراجع القائد كليهما، ويلاحظ أن الاختبارات تفترض الحذف النهائي، ويرسل إلى عضو الاختبارات تصحيحًا واحدًا، ثم يدمج الفرعين في ملخص تغيير واحد مع الفحوصات التي أجراها والحدود المعروفة.
ينتقل الـ Task إلى «بانتظار مراجعة بشرية». يقرأ شخص الملخص، ويفتح الفرق (diff)، ويقبل أو يعيد الإرسال. لم يحدث أي شيء في هذا التسلسل في طرفية خاصة. السؤال والافتراض وتشغيلا العضوين والتصحيح والقبول كلها مسجّلة على SH-312.
تعليمات الـ Crew التي تُنتج هذا السلوك قصيرة:
You lead this Crew. Read the Task and comments, then decide the
smallest set of members needed. Mention @backend for API and job
changes, @tests for coverage, @docs for user-facing pages.
Ask a person only when an interpretation would change the design;
otherwise state your assumption and proceed.
Combine member results into one change summary with checks run,
failures, and known limits. Leave acceptance to a person.
متى لا تضع Astra في مقعد القائد
زوجان من القرارات يُبقيان هذا صادقًا.
في الأعمال الصغيرة المحددة جيدًا، أسنِد الـ Task مباشرة إلى Agent واحد. واستخدم Crew عندما يحتاج القائد إلى تفسير الهدف وإشراك أعضاء Agents آخرين وإعادة نتائجهم إلى Task واحد. إصلاح خطأ في ملف واحد مُسنَد إلى Crew يدفع ثمن تشغيل قائد لم يحتج إليه أصلًا.
اترك دليل الـ Task المشترك معطّلًا إلا إذا كان على الأعضاء المتسلسلين البناء على التغييرات المحلية نفسها. فهو يشارك حالة نظام الملفات، لا جلسة الـ Agent السابق، وقد تتعارض التعديلات المتزامنة في دليل مشترك. في مثال SCIM عمل عضوا الـ backend والاختبارات بمعزل، ثم دمج القائد نتائجهما بعد ذلك.
وحدود أخرى. الـ Owner يدير الـ Crew؛ والقائد ينسّق التنفيذ. وجعل Astra قائدًا لا يغيّر من يمكنه تعديل العضوية أو الظهور أو التعليمات، وفقط أعضاء Agents يمكنهم بدء التشغيلات. ولا يزال الأشخاص في الـ Crew يساهمون عبر التعليقات والقرارات والمراجعة.
التكلفة والوفر
Astra هو أغلى نموذج في الجدول، والقائد هو الـ Agent الذي يقرأ أكثر. وهناك أمران يخففان ذلك. فالتخزين المؤقت للمطالبات (prompt caching) يحاسب على المدخلات المتكررة بسعر دولار واحد لكل مليون توكن وفق سعر API، والقائد الذي يعيد قراءة سياق الـ Task نفسه عبر الأدوار يستفيد من ذلك. وتزعم OpenAI أن Astra ينجز المهام الوكيلية بتوكنات مخرجات أقل من أسلافه، بنحو 65% أقل من Claude Opus 5 في Agents’ Last Exam عند أعلى إعدادات التسجيل.
لا تأخذ أيًا من الرقمين على الثقة. شغّل النوع نفسه من الـ Task عبر Crew بقائد Astra وعبر Crew بقائد Sol لمدة Sprint واحد، ثم قارن ما يظهره تقرير الـ Sprint: المهام المكتملة، والمهام المُعادة، والوقت من الإسناد إلى القبول. يحتفظ الـ Sprint بالجدول والنطاق والتقارير مرتبطة بالمهام، لذا فالمقارنة مرشّح (filter) لا جدول بيانات. وإذا أعاد Crew الـ Astra عددًا أقل من المهام، فقد دفع مقعد القائد ثمنه.


