
أطلقت OpenAI نموذج GPT-6 Luna في 22 سبتمبر بسعر 0.10 دولار لكل مليون رمز إدخال و0.50 دولار لكل مليون رمز إخراج، بمعرّف API هو gpt-6-luna ونافذة سياق تبلغ مليون رمز. عند هذا السعر، لم يعد السؤال المثير هو ما إذا كان النموذج جيدًا بما يكفي من حيث المبدأ، بل يصبح: أي مسارات في لوحتك أنت مستعد لتسليمها له؟ وكيف يعمل المسار الرخيص والمسار المكلف على الحاسوب نفسه دون أن يفقد أحد أثر أيٍّ منهما أنتج نتيجة معينة؟
هذه مسألة إعداد قبل أن تكون مسألة نموذج. فالفريق الذي يربط Luna بكل شيء يوفّر المال ثم ينفقه مرة أخرى في المراجعة. أما الفريق الذي لا يربطه أبدًا فيظل يدفع أسعارًا مرتفعة مقابل أن يعيد وكيل ذكي تسمية ملف اختبار. يقدّم هذا الدليل أقصر طريق مفيد: ضع gpt-6-luna على حاسوب واحد، وأبقِه في مساره الخاص، وأسند إليه مهمة حقيقية واحدة، واقرأ النتيجة في مكان يراها فيه الفريق.
باختصار
اربط gpt-6-luna كنموذج افتراضي لبيئة تشغيل (Runtime) على حاسوب متصل، وتأكد من أن هذه البيئة تظهر بحالة "متاحة" في Sharkly، وخصّص لها وكيلًا خاصًا بها بدلًا من إعادة استخدام الوكيل المكلف، وارفع المهلة الزمنية لكل مهمة قبل أن تثق بتشغيل طويل، وأبقِ Luna على الأعمال التي يستطيع شخص التحقق من ناتجها في أقل من دقيقة. لن يعرض Sharkly اسم النموذج. سيعرض التشغيل والسجل والأسئلة والنتيجة على المهمة. الوكلاء يبحثون وينفّذون ويختبرون ويقدّمون التقارير. أما البشر فيحدّدون الاتجاه ويمنحون الصلاحية ويقبلون النتيجة.
أين يوجد إعداد النموذج
Sharkly لا يختار النماذج. وتوثيق الوكلاء صريح في ذلك: "يتبع الوكيل النموذج الافتراضي لبيئة التشغيل. وهو لا يَعِد باسم نموذج محدد ولا يعرضه. غيّر النماذج من إعدادات أدوات بيئة التشغيل أو الحاسوب، لا من الوكيل."
لذا لا توجد قائمة منسدلة لاختيار النموذج على الوكيل، ولا تحكّم في عمق التفكير أيضًا. أربعة أدوار، ولكلٍّ منها وظيفة واحدة. الوكيل يحدّد كيف ينبغي التعامل مع العمل. والحاسوب يوفّر المضيف والموارد المحلية. وبيئة التشغيل تنفّذ جلسة الوكيل الفعلية. أما المهمة فتبقى السجل المشترك للفريق. الشرح الكامل لهذا الإعداد موجود في دليل GPT-6 Sol لدينا؛ أما هذه التدوينة فتغطي الجزء الخاص بوضع نموذج رخيص على اللوحة.
الخطوة 1: اربط gpt-6-luna على الحاسوب
على الحاسوب الذي سيشغّله، حدّث أداة الوكيل لديك وسجّل الدخول بحساب أو مفتاح API يمتلك صلاحية الوصول إلى Luna.أتاحت OpenAI نموذج Luna في ChatGPT Work وفي Codex لخطط Plus وPro وBusiness وEnterprise وEdu، ومنحت مستخدمي Free وGo إمكانية استخدام Luna في تطبيق سطح المكتب، ولم تضعه في Chat بعد. إذا كان الأمر codex -m gpt-6-luna يبدأ جلسة في طرفية عادية على ذلك المضيف، فسيتمكن Sharkly من استخدامه.
ثم اضبط الإعداد الافتراضي لتلتقطه عمليات التشغيل على تلك البيئة:
# ~/.codex/config.toml
model = "gpt-6-luna"
model_provider = "openai"
model_reasoning_effort = "high"
تحذيران بشأن هذه القطعة البرمجية. اسم مفتاح جهد التفكير يختلف بين إصدارات Codex، لذا تحقق منه مقابل ملف الإعدادات النموذجي للإصدار المثبَّت على ذلك الحاسوب. ووضع high موجود هناك عن قصد لا كإعداد افتراضي: فكل نتائج Luna المنشورة أدناه مقيسة عند جهد high أو max، وليس عند الإعداد الذي قد تختاره لجعل نموذج رخيص أرخص. [VERIFY]
وبالعودة إلى Sharkly، افتح تفاصيل الحاسوب وشغّل إعادة الفحص أو اختبار الاتصال. ينبغي أن تظهر بيئة التشغيل بحالة "متاحة". أما ظهور الحاسوب بحالة "متصل" فقط فيعني أن خدمته المحلية ترسل نبضات حياة. وحالة قدرة بيئة التشغيل هي ما يخبرك بأن التشغيل يمكن أن يبدأ.
الخطوة 2: أبقِ المسار الرخيص منفصلًا بشكل مرئي
يمكن للحاسوب أن يوفّر بيئة تشغيل واحدة أو أكثر، كلٌّ منها يبلّغ عن حالة اتصاله الخاصة، ويمكن إضافة بيئة تشغيل ACP مخصّصة من تفاصيل الحاسوب باسمها وأمر التشغيل الخاص بها. وهذا هو الرافعة التي تستحق الاستخدام هنا. خصّص لمسار Luna مدخل بيئة تشغيل خاصًا به ووكيلًا خاصًا به، مسمّى باسم المسار لا باسم النموذج، وستخبرك اللوحة في أي مسار جرى تشغيل المهمة دون أن يقرأ أحد سجل التنفيذ.
هذا ليس تجميلًا. إذ لا يستطيع Sharkly قراءة النموذج الذي تستخدمه بيئة التشغيل فعليًا بشكل موثوق، ولهذا بالضبط يتبع الوكلاء الإعداد الافتراضي لبيئة التشغيل ولا يعرضون اسم النموذج. فإذا غيّر وكيلٌ ما نموذجه بصمت بين الثلاثاء والخميس لأن أحدهم حرّر ملف إعدادات، فعمليتا تشغيل تبدوان متطابقتين على المهمة لم تكونا كذلك. ومسار واحد لكل فئة تكلفة يجعل ذلك مرئيًا في المكان الوحيد الذي ينظر إليه الفريق أصلًا. راجع الحواسيب في Sharkly لمعرفة كيف تُكتشف بيئات التشغيل وتُختبر.
ثنائي قرار، بما أن صيانة مسارين تكلّف شيئًا. افصل بيئة التشغيل عندما يُسند أكثر من شخص عملًا على ذلك الحاسوب وكان الفرق بين تشغيل بـ0.10 دولار وتشغيل بـ10 دولارات يهمّ أحدهم. ولا تفصلها عندما يدير مهندس واحد حفنة من المهام أسبوعيًا؛ فبيئة تشغيل واحدة مع تقدير لكل مهمة على حدة أقل ما يجب تتبّعه، كما أن عزل شجرة العمل يمنع عمليات التشغيل من التصادم أصلًا.
الخطوة 3: اضبط حجم التشغيل لنموذج يبدأ ببطء
الرخيص ليس مرادفًا للسريع، وهذا هو الإعداد الذي يخطئ فيه الناس أولًا. قاست Artificial Analysis، وهي طرف ثالث وليست أيًا من الشركتين، سرعة 153.9 رمز إخراج في الثانية للنسخة ذات الاستدلال الأقصى من GPT-6 Luna، مع 124.23 ثانية حتى الرمز الأول. وهذه مدة أطول مما ينتظره معظم الناس قبل أن يفترضوا أن العملية قد تجمّدت.
لذا اضبط المهلة الزمنية لكل مهمة عن قصد، وأبقِ دليل العمل في وضع Temporary حتى تحصل كل مهمة على دليل معزول وشجرة عمل جديدة. عندها لا تستطيع عمليتا تشغيل لـLuna على المستودع نفسه أن تكتب إحداهما فوق الأخرى، ويبدو التشغيل الذي يفكّر مختلفًا عن تشغيل مات، لأن المهمة تحمل حالة، بينما سجل الطرفية لا يحملها.
أين ينتمي المسار الرخيص داخل الفريق (Crew)
الفريق (Crew) مجموعة قابلة لإعادة الاستخدام من الأشخاص والوكلاء ينسّقها وكيل قائد واحد. وقاعدة التوزيع المستخلصة من أرقام OpenAI نفسها هي أن Luna ينتمي إلى الأعضاء لا إلى القمة.
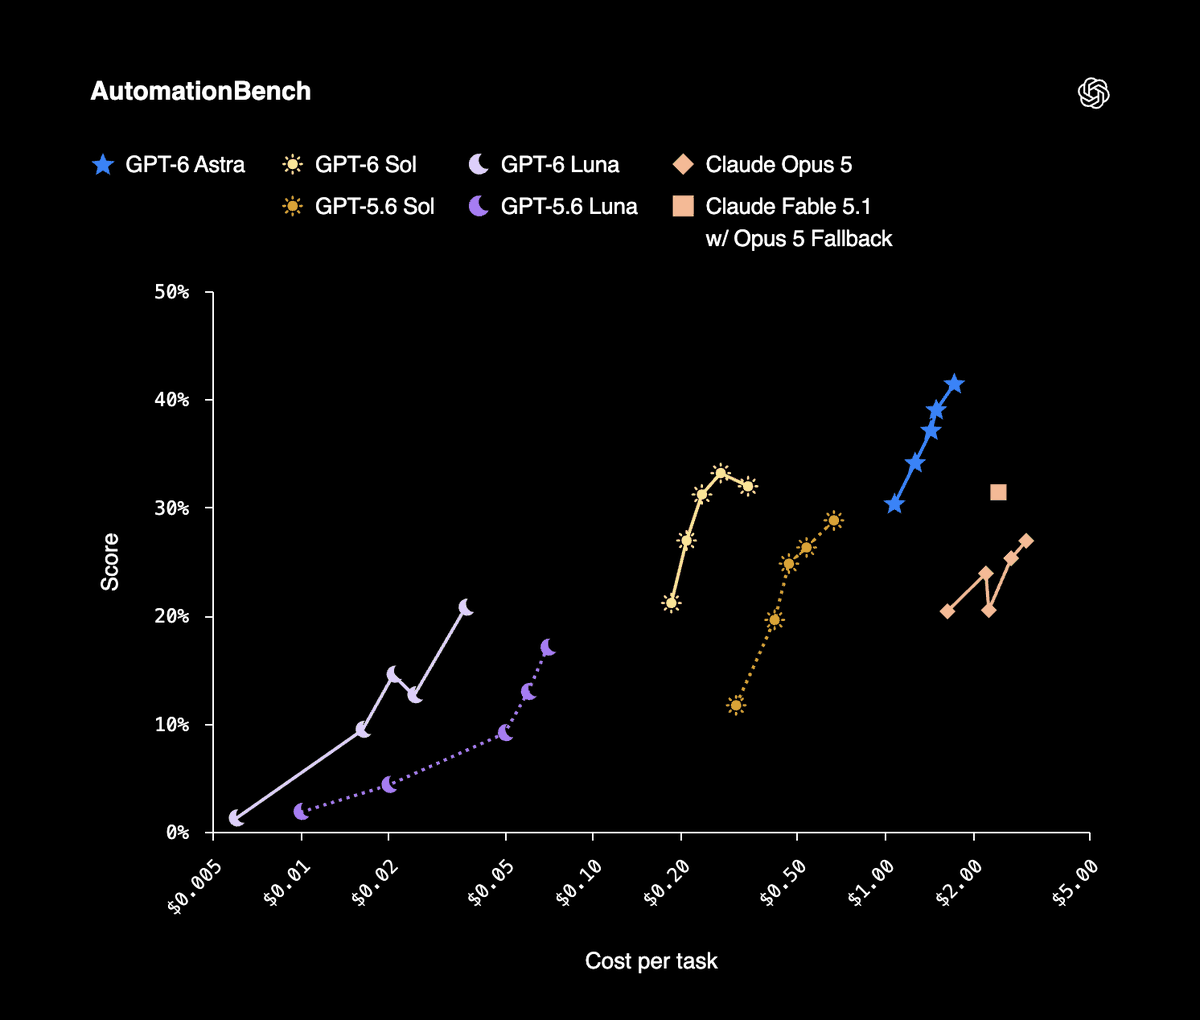
حالة العضوية قوية. في DeepSWE 1.1، تُبلّغ OpenAI عن تسجيل Luna عند جهد max نسبة 66.6%، وهي مقارنة بـClaude Opus 5 وFable 5 عند جهد medium، وبتكلفة أقل بنسبة 93% لكل مهمة من Opus 5 و96% أقل من Fable 5. وفي OSWorld 2.0 دون اتصال، يتفوق Luna عند max على GPT-5.6 Sol عند medium بعُشر التكلفة. وفي AutomationBench 1.0.6، يسجّل Luna عند high نتيجة أعلى بـ5.4 نقطة مئوية من سلفه بتكلفة أقل بنسبة 58% لكل مهمة، وفي الدقة الواقعية، يعادل Luna عند جهد أعلى نموذج GPT-5.6 Sol بحوالي جزء من مئة من التكلفة. كما تصف OpenAI كلا من Sol وLuna بأنهما أرخص بنسبة 50% من الأسعار الترويجية لـGPT-5.6، وهذا القيد من OpenAI نفسها: فخط الأساس هو سعر ترويجي لا سعر قائمة.
حالة القيادة ضعيفة، وليس بسبب أي اختبار معياري. فالقائد يفسّر الهدف، ويحدّد ما يفعله الأعضاء، ويعيد نتائجهم إلى مهمة واحدة. وخطأ في التفسير عند القمة ليس تشغيلًا سيئًا واحدًا، بل كل تشغيلات الأعضاء موجّهة إلى الشيء الخطأ، والتوفير في رموز القائد خطأ تقريب لا يُذكر مقابل ذلك. دليل قائد الفريق لدينا يقدّم الحجة ذاتها عند الطرف الآخر من قائمة الأسعار.
| العمل | المسار | السبب |
|---|---|---|
| الفرز والتصنيف وترتيب قائمة المهام المتراكمة | Luna | حجم كبير، ويستطيع شخص التحقق من الحكم في ثوانٍ |
| بناء هياكل الاختبارات وملاحظات المراجعة الأولية | Luna عند جهد high | المكاسب المنشورة كانت عند high أو max، لا عند إعداد أدنى |
| تعديلات على الكود الذي يُنشر | GPT-6 Sol بسعر 2 / 10 دولارات | AutomationBench بنسبة 33.2% بتكلفة 0.27 دولار لكل مهمة |
| تفسير هدف غامض لفريق (Crew) | GPT-6 Sol، أو Astra بسعر 10 / 50 دولارًا | خطأ القائد يتضاعف عبر كل عضو |
دوّن ذلك كقاعدة لا كعادة. وتغطي تدوينة أي نموذج لأي مهمة برمجية مسألة التوجيه بالكامل.
تحذير واحد عند قراءة هوامش OpenAI: فهي تقيس منشور الإطلاق مقابل Claude Opus 5، وقد استبدلت Anthropic نموذج Opus 5 بـOpus 5.5 بعد ساعات في اليوم نفسه. والمقارنات الخاصة بـLuna أعلاه مقيسة مقابل الجيل السابق من النموذج الذي تسمّيه.
ما لا تجعله بيئة التشغيل الرخيصة أرخص
Luna يخفض ثمن إنتاج تغيير. لكنه لا يفعل شيئًا لثمن قبول هذا التغيير. فعشر عمليات تشغيل رخيصة تنتج عشر فروقات، وعشر مجموعات من مخرجات الاختبارات، وعشر قرارات لا يستطيع اتخاذها إلا شخص، وأرقام الإنفاق لدى OpenAI نفسها تحذير لا طمأنة: فهي تُبلّغ عن إنفاق باحث وسيط يتجاوز 600 دولار يوميًا على وكلاء البرمجة، مع بلوغ المئين 90 حد 7000 دولار. فالرخيص لكل مهمة هو الطريقة التي تُبنى بها فاتورة كهذه.
إذن، النسخة الصادقة من الطرح. بيئة التشغيل الرخيصة تستحق الربط عندما يكون العمل الذي تتولاه عملًا يستطيع شخص التحقق منه بسرعة، وهي اقتصاد زائف عندما تضاعف الطابور أمام المراجع لديك. أبقِ السياق والتقدم والعوائق والنتائج والمراجعة البشرية مرئية من الطلب حتى الإصدار، واحسم المسار عند الإسناد لا عند المراجعة. وتتناول المراجعة البشرية هي عنق الزجاجة الجانب المتعلق بالجدولة من ذلك.
إذا كنت تشغّل بالفعل عدة وكلاء برمجة، فاربط حاسوبًا واحدًا، وأنشئ وكيلًا واحدًا على المسار الرخيص، وأسند إليه شيئًا مملًا.


