
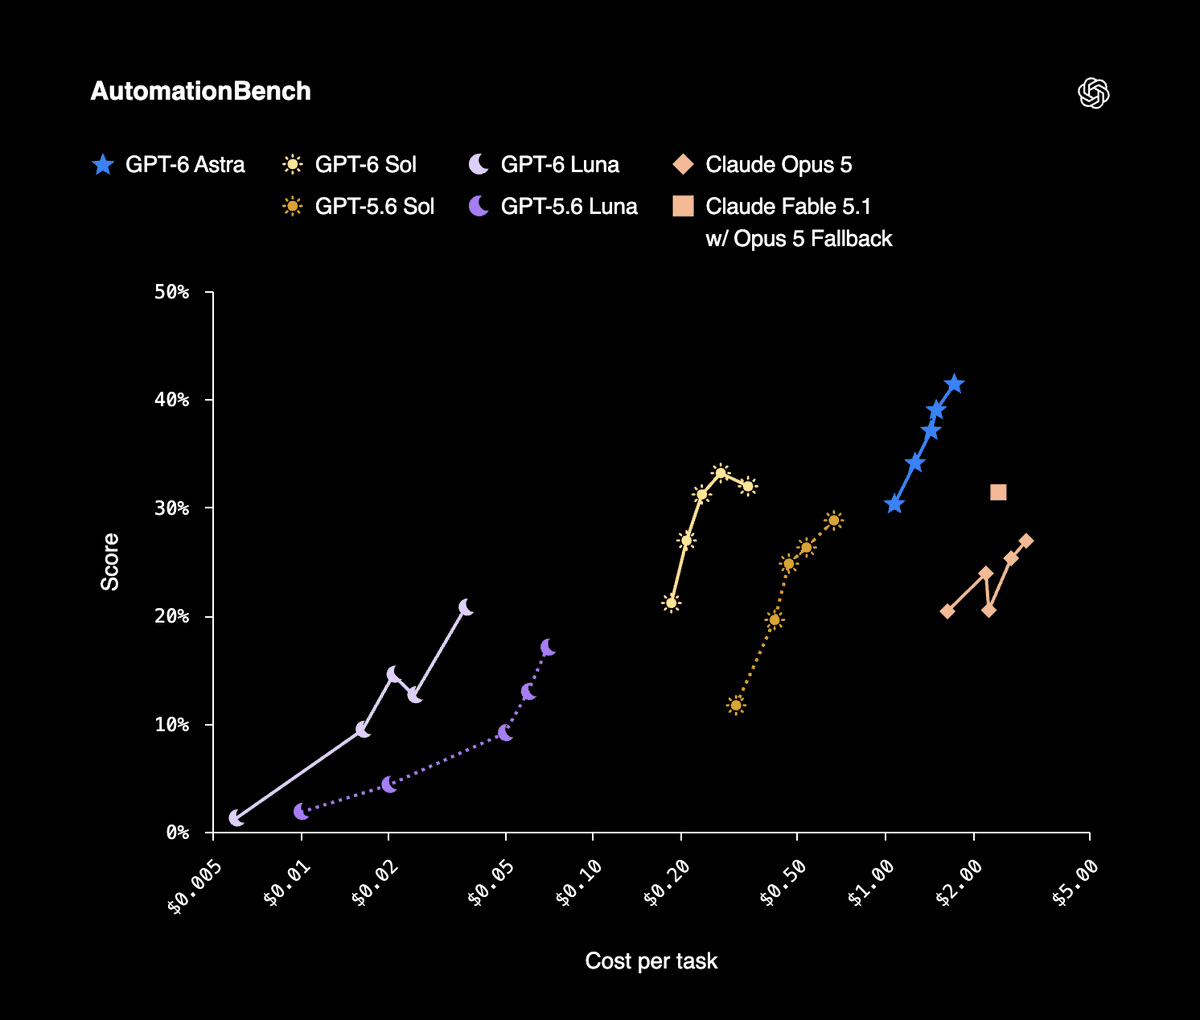
أطلقت OpenAI نموذج GPT-6 Sol في 22 سبتمبر بسعر دولارين لكل مليون رمز إدخال و10 دولارات لكل مليون رمز إخراج، بمعرّف API هو gpt-6-sol ونافذة سياق تبلغ 872 ألف رمز. لكن الرقم الذي يجب أن يغيّر شكل لوحتك ليس سعر الرموز، بل التكلفة لكل مهمة منجزة: فحسب نتائج AutomationBench 1.0.6 من OpenAI، يحرز Sol عند جهد الاستدلال xhigh نسبة 33.2% بتكلفة 0.27 دولار للمهمة، في حين يحرز Claude Opus 5 عند أقصى جهد نسبة 26.9% بتكلفة تعادل 11.1 ضعف تكلفة Sol للمهمة.
اقرأ ذلك كبيان ميزانية، لا كلوحة صدارة. إذا كان فريقك يقتّر في تشغيل الوكلاء لأن التشغيل الكامل كان مكلفًا، فقد انتقل هذا القيد للتو. أما القيد التالي فهو ذاك الذي لا يستطيع أحد أن يشتري طريقه للخروج منه: لا يزال هناك شخص يجب أن يقرأ الـ diff ويعتمد العمل. يأخذك هذا الدليل عبر أقصر مسار مفيد للإعداد، ثم يصارحك بالجزء الذي لا يحلّه خفض السعر. ضع Sol في Codex على Computer واحد، وأنشئ Agent واحدًا، وأسند Task حقيقيًا واحدًا.
باختصار
اضبط model = "gpt-6-sol" في Codex على Computer متصل، وتأكد من ظهور Codex Runtime بحالة Available في Sharkly، وأبقِ دليل عمل الـ Agent في وضع Temporary، وارفع مهلة الـ Task قبل أن تثق بأول تشغيل طويل، ثم أسند Task واحدًا. لن تعرض Sharkly اسم النموذج، بل ستعرض التشغيل والسجل والأسئلة والنتيجة على الـ Task. الـ Agents تبحث وتنفذ وتختبر وترفع التقارير، أما البشر فيحددون الاتجاه ويمنحون الصلاحية ويقبلون النتيجة.
أين يوجد إعداد النموذج
لا تختار Sharkly النماذج بنفسها. توضح وثائق Agents ذلك صراحةً: «يتبع الـ Agent النموذج الافتراضي للـ Runtime، ولا يتعهد بعرض اسم نموذج بعينه. غيّر النموذج من إعدادات Runtime أو أداة Computer، لا من الـ Agent.»
لا توجد قائمة منسدلة للنماذج في الـ Agent، ولا عنصر تحكم في عمق التفكير أيضًا، فلا تبحث عن أيٍّ منهما. أربعة أدوار، ولكلٍّ مهمة واحدة. الـ Agent يحدد كيف ينبغي التعامل مع العمل. الـ Computer يوفر المضيف والموارد المحلية. الـ Runtime تنفذ جلسة الوكيل الفعلية، وCodex هو الـ Runtime هنا. أما الـ Task فتبقى السجل المشترك للفريق.
الخطوة 1: ضع GPT-6 Sol في Codex على الـ Computer
على الـ Computer الذي سيشغّله، حدّث Codex وسجّل الدخول بحساب أو مفتاح API يملك صلاحية الوصول إلى Sol. أتاحت OpenAI نموذج Sol في ChatGPT Work وفي Codex لخطط Plus وPro وBusiness وEnterprise وEdu، وهو ليس متاحًا في Chat بعد. وإذا كان الأمر codex -m gpt-6-sol يبدأ جلسة في طرفية عادية على ذلك المضيف، فيمكن لـ Sharkly استخدامه.
ثم اضبط الإعداد الافتراضي بحيث يلتقطه كل تشغيل على هذا الـ Computer:
# ~/.codex/config.toml
model = "gpt-6-sol"
model_provider = "openai"
model_reasoning_effort = "xhigh"
هناك تحذيران بشأن هذا المقطع. أولًا، يختلف اسم مفتاح جهد الاستدلال بين إصدارات Codex، فتحقق منه مقابل ملف الإعدادات النموذجي الخاص بإصدار Codex المثبّت على ذلك الـ Computer. ثانيًا، مستوى الجهد قرار مرتبط بالتكلفة، وليس مقبضًا للجودة تتركه عند حده الأقصى: فالنتائج المنشورة من OpenAI نفسها تستخدم مستويات جهد مختلفة لمعايير مختلفة، ورقم 0.27 دولار للمهمة أعلاه هو صف xhigh. [VERIFY]
وبعد العودة إلى Sharkly، افتح تفاصيل الـ Computer وشغّل إعادة الفحص أو اختبار الاتصال. يجب أن تظهر حالة Codex Runtime على أنها Available. فظهور الـ Computer بحالة online يعني فقط أن خدمته المحلية ترسل نبضات، أما حالة قدرة الـ Runtime فهي التي تخبرك بأن تشغيلًا يمكن أن يبدأ.
الخطوة 2: جهّز الذاكرة المؤقتة قبل توسيع الـ Crew
هذا هو التغيير الأهم في GPT-6 بمجرد أن يعمل أكثر من Agent على المستودع نفسه، وهو أيضًا ما ستتجاهله معظم الفرق.
تفيد OpenAI بأن GPT-6 يحقق معدلات إصابة أعلى في الذاكرة المؤقتة افتراضيًا، وخصمًا بنسبة 90% على قراءات الإدخال المخزنة مؤقتًا، إضافة إلى لوحة معلومات لتخزين الـ prompt مؤقتًا وأداة للتشخيص، والأهم لعمل الوكلاء: أن تغيير جهد الاستدلال أو توافر الأدوات لم يعد يُبطل الذاكرة المؤقتة. وتتيح لك نقاط الفصل الصريحة اختيار المكان الذي تنتهي عنده البادئة المخزنة مؤقتًا. وتستشهد OpenAI بأن GitHub شهد انخفاضًا يزيد على 50% في رموز الـ prompt التي تحتاج إلى معالجة جديدة عبر مليارات الطلبات.
أما على مستوى الـ Crew، فالشكل العملي هو هذا. كل تشغيل لـ Agent على المستودع نفسه يعيد إرسال بادئة كبيرة شبه متطابقة: بنية المستودع، والقواعد الداخلية، وأمر الاختبار، والأعراف المتبعة. وهذه البادئة هي بالضبط ما وُجدت الذاكرة المؤقتة لأجله، وهي السبب في أن أسطولًا من الوكلاء قد يكلف لكل تشغيل أقل بكثير مما كلفه الوكيل الأول.
وهنا زوج من القرارات، لأن هذا ليس عملًا مجانيًا. ثبّت بادئة مستقرة واضبط نقطة فصل صريحة عندما يعمل عدة Agents بشكل متكرر على قاعدة شيفرة واحدة ويكون نص الـ Skill والتعليمات لديك قد استقر. ولا تتكبد هذا العناء عندما يعمل الـ Agent بضع مرات في الأسبوع أو عندما تظل تعليماته تتغير أسبوعيًا، لأنك ستنفق في صيانة هذا الحد وقتًا أكثر مما توفره.
الخطوة 3: ابنِ الـ Agent حول تشغيل يبدأ ببطء
افتح Agents، واختر New Agent، وحدد الـ Computer و الـ Codex Runtime، ثم اضبط ثلاثة أشياء.
مهلة الـ Task. اضبطها عن قصد، لأن تشغيل Sol في وضع استدلال مرتفع قد يبدو ميتًا قبل أن يبدو مشغولًا. فقد قاست Artificial Analysis، وهي جهة خارجية لا تابعة لأيٍّ من المورّدين، 102.15 ثانية حتى أول رمز في نسخة أقصى استدلال من GPT-6 Sol. وهذه مدة أطول مما ينتظره معظم الناس قبل أن يفترضوا أن شيئًا ما قد توقف عن الاستجابة، وهي بالضبط المشكلة التي تمنعها حالة على لوحة مشتركة ولا تمنعها الطرفية. فالتشغيل الذي يفكر والتشغيل الذي انهار يبدوان متطابقين في سجل الطرفية. راجع قابلية مراقبة وكيل البرمجة لتعرف ما يجب أن تحمله الحالة لتستحق القراءة.
دليل العمل. وضع Temporary. يحصل كل Task على دليل معزول، وتُهيّئ التشغيلات المرتبطة بمستودع worktree جديدًا، لذا لا يمكن لتشغيلي Sol على المستودع نفسه أن يكتب أحدهما فوق الآخر. والتزامن الافتراضي للأدلة المؤقتة هو 50% من حد الـ Computer. اتركه عند هذا الحد حتى يتعامل ذلك الـ Computer مع عدة تشغيلات حقيقية؛ فالتزامن الأعلى يستهلك المعالج والذاكرة والقرص وسعة المزوّد في آن واحد.
التعليمات. قصيرة ومستقرة:
Read the Task description and recent comments before editing.
Keep changes limited to the requested behavior.
Ask a question only when different interpretations would
materially change the result; otherwise proceed with a stated
assumption and record it in your report.
Run the closest relevant checks and report failures without hiding them.
Stop and ask before anything destructive or outside the repositories
attached to this Agent.
الخطوة 4: أسند Task واحدًا، ثم قرّر إن كان الـ Crew يستحق مكانه
اختر Task بمعيار قبول واضح. حدد الـ Agent بصفته المسؤول (Assignee) وانقل الـ Task خارج Backlog إلى حالة تكون فئتها جاهزة للعمل؛ فالـ Task المُسند وهو في Backlog يبقى منتظرًا. ويمر التشغيل عبر queued وdispatched وrunning، ويبث تبويب Executions السجل مباشرةً. وإذا احتاج الـ Agent إلى قرار، عاد السؤال إلى الـ Task كتعليق، وظهرت الـ Task بحالة waiting for human reply، ويُوجَّه ذلك إلى Inbox الخاص بك.
في التغيير المحدود، يكون Agent واحد هو الخيار الصحيح وتبقى الأجزاء المتحركة عند الصفر. أما Crew فهي مجموعة قابلة لإعادة الاستخدام من الأشخاص والـ Agents ينسّقها Agent قائد واحد، وهي تستحق مكانها عندما يتعين على القائد تفسير هدف ما وجمع نتائج عدة أعضاء في Task واحد.
ويغيّر Sol هذه المعادلة، لأن القائد في الغالب يقرأ ويخطط ويسند ويراجع، وكان ذلك أصعب عمل يصعب تبريره في قمة قائمة الأسعار:
| نموذج الـ Runtime | معرّف API | الإدخال / الإخراج لكل مليون | موضعه في الـ Crew |
|---|---|---|---|
| GPT-6 Astra | غير معلن | $10 / $50 | القائد عندما تكون الخطة نفسها هي الجزء الصعب |
| GPT-6 Sol | gpt-6-sol |
$2 / $10 | القائد والأعضاء الذين ينفذون التغييرات الفعلية |
| GPT-6 Luna | gpt-6-luna |
$0.10 / $0.50 | الأعضاء ذوو الحجم الكبير: الفرز، والوسم، وبناء الهياكل |
كتبنا الإعداد نفسه لـ Astra في تشغيل GPT-6 Astra كقائد لـ Crew. والحجة هناك لا تزال قائمة، أما نقطة السعر تحتها فقد تغيرت.
ما لا يشتريه خفض السعر
تصف OpenAI نموذج Sol بأنه أرخص بنسبة 50% من سعر GPT-5.6 الترويجي. وهذا القيد من OpenAI نفسها وهو مهم، لأن أساس المقارنة سعر ترويجي لا سعر قائمة. ويجدر ذكر تحفظين آخرين في السياق نفسه. فمعايير الإطلاق لدى OpenAI تقارن مع Claude Opus 5، الذي استبدلته Anthropic بـ Opus 5.5 بعد ساعات في اليوم نفسه، لذا اقرأ تلك الفروق على أنها مقاسة مقابل الجيل السابق. كما أن مستوى الجهد هو من يقوم بالعمل: إذ يصل Sol إلى 68.8% في DeepSWE 1.1 و56.4% في Agents’ Last Exam V1 عند أقصى جهد، لا عند الإعداد الذي ستتركه مفعّلًا للمهام الروتينية.
ثم يأتي الجزء الذي لا علاقة له بالنموذج أصلًا. تفيد OpenAI بأن باحثها الوسيط ينفق أكثر من 600 دولار يوميًا على وكلاء البرمجة، وأن المئين 90 يتجاوز 7000 دولار. وانخفاض التكلفة لكل مهمة هو الطريقة التي تُبنى بها فاتورة كهذه، لا الطريقة التي تُتجنّب بها. فكل تشغيل لا يزال ينتج تغييرًا يجب على شخص أن يقرأه ويتساءل عنه ويقبله، وهذا الطابور لم يصبح أرخص 11 مرة هذا الأسبوع. خطّط بناءً على قدرة المراجعة لا على اختيار النموذج، ودوّن التوجيه كقاعدة بدلًا من تفضيل، واحتفظ بالإسناد والتقدم والعوائق والنتائج والمراجعة البشرية في مكان واحد من الطلب حتى الإصدار.
إذا كنت تشغّل بالفعل عدة وكلاء برمجة، فاربط Computer واحدًا، وأنشئ Agent واحدًا، وأسند إليه شيئًا مملًا.


