
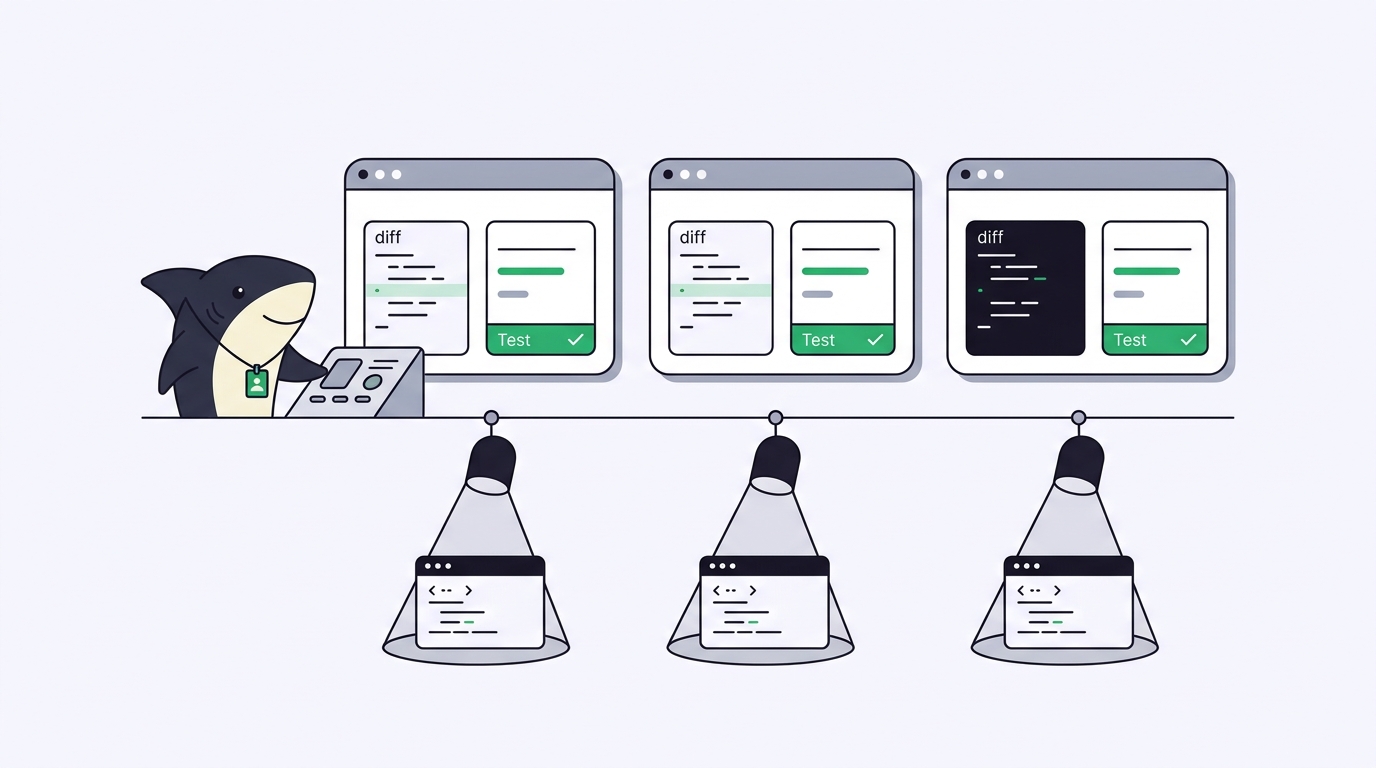
تحاول أن تقرر أي وكيل برمجي تثق به في العمل الحقيقي: Claude Code، أو Codex، أو Gemini CLI، أو OpenCode، أو اثنين منها معًا. فتقرأ نتائج المقارنات. وكيل يحلّ 68% من مجموعة مهام عامة، وآخر 71%، ويُفترض أن تختار بناءً على ذلك. ثم يصل الوكيل إلى مستودعك ويتعثّر عند خطوة بناء لم ترها أي مجموعة بيانات عامة من قبل.
المقارنة تقيس مجموعة ثابتة ومشتركة من المشكلات. أما قاعدة شفرتك فهي مجموعة خاصة من المشكلات: أعرافك، وتخطيط monorepo لديك، والاختبار المتذبذب الذي يتجاهله الجميع، وسكربت النشر الذي يفهمه شخص واحد. النتيجة التي تحدّد أسبوعك هي التي تولّدها على تلك الشفرة، لا التي نشرها مختبر. يشرح هذا الدليل منهجًا لمقارنة وكلاء البرمجة على البرمجيات التي تُصدرها فعليًا، وكيف تجري تلك المقارنة دون فتح خمسة نوافذ طرفية لإبقاء الوكلاء منفصلين.
Sharkly هي حيث تتجسّد هذه المنهجية. Sharkly منصة متكاملة لإدارة أوامر الوكلاء: توصّل حاسوبك الخاص، وتُسند المهمة نفسها إلى وكلاء مختلفين، وكل تشغيل يعيد الفرق الخاص به ومخرجات اختباره ومراجعته إلى مكان واحد. وهذا ما يجعل المقارنة العادلة ممكنة. المتغير الذي تريد قياسه هو الوكيل، لا التخبّط بين النوافذ الطرفية الذي ستضطر إليه لولا ذلك لإبقاء ثلاثة تشغيلات من التداخل مع بعضها.
نتيجة المقارنة تقيس مجموعة بيانات، لا مستودعك
مقارنة وكلاء البرمجة هي مجموعة اختبار عامة ثابتة، تُقيَّم بالطريقة نفسها للجميع. وهذا بالضبط ما يجعلها مفيدة للمختبرات التي تبني النماذج، وهو نفسه ما يجعلها مؤشرًا ضعيفًا بالنسبة لك.
المقارنات العامة مثل SWE-bench تستمد مهامها من مشاريع مفتوحة المصدر معروفة، مع بيئة اختبار مضبوطة وفحوص قبول منسّقة. لا شيء من ذلك يصف يومك العادي. فالأمور التي تحدّد أداء الوكيل على شفرتك هي أمور لا يمكن أن تحتويها مجموعة بيانات عامة أبدًا: مكتباتك الداخلية التي لم يقرأها النموذج قط، وإعدادات فحص الشفرة لديك، وملف السياق المكوّن من 400 سطر الذي يشرح كيف تُقلع الخدمة فعليًا، والوحدة الوحيدة بلا اختبارات.
النتيجة المرتفعة في المقارنات لا تتوقع كيف سيتصرف الوكيل في مستودعك، بل تتوقع كيف يتصرف في مستودع شخص آخر. عامل لوحة الصدارة كمرشّح تقريبي لمعرفة الوكلاء الذين يستحقون الاختبار، ثم أجرِ الاختبار الذي يهم فعلًا. وإذا كنت لا تزال تختار النموذج الذي توجّه به كل وكيل، فإن مطابقة النماذج بأدوار الوكلاء سؤال أفضل للبدء من النتيجة الخام.
اختر مهمة حقيقية واحدة، لا طلبًا تافهًا
ابدأ بأصغر مقارنة مفيدة. لا تقارن الوكلاء على مهمة «ابنِ تطبيق مهام». اختر متطلبًا حقيقيًا واحدًا من قائمة أعمالك المتراكمة: خطأ محدود النطاق، أو ميزة صغيرة في وحدة واحدة، أو ترحيل كنت ستنفّذه على أي حال. شيئًا له اختبار قبول يمكنك تشغيله وفرق يمكنك قراءته في بضع دقائق.
ثم أعطِ كل وكيل المدخلات نفسها تمامًا: وصف المهمة نفسه، ونقطة البداية نفسها في الـ commit، ومعايير القبول نفسها. اكتبه كما يظهر في نظام تتبع المهام لديك، مهمة مثل SH-312: fix the timezone drift in the invoice export. إذا حصل وكيل على طلب أغنى من الآخر، فأنت تقيس طلبك لا الوكيل.
استخدم إصلاح خطأ حين تريد رؤية كيف يقرأ الوكيل الشفرة الموجودة ويلتزم بالحدود. واستخدم ميزة صغيرة حين تريد رؤية كيف يبني شفرة جديدة وما إذا كان يكتب اختباراته الخاصة. جرّب النوعين مع الوقت؛ فمهمة واحدة تخبرك عن مهمة واحدة فقط.
قارن كل وكيل في أفضل حالاته، لا أسوأها
لكل وكيل إعداد يُقدّم فيه أقوى أعماله: النموذج المناسب، وملف السياق المناسب، والصلاحيات التي يحتاجها فعلًا. أعطِ Claude Code ملف CLAUDE.md الخاص به، وأعطِ Codex إعداداته، وأعطِ كل Runtime البيئة التي توصي بها وثائقه. مقارنة وكيل مُهيّأ جيدًا بآخر مجرد لا تخبرك بشيء سوى أيّهما كلّفت نفسك عناء إعداده.
تشغيلهم في أفضل حالاتهم، جنبًا إلى جنب، هو حيث ينهار أسلوب النوافذ الطرفية. على Sharkly تُسند المهمة نفسها إلى كل وكيل، ويعمل كل وكيل على حاسوب موصول داخل worktree معزول، فلا تلمس ثلاثة وكلاء يحرّرون المستودع نفسه ملفات بعضهم بعضًا. تحصل على ثلاث محاولات نظيفة للمشكلة نفسها بدلًا من شجرة عمل مشتركة واحدة ودمج عليك فكّه يدويًا. وإذا كنت تفعل ذلك يدويًا، فإن تشغيل عدة وكلاء في وقت واحد هو الجزء الذي بُنيت Sharkly لتزيله عن كاهلك.
إذا كنت تستخدم وكيلًا واحدًا فقط وتعيش في الطرفية، فجلسة Claude Code واحدة مضبوطة جيدًا داخل worktree تكفي، وقد لا تحتاج إلى أي من هذا. لكن المعادلة تتغير لحظة مقارنة وكيلين أو أكثر، عبر أكثر من مهمة واحدة، وأنت تريد النتائج في صيغة يمكنك قراءتها فعلًا جنبًا إلى جنب.
خمسة معايير تحسم الأمر في العمل الحقيقي
المقارنة تُقيّم رقمًا واحدًا: هل نجحت المهمة. لكن العمل الحقيقي تحسمه خمسة أمور يغفلها ذلك الرقم.
| المعيار | السؤال الذي يجيب عنه |
|---|---|
| التنفيذ المتوازي | هل يمكنني تشغيل الوكلاء على المهمة نفسها في الوقت نفسه، بمعزل عن بعضهم، ودون تعارضات؟ |
| ظهور العمل للفريق | هل يستطيع شخص غيري رؤية ما فعله كل وكيل، ولماذا؟ |
| مسار المراجعة | ما مدى سرعتي في قراءة الفرق والاختبارات والحدود المعروفة ثم القبول أو الرفض؟ |
| التنفيذ على جهازي | هل يعمل الوكيل على حاسوبي، مقابل بيئتي وأسرارّي الحقيقية؟ |
| التكاملات | هل تصل النتيجة إلى نظام تتبع المهام والمستودع وأدوات المراجعة التي نستخدمها فعلًا؟ |
المعايير الأربعة الأولى هي حيث تبدو معظم الوكلاء متطابقة في المقارنات وتتصرف بشكل مختلف تمامًا على شفرتك. أما التنفيذ على جهازك فهو تحديدًا غير مرئي في اختبار عام: الوكيل الذي يعمل مقابل سلسلة أدواتك الفعلية، وقاعدة بياناتك المحلية، وخطافات CI الحقيقية لديك، يُختبر على ما تُصدره، لا على بيئة معزولة تشبهه.
الوكلاء يبحثون ويُنفّذون ويختبرون ويُبلّغون. وأنت تحدّد الاتجاه، وتمنح الصلاحية، وتقبل النتيجة. والمقارنة لا تكون صادقة إلا إذا كنت ترى كل جزء من ذلك، لكل وكيل، دون إعادة تركيبه من سجل التمرير.
قيّم ما يعود، لا ما يدّعيه الوكيل
وكيل يطبع «تم» ليس مثل تغيير ينجح في الاختبار. قيّم كل تشغيل بناءً على ما يعود، لا على ما يؤكّده. ولكل محاولة، الأدلة المفيدة هي القائمة القصيرة نفسها: الفرق، ونتائج فحص الأنواع والاختبارات، وملخص التغيير، والحدود التي يقرّ بها الوكيل. تُبقي Sharkly السياق والتقدم والعوائق والنتائج والمراجعة البشرية ظاهرة من الطلب حتى الإصدار، فتُقرأ المقارنة كجدول نتائج بدلًا من خمس نوافذ طرفية عليك تذكّرها.
وهنا يظهر عنق الزجاجة الحقيقي أيضًا. يمكن لوكيلين أن «ينهيا» مهمة في عشرين دقيقة كلاهما، ومع ذلك يكلّفك كل واحد منهما ساعة كاملة للمراجعة. ومراجعة مخرجات الوكلاء غالبًا هي الحد الحقيقي لما يستطيع الفريق استيعابه من عمل متوازٍ، وينبغي أن يزن ذلك كثيرًا عند اختيار الوكيل. وما يجب ترجيحه يعتمد على من يختار:
| الاختيار لصالح | الأكثر ترجيحًا |
|---|---|
| مطوّر فردي | مسار المراجعة والتنفيذ على جهازك؛ فأنت المراجع الوحيد |
| فريق صغير | التنفيذ المتوازي وظهور العمل للفريق؛ إذ يحتاج عدة أشخاص لرؤية التشغيلات نفسها |
| فريق منصّات | التكاملات والظهور؛ إذ يجب أن يصمد سير العمل أمام أفضل وكيل قادم |
ذلك الصف الأخير هو جوهر المقارنة كلها. فأفضل وكيل اليوم قد لا يكون أفضل وكيل في الربع القادم، وإعادة بناء سير عملك في كل مرة تتغيّر الصدارة ضريبة بحد ذاتها. Sharkly ليست وكيل برمجة ولا أداة مقارنات؛ بل هي الطبقة التي تمكّنك من مواصلة اختبار الوكلاء على شفرتك الخاصة دون إعادة بناء العملية حولهم في كل مرة.
إذا كنت تريد مواصلة استخدام عدة وكلاء برمجة بدلًا من الالتزام بمنظومة واحدة، فهذه هي المشكلة التي صُمّمت Sharkly من أجلها. نزّل Sharkly، وصِل حاسوبًا واحدًا، وأسند المهمة الحقيقية نفسها إلى وكيلين. المقارنة التي ستحصل عليها تتعلق بقاعدة شفرتك، وهي الوحيدة التي تتوقع أسبوعك.


