
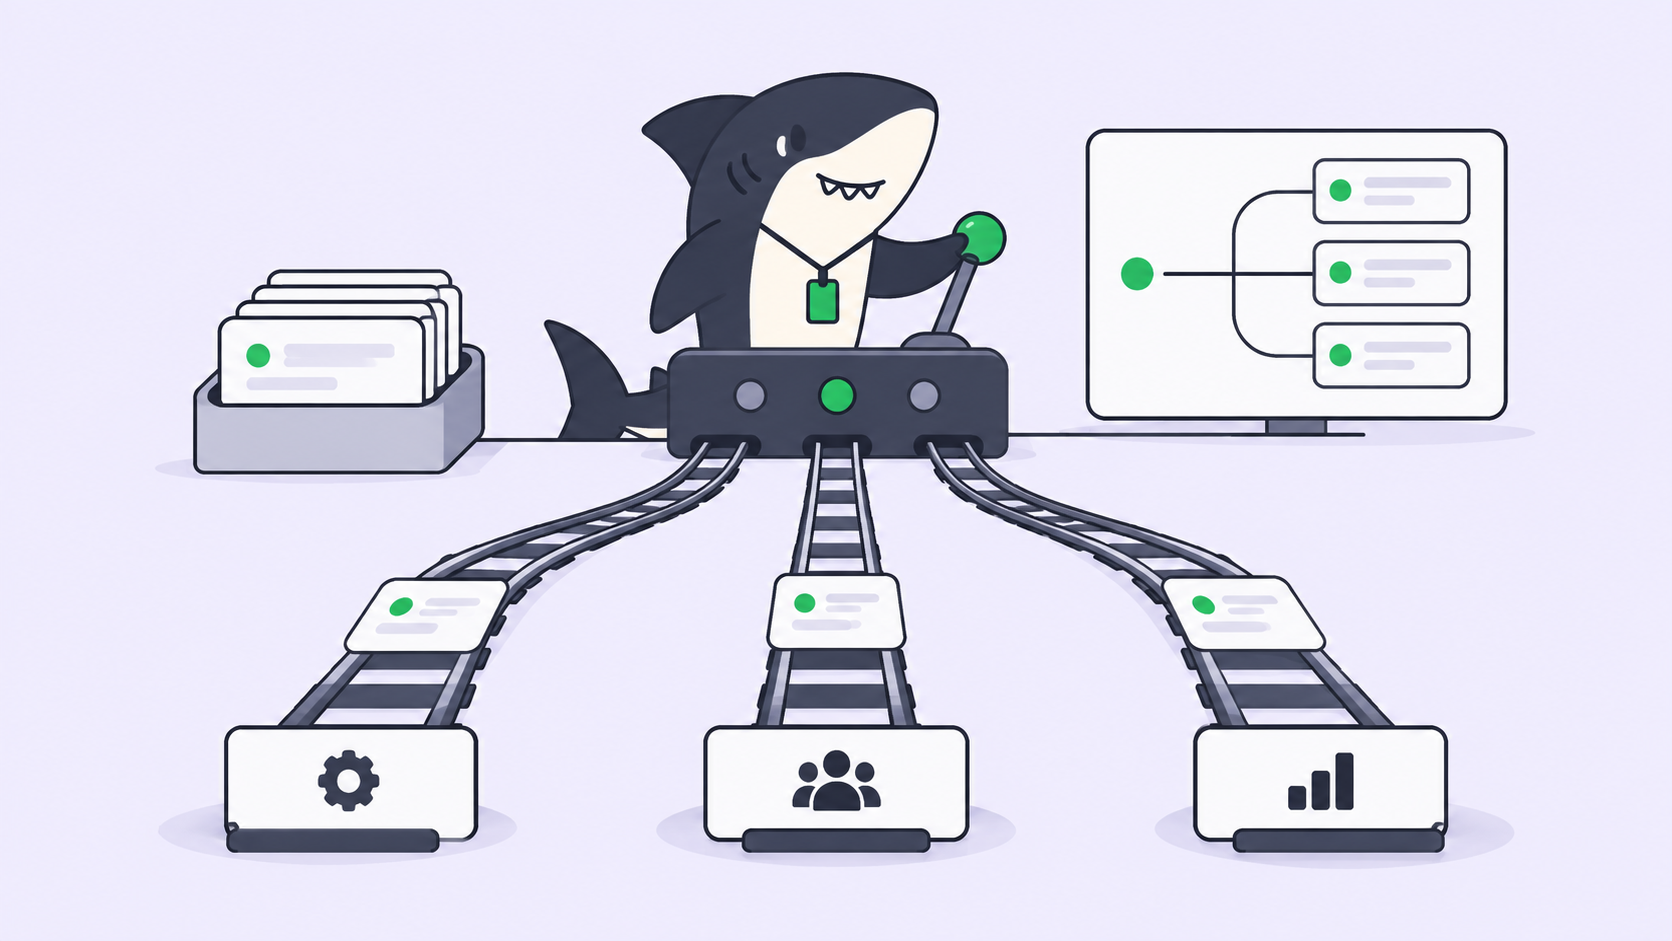
فريقك يوزّع العمل بين النماذج بالفعل. لكنه يفعل ذلك داخل رؤوس الناس فقط. مهندس واحد يشغّل كل شيء على الفئة الغالية لأنها تفشل أقل. وآخر انتقل الشهر الماضي إلى فئة رخيصة ولم يخبر أحدًا. وثالث ما زال يستخدم ما افترضته الأداة عند التثبيت. هذا أمر يمكن التعايش معه ما دام شخص واحد يشغّل Agent واحدًا. لكنه ينتهي في اللحظة التي تنفّذ فيها خمسة Agents بالتوازي، ولا يستطيع أحد أن يقول أيّها ينفق أكثر بأربعين ضعفًا مما يحتاجه على docstring، أو أيّها يفشل بهدوء في مهمة لم يكن قويًا بما يكفي للقيام بها.
في 22 سبتمبر 2026 اتسعت الفجوة بين الفئات بما يكفي ليصبح لها وزن. فأطلقت Anthropic نموذج Claude Opus 5.5، وأطلقت OpenAI نموذجَي GPT-6 Sol وGPT-6 Luna. والفرق بين أرخص الثلاثة وأغلاها يبلغ أربعين ضعفًا على توكنات الإدخال، وكل واحد منها جيد بما يكفي لتحويل مهمة حقيقية إليه.
قاعدة التوجيه بيان مكتوب، لا مجرد تفضيل
قاعدة التوجيه بيان مكتوب يحدد فئة المهام التي تعمل على أي Runtime، وتُربط بالـ Agent الذي ينفّذ العمل، لا بالشخص الذي صادف أنه بدأ التشغيل.
هذه هي الفكرة كلها، والجزء المهم منها هو كلمة «مكتوب». فالتفضيل يسكن في طرفية شخص واحد وينتهي بمجرد أن يخرج في إجازة. أما القاعدة فتعيش بجوار الـ Agent، فيرثها المكلَّف عندما يتسلم المهمة، ويستطيع المراجع أن يرى أي فئة أنتجت الـ diff الذي يقرأه، ويصبح تغيير رأيك في الربع القادم تعديلًا واحدًا بدلًا من ست محادثات.
قاعدة التوجيه ليست ترتيبًا للنماذج. إنها لا تدّعي وجود فائز، ولا تحتاج إلى واحد. إنها تقول إلى أين يتجه كل نوع من العمل افتراضيًا، وماذا يحدث عندما يتبين أن هذا الافتراض خاطئ.
كم تكلّف الفئات الثلاث
| Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | |
|---|---|---|---|
| معرّف API | claude-opus-5-5 |
gpt-6-sol |
gpt-6-luna |
| الإدخال / الإخراج لكل 1M | $4 / $20 | $2 / $10 | $0.10 / $0.50 |
| الإدخال المخزَّن مؤقتًا | $0.20 للقراءة، $5 للكتابة | خصم 90% على القراءات | خصم 90% على القراءات |
| السياق | 1M | 872k | 1M |
وللمقارنة: Claude Opus 5 بسعر $5 / $25، وGPT-6 Astra بسعر $10 / $50. وتصف OpenAI كلاً من Sol وLuna بأنهما أرخص بنسبة 50% من أسعار GPT-5.6 الترويجية. وكلمة «ترويجية» من OpenAI نفسها، وهي تغيّر المعنى: فالأساس الذي بُني عليه هذا العنوان هو سعر مخفَّض، لا السعر المعلن. وتقول OpenAI أيضًا إن Astra «ما زال أفضل نماذجنا في كل المجالات»، وهو تذكير مفيد بأن Sol هو فئة القيمة داخل عائلته، لا طرازه الرائد.
وثمة فحص عملي واحد قبل أن تكتب أي فئة في القاعدة: تُدرج OpenAI كلاً من Sol وLuna في ChatGPT Work وفي Codex لخطط Plus وPro وBusiness وEnterprise وEdu، مع حصول خطتي Free وGo على Luna في تطبيق سطح المكتب، وتقول إن أيًا منهما ليس متاحًا في Chat بعد. فمدى التوافر يشكّل قاعدة التوجيه بقدر ما يفعل السعر، لأن فئة لا يستطيع نصف الـ Crew الوصول إليها ليست فئة أصلًا.
وجّه على أساس التكلفة لكل مهمة مكتملة، لا على أساس سعر الـ token
سعر الـ token مجرد مؤشر تقريبي على الرقم الذي تدفعه فعليًا. فالنموذج الذي يكلّف خُمس السعر لكنه يحتاج أربع محاولات وتدخلًا بشريًا ليس أرخص. وقد نشرت OpenAI التكلفة لكل مهمة إلى جانب النتيجة في هذا الإطلاق، وهو أمر مباشر على نحو غير معتاد، ويشكّل النوع الصحيح من الأدلة لقرار التوجيه.
| المعيار، كما نشرته OpenAI | النتيجة | التكلفة لكل مهمة، نسبيًا |
|---|---|---|
| AutomationBench 1.0.6، Sol على extra-high | 33.2% | $0.27 لكل مهمة |
| AutomationBench 1.0.6، GPT-6 Astra على low | 30.3% | 3.9 أضعاف Sol |
| AutomationBench 1.0.6، Claude Opus 5 على max | 26.9% | 11.1 ضعفًا مقارنة بـ Sol |
| AutomationBench 1.0.6، Fable 5.1 مع Opus 5 كخيار احتياطي على max | 31.4% | أكثر من 8.9 أضعاف Sol |
| Agents’ Last Exam V1، Sol على max | 56.4%، أعلى من أفضل نتيجة لـ Opus 5 | أقل بنسبة 60% من Opus 5 |
| OSWorld 2.0 offline، Sol على extra-high | 60.5% مقابل 60.3% لـ Opus 5 على medium | أرخص بنحو 80% |
| DeepSWE 1.1، Luna على max | 66.6% | أرخص بنسبة 93% من Opus 5 |
| DeepSWE 1.1، Sol على max | 68.8%، بفارق 1.1 نقطة مئوية عن Fable 5 على extra-high | أرخص بنحو 80% |
ثمة أمران صحيحان في هذا الجدول في الوقت نفسه. الفوارق كبيرة، لكنها مقيسة مقابل Claude Opus 5 وليس Opus 5.5، الذي لم يكن موجودًا عند كتابة منشور OpenAI وصدر بعدها بساعات بتكلفة تشغيل أقل بنسبة 40% من Opus 5 بحسب ما ذكرته Anthropic نفسها. ولم يُعِد أحد إجراء المقارنة. لذا تعامل مع الصفوف باعتبارها آخر الأرقام المنشورة، ومع الترتيب الذي توحي به باعتباره فرضية تختبرها على مستودعك الخاص.
ما يبقى صحيحًا رغم هذا التحفظ هو الشكل العام، والشكل العام هو ما تحتاجه قاعدة التوجيه. فالفئات الرخيصة تصمد في العمل المحدود القابل للتكرار بتكلفة لا تمثل سوى جزء صغير. أما ما تدّعيه Anthropic بشأن Opus 5.5 فلا علاقة له إطلاقًا بسعر المهمة الواحدة: تكلفة تشغيل أقل بنسبة 40% من Opus 5، وإخراج أسرع بنحو 30%، وحد أقصى للإخراج يبلغ 128k، وقدرة على البقاء على المهمة لمدة 18 ساعة أو أكثر. هذه أوصاف نموذج توجّهه نحو عمل طويل وشاق، لا نموذج توجّهه نحو مئة مهمة صغيرة.
القاعدة مكتوبة
هذا هو المستند. إنه ممل عن قصد، ومكانه حيث يقرأه الفريق، لا في ملف إعدادات خاص على حاسوب شخصي واحد.
ROUTING RULE  (owner: platform, review: end of Sprint)

Tier 1  Runtime: Codex on gpt-6-luna
  Triage, labelling, changelog and release notes, first-pass review
  comments, test scaffolding, dependency bumps, doc edits.
  Rule of thumb: if a wrong answer costs a reviewer one minute, route here.

Tier 2  Runtime: Codex on gpt-6-sol           <- default
  Bounded feature work, bug fixes with a reproduction, refactors inside
  one module, anything repeated many times a day and cheap to retry.

Tier 3  Runtime: Claude Code on claude-opus-5-5
  Migrations, cross-cutting refactors, work that must hold context for
  hours, anything where stopping halfway costs more than the tokens.

ESCALATION
  A Tier 1 or Tier 2 Task that fails twice returns to the Task with its
  log and does NOT silently re-run on Tier 3. A person moves it.

EXCEPTIONS
  Named on the Task, with a reason, by the Assignee. Not in a DM.
ثلاثة أسطر هي التي تقوم بالعمل الحقيقي. فالفئة الافتراضية مذكورة بالاسم، فتستقر المهمة التي لم يفكر فيها أحد في مكان معقول. والتصعيد صريح، فلا يمكن لفشل رخيص أن يتسلسل إلى فشل مكلف دون أن يلاحظه أحد. والاستثناءات تُسجَّل على المهمة نفسها، وهذا هو الفرق بين قاعدة واقتراح.
التصعيد هو النصف الذي تتجاهله الفرق
الوفورات الواردة في الجدول أعلاه حقيقية على مستوى المحاولة الواحدة. لكنها تتبخر إذا تحولت محاولة رخيصة بشكل روتيني إلى إعادة محاولة مكلفة بالإضافة إلى إنقاذ بشري، لأنك حينها تدفع ثمن التشغيلين معًا وثمن المقاطعة. وهذا هو نمط الفشل في سلاسل الاحتياط التلقائي: فهي تخفي تكلفة الفئة الرخيصة داخل فاتورة الفئة المكلفة، ولا يستطيع أحد رؤية سعر الصرف.
لذا اجعل التصعيد يدويًا ومرئيًا. فالتشغيل الفاشل يعود إلى المهمة مصحوبًا بسجله، وبما أنجزه من diff حتى تلك اللحظة، وبالسؤال الذي توقف عنده. ويقرر إنسان ما إذا كان سيعيد توجيهه إلى فئة أعلى، أو يقسمه، أو يوضحه. الـ Agents تبحث وتنفذ وتختبر وترفع التقارير. أما البشر فيحددون الاتجاه، ويمنحون الصلاحية، ويقبلون النتيجة. وإذا كان مسار التصعيد لديك مجرد حلقة إعادة محاولة، فأنت قد أتمتت بالضبط القرار الذي كان يحتاج إلى إنسان.
وثمة أمر آخر يستحق الانتباه قبل أن توجّه عملًا حساسًا لزمن الاستجابة إلى فئة أدنى. فقد قاسَت Artificial Analysis، وهي طرف ثالث وليست أيًا من الشركتين، متغيّرات الاستدلال «max» فوجدت 115.2 توكن إخراج في الثانية لـ Sol مع 102.15 ثانية حتى أول توكن، و153.9 توكن في الثانية لـ Luna مع 124.23 ثانية. تحقق من هذه الأرقام مقابل القوائم الحالية قبل الاعتماد عليها. [VERIFY] والشكل العام هو المقصود: عند أقصى جهد استدلالي، ليست النماذج الرخيصة هي النماذج سريعة الانطلاق، والـ Agent الذي يفكر لمئة ثانية يبدو تمامًا كـ Agent توقّف عن الاستجابة. وأيًا كانت الفئة التي توجّه العمل إليها، فإن كيفية إبلاغ الـ Runtime عن التقدم والفشل هي ما يحدد إن كان أحد سيلاحظ الفرق.
متى لا تكتب قاعدة توجيه
إذا كنت تشغّل Agent واحدًا على مستودع واحد، فلا تفعل أيًا من هذا. اختر الفئة التي تناسب عملك وامضِ قدمًا. فالتوجيه يكلّفك مستندًا تحتاج إلى صيانته ونقاشًا تحتاج إلى خوضه، ولا يعود عليك بشيء إلا عندما تعمل عدة Agents في الوقت نفسه وتختلف تكلفتها أو نمط فشلها.
والحد الفاصل تقريبًا هو هذا: اكتب القاعدة عندما يستطيع شخصان أو أكثر بدء تشغيل، أو عندما تغطي ميزانية واحدة عدة Agents متزامنة. تحت هذا الحد، تكون القاعدة عبئًا إضافيًا. وفوقه، يكون غيابها هو السبب في أن لا أحد قادر على تفسير فاتورة الشهر الماضي.
الرقم الذي لا يتحرك
انخفضت التكلفة لكل مهمة مكتملة انخفاضًا حادًا على الجانبين في هذا الإطلاق. ولإعطاء فكرة عن الحجم: تُبلغ OpenAI أن إنفاق باحثيها عند الوسيط يتجاوز $600 في اليوم على الـ coding agents، بينما يبلغ المئين 90 نحو $7,000. والفرق التي تقع تحت هذا الخط حصلت للتو على عمل منجز من الـ Agents يزيد عدة أضعاف بالميزانية نفسها، وهو ما يستحق التتبع لكل Runtime بدلًا من كل فاتورة.
لكنها لم تحصل على أي ساعات مراجعة إضافية. فالتوجيه رافعة للتكلفة ورافعة للموثوقية، وليس رافعة للإنتاجية، لأن طابور العمل المنتظر لشخص يقبله لم يتغير. ما يستطيعه التوجيه هو أن يجعل هذا الطابور مقروءًا: أي فئة أنتجت هذا الـ diff، وكم كلّف، وكم محاولة استغرق، وما إذا كانت المهمة التي فشلت مرتين جالسة في صندوق وارد أحدهم أم في لا مكان على الإطلاق. أبقِ الهدف، والتشغيل، والتكلفة، والعوائق، والمراجعة على المهمة من الطلب حتى الإصدار، وستتحول قاعدة التوجيه إلى إعداد يعدّله الفريق بدلًا من عادة يحتفظ بها ستة أشخاص في الخفاء.
Sharkly لا تشغّل النموذج ولا تختاره نيابة عنك. إنها طبقة المهام والـ Computer والسياق والمراجعة المشتركة المحيطة بالأدوات التي تفعل ذلك، وهي المكان الذي يجب أن تعيش فيه قاعدة التوجيه إذا أردنا لها أن تبقى بعد من كتبها. وإذا كنت تشغّل بالفعل عدة coding agents، فإن أي نموذج يأخذ أي مهمة وأي Agent ينفذها هما القرار نفسه من وجهين مختلفين. اربط Computer واحدًا، وأنشئ Agent واحدًا لكل فئة، وأعطِ الرخيص منها شيئًا مملًا.


