
باختصار: تمكّن فريق الوكلاء الأذكياء (AI agents) في OpenAI من تحويل 5,034 هدف تدقيق في نواة لينكس (Linux kernel) إلى 948 ثغرة استغلال فريدة لتصعيد الصلاحيات محلياً بتكلفة بلغت قرابة 1.2 مليون دولار من أرصدة واجهة برمجة التطبيقات (API credits)، ليتولى بعدها باحثون بشريون مراجعة النتائج. يمكنك تطبيق هذا النمط نفسه على شيفراتك البرمجية: يستكشف الوكلاء ما يمكن الوصول إليه، ويحللونه، ويثبتون صحة كل نتيجة بمعزل عن غيرها ويصيغون حلاً لها، بينما يتولى عنصر بشري المراجعة والاعتماد.
في 4 نوفمبر 2026، نشرت OpenAI مقالاً بعنوان «A thousand fewer paths to root». العنوان الأبرز كان 948 ثغرة استغلال في لينكس، لكن الدرس الحقيقي لفرق تطوير البرمجيات يكمن خلف هذه الأرقام: تحققت هذه النتيجة بفضل وكلاء متخصصين عملوا عبر مراحل متتابعة، حيث سلّمت كل مرحلة أدلتها للمرحلة التالية، وصولاً إلى مراجع بشري في المرحلة الختامية.
لا يعتمد هذا التصميم على خبرة مسبقة بنواة النظام، لذا يمكنك توجيه الهيكل ذاته لفحص خدماتك الخاصة. والحاجة هنا ملحّة وحقيقية؛ إذ تفيد OpenAI بأن هذا المسار كان «ذا عائد إيجابي صافٍ» مقارنة ببرامج مكافآت الثغرات العامة. وبما أن المهاجمين قادرون على إجراء هذه الحسابات أيضاً، فمن الأفضل أن تبدأ الآن.
ما توصل إليه فريق الوكلاء الأذكياء في OpenAI
نفذت OpenAI هذا المسار في منتصف أكتوبر 2026 ضد أحدث إصدار من نواة لينكس، بالاعتماد على نموذج أمني قادم مخصص للتهديدات السيبرانية. وكانت الأهداف عبارة عن أجهزة افتراضية (VMs) معزولة تعمل بنظام تشغيل مكتبي تقليدي مع تفعيل كافة آليات الحماية القياسية.
| المرحلة | النتيجة | تكلفة واجهة برمجة التطبيقات (API) |
|---|---|---|
| الاستكشاف (Scout) | 5,034 هدف تدقيق، بنحو 2.8 مليون سطر، أي ما يقارب 7% من النواة | $3,426 |
| التحليل (Analyze) | 2,308 نتيجة مرشحة | $316,549 |
| التحقق (Validate) | إعادة إنتاج 1,724 ثغرة بنجاح (قرابة 74.7%) | $73,330 |
| تقييم قابلية الاستغلال (Assess exploitability) | 948 ثغرة استغلال فريدة لتصعيد الصلاحيات محلياً (LPE)، و291 إثبات مفهوم لتسريب المعلومات | $820,123 |
| الإجمالي | $1,213,430 |
هذه الأرقام تخص OpenAI على مستوى نواة النظام ككل، وليست تقديراً لما قد تتكبده مستودعاتك البرمجية. وتصف OpenAI هذه التكاليف بأنها «حد أقصى على الأرجح»، نظراً لأن هدفها كان قياس القدرات لا تحسين الكفاءة.
ضع في اعتبارك ثلاثة قيود أساسية:
- هذه الثغرات تختص بتصعيد الصلاحيات محلياً (LPE). أي أن المهاجم يحتاج أولاً إلى موطئ قدم محلي، فهي ليست ثغرات استغلال عن بُعد بحد ذاتها.
- العديد منها لم يُعالج بعد. عند انتهاء عملية الفحص والتحليل التي استمرت 10 أيام، كان قد تم ترقيع 61 ثغرة LPE في المستودع الرئيسي (upstream)، وتوفرت ترقيعات تمهيدية (staging) لـ 43 ثغرة، بينما كانت 299 ثغرة قيد النقاش العام. وقد أرسلت OpenAI مئات التقارير والترقيعات للثغرات الحرجة، وتواصل إرسال البقية تدريجياً بالتعاون مع شركاء مبادرة Patch the Planet.
- لا يشير منشور OpenAI إلى وجود استغلال فعلي لهذه الثغرات على أرض الواقع (in the wild).
ومع ذلك، تأتي توجيهات OpenAI صريحة وحاسمة؛ ففي أي نظام تشغيل لم يحصل على أحدث التحديثات والترقيعات، فإن وجود حساب ذي صلاحيات منخفضة «يجب اعتباره مكافئاً وظيفياً للوصول بصلاحيات الجذر (root) بالنسبة لأي طرف تهديد يمتلك موارد كافية». لذلك، سارع بتطبيق التحديثات، واحرص على تقليص نطاق التأثير من خلال تقنيات العزل مثل Firecracker وgVisor.
المراحل الخمس لمسار العمل الأمني باستخدام الوكلاء الأذكياء
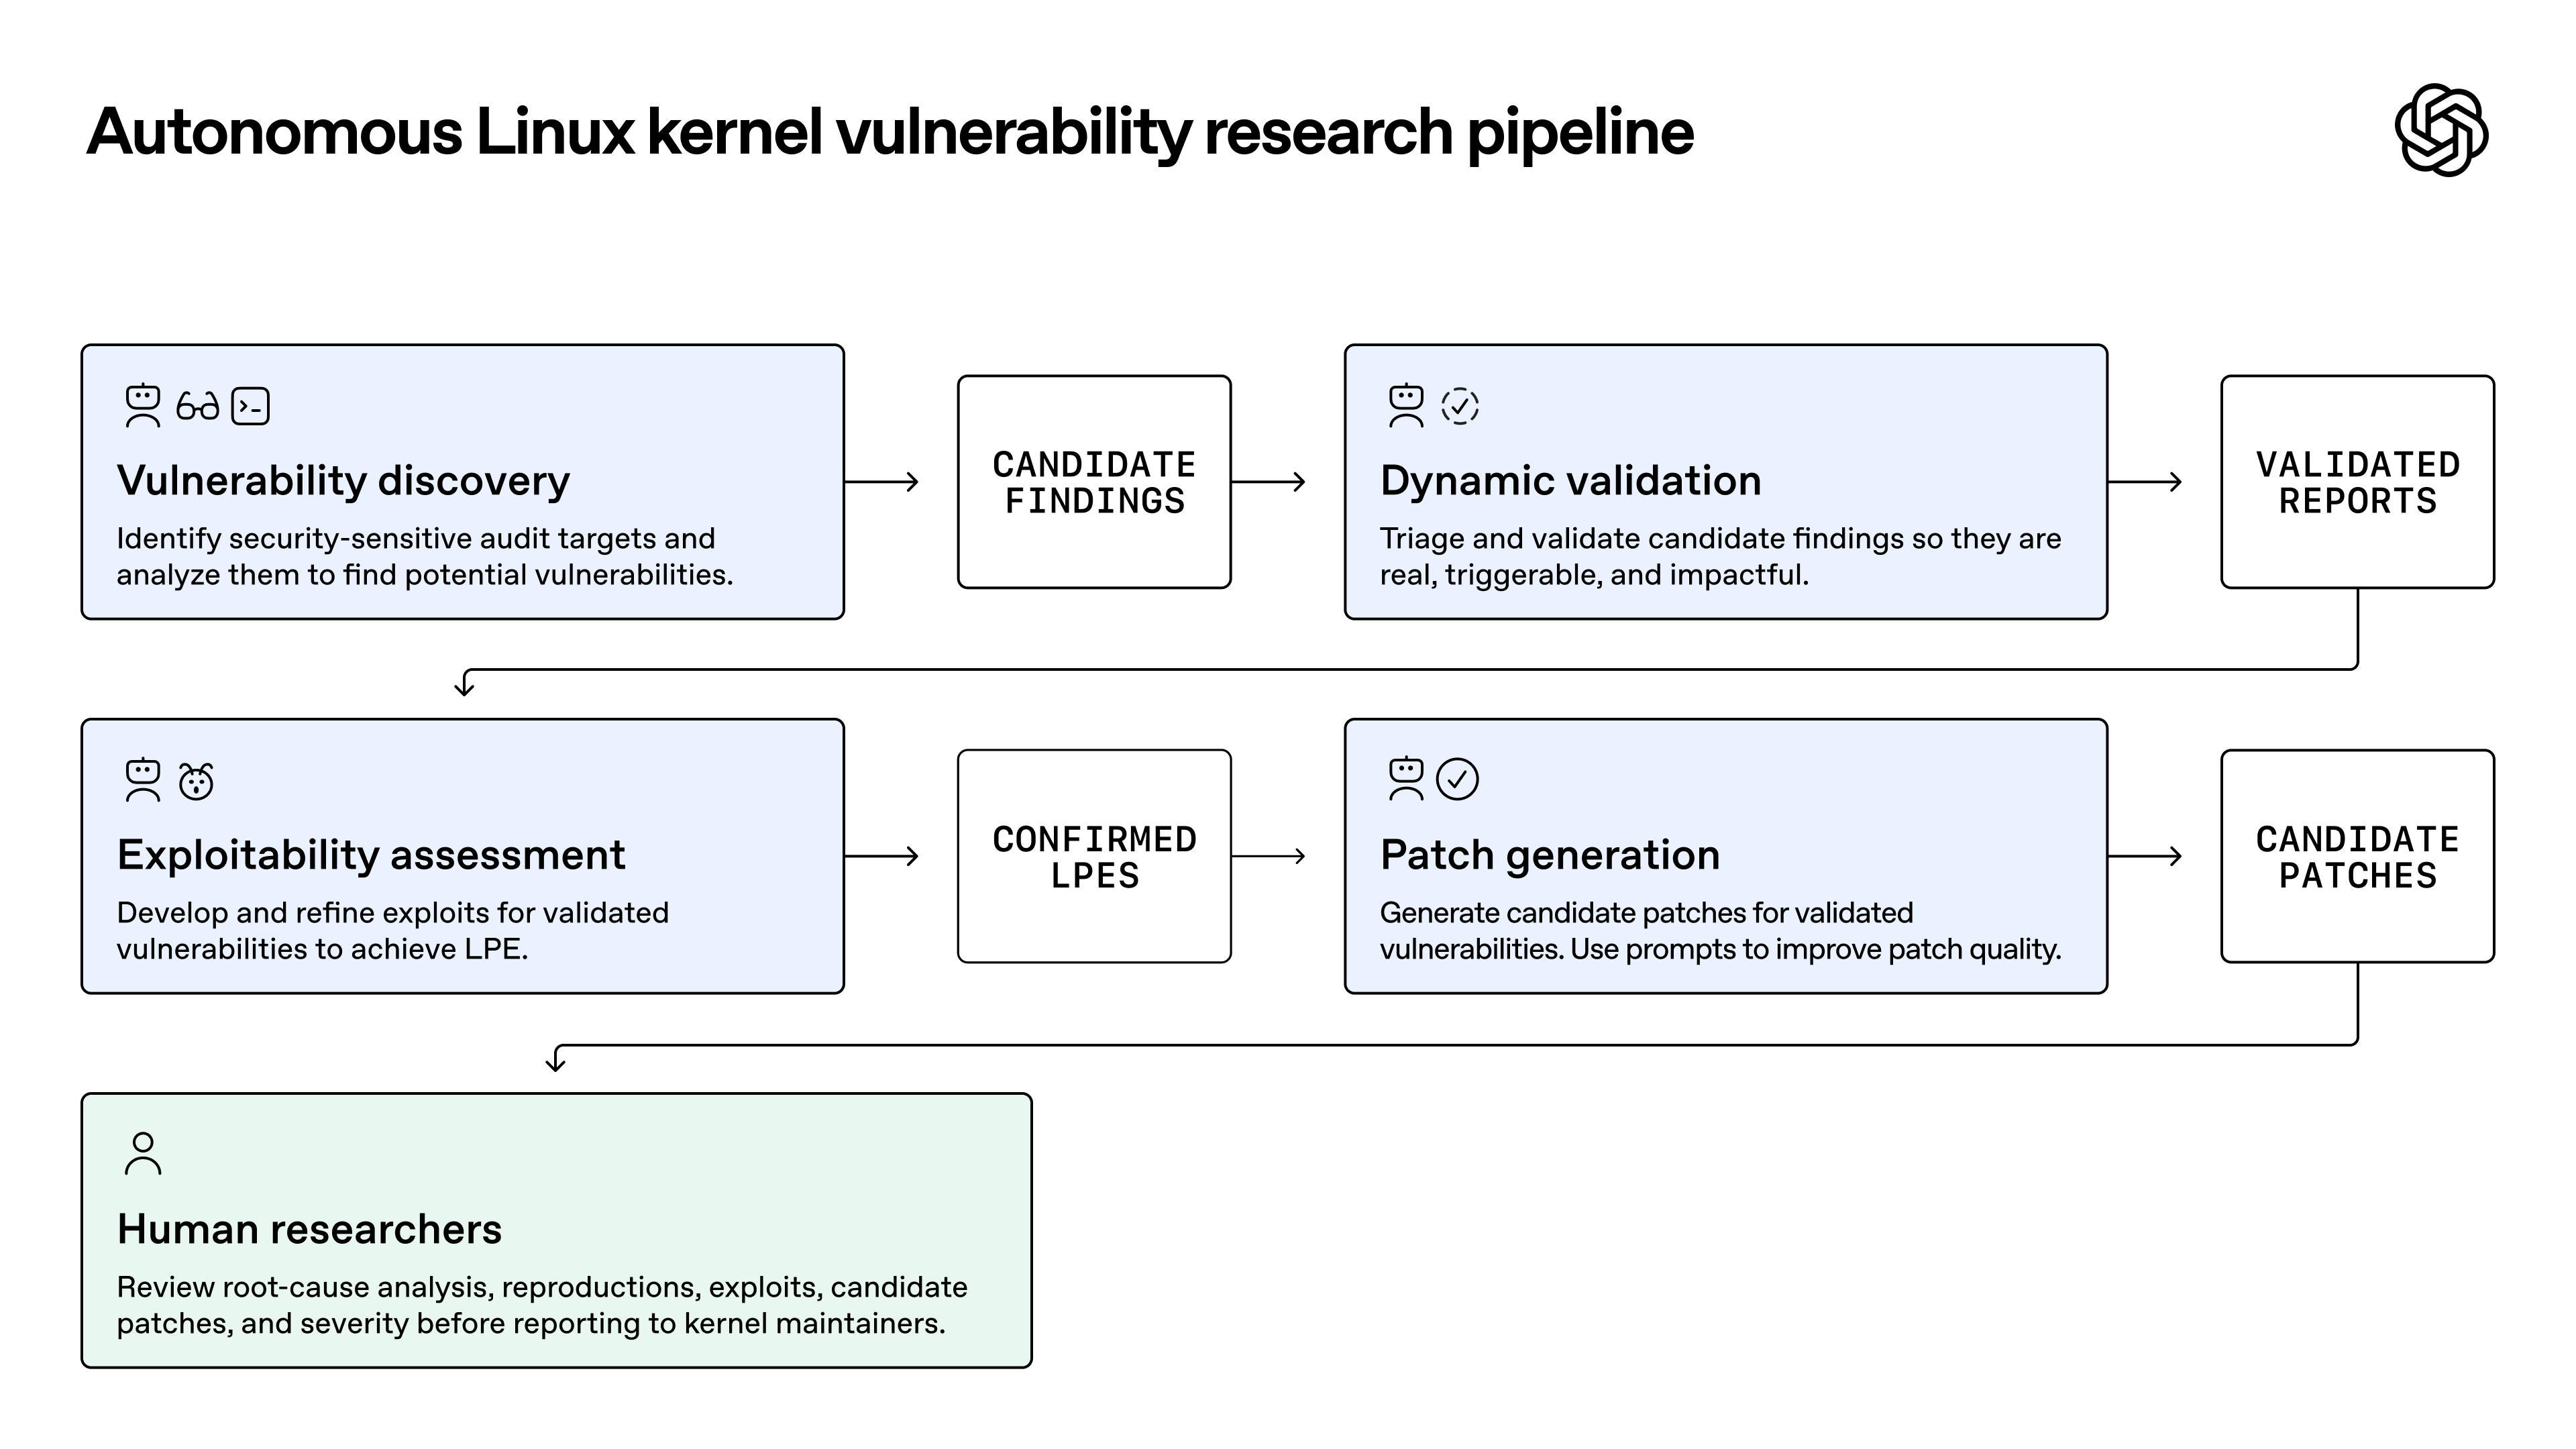
يقسم مسار العمل الأمني عبر الوكلاء الأذكياء المراجعة إلى مراحل متسلسلة، حيث تعمل كل مرحلة على تضييق نطاق العمل وتقديم الأدلة للمرحلة التي تليها. ويتكون نموذج OpenAI من خمس مراحل:
- الاستكشاف (Discovery). يختار وكلاء الاستكشاف (Scout agents) أهداف التدقيق بناءً على إمكانية الوصول إليها وأهميتها الأمنية. ثم يتولى وكلاء التحليل (Analyst agents) فحص كل هدف، وبناء نموذج للتهديدات، والإبلاغ عن الثغرات المحتملة.
- التحقق الديناميكي (Dynamic validation). يكتب وكلاء الفرز (Triage agents) كود إثبات مفهوم (PoC) ويشغلونه داخل جهاز افتراضي معزول مزود بأداة KASAN—وهي أداة لاكتشاف أخطاء الذاكرة في النواة—مع الاستمرار في تنقيح الكود حتى تظهر الثغرة مجدداً أو تُستنفد كافة الخيارات.
- تقييم قابلية الاستغلال (Exploitability assessment). يتولى وكيل الفرز المبدئي استبعاد النتائج التي لا تملك مساراً قابلاً للتطبيق، في حين يختبر وكلاء تطوير الاستغلال (ExploitDev agents) الحالات المتبقية.
- توليد الترقيعات (Patch generation). يصيغ الوكلاء ترقيعاً برمجياً لكل ثغرة مؤكدة، مع مراعاة الاصطلاحات البرمجية للكود المجاور والتحقق من عدم وجود أنماط مشابهة للخلل (variants).
- المراجعة البشرية (Human review). يراجع باحثو الأمان كود الاستغلال والترقيع ومستوى الخطورة بدقة قبل إرسال أي تفاصيل إلى مسؤولي الصيانة.
ينقل كل تسليم بين المراحل أدلة ملموسة لا مجرد آراء، مما يتيح للمراجع البشري في النهاية اتخاذ قراراته استناداً إلى حقائق مؤكدة.
كيفية تطبيق كل مرحلة على مستودعك البرمجي
لا تطبق مسار العمل هذا إلا على الشيفرات البرمجية التي تملكها أو تملك تصريحاً صريحاً باختبارها. أما بالنسبة لمستودعك البرمجي، فيمكنك الاستغناء تماماً عن مرحلة بناء ثغرات الاستغلال؛ فاختبار الفشل (failing test) كافٍ لإثبات وجود الخلل دون الحاجة لإنشاء أدوات هجومية.
| مرحلة OpenAI | النسخة المخصصة لك | المخرجات |
|---|---|---|
| الاستكشاف (Scout) | حصر نقاط الدخول القابلة للوصول من المستخدمين المجهولين أو ذوي الصلاحيات المنخفضة: المسارات، وخطافات الويب (webhooks)، وعمليات الرفع، وأدوات التحليل، ومستهلكي قوائم الانتظار (queue consumers) | قائمة التدقيق |
| التحليل (Analyst) | هدف واحد في كل تشغيلة: قراءة الكود، وكتابة نموذج تهديد موجز، والإبلاغ عن الثغرات المشتبه بها | النتائج المرشحة |
| التحقق (Validate) | كتابة اختبار فاشل بحد أدنى من الشيفرة البرمجية في بيئة مؤقتة قابلة للإتلاف (disposable) | كود الاختبار مع سجل النتائج |
| التقييم (Assess) | تقييم مستوى التأثير بناءً على حدود الثقة (trust boundary) التي تم اختراقها | مستوى الخطورة مع الأسباب |
| الترقيع (Patch) | صياغة الإصلاح كطلب سحب (pull request) متضمناً كود الاختبار | طلب سحب (Pull request) |
| المراجعة البشرية (Human) | المراجعة، ثم الدمج أو الرفض | إصلاح مدمج أو إغلاق النتيجة |
تحديد النطاق بدقة يوفر تكلفته؛ فقد بلغت تكلفة وكلاء الاستكشاف لدى OpenAI نحو 3,426 دولاراً، وأدت إلى تقليص التدقيق إلى نحو 7% فقط من النواة. ابدأ بخدمة واحدة ونقاط الدخول العامة الخاصة بها. يمكن لمهمة مخصصة لنتيجة واحدة أن تكون موجزة بهذا الشكل:
Title: Validate finding: path traversal in /api/exports/download

Scope: this repository only. Disposable test environment only.
No production credentials, no external network targets.

Goal: write a minimal failing test that proves or disproves the finding.
Evidence: test file, command output, code path from entry point to flaw.
Give up: stop after two approaches with no new evidence. Report what you tried.
Do not: fix the bug here, build an attack payload, or merge anything.
تحقق من المسار، وليس من النتيجة فحسب
في إحدى مراحل التشغيل المبكرة، أبلغت مرحلة الاستغلال لدى OpenAI عن 200 محاولة ناجحة. لكن المراجعة البشرية كشفت أن 20 منها وصلت إلى صلاحيات الجذر عبر ثغرة يوم الصفر (0-day) مختلفة تماماً عن تلك المحددة للمهمة. فقد حكم المسار بنجاح العملية بناءً على النتيجة النهائية فقط، وكانت النتيجة صحيحة ولكن لسبب غير مقصود.
قامت OpenAI على إثر ذلك بتشديد قيود المهمة وأضافت فحصاً مستقلاً للتأكد من أن كل استغلال يعتمد بالفعل على الثغرة المحددة له. والخلاصة المستفادة هنا: تحقق من المسار المؤدي إلى النتيجة بالقدر نفسه الذي تتحقق به من النتيجة ذاتها.
يتكرر هذا السيناريو كثيراً في بيئات العمل: يدعي أحد الوكلاء أن اختباره يثبت وجود خلل في المصادقة، بينما يكون سبب فشل الاختبار في الواقع هو غياب بيانات تجريبية (missing fixture). أضف وكيلاً للمراجعة لم يشارك في كتابة الاختبار، واطرح عليه سؤالاً واحداً: هل هذا الفشل ناتج فعلاً عن مسار الكود المبلغ عنه؟
تحقق مبكراً، فالإيجابيات الزائفة تكلف القدر نفسه
وجدت OpenAI أن محاولة التحقق من نتيجة صحيحة حقيقية والتحقق من نتيجة إيجابية زائفة تكلفان المقدار نفسه تقريباً. وبناءً عليه، فإن كل نتيجة غير دقيقة تصل إلى مرحلة التحقق تستهلك تكلفة تشغيل كاملة دون جدوى.
لذلك، قم بالتصفية قبل الشروع في الإثبات. ركزت OpenAI في التحقق على النتائج التي يمكن للمستخدم منخفض الصلاحيات الوصول إليها، والتي لا تتطلب امتيازات خاصة، وتنتج أدلة قابلة للقياس. ضع معايير تصفية مماثلة لشيفراتك البرمجية، مثل «إمكانية الوصول دون الحاجة لصلاحيات مدير (admin)». والنتائج التي لا تجتاز هذا المعيار يتم إغلاقها مع ذكر السبب.
بعد ذلك، أعد فحص النتائج مقارنة بأحدث إصدار من الكود قبل الإبلاغ عنها، كما توصي بذلك OpenAI، لتجنب إرسال تقارير مكررة أو قديمة تجاوزها التحديث.
حدد شرطاً للتوقف قبل بدء التشغيل
كانت المحاولات الفاشلة هي الأعلى تكلفة. ففيما يتعلق بالثغرات المرشحة لتصعيد الصلاحيات محلياً، بلغت تكلفة 69 محاولة فاشلة ما متوسطه 3,922 دولاراً لكل منها، بينما لم يتجاوز متوسط تكلفة 1,169 محاولة ناجحة 360 دولاراً. وبحسب تقديراتنا، يمثل ذلك نحو 6% من المحاولات استحوذت على ما يقارب 39% من أصل 691,000 دولار أُنفقت على تلك المرحلة.
تمثل الحل المقترح من OpenAI في وضع شرط صريح للتوقف (give-up condition)، مثل إنهاء المحاولة بعد مضي ساعة دون إحراز أي تقدم. ضمّن هذه القاعدة في تعليمات المهمة، وعززها بفرض حد زمني صارم على مدة التشغيل.
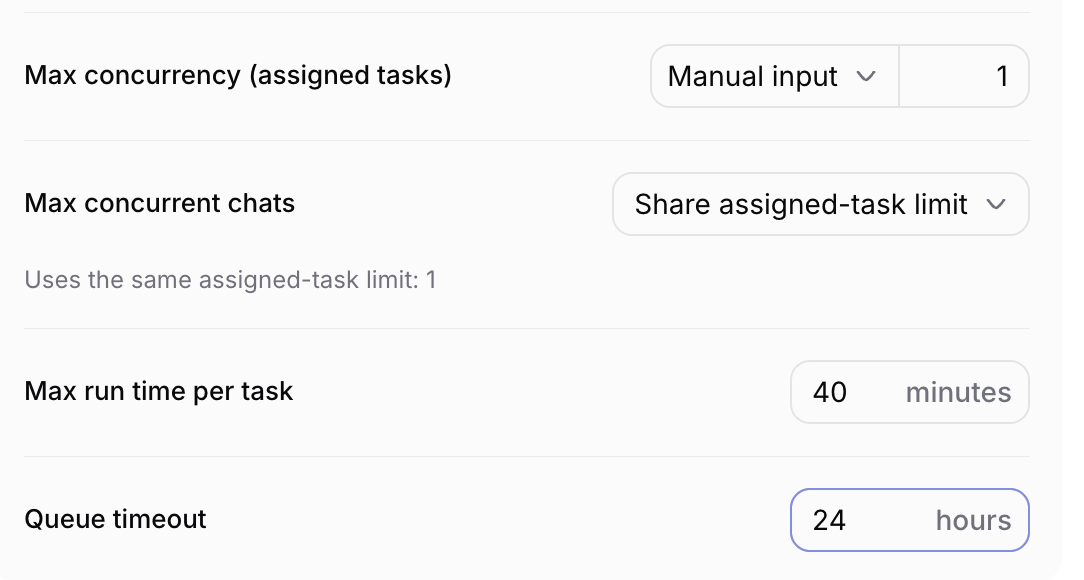
في منصة Sharkly، يتم ضبط مهلة المهمة عبر إعدادات التشغيل (Run settings) الخاصة بالوكيل. يمثل هذا الخيار حداً زمنياً أقصى وليس أداة لرصد التقدم، لذا احرص على إبقاء قاعدة «التوقف عند عدم توفر أدلة جديدة» واضحة داخل التعليمات.
اجعل التنسيق بسيطاً ومرناً مع تطور النماذج
قامت OpenAI ببناء طبقة تضم 103 تقنيات استغلال لنموذج GPT-5.5 Cyber، مما رفع نسبة نجاحه من 76.2% إلى 88.9%. ولكن عند اختبار الطبقة نفسها على نموذج GPT-5.6 Cyber، لم تضف سوى 1.5 نقطة مئوية، مما دفع OpenAI إلى إزالتها كلياً.
أعد تقييم البنية المساعدة (scaffolding) الخاصة بك في كل مرة تقوم فيها بتغيير النماذج. وكرر عمليات الفحص دورياً؛ إذ تمكنت عملية الفحص المنفذة في أكتوبر من اكتشاف أكثر من خمسة أضعاف الثغرات الجديدة لتصعيد الصلاحيات محلياً مقارنة بعملية فحص سابقة في يوليو باستخدام GPT-5.6 Sol، وذلك على شيفرة برمجية خضعت لثلاثة أشهر إضافية من التحصين الأمني.
حافظ على المراجعة البشرية قبل طرح أي تعديل
يقوم الوكلاء بصياغة الترقيعات في صورة طلبات سحب، بينما يتولى المطور البشري عملية الدمج. لاحظت OpenAI أن الترقيعات المنجزة في المحاولة الأولى قد تأتي أكبر من اللازم، أو تغفل بعض الحالات المشابهة، أو تخالف معايير كتابة الكود المتبعة، وأن إجراء جولات مراجعة إضافية كفيل بتحسين جودتها.
كما توصي الشركة بالاستعانة بالنماذج الذكية لإجراء مراجعة نقدية مضادة (adversarial review) للترقيعات التي يكتبها البشر والذكاء الاصطناعي على حد سواء. لذلك، اطلب من أحد الوكلاء محاولة تجاوز الإصلاح المقترح، ثم اترك القرار النهائي للإنسان. وإذا كانت مرحلة المراجعة تمثل بالفعل عنق الزجاجة لديك، فاطّلع على دليلنا حول كيفية تصميم عمليات المراجعة للوكلاء الذين يعملون بالتوازي قبل إضافة مسار تدفق جديد من طلبات السحب.
كيفية تشغيل مسار العمل في صورة مهام على Sharkly
تمثل المهمة (Task) وحدة العمل الرئيسية في Sharkly. وإليك إحدى الطرق الفعالة لبناء هذا المسار:
- إنشاء نوع المهمة. يتضمن كل نوع مهمة (task type) مسار عمل (Workflow) واحداً بحالات مرتبة. ويمكن لنوع «نتيجة أمنية» (Security finding) أن يتدرج عبر: مرشح (Candidate)، تم إثباته (Reproduced)، كُتب ترقيعه (Patch drafted)، قيد المراجعة (In review)، مغلق (Closed).
- إنشاء فريق عمل (Crew). يمثل الفريق (Crew) مجموعة قابلة لإعادة الاستخدام تضم أفراداً ووكلاء أذكياء يقودهم وكيل رئيسي. أضف وكلاء للاستكشاف والتحليل والفحص والترقيع؛ حيث يبدأ القائد أولاً ويوجه المهام للأعضاء بحسب التخصص.
- عزل عمليات التشغيل. استخدم دليلاً مؤقتاً (temporary directory) لتحصل كل مهمة على مساحة عمل مستقلة (worktree)، وراجع دليلنا لمساحات العمل المعزولة في حال التوسع المتوازي. واحرص على تعطيل المجلد المشترك للفريق في المواضع التي تتطلب استقلالية تامة لوكيل الفحص.
- أتمتة تسليم المهام. يمكن لأداة الأتمتة (Automation) المشروطة بتغيير حالة المهمة أن تُطلق وكيل الترقيع فور وصول المهمة إلى حالة «تم إثباته» (Reproduced). تعمل هذه العمليات بشكل آلي دون تدخل بشري ولا يمكنها طرح استفسارات، كما أن مطابقة الحالات تسري على مستوى المؤسسة بالكامل، لذا احرص على تضمين التعليمات ما يؤكد المهمة المسببة للتشغيل.
- ربط طلبات السحب. بفضل التكامل مع GitHub، فإن تضمين معرف المهمة في اسم الفرع أو العنوان أو الوصف كفيل بربط طلب السحب تلقائياً. وبما أن الدمج لا يغير حالة المهمة مباشرة، يتولى المراجع إغلاق المهمة بنفسه.
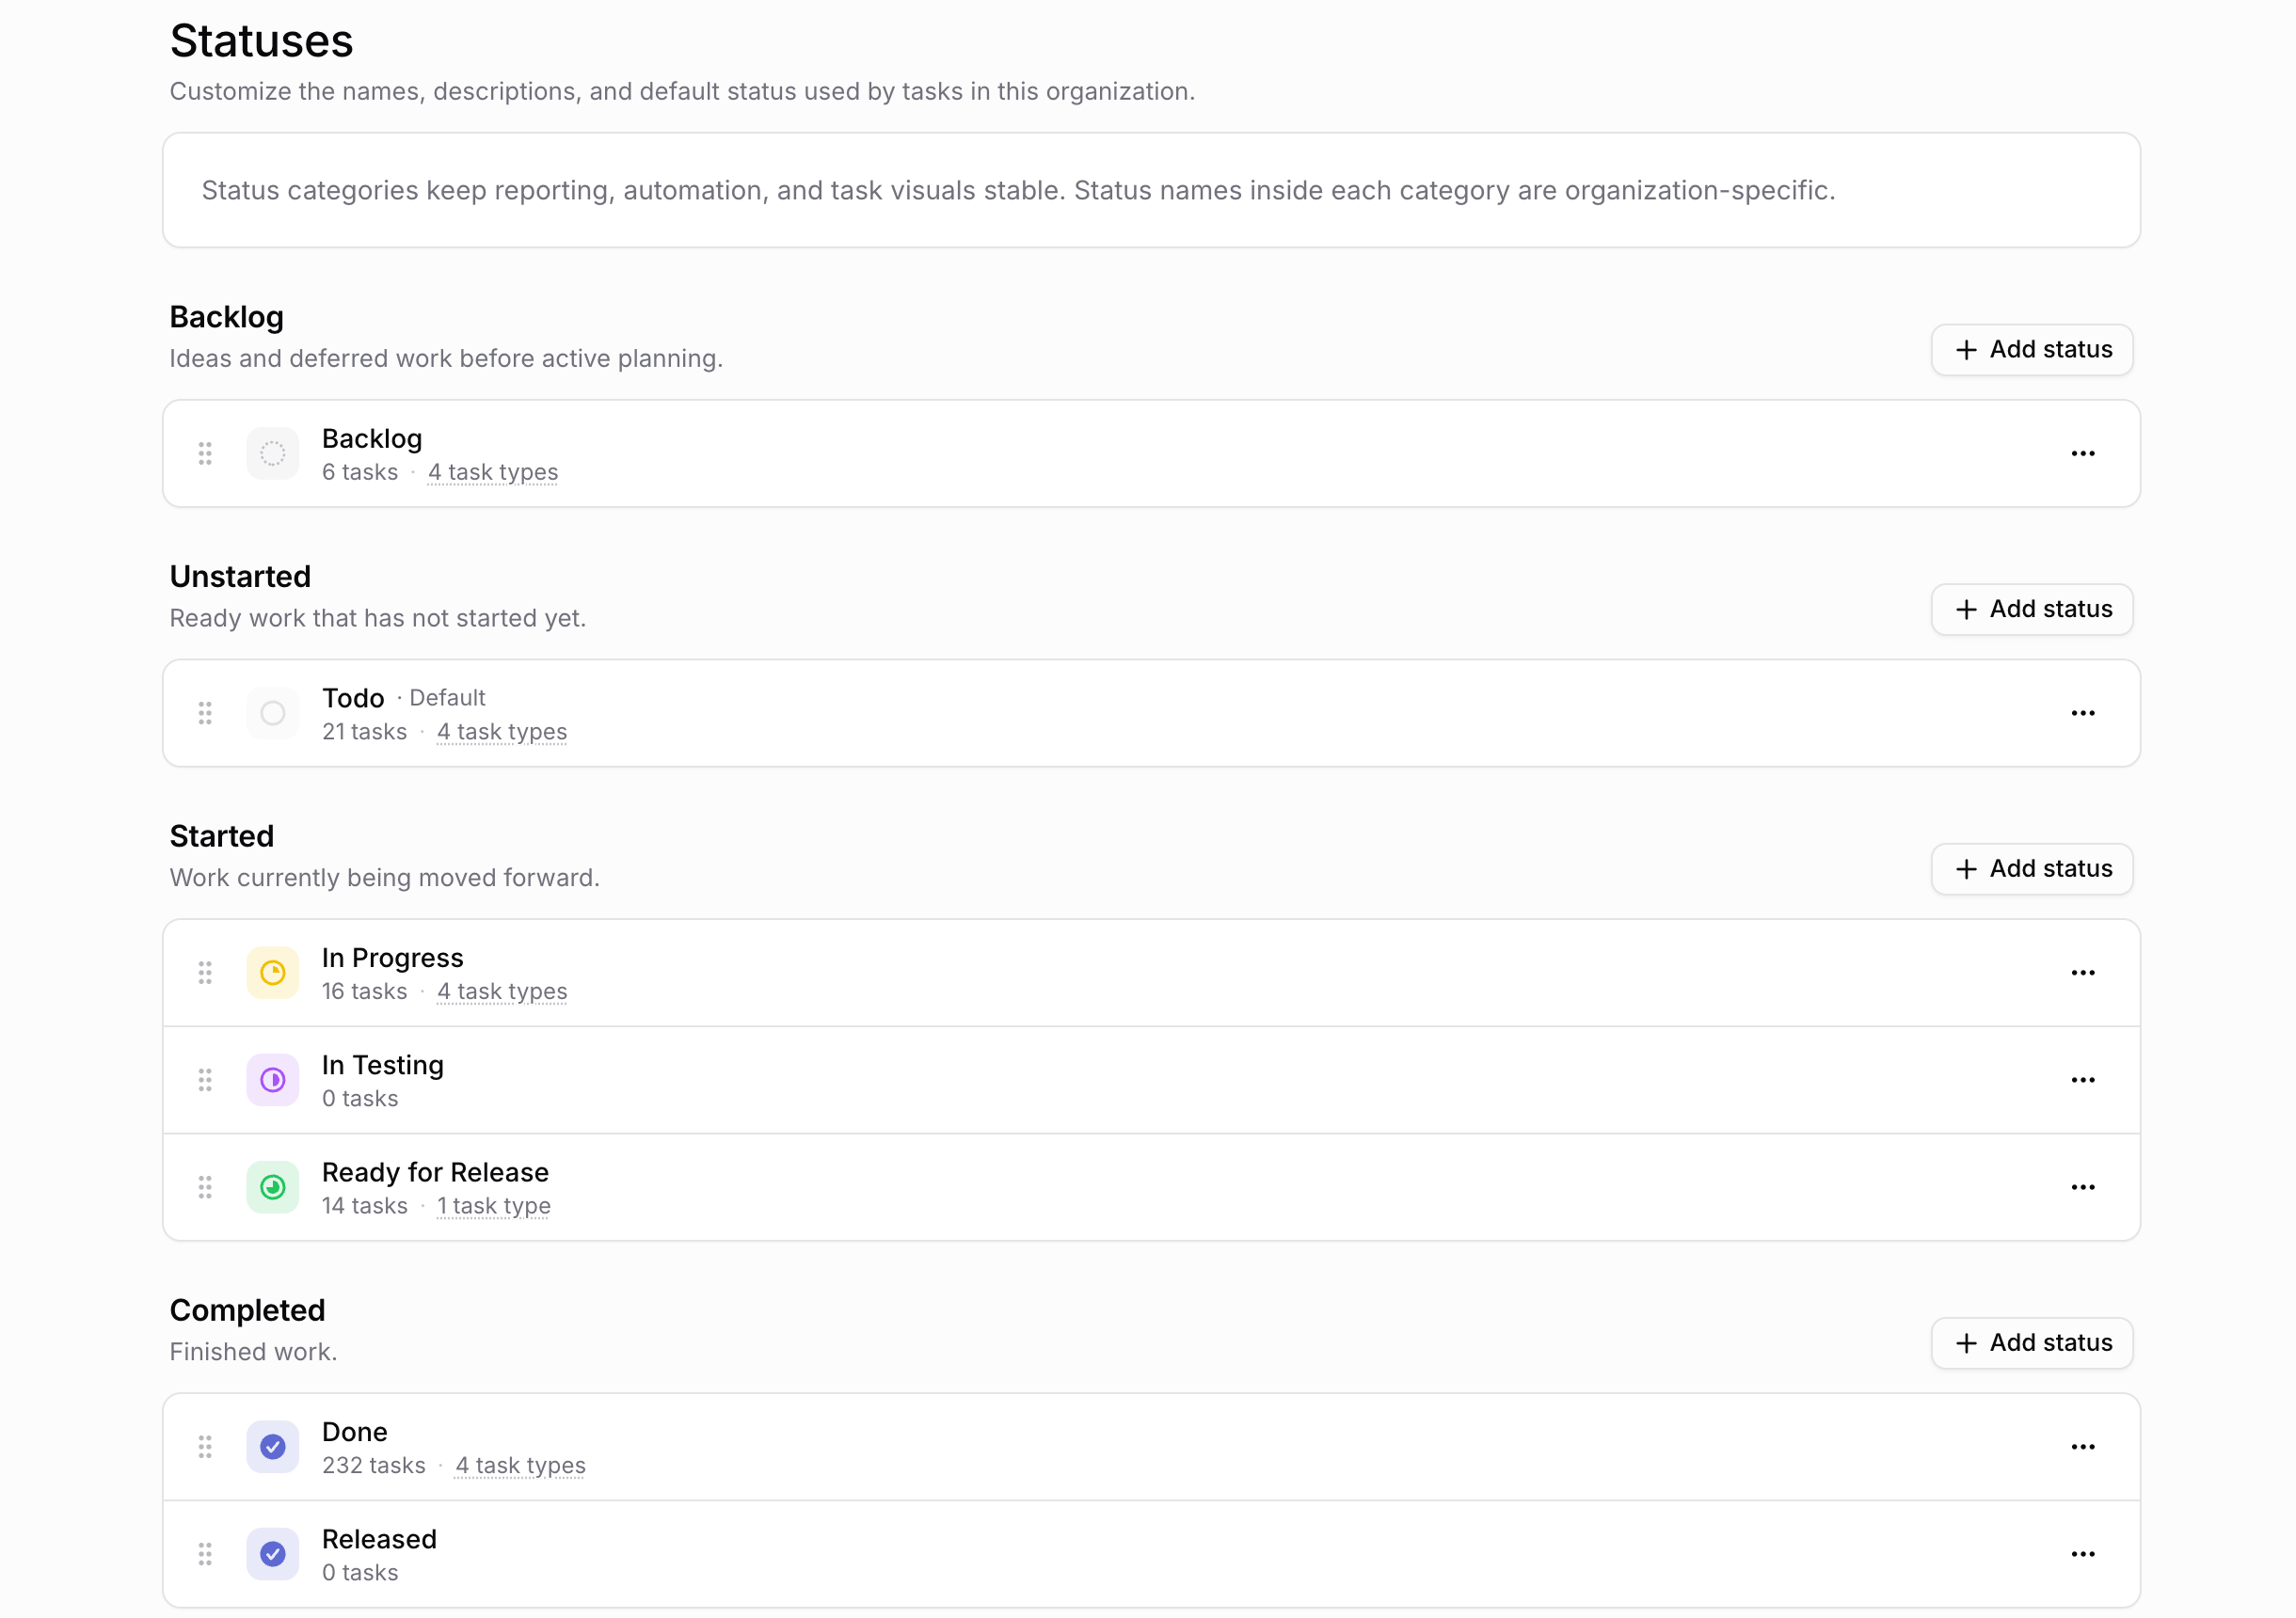
الحالات مشتركة على مستوى المؤسسة ككل، لذا يفضل إضافة حالات جديدة مخصصة لمسار العمل هذا بدلاً من تعديل الحالات الحالية.
وهناك حد أمني فاصل تجب مراعاته: شجرة العمل المستقلة (worktree) تمنع تداخل المهام وتعارضها، لكنها لا تُعد بيئة عزل أمني (sandbox). لذلك، احرص على تشغيل اختبارات إعادة الإنتاج داخل حاوية مؤقتة أو جهاز افتراضي مستقل لا يحتوي على أسرار أو بيانات بيئة الإنتاج، وامنح الوكلاء أدنى حد من صلاحيات Git التي يحتاجونها لإتمام عملهم.
تتولى Sharkly تنسيق هذه المنظومة بالكامل، في حين تتولى أدوات مثل Claude Code وCodex وغيرها تنفيذ المهام فعلياً، وتستمر تكلفة استخدام النماذج عبر الاشتراكات أو مفاتيح واجهة برمجة التطبيقات (API) المحددة داخل تلك الأدوات. وإذا كنت بصدد التوسع، فاطلع على مقالنا حول كيفية تشغيل 10 وكلاء برمجة أذكياء بالتوازي في الوقت نفسه.
بالنسبة للمستودعات الصغيرة، يمكنك الاكتفاء بتعيين وكيل واحد لكل مهمة دون الحاجة لإنشاء فريق (Crew). واحتفظ بخيار الفرق للحالات التي تتطلب من القائد ترتيب عدة أدوار ودمج نتائجها في مهمة واحدة مشتركة.
خاتمة
تقدم نتائج OpenAI مخطط عمل جاهزاً لفريقك: حدد النطاق بدقة، واطلب أدلة ملموسة عند كل مرحلة تسليم، وتحقق من المسار الفعلي، وتوقف مبكراً عن المحاولات غير المجدية، ودع قرار الضغط على زر الدمج دائماً في يد خبير بشري.
ابدأ هذا الأسبوع: اختر خدمة واحدة من الخدمات التي تديرها، واجمع نقاط الدخول العامة الخاصة بها، وأنشئ مهمة تحقق واحدة لكل ثغرة تشتبه بها. يساعدك دليل البدء السريع لـ Sharkly على إطلاق وكيلك الأول على جهاز متصل، كما يوضح لك sharkly.ai كيف تتكامل طبقة إدارة المهام والمراجعة بسلاسة حول وكلائك الأذكياء.
الأسئلة الشائعة
هل هاجم وكلاء OpenAI أنظمة لينكس حية ونشطة؟
لا؛ فقد نُفذت عمليات الاستغلال داخل أجهزة افتراضية معزولة ضمن بيئة بحثية خاضعة للرقابة الكاملة، وتولى باحثون بشريون مراجعة النتائج قبل إرسال التقارير بشأنها.
هل تم ترقيع جميع الثغرات الـ 948 المكتشفة في لينكس؟
لا؛ فالعديد منها لا يزال في مرحلة الإبلاغ والمعالجة. وعند انتهاء عملية الفحص التي استمرت 10 أيام، كان قد تم ترقيع 61 ثغرة في المستودع الرئيسي، وتوفرت ترقيعات تجريبية تمهيدية لـ 43 ثغرة أخرى.
هل يمكن لهذه الثغرات اختراق الخوادم عن بُعد؟
ليس بمفردها؛ فهذه ثغرات مخصصة لتصعيد الصلاحيات محلياً، مما يعني أن المهاجم يحتاج أولاً إلى موطئ قدم أولي داخل النظام. احرص دائماً على تحديث أنظمتك وعزل أعباء العمل غير الموثوقة.
كم سيكلف تطبيق مسار العمل هذا على مستودعي البرمجي؟
لا تنطبق أرقام OpenAI مباشرة على حالتك لأنها شملت فحصاً ضخماً على مستوى نواة النظام ككل. ابدأ بخدمة واحدة، وحدد قيوداً للتشغيل، وقس التكلفة الفعلية لكل نتيجة مؤكدة يتم إثباتها.
هل أحتاج إلى نموذج OpenAI المخصص للتهديدات السيبرانية؟
لا يمكنك استخدامه في الوقت الراهن لأنه ما زال نموذجاً قادماً بحسب تصريح OpenAI. كما أن مراحل مسار العمل محايدة وتعمل مع أي نموذج، لذا يمكنك تجربتها باستخدام وكلاء البرمجة المعتمدين لدى فريقك حالياً وتقييم المخرجات بناءً على ما تقدمه من أدلة واقعية.


