
أيهما تختار: Argon أم Carbon؟ نفّذ معظم مهام الوكلاء على Gemini 4 Argon، واقتصر في توجيه المهام المعقدة فقط على Gemini 4 Carbon. هذا ما تؤكده Google بنفسها: يظل Argon هو الخيار الافتراضي لغالبية أعمال هندسة البرمجيات، بينما خُصص Carbon للمهام الأكثر صعوبة. تبلغ تكلفة كلا النموذجين دولارين للإدخال و10 دولارات للإخراج لكل مليون رمز مميز حتى 30 نوفمبر 2026، إلا أن Carbon يستهلك عدداً أكبر من الرموز في كل مهمة.
خلاصة المقال
- ابدأ بالأقل تكلفة افتراضياً، وصعّد بناءً على الأدلة. ابدأ كل مهمة بالنموذج السريع، ولا ترقّها إلى النموذج الأقوى إلا عندما تستوفي معياراً واضحاً يثبت تعقيدها، أو إذا فشلت في التجربة الأولى.
- تساوي سعر الرمز لا يعني بالضرورة تساوي تكلفة المهمة. يقرأ نموذج Carbon أكثر، ويتعمق في الاستدلال والتفكير لمدة أطول، ويجري عمليات تحقق أوسع؛ لذا تستهلك المهمة الواحدة عدداً أكبر من الرموز.
- أربع مؤشرات تدل على صعوبة المهمة: الأفق الزمني الطويل، كثرة الملفات المعنية، التأثير الأمني، أو الفشل في محاولة التنفيذ الأولى.
- قِس رقمين لكل مهمة: التكلفة الإجمالية ومعدل النجاح عند المراجعة. وجّه مهامك بالاعتماد على هذين المؤشرين، لا على لوحات الصدارة.
- اجعل اختيار النموذج إعداداً ثابتاً، لا قراراً تعيد اتخاذه مع كل مطالبة (Prompt). في Sharkly، يمتلك كل وكيل نموذجاً افتراضياً، مع إمكانية تجاوزه لجولة تشغيل واحدة عند إسناد المهمة.
لماذا يُعد السؤال عن «النموذج الأفضل» سؤالاً خاطئاً؟
أصبح Gemini 4 Carbon متاحاً للاستخدام العام (GA) في 10 نوفمبر 2026 بمعرّف النموذج gemini-4-carbon. ويحمل منشور الإطلاق العام من Google مفارقة قلّما نراها في إعلانات الإطلاق؛ إذ ينصحك صراحةً بعدم استخدام هذا النموذج الأحدث في معظم الأعمال: «يظل Argon الخيار المثالي للغالبية العظمى من مهام هندسة البرمجيات والأعمال المعرفية».
أما نموذج Carbon، وبحسب المنشور نفسه، فهو «مصمم للمهام التي تختبر أقصى حدود ذكاء النموذج»، ويستهلك «رموزاً أكثر من Argon للاستكشاف الشامل، والاستدلال العميق، وتشغيل حلقات تحقق مطوّلة».
ينسجم هذا الطرح تماماً مع الكيفية التي تدير بها الفرق وكلائها البرمجيين. فأنت أمام قائمة انتظار تضم مهام متفاوتة في الصعوبة، وتستحق كل مهمة استخدام النموذج الأقل تكلفة القادر على اجتياز المراجعة بنجاح. واعتماد نموذج «أفضل» موحد للفريق بأكمله يعني إما إنفاقاً مفرطاً على مهام سهلة، أو أداءً دون المستوى في المهام المعقدة.
إذا أردت الاطلاع على الصورة الكاملة لنموذج Carbon أولاً، فإن مقالنا حول Gemini 4 Carbon لوكلاء البرمجة يغطي جميع تفاصيله، بينما يستعرض دليل Gemini 4 Argon إمكانيات الخيار الافتراضي.
قاعدة التوجيه: الاقتصاد كخيار افتراضي، والتصعيد للمهام الصعبة
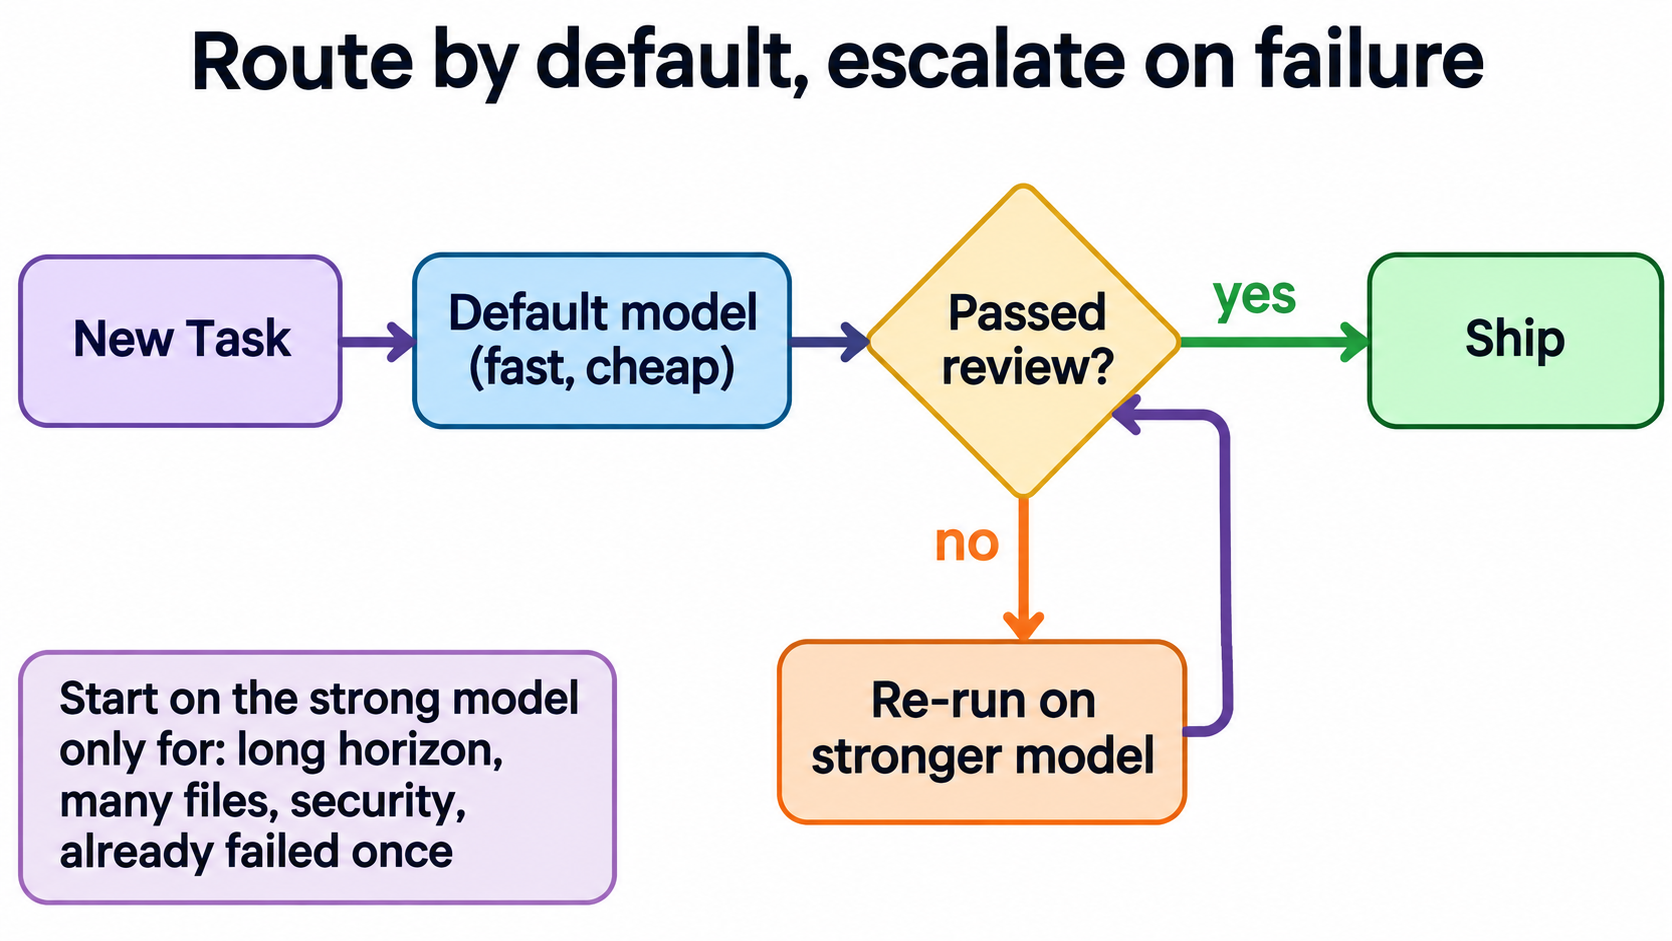
يعني توجيه النماذج لوكلاء البرمجة اختيار النموذج المناسب لكل مهمة بدلاً من فرضه على مستوى الفريق بالكامل. وتتلخص هذه القاعدة في سطر واحد: تبدأ كل مهمة بالنموذج الافتراضي، ولا تُنقل إلى النموذج الأقوى إلا إذا دلّت إشارة محددة على صعوبتها أو بعد فشل النموذج الافتراضي في إنجازها.
يرتكز نجاح هذه القاعدة على شقين أساسيين:
- نموذج افتراضي سريع وكفء بما يكفي لأغلب المهام: وهو نموذج Argon بالنسبة للفرق التي تستخدم عائلة Gemini، وفقاً لنصيحة Google نفسها.
- مسار تصعيد يعتمد على محفزات قابلة للتدقيق والقياس: فالقول بأن «المهمة تبدو صعبة» لا يُعد محفزاً صالحاً، بينما يُعد «تعديل شيفرة المصادقة والأمان» محفزاً موضوعياً.
كيف تحدد صعوبة المهمة؟
تحتاج إلى مؤشارات واضحة يمكن لأي شخص ملاحظتها في تفاصيل المهمة قبل البدء في تنفيذها. وتغطي هذه المؤشرات الأربعة معظم الحالات:
الأفق الزمني الطويل للمهمة
تتطلب بعض المهام سلسلة طويلة من الخطوات المتتابعة، كعمليات الترحيل البرمجي (Migration) التي تتضمن عشرة تعديلات مترابطة، مما يزيد من احتمالية انحراف النماذج الأضعف عن المسار المطلوب. هنا يأتي دور حلقات التحقق الإضافية في Carbon لمعالجة هذه المشكلة. المؤشر: أن يتضمن وصف المهمة أكثر من خمس خطوات، أو أن تكون جولات سابقة لمهام مشابهة قد تجاوزت الوقت المخصص لها.
تعدد الملفات وتداخلها
تتطلب التغييرات الهيكلية المتقاطعة احتفاظ النموذج بأجزاء واسعة من قاعدة الشيفرة البرمجية في الذاكرة في الوقت نفسه. المؤشر: أن يمتد التغيير ليشمل حِزماً برمجية متعددة أو أكثر من عشرة ملفات.
التأثير الأمني الحساس
لا تحتمل قضايا المصادقة (Auth)، والمدفوعات، وإدارة المفاتيح السرية، وفحوصات الصلاحيات أي إجابات خاطئة، حتى وإن قُدّمت بثقة. ويشير تقرير إطلاق Carbon من Google إلى تصدره لاختباري SEC-bench Pro وCWE-bench v1 عند الوصول إليه عبر برنامج Fairwind المخصص للمدافعين عن الأمن السيبراني. المؤشر: أن تمس المهمة مساراً أو ملفاً مصنفاً لديك على أنه حساس أمنياً.
فشل المهمة في المحاولة الأولى
يُعد هذا المؤشر الأقل تكلفة والأكثر وضوحاً ودقة. فإذا أخفق النموذج الافتراضي في اجتياز المراجعة، فأنت أمام دليل مباشر على أن المهمة تتجاوز إمكانياته. أعد تشغيلها على النموذج الأقوى مع إرفاق تعليقات وملاحظات المراجع.
جدول توجيه يمكنك البدء به
يمكنك استخدام هذا الجدول كمسودة أولية، ثم تعديله لاحقاً بناءً على معدلات النجاح الفعلية لديك بعد أسبوعين من التطبيق.
| نوع المهمة | ابدأ بـ | صعّد إلى | السبب |
|---|---|---|---|
| تصحيح الأخطاء المطبعية، تعديل النصوص، تحديث التبعيات البرمجية | الفئة السريعة (نماذج Flash أو mini) | Argon | فروقات برمجية صغيرة وسهلة المراجعة |
| إصلاح خطأ برمجي مع وجود اختبار فاشل يحدده | Argon | Carbon | يوفر الاختبار مؤشراً واضحاً للنجاح |
| إضافة ميزة برمجية ضمن وحدة (Module) واحدة | Argon | Carbon | الخيار الافتراضي الموصى به من Google لمعظم الأعمال البرمجية |
| إعادة هيكلة الشيفرة البرمجية (Refactor) عبر ملفات متعددة | Carbon | Fable 5.2 أو مهندس بشري | أفق عمل طويل وملفات متعددة |
| المصادقة، أنظمة الدفع، وإدارة الصلاحيات | Carbon | مراجعة بشرية حتمية دائماً | حساسية التأثير الأمني |
| أي مهمة تفشل في المراجعة مرة واحدة | المستوى الأعلى مباشرة | مهندس بشري | الأدلة الميدانية أصدق من التخمين |
تبلغ تكلفة نموذج Claude Fable 5.2 المعلنة 8 دولارات للإدخال و40 دولاراً للإخراج لكل مليون رمز مميز، وهي أربعة أضعاف السعر التمهيدي لنموذج Carbon؛ ولذا فهو يمثل الخطوة المؤتمتة الأخيرة في مسار التصعيد وليس الخيار الافتراضي. وتجدر الإشارة إلى أن سعر Carbon نفسه سيرتفع إلى 4 دولارات و20 دولاراً بعد 30 نوفمبر 2026 وفقاً لتوضيح Google، مما يقلص تلك الفجوة السعرية. احرص دائماً على مراجعة الأسعار الحالية عبر صفحة تسعير Gemini API قبل تحديد ميزانياتك.
التصعيد عند الفشل بدلاً من التوجيه المسبق
تميل الفرق البرمجية عادةً إلى التوجيه المسبق لأي مهمة «تبدو معقدة» نحو أقوى نموذج متاح. يمنحك هذا الإجراء شعوراً بالأمان، لكنه يكبّدك تكلفة باهظة؛ نظراً لأن الكثير من تلك المهام كان بالإمكان إنجازها بنجاح عبر النموذج الافتراضي.
أما استراتيجية التصعيد عند الفشل، فتضمن لك دفع تكلفة النموذج الأقل سعراً في كل مهمة، وحصر تكلفة النموذج الأكبر على المهام التي أثبتت التجربة حاجتها الفعلية إليه. فغالباً ما تكون تكلفة تشغيل فاشل لنموذج اقتصادي أقل بكثير من تكلفة تشغيل غير ضروري لنموذج مرتفع التكلفة.
توجد حالتان فقط تشذّان عن هذه القاعدة، وقد غطاهما الجدول أعلاه: الأولى هي الأعمال الأمنية الحساسة، والتي تبدأ بالنموذج الأقوى لأن الخطأ في المحاولة الأولى قد يُدمج في الشيفرة في حال غفلت عنه المراجعة؛ والحالة الثانية هي عمليات إعادة الهيكلة الشاملة الممتدة عبر ملفات كثيرة، حيث يستهلك الفشل فيها ساعات من الوقت بدلاً من دقائق معدودة.
كما يجب التنويه إلى أن المحاولة الفاشلة لا تفيدك كإشارة إلا إذا اكتشفتها المراجعة بدقة؛ فالنماذج قد تتحايل على الاختبارات أحياناً. لذلك، احرص على ربط مسار التصعيد بأساليب الفحص الموضحة في مقالنا حول كيفية كشف تحايل وكلاء البرمجة على الاختبارات.
قياس التكلفة ومعدل النجاح لكل مهمة
يتحول توجيه النماذج دون أرقام واضحة إلى مجرد آراء شخصية. احرص على تتبع معيارين لكل مهمة:
- التكلفة لكل مهمة: إجمالي الرموز المميزة (المدخلات والمخرجات) مضروبة في سعر النموذج المستخدم، وتُحسب مجموع كافة محاولات تشغيل المهمة بما فيها المحاولات الفاشلة.
- معدل النجاح عند المراجعة: هل اجتازت المحاولة الأولى المراجعة بنجاح، أم تطلبت إعادة تشغيل أو تدخلاً بشرياً للإصلاح؟
بعد ذلك، احسب النسبة بينهما؛ إذ تُعد «التكلفة لكل تعديل مقبول» المعيار الحاسم في قرارات التوجيه. فالنموذج الاقتصادي الذي يفشل في نصف الحالات قد تصبح تكلفته الإجمالية أعلى من نموذج متقدم ينجز العمل من المحاولة الأولى، وهو ما نوضحه بالتفصيل في مقال عندما تصبح النماذج الأرخص أكثر تكلفة.
تؤكد بيانات الجهات المستقلة هذا التوجه أيضاً؛ حيث يشير تقرير منصة Artificial Analysis إلى أن تشغيل مؤشر الذكاء الخاص بها كلّف 7.76 دولاراً على Gemini 4 Carbon (الوضع المرتفع) مقابل 26.54 دولاراً على Claude Fable 5.2 (الوضع الأقصى)، في حين سجّل Fable 65 نقطة مقابل 60 نقطة لـ Carbon. وفارق النقاط الخمس مقابل تكلفة تعادل 3.4 أضعاف لا يستحق الدفع إلا في المهام التي تُحدث فيها تلك النقاط الخمس فارقاً جوهرياً في النتيجة.
يكفيك سجل بسيط للبدء:
task       model          runs  tokens_in  tokens_out  cost_usd  passed_first
COIN-212   gemini-4-argon    1     48,000      9,500      0.19   yes
COIN-213   gemini-4-argon    2    121,000     22,000      0.46   no
COIN-213   gemini-4-carbon   1    210,000     41,000      0.83   yes
في هذا المثال، فشلت المهمة COIN-213 على Argon، فتم تصعيدها ونجحت على Carbon. بلغت التكلفة الإجمالية للمهمة 1.29 دولاراً، ويوضح لك هذا السجل ما إذا كان من الأفضل بدء المهام المشابهة مستقبلاً على Carbon مباشرة.
إدارة التوجيه لكل مهمة على لوحة التحكم
من السهل صياغة هذه القاعدة نظرياً، لكن يصعب تطبيقها عملياً إذا تُرِك لكل مطور حرية اختيار النموذج يدوياً من طرفيته البرمجية. والحل هو ضبط التوجيه في مكان إدارة المهام نفسه.
تحديد نموذج ثابت لكل وكيل
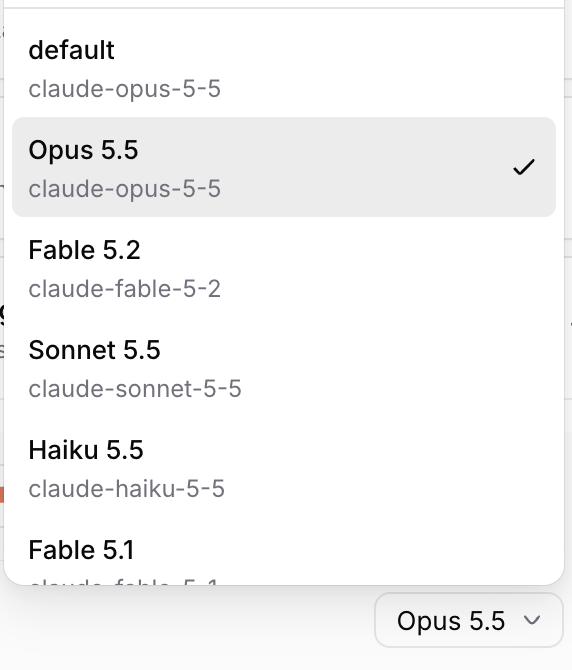
في Sharkly، يتبع الوكيل افتراضياً نموذج بيئة التشغيل (Runtime) الخاصة به، ويتيح لك خيار Model في إعدادات الوكيل اختيار نموذج آخر من دليل تلك البيئة، فضلاً عن تحديد عمق التفكير (Thinking Depth) في حال كان النموذج يدعم ذلك. وتفصّل وثائق الوكلاء ذلك بالكامل. يتيح لك هذا تخصيص وكيل لكل مستوى: وكيل افتراضي يعتمد النموذج السريع، ووكيل تصعيد يعتمد النموذج القوي.
تصعيد جولة تشغيل واحدة
عند إسناد المهمة، يمكنك اختيار النموذج لتلك الجولة بالتحديد، متجاوزاً الإعداد الافتراضي للوكيل لتلك المحاولة فقط. يمثل هذا التصعيد عند الفشل في خطوة واحدة: إذ يُعيد المراجع المهمة، لتبدأ المحاولة الجديدة مباشرة على Carbon دون الحاجة لتغيير إعدادات الوكيل الأساسي الذي يعتمد عليه باقي الفريق.
الاحتفاظ بالسجلات في مكان موحد
تحتفظ كل عملية تشغيل بسجل التنفيذ الخاص بها، مما يتيح لك استخراج بيانات التكلفة ومعدلات النجاح من المهام المنجزة فعلياً لا من الذاكرة والتقديرات. أما بالنسبة للفرق (Crews) التي تقسم العمل بناءً على الأدوار الوظيفية لا على درجة الصعوبة، فيمكن مراجعة دليل توجيه النماذج لفرق الوكلاء. وللتعرف على جانب الرقابة والإشراف، يشرح مقال من يراقب وكلاءك؟ آليات التحكم التي تظل بيد فريقك. يتيح Sharkly البدء مجاناً.
بدائل التوجيه الفردي للمهام
- نموذج واحد لكافة المهام: مناسب للمطور المستقل، لكنه يتحول إلى إهدار للموارد مع تنوع المهام.
- نموذج توجيه تلقائي: نموذج صغير يصنف كل مطالبة ويختار الوجهة المناسبة. يعيب هذا النهج أنه يحجب آلية اتخاذ القرار ولا يستطيع رصد حالات فشل المراجعة.
- أنماط فرق الوكلاء المتكاملة: تتيح ميزة المعاينة /swarm من Google في Antigravity إسناد مهام التخطيط والتدقيق إلى Carbon بينما تعمل النماذج الأخف وزناً بالتوازي. يمثل هذا توجيهاً مبنياً على الدور ضمن الوظيفة الواحدة، ويكمل استراتيجية التوجيه لكل مهمة.
خاتمة
قدمت Google قاعدة التوجيه بوضوح في منشور الإطلاق الخاص بها: اعتمد Argon كخيار افتراضي، ولا تلجأ إلى Carbon إلا عندما تستحق المهمة ذلك. حدد مؤشراتك الأربعة للمهام المعقدة، وابدأ كل ما سواها بالنموذج الاقتصادي، وصعّد عند فشل المراجعة، ودوّن التكلفة ومعدل النجاح لكل مهمة. وبعد أسبوعين فقط، ستكون أرقامك وبياناتك الميدانية كفيلة بصياغة جدولك الخاص بدقة تفوق أي اختبارات أداء قياسية.
خطوتك التالية: قم بإعداد وكيلين في Sharkly، أحدهما يعتمد نموذجك الافتراضي والآخر مخصص للتصعيد، ووجّه مهام هذا الأسبوع من خلالهما.
الأسئلة الشائعة
هل ينبغي استخدام Gemini 4 Carbon أم Argon لوكلاء البرمجة؟
استخدم Argon لمعظم المهام واحتفظ بـ Carbon للمهام الشاقة والمعقدة؛ حيث يوضح منشور الإطلاق العام من Google أن Argon «يظل الخيار المثالي لغالبية أعمال هندسة البرمجيات»، بينما صُمم Carbon للمهام التي تتحدى قدرات النماذج وذكائها.
هل يُعد Gemini 4 Carbon أكثر تكلفة من Argon؟
بالنظر إلى سعر الرمز الواحد، لا؛ فكلاهما يكلف دولارين للإدخال و10 دولارات للإخراج لكل مليون رمز مميز حتى 30 نوفمبر 2026. أما بالنظر إلى تكلفة المهمة الواحدة، فغالباً نعم؛ نظراً لأن Carbon يستهلك عدداً أكبر من الرموز المميزة في عمليات الاستكشاف والتحقق وفقاً لما صرحت به Google.
ماذا سيحدث لأسعار Gemini 4 Carbon بعد 30 نوفمبر؟
تشير الحاشية في إعلان Google إلى أن السعر التمهيدي سينتهي في 30 نوفمبر 2026، لترتفع أسعار Carbon إلى 4 دولارات لكل مليون رمز إدخال و20 دولاراً لكل مليون رمز إخراج.
ما المقصود بتوجيه النماذج لوكلاء الذكاء الاصطناعي؟
يقصد بتوجيه النماذج اختيار النموذج الأنسب لكل مهمة بناءً على مدى صعوبتها، بهدف الوصول إلى أدنى تكلفة ممكنة لكل تعديل برمجي مقبول.
كيف أعرف الوقت المناسب لتصعيد المهمة إلى نموذج أقوى؟
يُنصح بالتصعيد عندما تتطلب المهمة أفقاً زمنياً طويلاً وخطوات متعددة، أو تشمل عدداً كبيراً من الملفات، أو تتناول شيفرة حساسة أمنياً، أو إذا كانت قد فشلت بالفعل في اجتياز المراجعة عبر النموذج الافتراضي.
هل يمكن تعيين نموذج مختلف لكل وكيل في Sharkly؟
نعم، يتيح حقل Model في إعدادات كل وكيل الاختيار من دليل بيئة التشغيل، كما يمكنك تجاوز النموذج المحدد لجولة تشغيل واحدة عند إسناد أي مهمة.


