قيمة الفاتورة هي أسهل رقم يمكن تعديله، لكنها الأقل أهمية عند القراءة. وجّه مهام فريقك (Crew) الروتينية إلى GPT-6 Luna بتكلفة 0.10 دولار و0.50 دولار لكل مليون رمز، وستشهد بند تكلفة النماذج ينهار في غضون يوم واحد. وبعد أسبوعين، تظل الفاتورة منخفضة، وتزداد عمليات التشغيل المكتملة على لوحة المهام أكثر من أي وقت مضى، بينما لا تزال التعديلات الأربعة الصادرة يوم الثلاثاء الماضي في انتظار من يعتمدها.
لم يحدث أي خطأ. كل ما في الأمر أنك نقلت التكلفة من بند تراقبه إلى بند لا يضع له أحد سعرًا.
تكلفة التغيير المقبول هي إجمالي الأموال ووقت الموظفين المستغرق في كل محاولة قادت إلى تغيير واحد قبله شخص ما. وهي تحسب عمليات التشغيل الفاشلة، والمخرجات التي لم يدمجها أحد، والدقائق التي قضاها أحدهم في اتخاذ القرار بشأنهما معًا. لا توجد شركة مزودة تنشر هذا الرقم، ولا يوجد اختبار قياسي يقيسه، ومع ذلك فهو الرقم الوحيد الذي يتغير وفقًا لما يطلقه فريقك فعليًا.
خلاصة القول
يقلل النموذج الأرخص من تكلفة المحاولة الواحدة، لكنه يرفع ثلاثة أمور تُدفع من انتباه المراجع ووقته: عدد المحاولات لكل تغيير يُطلق، وحجم المخرجات لكل محاولة، وعدد القرارات المطلوبة لكل تغيير يُطلق. ولم يصبح انتباه المراجعين أرخص في 2026-09-22. إن الفئة الاقتصادية تكون أرخص حقًا عندما تكون الآلة هي من يقرر نجاح المحاولة من عدمه، وتصبح باهظة التكلفة بهدوء عندما يتعين على شخص اتخاذ هذا القرار. تبحث الوكلاء البرمجية (Agents) وتنفذ وتختبر وترفع التقارير، بينما يحدد البشر التوجه ويمنحون الصلاحيات ويعتمدون النتائج. والحل يكمن في تعديل محاسبي قبل أن يكون تعديلًا في التوجيه: احسب عدد المحاولات ودقائق العمل البشري لكل تغيير مقبول وفقًا لكل بيئة تشغيل (Runtime)، واجعل العمل في انتظار المراجعة البشرية حالة قابلة للقياس والإحصاء، لا مجرد شعور يداهمك مساء يوم الجمعة.
ثلاث وحدات قياس، وواحدة فقط هي ما يهمك
| الوحدة | من يستخدمها | ما تخبرك به | ما تتجاهله |
|---|---|---|---|
| لكل مليون رمز | صفحات تسعير المزودين | تكلفة المدخلات والمخرجات | كمية الرموز التي تتطلبها مهمتك |
| لكل مهمة مكتملة | جداول الاختبارات القياسية | تكلفة محاولة واحدة خضعت للتقييم | المحاولات الفاشلة، وقاعدتك البرمجية، والمراجعة البشرية |
| لكل تغيير مقبول | فريق عملك | تكلفة التغيير الواحد الذي تم إطلاقه من البداية إلى النهاية | لا تتجاهل شيئًا، ولهذا لا ينشرها أحد |
أطلق كلا المختبرين نماذجهما في 2026-09-22، ونشر كلاهما أرقامه بناءً على العمود الأوسط. فلا تقرأ تلك الجداول وكأنها تمثل العمود الأخير.
تكلفة الفئة الاقتصادية ونتائج تقييمها
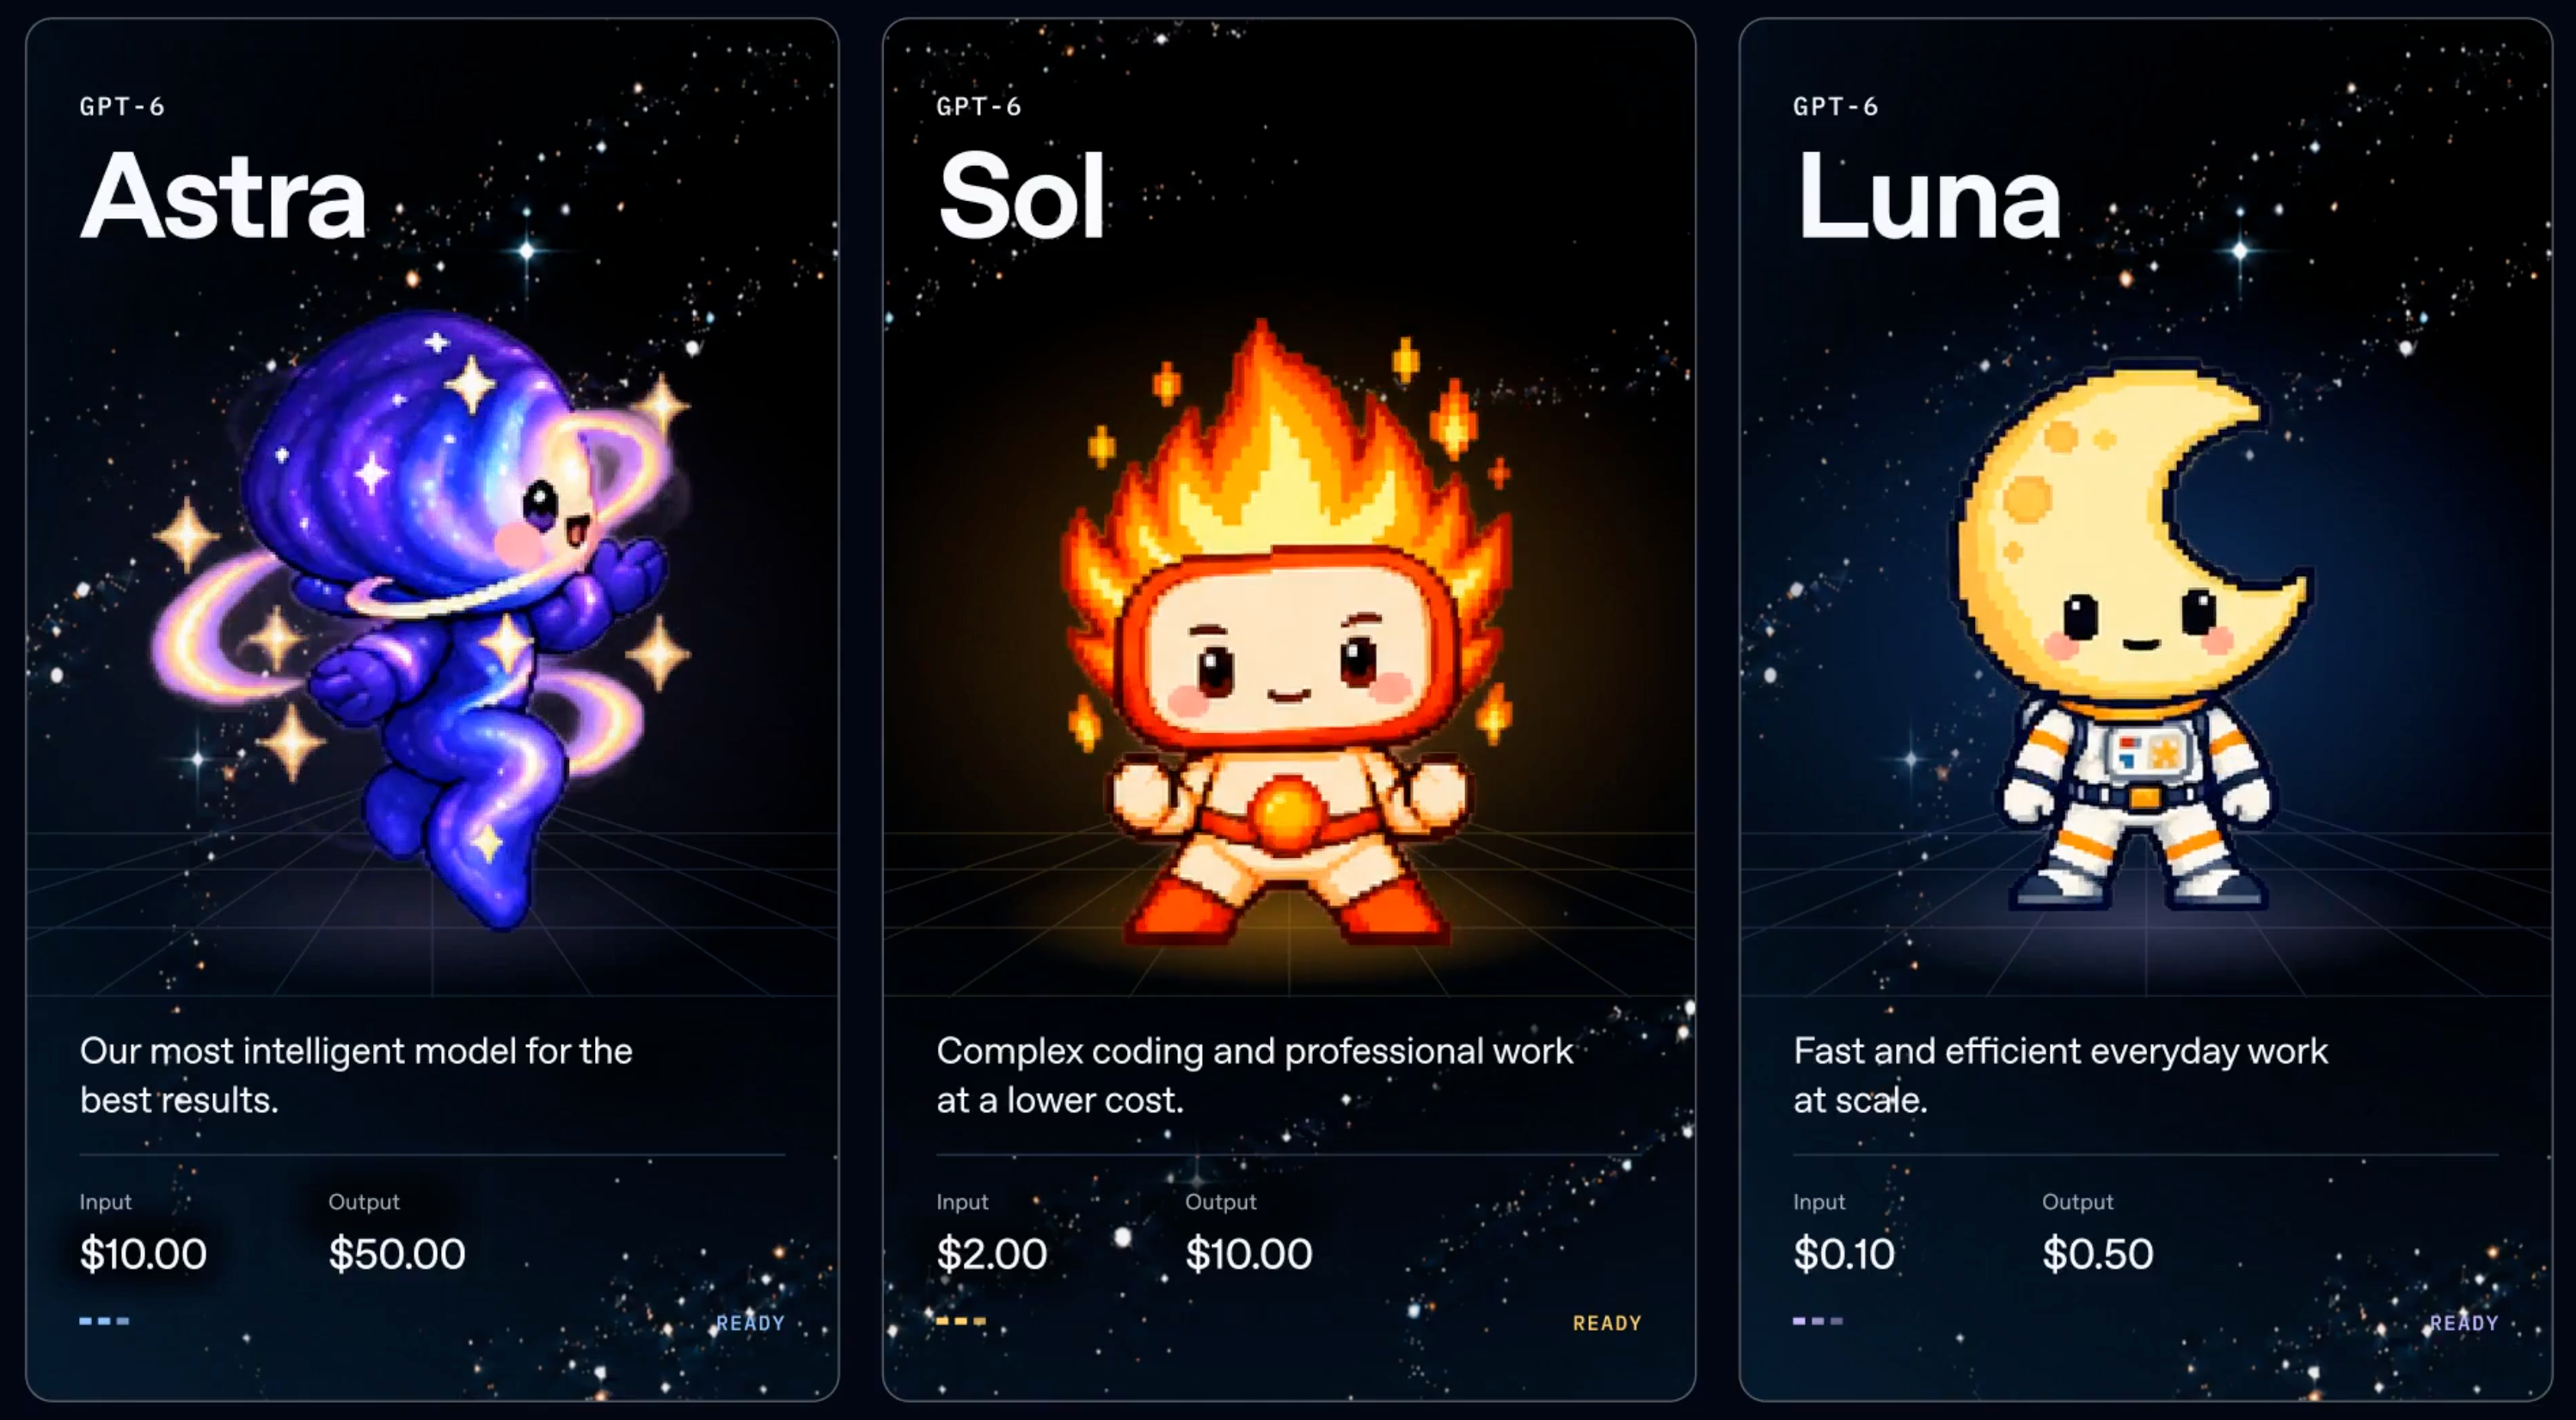
| GPT-6 Luna | GPT-6 Sol | Claude Opus 5.5 | |
|---|---|---|---|
| معرف واجهة برمجة التطبيقات (API) | gpt-6-luna |
gpt-6-sol |
claude-opus-5-5 |
| المدخلات / المخرجات لكل مليون رمز | $0.10 / $0.50 | $2 / $10 | $4 / $20 |
| المدخلات المخزنة مؤقتًا (Cached) | خصم 90% على القراءات | خصم 90% على القراءات | $0.20 للقراءة، و$5 للكتابة |
| سياق المعالجة | 1M | 872k | 1M |
| DeepSWE 1.1 بأقصى مستوى استدلال | 66.6% | 68.8% | غير متوفر في مواد الإطلاق |
| مؤشر Artificial Analysis | 37 | 48 | 58، الأول من بين 212 |
تفيد شركة Anthropic بتحقيق Opus 5.5 نسبة 40.0% في اختبار AutomationBench. بينما تعلن OpenAI عن نسبة 33.2% لنموذج Sol بمستوى استدلال فائق على AutomationBench 1.0.6، بتكلفة 0.27 دولار لكل مهمة. مختبران، وبيئتا اختبار مختلفتان، ورقم معلن واحد للتكلفة لكل مهمة. هذه المقارنة ليست مواجهة مباشرة متكافئة، وعدم القدرة على جعلها كذلك هو بيت القصيد: لا يوجد جدول أسعار يقدمه أي مزود يمكنه أن يوضح لك تكلفة التغيير المقبول.
العامل الخفي الأول: عدد المحاولات لكل تغيير مقبول
تضع OpenAI نموذج Luna عند أقصى استدلال عند 66.6% في اختبار DeepSWE 1.1، ونموذج Sol عند أقصى استدلال عند 68.8%. ووفقًا لحساباتنا، يعني هذا أن محاولة واحدة تقريبًا من بين كل ثلاث محاولات لنموذج Luna لا تحقق نتيجة مقبولة. صحيح أن مستودعك البرمجي ليس DeepSWE وأن معدلاتك ستختلف، لكن النتيجة العامة تظل واحدة: فالفئة الاقتصادية التي تقل بعدة نقاط مئوية ليست أسوأ ببضع نقاط في كل تشغيل فحسب، بل هي أكثر عرضة ببضع نقاط لتسليمك عملاً يتطلب جولة أخرى من التعديل.
يظل الجانب المالي لتلك الجولة الإضافية ضئيلًا للغاية. تفيد تقارير OpenAI بأن Luna بأقصى استدلال أرخص بنسبة 93% لكل مهمة مقارنة بـ Claude Opus 5 في نفس الاختبار القياسي. وحتى لو ضاعفت عدد المحاولات، ستظل التكلفة—بحسب حساباتنا مجددًا—أرخص بنحو 86%. وبالتالي، لن يكون بند تكلفة النماذج هو المشكلة إطلاقًا.
لكن المحاولة الفاشلة ليست مجانية في أي مكان آخر؛ فقد أنشأت فرعًا برمجياً، وملخصًا للتغيير، وقرارًا يتعين على إنسان اتخاذه. فالتشغيل الفاشل ليس صفرًا، بل هو عنصر مراجعة ينتهي دون إحراز أي تغيير.
العامل الخفي الثاني: الفئة الاقتصادية تجيد عملها بالتفكير لفترة أطول
انظر من أين تأتي أرقام Luna الجيدة؛ فنسبة 66.6% تحققت عند أقصى مستوى استدلال، وملاحظة الدقة من OpenAI تشير إلى أن Luna عند بذل جهد أكبر يعادل أداء GPT-5.6 Sol بنحو 1% فقط من التكلفة. أي أن الفئة الاقتصادية تصل إلى الجودة المقبولة ببذل مجهود أكبر، وهذا المجهود يظهر في صورة رموز مخرجة إضافية ووقت انتظار أطول.
تقيس منصة Artificial Analysis—وهي جهة مستقلة وليست أحد المزودين—إصدارات الاستدلال الأقصى بمعدل 153.9 رمز مخرج في الثانية لنموذج Luna مع وقت استجابة يبلغ 124.23 ثانية للرمز الأول، و115.2 رمزًا في الثانية لنموذج Sol مع 102.15 ثانية للرمز الأول. اعتبر هذه الأرقام مؤشرات تقريبية: فهي صادرة عن طرف ثالث، وتغطي إصدارات الاستدلال الأقصى تحديدًا، وتتغير مع إعادة تقييم المختبرات.
هناك نتيجتان تؤثران على فريقك مباشرة وليس على فاتورتك: الأولى أن التشغيل الذي يتوقف لمدة دقيقتين يبدو تمامًا وكأنه تشغيل معلق، مما يدفع شخصًا ما للتدخل والتحقق منه. والثانية أن سجل التتبع الأطول مع فارق تغييرات (diff) أكبر يعني مزيدًا من النصوص للقراءة في كل محاولة قبل أن يتمكن أي شخص من قبولها. والقراءة هي المورد الشحيح لديك، وأنت للتو اشتريت المزيد مما يستنزفها.
العامل الخفي الثالث: القرارات لا الفروق البرمجية
احسب عدد القرارات البشرية المطلوبة بين إسناد المهمة (Task) وقبول التغيير. في بيئة تشغيل قوية، يكون المسار المعتاد خطوة واحدة: اقرأ التغيير، ثم اقبله. أما في بيئة تشغيل رخيصة تؤدي عملاً يصعب التحقق منه آليًا، فإن المسار يتفرع، وكل تفرع يتطلب تدخلاً بشريًا:
- فشل التشغيل: هل تعيد المحاولة في بيئة التشغيل نفسها، أم تُصعّد الأمر إلى بيئة أقوى؟
- اجتاز التشغيل الاختبارات لكنه اتبع نهجًا لم تكن لتختاره: هل تقبله، أم ترده للتعديل؟
- أنتج التشغيل ثلاث نتائج جزئية: أي منها يمثل التغيير المطلوب؟
- توقف التشغيل ليطرح سؤالاً: من يجيب، وأين يُحفظ الرد؟
لا يظهر أي من ذلك في فاتورة الرموز، بل يظهر كله في جدول مواعيد المسؤول عن المراجعة البشرية.
المعادلة بأرقامك الخاصة
cost per accepted change
  = attempts per accepted change
      x (model cost per attempt + reviewer minutes per attempt x loaded cost per minute)
  + escalation cost when the cheap tier hands the job back
طبّق هذه المعادلة بأرقامك أنت، لا أرقامنا. فعند تكلفة 0.10 دولار و0.50 دولار لكل مليون رمز، تؤول تكلفة النموذج داخل القوسين إلى ما يقارب الصفر، وبالتالي تصبح المعادلة محكومة بدقائق المراجع مضروبة في عدد المحاولات. إن الانتقال إلى بيئة تشغيل أرخص يقلص بندًا كان ضئيلًا بالفعل، ويضاعف البند الذي لم يكن كذلك. قد يظل هذا خيارًا جيدًا في بعض الأحيان، لكنه خيار لا يمكنك تقييمه أبدًا من صفحة الأسعار وحدها.
متى تكون الفئة الاقتصادية أرخص حقًا؟
استخدم بيئة تشغيل رخيصة عندما تكون الآلة هي من يقرر نجاح المحاولة؛ مثل فحص الأنواع (Typecheck)، واختبارات الوحدة (unit tests)، والبناء (build)، وقواعد التنسيق (lint rules)، والتحقق من المخطط (schema check): إذ يصدر القرار قبل أن يستهلك أي إنسان انتباهه، وتستوعب بيئة الاختبار المحاولات الإضافية بدلاً من أن تستنزف عطلتك الأسبوعية. يمثل هذا الجزء الأكبر من حجم العمل في أي فريق عمل برمجيات (Crew)، وهو المبرر الحقيقي لتوجيه المهام الروتينية المملة إلى Luna.
ولا تستخدم بيئة تشغيل رخيصة عندما يعتمد القبول على التقدير البشري؛ مثل القرارات المعمارية، وعمليات ترحيل البيانات، وأي مسألة متعلقة بالأمان، وأي مهمة لا يمكن لأمر برمجي الإجابة فيها عن سؤال "هل هذا صحيح؟". ففي هذه الحالات، تتحول فجوة النقاط مباشرة إلى دقائق مراجعة إضافية، ويصبح أرخص ما يمكنك شراؤه هو محاولة لا تحتاج إلى قراءتها سوى مرة واحدة فقط.
دوّن قاعدة التصعيد بوضوح بدلاً من تركها للتفضيل الشخصي، لأن التفضيل ينهزم أمام السعر الأرخص في كل مرة. فـ توجيه النماذج يعتمد أولاً على إمكانية التحقق الآلي، وثانيًا على التكلفة.
لماذا لن يخبرك أي مزود بهذه الحقيقة؟
أجرى كلا المختبرين مقارنات قياسية ضد بعضهما في اليوم نفسه، وكان خط الأساس الذي قارنت به OpenAI هو Claude Opus 5، والذي استبدلته Anthropic بنموذج Opus 5.5 بعد ساعات معدودة. تمثل الفئة الاقتصادية لدى كل مزود قمة قمع المبيعات الخاص به؛ ولن ينشر أي منهم عبارة "نموذجنا الاقتصادي سيكلف مراجعيك جولة مراجعة إضافية"، وليسوا مخطئين في إغفال ذلك، فالرقم يعتمد على قاعدتك البرمجية وفريق عملك.
لا تبيع Sharkly رموز النماذج، بل يستمر استخدام النماذج عبر الاشتراكات أو مفاتيح API المضبوطة في الأدوات التي يستخدمها فريقك بالفعل، لذا لا مصلحة لنا في نوع بيئة التشغيل التي تختارها. وهذا هو الموقف الوحيد الذي يسمح بطرح هذا الطرح بنزاهة، وهو السبب نفسه الذي يجعل سير عملك قادرًا على مواكبة النموذج الاقتصادي القادم دون الحاجة إلى إعادة بنائه من الصفر.
ما يجب وضعه في لوحة التحكم بدلاً من ذلك
دقائق العمل البشري لكل تغيير مقبول، لكل بيئة تشغيل. إذا ارتفع هذا الرقم بعد التبديل، فإن النموذج الأرخص هو في الواقع أكثر تكلفة، وبات لديك الدليل القاطع. أما مقياس التكلفة بالدولار لكل تشغيل فهو يجيب عن سؤال فقد أهميته منذ 2026-09-22.
عدد المحاولات لكل تغيير مقبول، لكل بيئة تشغيل. هذا المعيار هو ما يحدد كل شيء آخر ولا يمكن لأي مزود أن يقدمه لك؛ وتحصل عليه بتسجيل بيئة التشغيل التي أنتجت كل محاولة، ضمن المهمة التابعة لها.
اعتبار "في انتظار المراجعة البشرية" حالة فعلية. يعود التنفيذ والعوائق والنتائج والنقاشات اللاحقة إلى الجدول الزمني للمهمة، مما يجعل قائمة الانتظار التي تتطلب تدخلاً بشريًا قابلة للإحصاء والقياس بدلاً من أن تكون مجرد انطباعات. واشترط أن يأتي كل تشغيل مصحوبًا بأدلته:
Before a run reaches a person, the Task carries:
- the change summary
- typecheck, test, and build results
- known limits and what was not attempted
- the attempt number and which Runtime produced it
لست بحاجة إلى أي من هذا في الفرق الصغيرة؛ فإذا كان شخص واحد يشغّل وكيلين برمجيين ويراجع كل شيء في فترة ما بعد الظهر نفسها، فاستمر على ذلك، فالحالات وقوائم الانتظار عبء إضافي لحل مشكلة لا تواجهها بعد. لكن هذا الحساب يصبح ضروريًا عندما يعجز الجميع عن تذكر عدد عمليات التشغيل المكتملة التي تنتظر المراجعة.
الجزء الذي لم تنخفض تكلفته
خفّض مختبران تكلفة المحاولة في يوم واحد، لكن أيًا منهما لم يطلق أداة تقرأ الفروق البرمجية نيابة عنك، ولا تزال مسؤولية التغيير تنتهي عند الإنسان. فالنموذج الأرخص لا يعني سير عمل أرخص؛ بل يعني مجرد محاولة أرخص، والمحاولات تغذي عملية تظل خطوتها الأكثر كلفة هي المراجعة البشرية.
إذا كنت تشغّل بالفعل عدة وكلاء برمجيين، فإن منصة Sharkly تمنحك مكانًا واحدًا لترى بيئة التشغيل التي أنتجت كل محاولة، وما أرفقته من أدلة، وحجم العمل الذي ينتظر المراجعة البشرية في هذه اللحظة.