
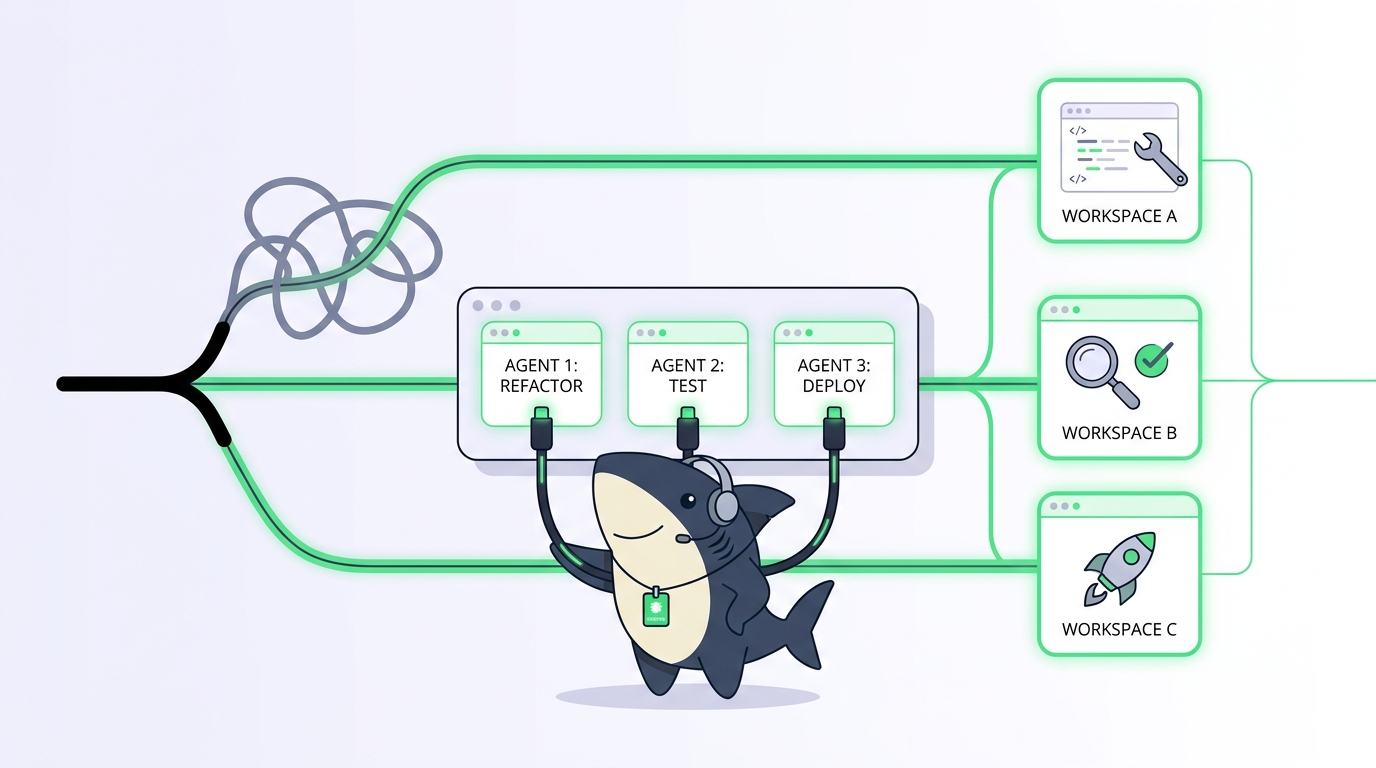
Richtet man zwei KI-Coding-Agenten auf denselben Checkout, ruinieren sie einem früher oder später den Nachmittag. Der eine schreibt eine Datei neu, an der der andere gerade arbeitet. Der eine zieht dem anderen den Branch unter den Füßen weg. Beide führen npm install gegen dasselbe node_modules aus und hinterlassen ein Lockfile, das niemand geschrieben hat. Der Fehler bleibt still, bis er es nicht mehr ist – und dann arbeitet man sich per Bisect durch ein Chaos, das keiner der Agenten erklären kann.
Git-Worktrees sind die Standardlösung. Ein Worktree gibt jedem Agenten sein eigenes Arbeitsverzeichnis und seinen eigenen ausgecheckten Branch auf Basis eines gemeinsamen Repositorys – so kollidiert parallele Arbeit nicht mehr. Dieser Leitfaden geht die tatsächlichen Befehle durch, die Stolperfallen, die in der Praxis wirklich zuschlagen, und die Aufräumdisziplin, über die kaum jemand spricht. Danach zeigt er, wo selbstgeschriebene Worktree-Skripte an ihre Grenzen stoßen und wie Sharkly jeden Task automatisch in seinem eigenen Worktree ausführt, sodass Ergebnisse an einer gemeinsamen Stelle landen, statt sich über unzählige Terminals zu verteilen.
Wer nur einen Agenten laufen lässt, braucht das alles noch nicht. Sobald es zwei sind, ist Isolation keine Option mehr.
TL;DR
Ein Git-Worktree ist ein zweites Arbeitsverzeichnis, das an dasselbe Repository angehängt ist und über einen eigenen Branch und Index verfügt. Gibt man jedem KI-Coding-Agenten seinen eigenen Worktree, können sie parallel editieren, bauen und testen, ohne sich gegenseitig zu überschreiben oder um den aktuellen Branch zu streiten. Die Befehle sind simpel; der operative Aufwand (Installationen pro Worktree, Aufräumen, Speicherplatz, Koordination) ist das, was wächst. Sharkly übernimmt diesen Aufwand, indem für jeden Task automatisch ein isolierter Worktree vorbereitet und jedes Ergebnis zur Prüfung an den Task zurückgegeben wird.
Warum ein Checkout nicht zwei Agenten beherbergen kann
Ein normales Git-Checkout hat genau ein Arbeitsverzeichnis, einen Index und ein HEAD. Für eine Person, die eine Sache macht, ist das völlig in Ordnung. In dem Moment, in dem zwei Agenten gleichzeitig arbeiten, bricht es zusammen, denn alle drei sind geteilter Zustand.
Stellen Sie sich zwei Agenten im selben Repo vor. Agent A refaktoriert das Auth-Modul in einem Branch namens auth-refactor. Agent B soll einen Logging-Bug beheben und führt git checkout -b fix-logging aus. Dieser eine Befehl verschiebt HEAD für den gesamten Checkout. Die nicht committeten Änderungen von Agent A liegen nun auf dem falschen Branch, sein nächster Commit landet an der falschen Stelle, und sein Build schlägt aus Gründen fehl, mit denen er zwanzig Minuten lang „debugging“ verbringen wird. Nichts ist abgestürzt. Der Zustand ist einfach still und leise schiefgelaufen.
Mit Dateien wird es noch schlimmer. Beide Agenten teilen sich ein Arbeitsverzeichnis. Wenn Agent B also eine Konfigurationsdatei neu generiert oder einen Formatter erneut laufen lässt, werden die offenen Änderungen von Agent A auf der Festplatte überschrieben. Coding-Agenten haben kein mentales Modell davon, dass „der andere gerade mitten in etwas steckt“. Sie lesen die Datei, handeln und schreiben sie zurück. Zwei Schreiber, eine Datei, kein Lock. Das ist das klassische Lost-Update-Problem – nur dass die Schreiber autonom und schnell sind.
Genau dieser Schmerz ist der Grund, warum das Keyword „git worktrees“ immer wieder auftaucht. Niemand sucht nach Worktrees, weil Branching spannend ist. Man sucht danach, weil man versucht hat, Agenten parallel laufen zu lassen, und sich die Finger verbrannt hat. Wenn das auf Sie zutrifft: Die Seite der parallelen Ausführung wird in unserem Leitfaden zum parallelen Ausführen mehrerer Claude-Code-Agenten ausführlich behandelt; dieser Artikel hier ist das Isolationsprimitiv darunter.
Was ein Git-Worktree tatsächlich ist
Hier die Definition, die es sich lohnt, sich einzuprägen:
Ein Git-Worktree ist ein zusätzliches Arbeitsverzeichnis, das mit demselben Repository verknüpft ist, mit eigenem ausgecheckten Branch, eigenem Index und eigenem HEAD, und das sich eine Objektdatenbank teilt.
Der letzte Teilsatz ist der ganze Trick. Ein Worktree ist kein Clone. Clones duplizieren den gesamten Objektspeicher: jeder Commit, jeder Blob, jeder Tag wird in ein zweites .git kopiert. Worktrees teilen sich einen Objektspeicher und fügen lediglich ein leichtgewichtiges zweites Arbeitsverzeichnis hinzu. Ihre Commits sind von jedem Worktree aus sichtbar, sobald sie landen, denn darunter gibt es nur eine Historie. Was sich pro Worktree unterscheidet, ist der Checkout: welcher Branch ausgecheckt ist, was im Index steht, was auf der Festplatte ungespeichert ist.
Für Agenten passt das exakt auf das Problem. Jeder Agent bekommt einen Worktree. Jeder Worktree hat seinen eigenen Branch und seine eigenen Dateien. Sie können sich nicht gegenseitig überschreiben, weil sie buchstäblich in verschiedenen Verzeichnissen liegen, und sie können sich nicht gegenseitig den Branch unter den Füßen wegziehen, weil jeder Worktree sein eigenes HEAD festhält. Konflikte verlagern sich dorthin, wo sie hingehören: zum Merge-Zeitpunkt, bewusst und unter Review – statt mitten im Editieren, aus Versehen.
Die Worktree-Befehle, die Sie tatsächlich brauchen
Beginnen Sie in einem normalen Repository. Alle folgenden Befehle werden von dort aus ausgeführt.
Einen Worktree mit neuem Branch anlegen. Diesen werden Sie am häufigsten nutzen:
git worktree add -b fix-logging ../myproject-fix-logging main
Das legt ein Verzeichnis unter ../myproject-fix-logging an, erstellt einen neuen Branch fix-logging ausgehend von main und checkt ihn dort aus. Richten Sie einen Agenten auf dieses Verzeichnis, hat er einen sauberen, isolierten Arbeitsplatz.
Einen Worktree für einen bestehenden Branch anlegen:
git worktree add ../myproject-auth auth-refactor
Auflisten, was gerade offen ist:
git worktree list
/Users/you/myproject              9f3c1a2 [main]
/Users/you/myproject-fix-logging  9f3c1a2 [fix-logging]
/Users/you/myproject-auth         3b7e0d4 [auth-refactor]
Eine Zeile pro Worktree, mit Pfad, ausgechecktem Commit und Branch. Wenn eine ganze Flotte von Agenten läuft, ist diese Liste die einzige Wahrheit darüber, wer wo arbeitet.
Einen Worktree entfernen, wenn die Arbeit gemergt oder verworfen wurde:
git worktree remove ../myproject-fix-logging
Veraltete Metadaten bereinigen, nachdem Sie ein Worktree-Verzeichnis manuell gelöscht haben (Agenten und Skripte machen das häufiger, als Ihnen lieb ist):
git worktree prune
Das ist die komplette Oberfläche. Fünf Befehle. Die Schwierigkeit steckt nicht in den Befehlen.
Die Stolperfallen, die wirklich zuschlagen
Die Befehle sind simpel. Die operative Realität ist das, was Nachmittage frisst. Das sind die Fehlerbilder, die auftauchen, sobald echte Agenten in echten Worktrees laufen.
Untracked und von Git ignorierte Dateien kommen nicht mit. Ein Worktree checkt die getrackten Dateien des angegebenen Branches aus. Er kopiert weder node_modules noch .env, venv, Build-Cache oder irgendetwas anderes, das Git ignoriert. Ein frischer Worktree für ein Node-Projekt ist also erst lauffähig, wenn man die Installation darin ausführt. Jeder Worktree zahlt für seine eigene Dependency-Installation, seine eigene Env-Datei, seinen eigenen Build. Agenten, die davon ausgehen, dass „das Repo eingerichtet ist“, scheitern bei ihrem ersten Befehl in einem neuen Worktree, solange das Setup nicht explizit geregelt ist.
Denselben Branch kann man nicht zweimal auschecken. Git weigert sich, einen Branch gleichzeitig in zwei Worktrees ausgecheckt zu haben – und das zu Recht. Wenn zwei Agenten beide main ausgecheckt brauchen, muss einer von ihnen einen Branch anlegen. Das ist ein Feature, keine Einschränkung, überrascht aber alle, die erwartet haben, Worktrees seien frei schwebende Kopien.
Der Speicherplatz wächst schnell. Der Objektspeicher ist geteilt, die Historie kostet also wenig. Arbeitsverzeichnisse und ihre Installationen dagegen nicht. Zehn Worktrees eines Projekts mit 900 MB node_modules bedeuten 9 GB duplizierte Dependencies. Auf einem Laptop mit einer Handvoll laufender Agenten merkt man das schon vor dem Mittagessen.
Schmutzige Worktrees wehren sich gegen das Entfernen. git worktree remove verweigert den Dienst, wenn der Worktree nicht committete Änderungen enthält – das schützt vor dem Wegwerfen unfertiger Agenten-Arbeit. Wenn er wirklich weg soll: git worktree remove --force. Aber dann liegt die Entscheidung, ob diese nicht committete Arbeit wichtig war, bei jedem einzelnen Worktree bei Ihnen – manuell.
Gelöschte Verzeichnisse hinterlassen Geister. Löscht man einen Worktree-Ordner mit rm -rf, listet Git ihn weiterhin auf, bis man git worktree prune ausführt. Skripte, die Worktrees schneller anlegen, als sie aufräumen, sammeln veraltete Einträge an, und diese Einträge halten Locks, die die Wiederverwendung von Branchnamen blockieren. Aufräumen ist nicht optional; es ist nur leicht zu vergessen – bis git worktree list einem Friedhof gleicht.
Verschachtelte Agenten-Caches dürfen Sie nicht löschen. Manche Runtimes führen eigene Worktree-Caches, etwa unter ~/.claude/worktrees. Richten Sie Ihre eigenen Cleanup-Skripte nicht darauf. Lassen Sie das Tool, dem ein Cache gehört, ihn auch verwalten.
Keine dieser Punkte ist für sich genommen schwierig. Das Problem ist, dass sie sich gegenseitig verstärken. Bei zwei Worktrees macht man es von Hand. Bei fünf schreibt man ein Skript. Bei zwölf laufenden Agenten über zwei Repositories ist das Skript plötzlich ein kleines Stück Infrastruktur mit eigenen Bugs – und Sie sind der Rufbereitschaftsdienst dafür.
Wo die Skripte nicht mehr skalieren
Der ehrliche Verlauf sieht so aus: Man beginnt mit einer Shell-Funktion, die git worktree add kapselt, einen Agenten in das neue Verzeichnis setzt und das Setup ausführt. Es funktioniert. Man ergänzt ein Namensschema, damit Verzeichnisse nicht kollidieren. Man ergänzt einen Cleanup-Befehl. Und dann stapeln sich die Anforderungen.
Man will wissen, welcher Agent gerade in welchem Worktree steckt und in welchem Zustand sein Branch ist. Das git worktree list kennt keine Agenten; es kennt nur Verzeichnisse. Man schraubt eine Mapping-Datei dran. Man will verhindern, dass Dependency-Installationen pro Worktree die Festplatte überrennen, also fügt man Caching-Logik hinzu. Man will, dass die Ausgabe eines Agenten, sein Diff und seine Testergebnisse an einer Stelle landen, an der ein Mensch sie prüfen kann, statt in einem Terminal gefangen zu sein, das sich schließt. Jetzt schreibt man einen Result-Collector. Man will verhindern, dass zwei Agenten denselben Task aus der Queue greifen. Jetzt schreibt man ein Lock.
Irgendwann hat man eine Orchestrierungsschicht aus Shell-Skripten nachgebaut – und es ist niemandes Aufgabe, sie zu pflegen. Genau an dieser Nahtstelle lebt die Diskussion um die Vibe-Kanban-Alternative, und deshalb greifen Teams zu einer echten Management-Schicht, sobald die Agentenzahl eine Schwelle überschreitet. Der Worktree war nie das Schwierige. Schwierig ist, viele isolierte Läufe zu koordinieren und ihre Ergebnisse an einer Stelle zusammenzuführen.
Wie Sharkly jeden Task in seinem eigenen Worktree ausführt
Sharkly ist eine All-in-One-Plattform für Agenten-Steuerung und -Management. Sie ersetzt nicht Claude Code, Codex oder die anderen Ausführungswerkzeuge, die Ihre Agenten bereits nutzen; sie ergänzt die gemeinsame Task-, Computer-, Kontext- und Review-Schicht darum herum. Die Worktree-Isolation ist in dieser Schicht bereits enthalten, sodass Sie sie nicht mehr selbst bauen müssen.
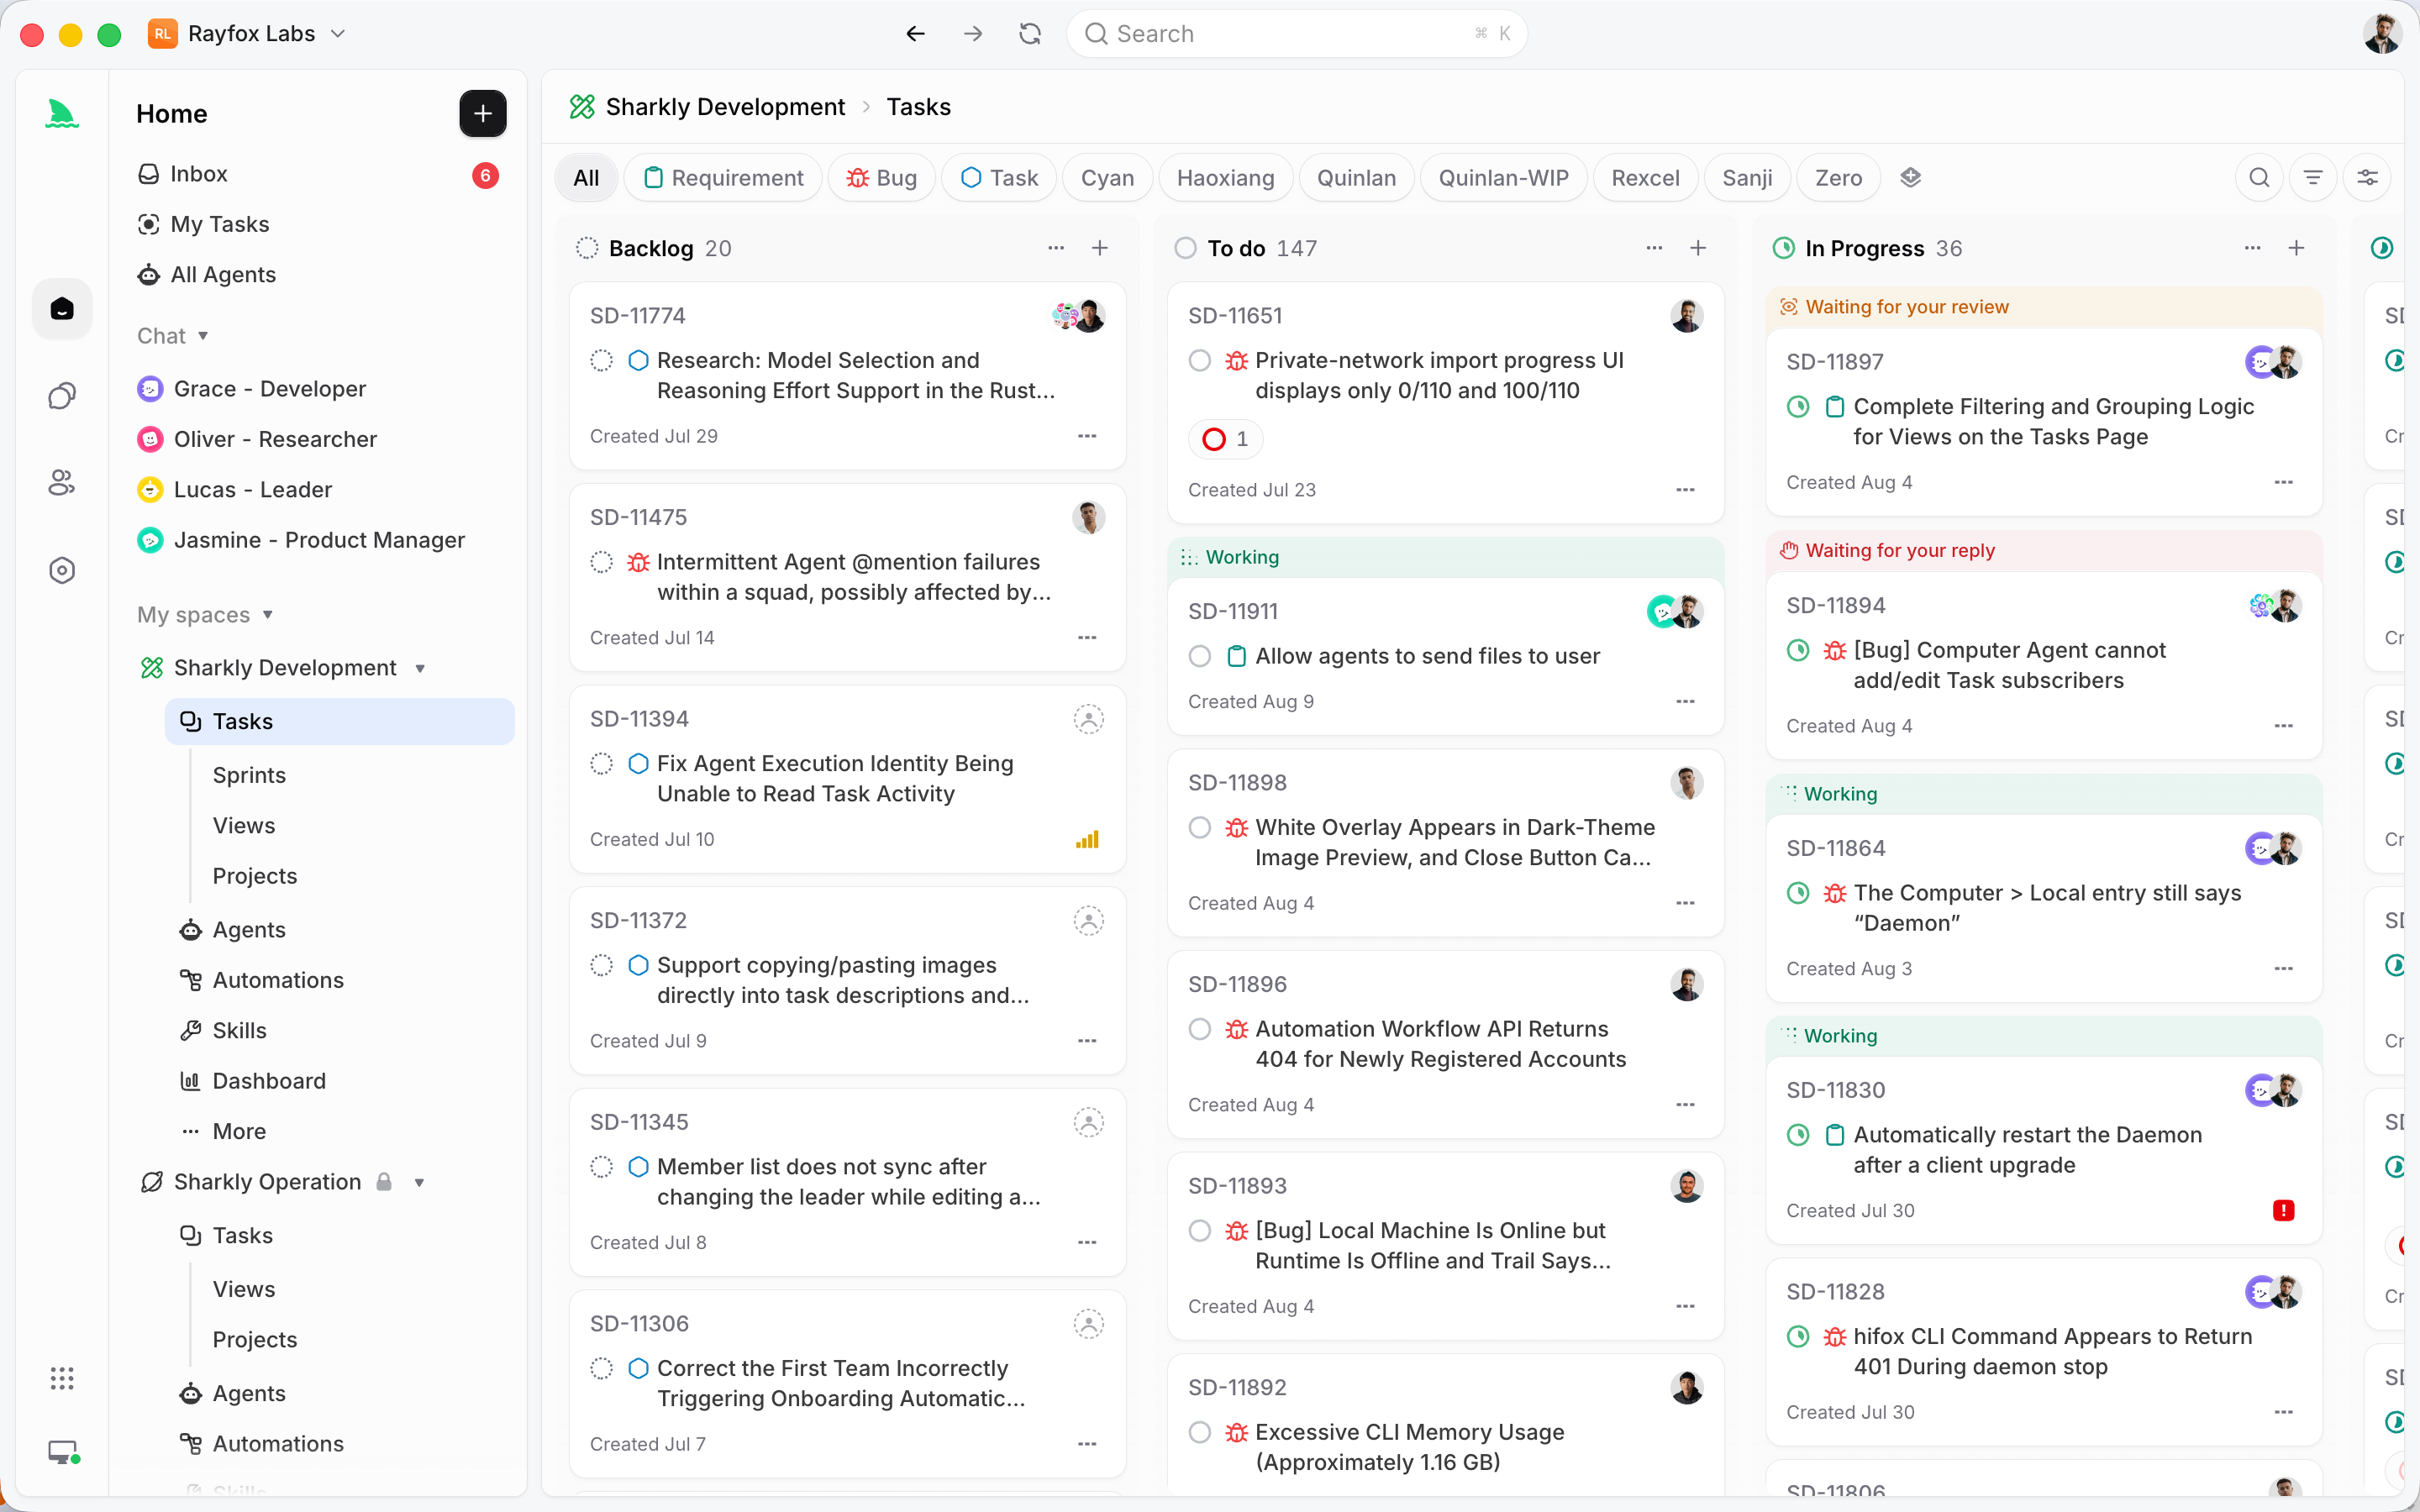
Der Mechanismus ist direkt. Jeder Task erhält ein isoliertes Verzeichnis. Bei repository-basierten Arbeiten bereitet Sharkly aus seinen gecachten Repository-Daten pro Lauf einen frischen Worktree vor, sodass mehrere Tasks gegen dieselbe Quelle arbeiten können, ohne je in einen gemeinsamen Checkout zu schreiben. Sie führen kein git worktree add aus. Sie schreiben kein Namensschema, keinen Cleanup-Job und keine Mapping-Datei. Sie weisen einen Task zu, und die Isolation ist bereits da.
Das ist die Trennung der Zuständigkeiten, die das Ganze ruhig macht. Der Agent definiert, wie die Arbeit erledigt werden soll. Der Computer stellt den Host und lokale Ressourcen bereit. Die Runtime führt die eigentliche Agenten-Session aus. Der Task bleibt der gemeinsame Datensatz für das Team. Weil jeder Lauf in seinem eigenen Worktree stattfindet, können Frontend, Backend, ein Bugfix und neue Testabdeckung gleichzeitig vorankommen, ohne sich gegenseitig zu behindern – genau die Parallelität, die der manuelle Ansatz angestrebt hat.
Und die Ergebnisse haben einen Ort, an den sie gehen. Ausführung, Blocker, Ergebnisse und Follow-up-Diskussionen landen alle in der Task-Timeline. Statt dass das Diff eines Agenten in einem Terminal lebt, an das man sich erinnern muss, kommen die Änderungszusammenfassung, die Verifikationsausgabe und die bekannten Grenzen zurück zum Task, wo eine Person sie annimmt, Änderungen anfordert oder über den Merge entscheidet. Kontext, Fortschritt, Blocker, Ergebnisse und menschliche Prüfung bleiben vom Request bis zum Release sichtbar – an einem gemeinsamen Ort, statt auf private Prompts und Terminal-Sessions verteilt. Wer mit diesem Modell neu ist, für den ist Ihren ersten Task an einen KI-Coding-Agenten zuweisen der kürzeste Einstieg.
Sie behalten die Tools, die Sie bereits nutzen. Die Modellnutzung läuft weiter über die in diesen Tools konfigurierten Abos oder API-Keys; Sharkly ergänzt Isolation, Koordination und Review darum herum.
Manuelle Worktrees vs. eine Management-Schicht
Beide Ansätze nutzen dasselbe Primitiv. Der Unterschied liegt darin, wer das operative Gewicht trägt.
| Aspekt | Manuelle Git-Worktrees | Von Sharkly verwaltete Worktrees |
|---|---|---|
| Isolation pro Agent | Sie führen pro Lauf git worktree add aus |
Jeder Task bekommt automatisch einen frischen Worktree |
| Setup pro Worktree | Sie skripten Installationen und Env-Dateien | Wird im Rahmen der Task-Vorbereitung erledigt |
| Aufräumen und Pruning | Ihre Verantwortung, leicht zu vergessen | Verwaltet; sicheres Aufräumen berührt geschützte Caches nie |
| Welcher Agent ist wo | Eine Mapping-Datei, die Sie pflegen | Direkt am Task sichtbar, keine zusätzliche Datei |
| Ergebnisse und Diffs | In jedem Terminal gefangen | Kehren zur Prüfung an den Task zurück |
| Task-Vergabe / Locks | Sie schreiben das Lock | Tasks werden aus einem gemeinsamen Plan beansprucht |
| Speicherplatz-Koordination | Manuell | Verwaltet über verbundene Computer hinweg |
Manuelle Worktrees sind die richtige Wahl, wenn Sie ein einzelner Entwickler mit ein oder zwei Agenten sind und die volle Kontrolle über die Shell wollen. Diese Konstellation ist völlig in Ordnung und es lohnt sich, sie zu lernen, weil die Mechanik zeigt, was eine Ebene darüber eigentlich macht. Eine Management-Schicht lohnt sich, wenn die Anzahl wächst, wenn mehr als eine Person die Arbeit sehen muss oder wenn der Verlust von Agentenergebnissen in einem geschlossenen Terminal Sie tatsächlich schon Zeit gekostet hat. Das entspricht der ehrlichen Entscheidungsregel in unserem Leitfaden zur KI-Agenten-Orchestrierung: Bauen Sie keine Koordinationsmaschinerie, solange parallele Arbeit nicht real ist – und bauen Sie sie nicht weiter selbst, sobald sie es ist.
Der Vertrag zwischen Mensch und Agent gilt weiterhin
Isolation ändert, wo Arbeit stattfindet, nicht wer entscheidet. Worktrees lassen Agenten parallel recherchieren, ausführen, testen und berichten – ohne Kollisionen. Menschen geben weiterhin die Richtung vor, erteilen Befugnisse und nehmen das Ergebnis ab. Automatisierung endet dort, wo Team-Urteilsvermögen gefragt ist. Ein frischer Worktree pro Agent macht diese Grenze durchsetzbar: Die Arbeit jedes Agenten kommt als eigenständige, prüfbare Änderung in seinem eigenen Branch an – nicht als nicht nachvollziehbare Bearbeitung, die in einen gemeinsamen Checkout eingemischt wurde. Sie prüfen Branches, kein Chaos. Für das größere Bild davon, was dieser Wandel im Alltag bedeutet, liefert unser Erklärartikel zum agentischen Coding den Kontext, und Was ist Sharkly beschreibt die Plattform von A bis Z.
Ein paar bewährte Vorgehensweisen für manuelle Worktrees
Wenn Sie vorerst manuell bleiben, verhindern diese Gewohnheiten den größten Teil des Ärgers:
- Benennen Sie Worktree-Verzeichnisse nach Branch oder Task, nicht fortlaufend nummeriert.
myproject-auth-refactorsagt Ihnen, was drin ist;myproject-wt3nicht. - Halten Sie Worktrees als Geschwister des Haupt-Checkouts, nicht darin verschachtelt. Verschachtelung verwirrt Tools, die den Baum durchlaufen, und bläht Ihre Ignore-Regeln auf.
- Automatisieren Sie das Setup pro Worktree als ein Skript, das der Agent zuerst ausführt. So ist ein neuer Worktree in einem Schritt lauffähig, statt an einer fehlenden Installation zu scheitern.
- Prunen Sie nach Plan, nicht aus einer Laune heraus. Ein tägliches
git worktree pruneplus ein Blick aufgit worktree listhält die Geistereinträge in Schach. - Löschen Sie niemals einen verschachtelten Runtime-Cache wie
~/.claude/worktreesaus Ihren eigenen Skripten. Überlassen Sie ihn der Runtime. - Committen oder stashen Sie, bevor Sie entfernen.
--forceist für den Fall, dass Sie sicher sind – nicht als Standard.
Fazit
Git-Worktrees sind das Isolationsprimitiv, das parallele KI-Coding-Agenten sicher macht. Diese Kernideen lohnen sich zu behalten:
- Ein Checkout hat einen Branch, einen Index, ein
HEAD– und kann nicht zwei Agenten gleichzeitig beherbergen. - Ein Worktree fügt ein zweites Arbeitsverzeichnis auf derselben gemeinsamen Historie hinzu, sodass jeder Agent seinen eigenen Branch und seine eigenen Dateien erhält.
- Die fünf Befehle (
add,list,remove,pruneund--force, wenn Sie es ernst meinen) sind simpel. - Was wächst, ist der operative Aufwand (Installationen pro Worktree, Speicherplatz, Aufräumen, Koordination, Einsammeln von Ergebnissen).
- Manuelle Worktrees sind für ein oder zwei Agenten richtig; eine Management-Schicht verdient ihren Platz, wenn Anzahl und Einsatz steigen.
- Sharkly bereitet für jeden Task automatisch einen frischen Worktree vor und gibt jedes Ergebnis zur menschlichen Prüfung an den Task zurück.
Lernen Sie zuerst die manuellen Befehle; sie zeigen Ihnen, was jede Ebene darüber tut. Wenn die Buchhaltung mehr kostet als die Arbeit, nimmt Sharkly Ihnen Worktree, Koordination und Review ab. Verbinden Sie einen Computer, erstellen Sie einen Agenten und weisen Sie ihm etwas Langweiliges zu.
FAQ
Was ist ein Git-Worktree, einfach erklärt? Er ist ein zweites Arbeitsverzeichnis, das an dasselbe Repository angehängt ist, mit eigenem ausgecheckten Branch und eigenen gestagten und unstaged Änderungen. Er teilt sich eine Commit-Historie mit dem Haupt-Checkout und ist daher viel leichter als ein Clone. Für KI-Agenten bedeutet das: Jeder Agent bekommt einen privaten Arbeitsbereich, ohne die Dateien anderer anzufassen.
Warum brauchen KI-Coding-Agenten Worktrees? Weil zwei Agenten, die sich einen Checkout teilen, gegenseitig ihre Dateien überschreiben und sich gegenseitig den Branch wechseln. Ein Worktree pro Agent verlagert Konflikte auf den Merge-Zeitpunkt, wo sie sichtbar und prüfbar sind – statt mitten ins Editieren, wo sie den Zustand still korrumpieren. Das vollständige parallele Setup finden Sie in unserem Leitfaden zum parallelen Ausführen mehrerer Claude-Code-Agenten.
Ist ein Worktree dasselbe wie ein Clone? Nein. Ein Clone kopiert die gesamte Objektdatenbank in ein separates Repository. Ein Worktree teilt sich eine Objektdatenbank und fügt nur ein neues Arbeitsverzeichnis und einen Branch-Checkout hinzu. In einem beliebigen Worktree erstellte Commits sind sofort von allen aus sichtbar, und der Speicherverbrauch ist deutlich geringer.
Können zwei Worktrees denselben Branch auschecken? Nein. Git weigert sich, einen Branch gleichzeitig in zwei Worktrees auszuchecken, um Sie vor konkurrierenden Schreibzugriffen auf denselben Branch zu schützen. Wenn zwei Agenten diesen Branch als Basis brauchen, muss einer einen neuen Branch davon ableiten.
Wie räume ich Worktrees sicher auf? Committen oder stashen Sie zuerst alle Arbeit, dann git worktree remove <path>. Wenn Sie ein Worktree-Verzeichnis von Hand gelöscht haben, führen Sie git worktree prune aus, um die veralteten Metadaten zu bereinigen. Richten Sie Cleanup-Skripte niemals auf den eigenen Cache einer Runtime wie ~/.claude/worktrees.
Wann sollte ich aufhören, Worktrees von Hand zu verwalten? Wenn Sie mehr als ein paar Agenten koordinieren, wenn mehr als eine Person die Arbeit sehen muss oder wenn ein verlorenes Ergebnis in einem geschlossenen Terminal Sie Zeit gekostet hat. Dann rechnet sich eine Management-Schicht, die jeden Lauf isoliert und verfolgt. Unser Leitfaden zur KI-Agenten-Orchestrierung behandelt, wann dieser Sprung fällig ist.


