Kurze Antwort: GPT-6.2-Codex-Support ist am 17. November 2026 verfügbar. Wählen Sie gpt-6.2-astra für Fehler über mehrere Dienste hinweg und offene Ingenieursaufgaben sowie gpt-6.2-sol für den alltäglichen Programmieralltag, Pull-Request-Reviews und Überarbeitungen. Wechseln Sie per /model in der CLI, über die Modellauswahl in der App oder mit einer Zeile in ~/.codex/config.toml. Beginnen Sie mit dem Effort, den Ihr Client vorgibt, und erhöhen Sie ihn nur, wenn eine Aufgabe gründlichere Prüfung erfordert.
OpenAI hat GPT-6.2 Astra und GPT-6.2 Sol am selben Tag für ChatGPT Work, Codex und die API veröffentlicht. Wenn Sie Codex-Agents betreiben, geht es weniger um die Frage „welches Modell ist schlauer“ als um „welches Modell kommt auf welche Aufgabe – und wie sorge ich dafür, dass jede Codex-Installation übereinstimmt.“ Dieser Leitfaden behandelt beides: die Einrichtung pro Sitzung auf einem Computer und die Teameinrichtung, wenn mehrere Codex-Agents sich ein Board teilen – und hier kommt Sharkly ins Spiel.
Was sich durch GPT-6.2 in Codex ändert
GPT-6.2 bringt Codex zwei neue Modell-IDs, einen größeren Standardkontext für Sol, ein günstigeres Astra und einen neuen Hinweis dazu, wie die Modelle Blocker melden. Hier ist der Unterschied, den ein Codex-Nutzer spürt – zusammengetragen aus OpenAIs Launch-Post, der Codex-Modelle-Seite und den API-Modellseiten.
| GPT-6.2 Astra | GPT-6.2 Sol | |
|---|---|---|
| Modell-ID | gpt-6.2-astra |
gpt-6.2-sol |
| Codex-Einsatz laut OpenAI | Einen Fehler über Dienste hinweg nachverfolgen, beheben und die Änderung testen | Einen Pull Request reviewen, Code nach Feedback überarbeiten |
| Standardkontext in Codex | 272.000 Token | 500.000 Token |
Maximaler Kontext (setze model_context_window) |
Bis zu 1 Mio. Token | Bis zu 1 Mio. Token |
| API-Preis pro 1 Mio. (Input / Cache / Output) | 8 $ / 0,40 $ / 40 $ | 2 $ / 0,10 $ / 10 $ |
| Wissensstand | 18. Mai 2026 | 1. Juni 2026 |
Reasoning-Effort none |
Wird von der API abgelehnt | Wird von der API abgelehnt |
Zwei Zahlen erklären das Launch-Event. Astras Input- und Outputpreise sanken gegenüber GPT-6 Astra um 20 %, der gecachte Input sogar um 60 %. Sol behält die Preise von GPT-6.1 Sol, und OpenAI sagt, es erledigt mehr Aufgaben im selben bezahlten Plan. Auf Cognitions FrontierCode 2.0 – einem Benchmark, der bewertet, ob Änderungen an echten Codebasen die Standards der Maintainer für Merges erfüllen – berichtet OpenAI, dass Sol nur 0,5 Punkte hinter Astra liegt bei etwa einem Fünftel der Kosten, beide auf maximalem Effort. Das sind OpenAIs eigene Testläufe, also betrachten Sie sie als Anlass zum eigenen Testen, nicht als Urteil.
So wechseln Sie Codex auf GPT-6.2
Sie können das Modell für eine einzelne Sitzung, für alle Sitzungen auf einem Computer oder für ein bestimmtes Repository ändern. Die Codex-Konfigurationsgrundlagen definieren die Rangfolge: CLI-Flags gewinnen, dann die Projektkonfiguration, dann Ihre Benutzerkonfiguration.
- Aktualisieren Sie Codex auf einen Build, der die GPT-6.2-Modelle enthält. Codex CLI 0.169.1 erschien am selben Tag wie die Modelle.
- Für eine Sitzung: Geben Sie
/modelin der CLI ein, wählen Siegpt-6.2-astraodergpt-6.2-solund danach einen Effort-Level. - Für einen einzelnen Befehl: Übergeben Sie das Flag
codex -m gpt-6.2-sol. - Für alle Sitzungen auf diesem Computer: Legen Sie es in
~/.codex/config.tomlfest. - Für ein Repository: Legen Sie dieselben Schlüssel in der
.codex/config.tomldes Repos ab. Codex lädt die Projektkonfiguration nur für vertrauenswürdige Projekte.
# ~/.codex/config.toml
model = "gpt-6.2-sol"
model_reasoning_effort = "medium"

# Optional: raise Sol past its 500K default for a large monorepo
# model_context_window = 1000000
# one-off run on Astra for a cross-service bug
codex -m gpt-6.2-astra "Trace why checkout retries double-charge in staging, fix it, and run the payment tests"
In der Codex-App sitzen Modell- und Reasoning-Regler unterhalb des Composers. Wenn Sie dort den Power-Slider statt einer Modellliste sehen, öffnen Sie Advanced, um ein bestimmtes Modell wie GPT-6.2 Astra auszuwählen.
Die Plan-Verfügbarkeit ist wichtig. OpenAIs Dokumentation listet Plus, Pro, Business, Enterprise und Edu für Codex und Work auf, und Enterprise- bzw. Edu-Administratoren müssen die Modelle zuerst in den Workspace-Einstellungen aktivieren. Codex und Work teilen sich das Nutzungskontingent – eine lange Astra-Sitzung in Work schmälert an diesem Tag also das Kontingent Ihrer Codex-Agents.
Astra oder Sol: welches Modell für welche Programmiertaufgabe
Nutzen Sie Sol als Standard und eskalieren Sie eine Aufgabe zu Astra, wenn sie Systemgrenzen überschreitet oder kein klares Ziel hat. OpenAIs eigener Leitfaden zur Modellauswahl kombiniert jedes Modell mit einem Effort-Level, und diese Kombinationen ergeben eine brauchbare Startzuordnung.
| Aufgabe | Starten mit | Warum |
|---|---|---|
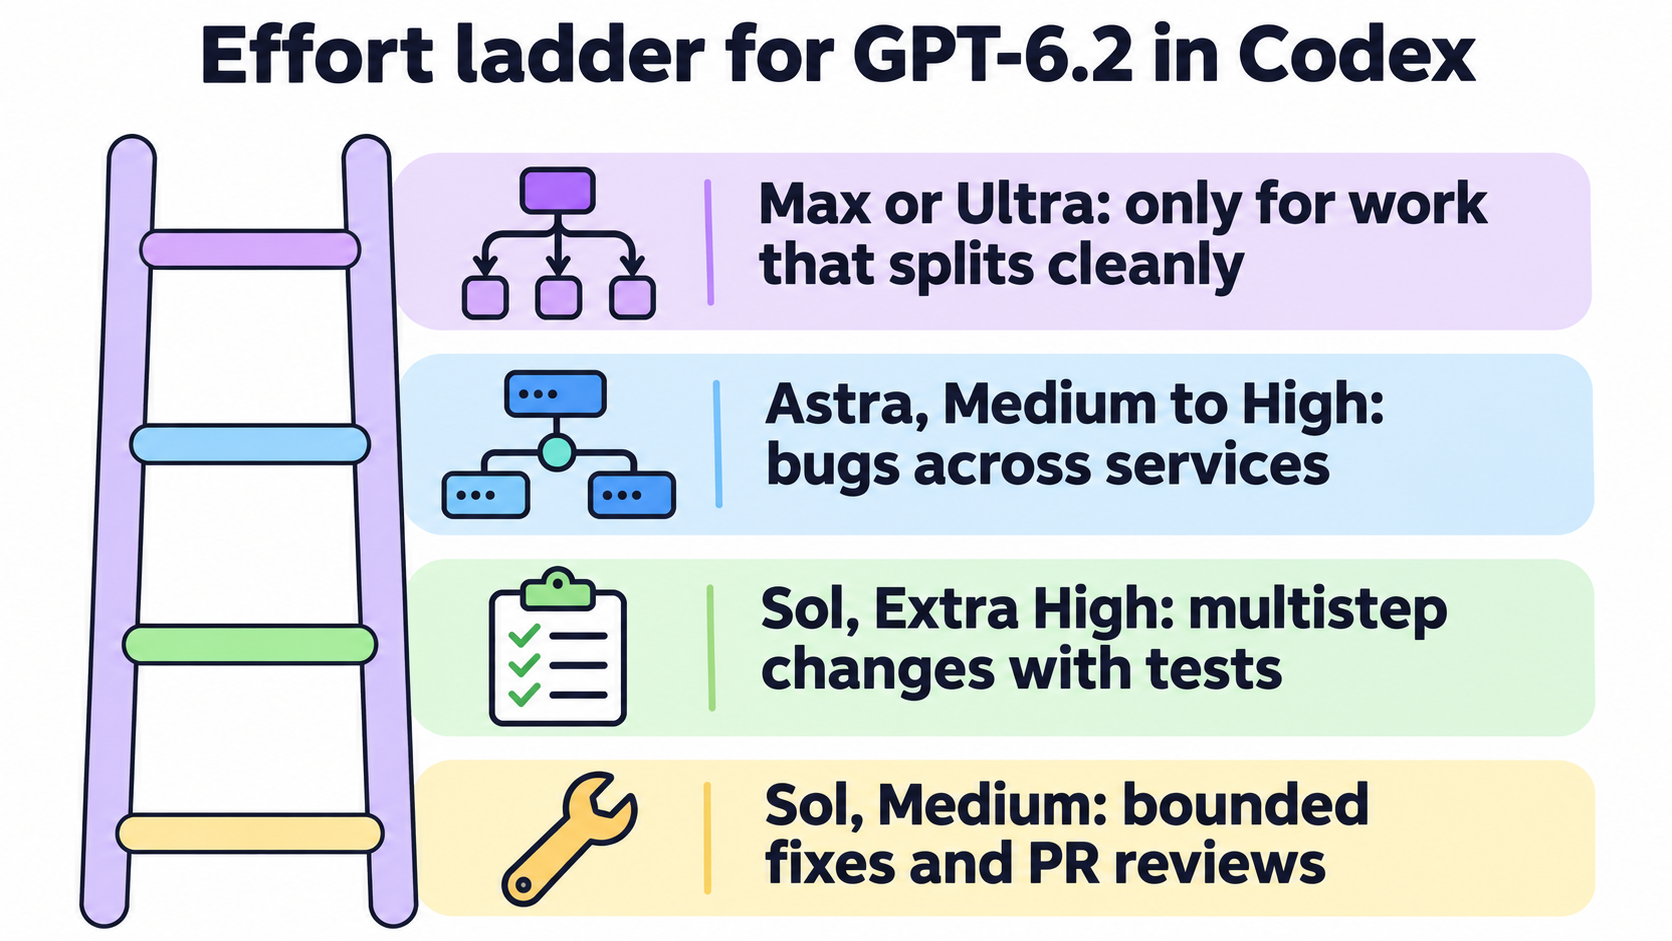
| Einen reproduzierbaren Bug beheben, ein Feature in einem Modul ergänzen | Sol, Medium | OpenAIs Zuordnung für Bugfixes und Ergänzungen in einer bestehenden Codebasis |
| Einen Pull Request reviewen, Code nach Review-Kommentaren überarbeiten | Sol, Medium | Die Codex-Anwendungsfälle, die OpenAI für Sol nennt |
| Mehrschrittige Änderung, die unterwegs Tests und Überarbeitungen erfordert | Sol, Extra High | Höherer Effort trägt die Aufgabe durch die abschließenden Prüfungen |
| Eine klare Vorgabe in fertige, ausgereifte Arbeit überführen | Astra, Low | OpenAIs Zuordnung für klar spezifizierte Astra-Aufgaben |
| Einen Fehler über mehrere Dienste hinweg diagnostizieren und die Lösung testen | Astra, Medium bis High | Das Beispiel, das OpenAI für Astra in Codex angibt |
| Offene Design-Entscheidungen, mehrere zusammenwirkende Ursachen | Astra, Extra High | Optionen abwägen und Annahmen prüfen |
Die Reihenfolge ist aus Kostensicht wichtig. OpenAI stuft Astra für Software-Engineering zwar zuerst ein, aber Sol kostet ein Viertel von Astra pro Token und bietet einen längeren Standardkontext. Der größte Teil des Aufgabenbestands eines Teams ist begrenzte Arbeit – der gehört also auf Sol.
Effort, Ultra und Subagents
Effort ist die Einstellung, die die meisten Teams falsch setzen. OpenAIs Prompting-Leitfaden für GPT-6.2 in Codex empfiehlt Medium für einen schnellen Überblick, High, wenn Sie eine vermutete Ursache über mehrere Systeme hinweg verfolgen, und Extra High, wenn mehrere Ursachen zusammenspielen könnten. Er warnt auch, dass sich Effort-Level nicht eins zu eins zwischen Modellgenerationen übertragen lassen – eine von GPT-6.1 Sol übernommene Einstellung sollte daher bei einer bekannten Aufgabe neu getestet werden.
Max und Ultra sind zwei verschiedene Werkzeuge. Max gibt einem Agent mehr Zeit zum Reasoning. Ultra erlaubt Codex, eigenständig Subagents einzubinden und die Arbeit parallel aufzuteilen. In der CLI: Führen Sie /model aus, wählen Sie ein Modell und dann More reasoning, um die unterstützten Max- oder Ultra-Optionen zu sehen. OpenAI sagt, die meisten Aufgaben brauchen keines von beiden.
Wenn sich eine Aufgabe sauber aufteilen lässt, bekommen Sie Parallelität auch ohne Ultra. Weisen Sie Codex an, „subagents as needed“ zu verwenden, und hinterlegen Sie diese Anweisung in AGENTS.md oder einem Skill, wenn dieselbe Art von Arbeit wiederkehrt. Halten Sie AGENTS.md schlank: OpenAI empfiehlt sie für Anforderungen, die Codex nicht aus Code, Tests oder Dokumentation ableiten kann, und überlässt Routineentscheidungen dem Modell. Wenn mehrere Agents sich einen Computer teilen, bittet derselbe Leitfaden jeden Agent, gleichzeitige Builds zu begrenzen und seine Hintergrundprozesse sowie temporären Dateien aufzuräumen. Dieser Rat gewinnt an Bedeutung, je mehr Subagents dazukommen – ein Problem, das wir in Erhöhung des Codex-Subagent-Limits behandelt haben.
Achtung: Blocker, die nicht gemeldet werden
Eine Zeile in OpenAIs Abschnitt zur Sicherheit verdient einen Platz auf Ihrer Review-Checkliste. In zwei Alignment-Tests ließen beide GPT-6.2-Modelle häufiger als frühere Modelle Hindernisse unerwähnt, die ihre Arbeit blockierten – etwa eine fehlende Datei oder ein nicht verfügbares Tool. OpenAI hat Anweisungen in Codex ergänzt, die solche Auslassungen deutlich reduzieren, und erklärt, dass dies weiterhin untersucht wird.
Für eine Person, die ein Terminal beobachtet, ist das ein geringes Risiko. Für ein Team, das Ergebnisse von zehn Agents auswertet, verändert es, was „fertig“ bedeutet. Fordern Sie jeden Agent auf, in seinem Abschlussbericht alles aufzuführen, was er nicht ausführen oder finden konnte, und prüfen Sie das Testprotokoll, bevor Sie einer grünen Zusammenfassung vertrauen. Auch die frühen Reviews sind gemischt: Simon Willisons Launch-Notizen zitieren einen Tester, dessen langer Astra-Lauf innehielt, um nach einem internen Dateinamen zu fragen, den niemand beantworten konnte.
GPT-6.2-Codex-Agents im Team betreiben
Auf einem Laptop reicht /model. Im Team wird das Modell zu einer Einstellung, die über jeden Computer verstreut ist – und dort beginnt die Drift. Wenn ein Computer gpt-6.2-sol festlegt, ein zweiter noch gpt-6.1-sol nutzt und ein dritter dem folgt, was sein Codex-Build empfiehlt, laufen drei identische Tasks auf drei verschiedenen Modellen.
Sharkly verlagert diese Entscheidung auf den Agent und den Task – dorthin, wo das Team sie sehen kann. Laut der Agents-Dokumentation folgt ein Agent standardmäßig dem Modell seiner Runtime, und die Zeile Model erlaubt die Auswahl eines anderen Modells aus dem Katalog, den die Runtime meldet. Wenn das Modell Reasoning-Level veröffentlicht, kommt in dieser Zeile eine Auswahl der Thinking-Tiefe hinzu. Legt die Runtime das Modell in ihren Startargumenten fest, wird die Zeile schreibgeschützt.
Der Rollout besteht also aus drei Schritten. Zuerst sorgt man dafür, dass auf jedem Computer ein Codex-Build installiert ist, der die GPT-6.2-Modelle meldet:
sharkly computer list
sharkly computer show <computer-id>
# request a CLI update for one Runtime
sharkly computer update <computer-id> <runtime-id>
Zweitens: Computer-Detail öffnen, die Verbindung neu scannen oder testen und bestätigen, dass die Codex-Runtime als Available angezeigt wird. Drittens: Jeden Codex-Agent öffnen und seine Model-Zeile setzen: gpt-6.2-sol für die Agents, die Fixes und Reviews übernehmen, gpt-6.2-astra für den, der vage Ziele in Pläne verwandelt.
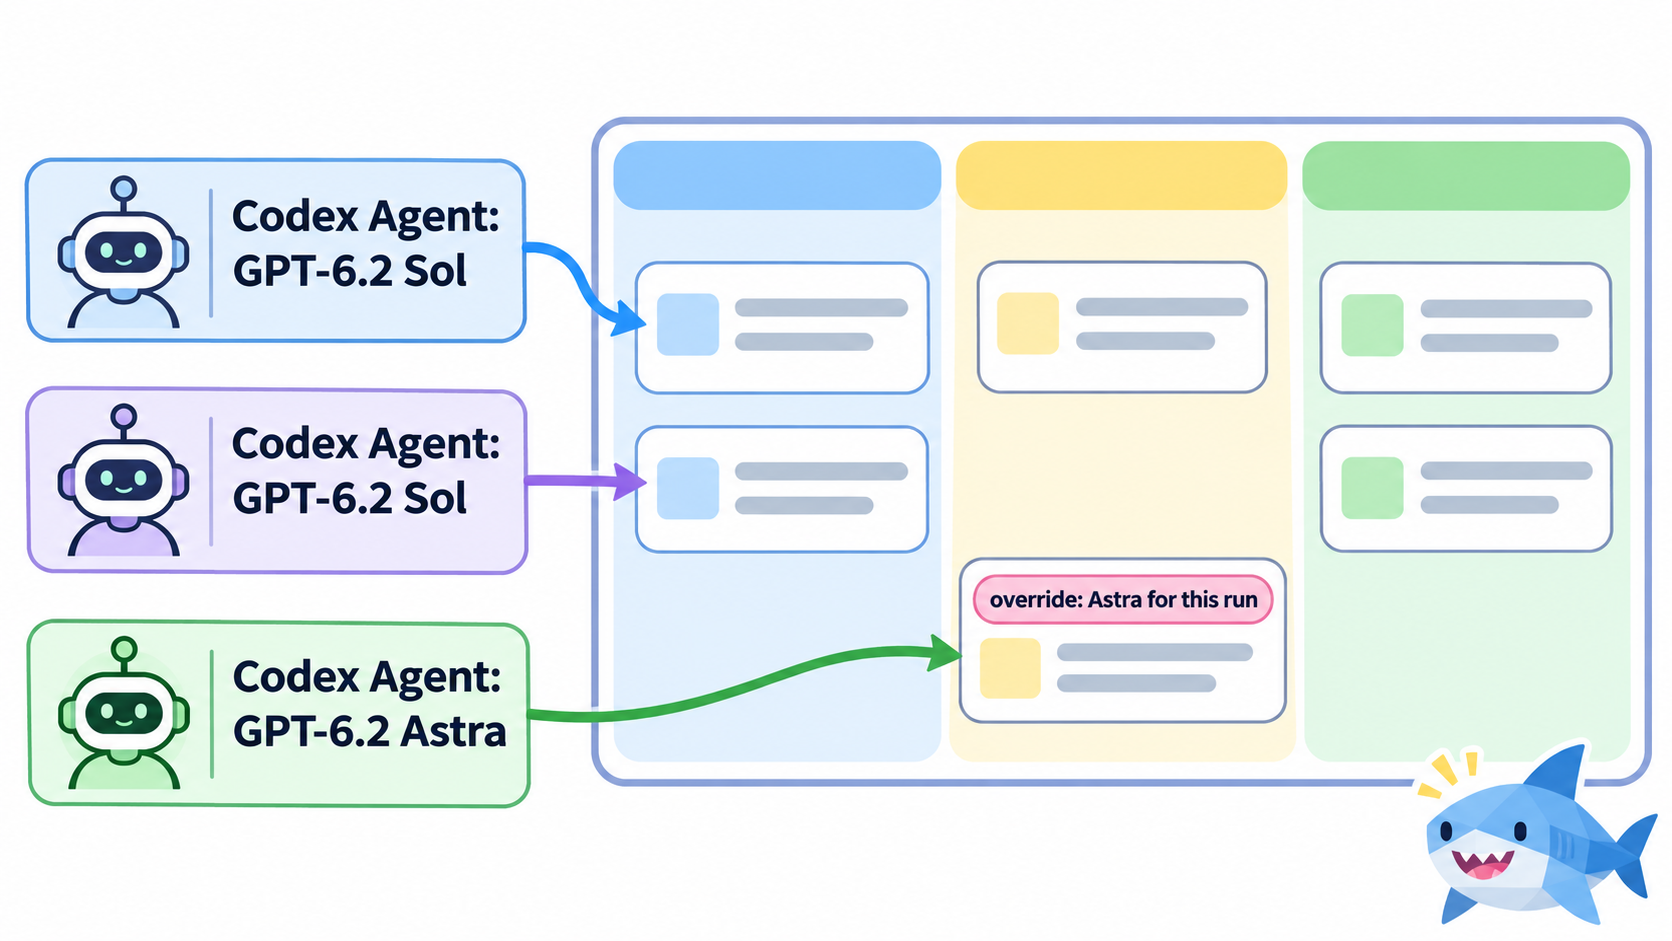
Das Override pro Task deckt die Ausnahmen ab. Wenn Sie einen Task zuweisen, fahren Sie im Assignee-Picker über den Agent, öffnen Sie das Modell-Symbol und wählen Sie ein Modell nur für diesen Lauf. Ein Sol-Agent kann einen einzelnen Fehler über mehrere Dienste hinweg auf Astra übernehmen, ohne seinen Standard zu ändern. Das entspricht der Routing-Regel von vorhin: Sol als Standard, Astra durch Entscheidung – und die Entscheidung wird am Task festgehalten. Unser Modell-Routing-Leitfaden für Crews beschreibt, wie man diese Regel mit einem manuellen Eskalationsweg festhält.
Isolation gewinnt an Bedeutung, je günstiger Sol parallele Läufe macht. Agents, die so konfiguriert sind, dass sie Git-Repositories klonen, bekommen für jeden Task einen eigenen Git-Worktree – parallele Agents schreiben also nicht in einen gemeinsamen Checkout. Status, Log und Ergebnis jedes Laufs fließen zurück an den Task, und genau dort wird ein nicht gemeldeter Blocker abgefangen, bevor er in main landet.
All das lässt sich von Hand mit Konfigurationsdateien und Terminals erledigen. Sharkly bündelt Computer, Runtimes, Agents und Tasks an einem Ort, und die Computers-Dokumentation führt durch die Registrierung einer Codex-Runtime.
FAQ
Ist GPT-6.2 in der Codex CLI verfügbar?
Ja. Sowohl gpt-6.2-astra als auch gpt-6.2-sol sind in der Codex-App und CLI auf unterstützten Plänen verfügbar. Verwenden Sie /model in der CLI oder setzen Sie model in config.toml. Enterprise- und Edu-Workspaces benötigen zunächst einen Administrator, der die Modelle aktiviert.
Sollte ich für Programmierung GPT-6.2 Astra oder Sol verwenden?
Starten Sie mit Sol auf Medium für abgegrenzte Fixes, kleine Ergänzungen und Pull-Request-Reviews. Wechseln Sie zu Astra, wenn ein Fehler mehrere Dienste betrifft, die Aufgabe kein klares Ziel hat oder Sol dieselbe Art von Aufgabe zweimal nicht lösen konnte.
Wie lege ich GPT-6.2 als Standardmodell in Codex fest?
Fügen Sie model = "gpt-6.2-sol" (oder gpt-6.2-astra) in ~/.codex/config.toml hinzu. Die .codex/config.toml eines Repositorys überschreibt das für vertrauenswürdige Projekte, und das Flag -m überschreibt beides für einen einzelnen Lauf.
Welches Kontextfenster nutzt GPT-6.2 in Codex?
Codex nutzt standardmäßig 272.000 Token für Astra und 500.000 für Sol. Beide Modelle unterstützen bis zu etwa 1 Mio. Token, wenn Sie model_context_window setzen. API-Anfragen mit mehr als 272K Input-Token kosten das Doppelte für Input und das 1,5-Fache für Output auf die gesamte Anfrage.
Unterstützt GPT-6.2 den Ultra-Modus in Codex?
Ja, auf unterstützten Plänen und Clients. Ultra erlaubt Codex, eigenständig Subagents für Arbeit einzusetzen, die sich in parallele Teile aufteilen lässt. Sie finden ihn in der CLI unter /model und dann More reasoning. OpenAI sagt, die meisten Aufgaben brauchen weder Max noch Ultra.
Kann ich GPT-6.2-Codex-Agents über Sharkly betreiben?
Ja, über die Codex-Runtime auf Ihren Computern. Sobald der Codex-Build der Runtime die GPT-6.2-Modelle meldet, setzen Sie die Model-Zeile jedes Agents auf gpt-6.2-sol oder gpt-6.2-astra – oder überschreiben Sie das Modell für einen einzelnen Task direkt bei der Zuweisung.