Kurze Antwort: Sollte KI-generierter Code Open Source sein? Es gibt keine gesetzliche Regel, die das verlangt. Das Argument dafür stützt sich auf zwei Punkte: Die Modelle wurden mit Open-Source-Code trainiert, und Code, der vollständig von einer KI erstellt wurde, ist möglicherweise nicht urheberrechtlich schützbar. Auf welcher Seite Sie auch stehen – Ihr Team braucht zuerst dasselbe: eine Dokumentation darüber, welcher Agent was geschrieben hat, aus welcher Aufgabe, und wer sie geprüft hat.
Am 17. November 2026 stand ein Beitrag mit dem Titel „All AI-generated code should be Open Source“ an der Spitze von Hacker News mit mehr als 1.200 Punkten und 650 Kommentaren. Der Thread ist laut, aber die Frage dahinter ist sehr praktisch: Wenn Ihre Agents einen wachsenden Anteil Ihrer Codebasis schreiben, wem gehört dieser Code, unter welcher Lizenz – und wer verantwortet ihn, wenn er fehlschlägt?
Das Argument „KI-generierter Code sollte Open Source sein“ im Detail
Das Plädoyer für die Öffnung von KI-generiertem Code ist eine ethische und eine rechtliche Behauptung: Modelle wurden mit Open-Source- und Creative-Commons-Code trainiert, daher ist die Schließung ihrer Outputs eine Form von Lizenzwäsche. Zudem ist Code ohne menschlichen Autor möglicherweise ohnehin nicht urheberrechtlich geschützt – er sollte also unter einer offenen Lizenz oder CC0 veröffentlicht werden.
Jakub Jankiewicz' Beitrag führt vier Argumente an:
- Trainingsdaten. Modelle haben aus Jahrzehnten von Open-Source-Code und Stack-Overflow-Antworten gelernt, die Creative-Commons-Lizenzen mit Namensnennungspflicht tragen. Daraus geschlossenen Code zu machen, „fühle sich wie Lizenzwäsche an“, so seine Worte.
- Urheberschaft. Rein KI-generierter Code hat keinen menschlichen Autor und sollte daher nicht urheberrechtlich schützbar sein. Er verweist auf den Affen-Selfie-Streit und auf die Position des U.S. Copyright Office zu KI.
- Jurisdiktion. Einige Länder, wie das Vereinigte Königreich, gewähren computergenerierten Werken eingeschränkten Schutz – die Regeln sind also nicht einheitlich.
- Die Lösung. Entwickler sollten KI-generierten Code unter einer Open-Source-Lizenz veröffentlichen oder mit CC0 der Gemeinfreiheit übergeben – zumindest dort, wo Menschen kaum mehr getan haben als Prompts zu schreiben.
Der letzte Punkt ist für Teams am wichtigsten: Es geht ihm um Code, den niemand geprüft oder verändert hat – nicht um Code, den ein Mensch entworfen und ein Agent getippt hat.
Urheberrecht und KI-generierter Code: Die Rechtslage
Der rechtliche Teil des Arguments hat in den USA echte Grundlage, anderswo weniger.
Im Januar 2025 veröffentlichte das U.S. Copyright Office Teil 2 seines KI-Berichts zur Urheberrechtsfähigkeit. Seine Position: Urheberrecht setzt menschliche Autorenschaft voraus, Prompts allein geben einer Person in der Regel nicht genug Kontrolle über das Ergebnis, und menschliche Beiträge wie die Auswahl, Anordnung oder Bearbeitung des Outputs können dennoch geschützt sein. Im März 2025 bestätigte der D.C. Circuit in Thaler v. Perlmutter, dass der Copyright Act einen menschlichen Autor verlangt.
Das Vereinigte Königreich sieht das anders. Section 9(3) des Copyright, Designs and Patents Act 1988 behandelt bei computergenerierten Werken die Person als Autorin, die die für die Erstellung notwendigen Vorkehrungen getroffen hat.
In den USA kann eine Datei, die ein Agent ohne wesentliche menschliche Bearbeitung erzeugt hat, also schwachen oder keinen urheberrechtlichen Schutz genießen. Eine Datei, die ein Entwickler umstrukturiert, gekürzt und erweitert hat, sehr wahrscheinlich schon. Der meiste Produktionscode liegt irgendwo dazwischen – und die Grenze verläuft durch Ihren Review-Prozess.
Die Gegenargumente im direkten Vergleich
Die stärksten Einwände im Thread lauten nicht „der Autor irrt sich im Recht“. Sie betreffen das, was daraus folgt.
| Das Argument | Das Gegenargument |
|---|---|
| Modelle wurden mit Open Source trainiert, also sollte der Output offen sein | Klagen zu Trainingsdaten werden vor Gericht ausgetragen; eine Lizenz am Output entscheidet sie nicht |
| Nicht schützbarer Code sollte veröffentlicht werden | Nicht schützbar ist nicht dasselbe wie veröffentlicht; nichts im Bericht des Copyright Office verlangt die Freigabe von Code |
| Code mit minimalem Aufwand verdient keinen Schutz | Fast kein Produktionscode ist aufwandfrei: Specs, Reviews, Tests und Bearbeitungen sind menschliche Arbeit |
| Offene Lizenzen würdigen das Gemeingut | Ein pauschales CC0 kann menschlichen Beiträgen, die in dieselbe Datei gemischt sind, den Schutz nehmen |
| Die Regel sollte länderübergreifend einheitlich sein | Urheberrecht ist nationales Recht; die britische Regel weicht bereits von der US-amerikanischen ab |
Beachten Sie, was beide Spalten voraussetzen: Jede Zeile hängt davon ab zu wissen, wie viel einer Änderung von einem Agent stammt und wie stark eine Person sie geformt hat. Ohne diese Dokumentation können Sie weder eine Lizenzpolitik festlegen, noch die Herkunftsfrage eines Kunden beantworten, noch die Urheberschaft begründen.
Wer ist für von Agents geschriebenen Code verantwortlich?
Die Lizenzdebatte ist offen. Die Verantwortung nicht. Wer die Änderung gemerged hat, trägt die Verantwortung – ganz gleich, was den ersten Entwurf geschrieben hat.
Das ist der Kerngedanke in unserem Beitrag über die menschliche Verantwortung für die Arbeit von Agents. Ein Bug in von Agents geschriebenen Code ist weiterhin Ihr Bug. Ein geleaktes Secret im Pull Request eines Agents ist weiterhin Ihr Vorfall.
Agents recherchieren, führen aus, testen und berichten. Menschen setzen die Richtung, erteilen Befugnisse und nehmen das Ergebnis ab. Die Open-Source-Debatte ändert diese Aufteilung nicht – sie erhöht nur die Kosten, sie aus den Augen zu verlieren.
Herkunftsnachweis für KI-generierten Code: Was dokumentiert werden sollte
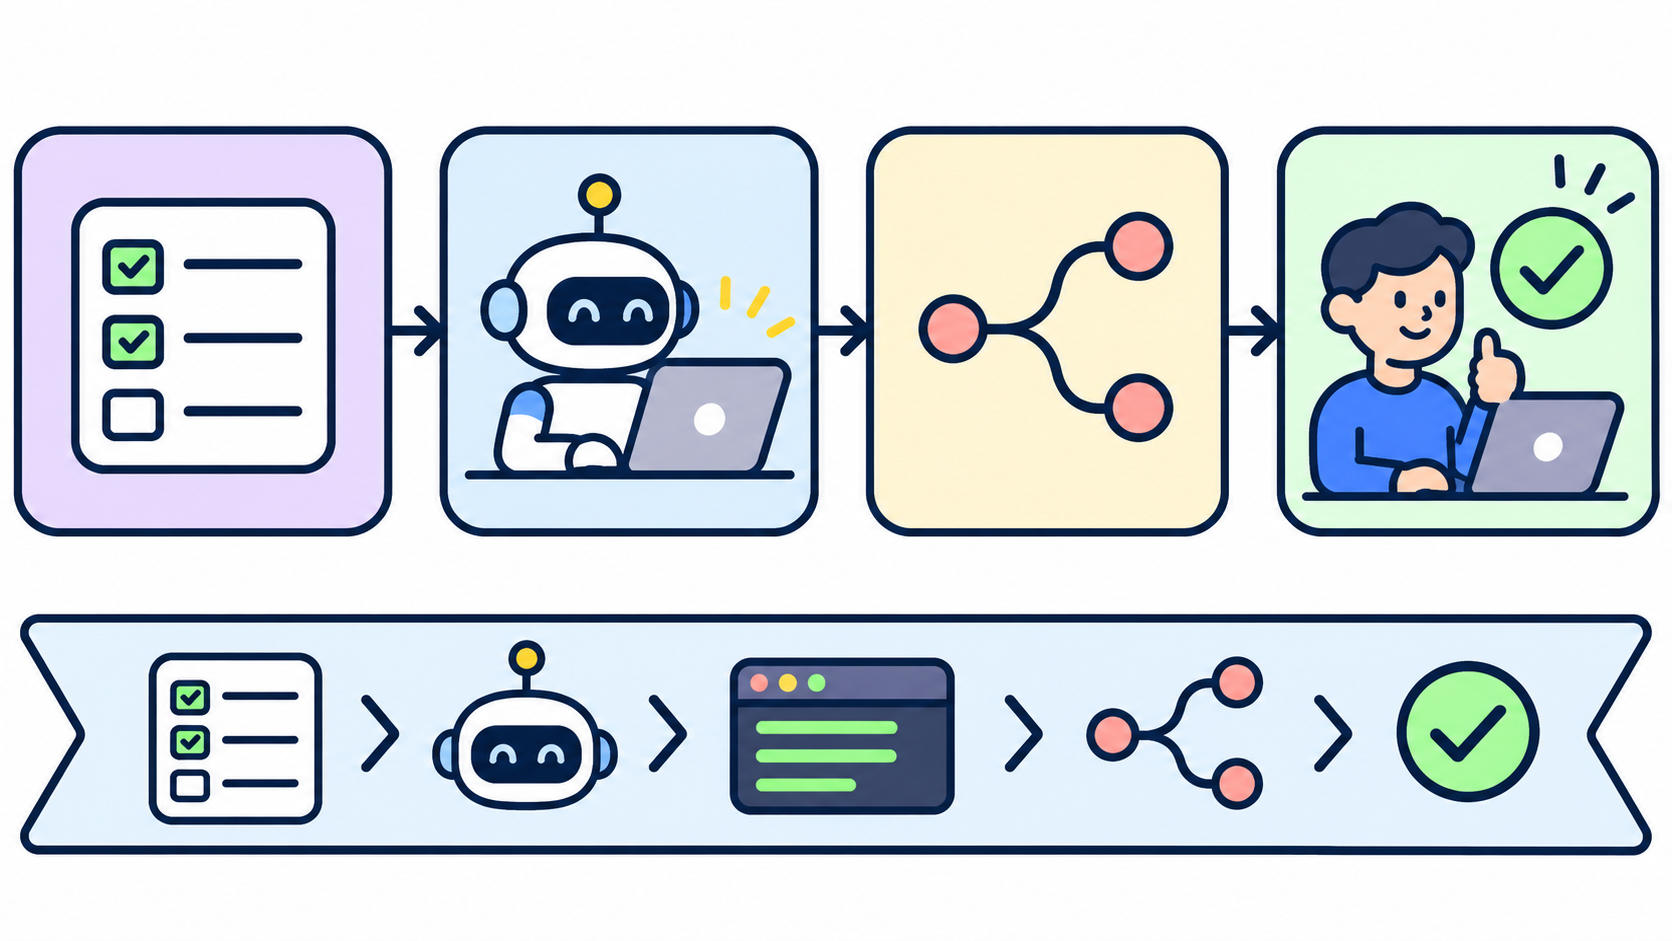
Herkunftsnachweis (Provenance) ist die Dokumentation, woher eine Änderung stammt. Bei von Agents geschriebenen Code sollte ein nützlicher Eintrag sechs Fragen beantworten:
- Welche Aufgabe die Änderung angefordert hat, mit Anforderung und Abnahmekriterien.
- Welcher Agent die Arbeit erledigt hat, und auf welchem Runtime- und Modell-Setup.
- Welcher Lauf sie erzeugt hat, mit Startzeit, Endzeit und Auslöser.
- Welcher Pull Request sie ins Repository gebracht hat.
- Wer sie geprüft hat, und was vor der Freigabe geändert wurde.
- Welche Lizenz das Repository auf diesen Code anwendet.
Die meisten Teams haben bereits Teile davon. Der Pull Request enthält den Diff und den Reviewer. Git kann strukturierte Metadaten über Commit-Trailer transportieren. Manche Coding-Agents, darunter Claude Code, fügen standardmäßig einen Co-Author-Trailer hinzu – und diese Konvention lässt sich mit eigenen Keys erweitern:
fix(auth): return 401 instead of 500 on expired refresh token

Refresh tokens past their TTL threw an unhandled TokenExpiredError
in the session middleware. Map it to a 401 with a retry hint.

Co-Authored-By: Claude <[email protected]>
Agent-Task: COIN-1287
Agent-Run: 3f9c2a71-0b4e-4c8a-9d51-6e2f4b7a1c09
Reviewed-By: Priya Shah
Human-Edits: renamed handler, added regression test
Trailer wandern mit dem Commit mit und überleben damit Repository-Umzüge. Was sie nicht festhalten können, ist der Lauf selbst: die Tool-Aufrufe, die fehlgeschlagenen Versuche, die Diskussion hinter der endgültigen Form.
Für die Lizenzverfolgung auf Dateiebene geben SPDX-Bezeichner und die REUSE-Konventionen jeder Datei einen Lizenzheader, den Tools prüfen können. Wenn Ihr Team entscheidet, dass einige generierte Assets unter CC0 herausgehen, wird diese Entscheidung genau hier überprüfbar.
Wie Sharkly die Dokumentation an der Aufgabe festhält
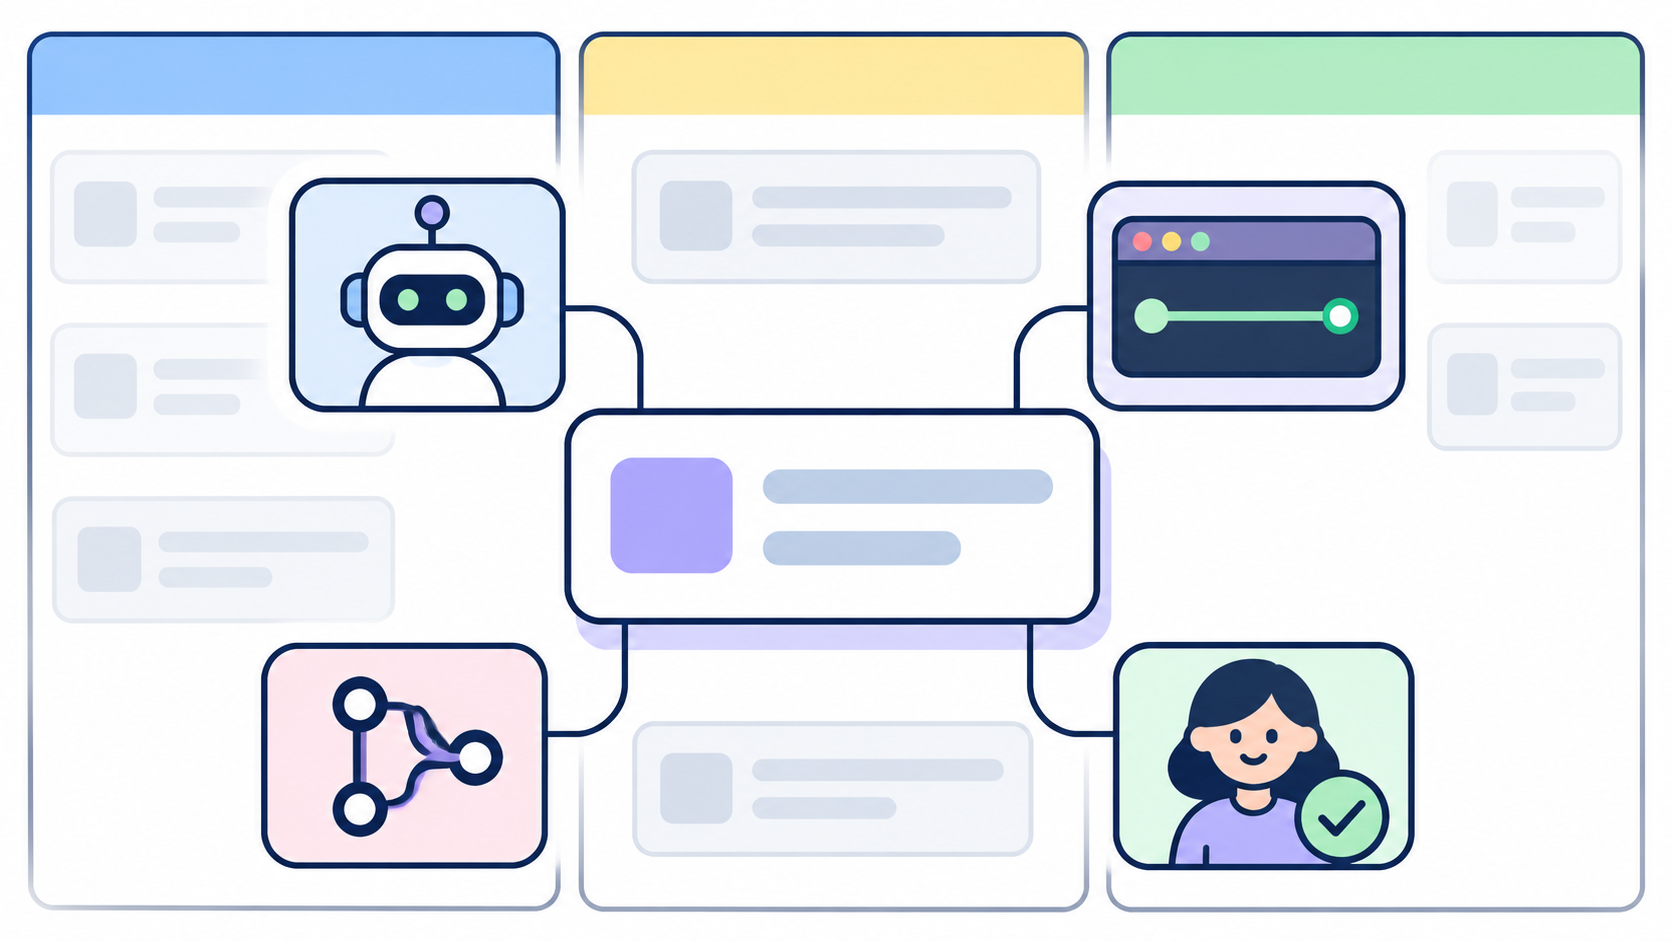
Sharkly ist ein Arbeitmanagementsystem für Menschen und Coding-Agents. Sie weisen einem Agent eine Aufgabe genauso zu wie einer Person – und die Aufgabe bleibt die gemeinsame Dokumentation für das Team.
Diese Dokumentation ist genau der Herkunftsnachweis, den den meisten Teams fehlt:
- Die Aufgabe enthält die Anforderung, den Zuständigen, Kommentare, Anhänge und eine Aktivitätszeitleiste aller Aufgabenänderungen.
- Das Ausführungsprotokoll zeigt pro Lauf, warum er eingereiht wurde, wann er startete und endete, Tool-Aufrufe und Runtime-Ereignisse, den Auslöser sowie etwaige Fehlerdetails – so beschreiben es die Dokumente zur Aufgabenausführung.
- Agent-Kommentare für das Team werden als mit dem Lauf verknüpfte Kommentare gespeichert, sodass die Erklärung direkt neben den Belegen liegt.
- Review-Signale: Ein Agent kann eine Aufgabe auf menschliche Prüfung warten lassen, wodurch sie zur verantwortlichen Person geleitet wird, statt still gemerged zu werden.
- Pull-Request-Verknüpfungen: Die GitHub-Integration verknüpft Pull Requests und synchronisiert Issues in einen Space, sodass Codeänderung und Aufgabe aufeinander verweisen.
Sharkly entscheidet nicht über Ihre Lizenz, und es ist kein Compliance-Produkt. Es hält die Fakten, von denen eine Lizenzentscheidung abhängt, an einem Ort zusammen – statt in privaten Terminal-Sitzungen.
Eine Herkunftsrichtlinie, die Sie diese Woche einführen können
Verwenden Sie die kleinste Richtlinie, die die sechs Fragen oben beantwortet. Beginnen Sie hier:
- Eine Aufgabe pro Agentenänderung. Keine Agentenarbeit ohne Task-ID. Ad-hoc-Chat ist in Ordnung zum Ausprobieren – alles, was ausgeliefert wird, bekommt eine Aufgabe.
- Task-ID in Branch und Commit eintragen. Ein Trailer oder ein Branch-Präfix reicht, um später danach suchen zu können.
- Einen namentlich genannten menschlichen Reviewer verlangen. Der Name des Reviewers landet auf Pull Request und Aufgabe, seine Änderungen werden vermerkt.
- Eine Lizenzzeile pro Repository festlegen. Entscheiden Sie, ob von Agents geschriebener Code der bestehenden Repository-Lizenz folgt (der Standard für die meisten Teams) oder etwas anderem – und halten Sie das in
CONTRIBUTING.mdfest. - Dateien mit abweichender Lizenz markieren. Verwenden Sie SPDX-Header, wenn Sie sich für CC0 oder eine andere Lizenz für generierte Assets entscheiden.
- Ausführungsprotokolle so lange aufbewahren wie Pull Requests. Wenn Sie den Review-Thread behalten würden, behalten Sie auch den Lauf, der den Diff erzeugt hat.
Für vertiefende Review-Mechaniken siehe KI-generierten Code mit Belegen auf Aufgabenebene prüfen und Freigabeschranken für Coding-Agents richtig platzieren.
Verwenden Sie eine leichte Richtlinie, wenn Agents nur interne Tools und Tests anfassen. Verwenden Sie die vollständigen sechs Schritte, wenn Agentencode an Kunden ausgeliefert wird, in regulierten Umgebungen läuft oder in einem Repository landet, das Sie bereits unter einer Open-Source-Lizenz veröffentlichen.
Sollte Ihr Team ihren von Agents geschriebenen Code als Open Source veröffentlichen?
Wahrscheinlich nicht per Standard – und nicht allein wegen dieses Threads. Die Rechtslage bewegt sich noch, der Großteil der Agenten-Outputs in einem geprüften Workflow enthält echte menschliche Beiträge, und eine pauschale CC0-Freigabe kann mehr preisgeben als beabsichtigt.
Der bessere Schritt ist, die Frage beantwortbar zu machen. Wenn ein Kunde oder Ihr Rechtsteam fragt „wie viel davon hat ein Agent geschrieben, und wer hat es geprüft“, öffnen Sie einen Eintrag und zeigen die Aufgabe, den Lauf, den Pull Request und den Reviewer.
Wenn Sie bereits Claude Code, Codex oder einen anderen Coding-Agent nutzen, verbinden Sie einen Computer mit Sharkly, weisen Sie einem Agent eine risikoarme Aufgabe zu und prüfen Sie, was der Aufgaben-Eintrag nach Abschluss des Laufs zeigt. Dieser Eintrag ist Ihr Herkunftsnachweis – ganz gleich, wie die Open-Source-Debatte ausgeht.
FAQ
Ist KI-generierter Code urheberrechtlich schützbar?
In den USA ist Code, den eine KI ohne wesentlichen menschlichen Beitrag erzeugt hat, laut dem Bericht des Copyright Office von 2025 und Thaler v. Perlmutter voraussichtlich nicht schützbar. Menschliche Auswahl, Anordnung und Bearbeitung des Outputs können dennoch geschützt sein. Andere Länder, darunter das Vereinigte Königreich, behandeln computergenerierte Werke anders.
Muss ich Code, den ein KI-Agent geschrieben hat, als Open Source veröffentlichen?
Kein Gesetz verlangt das. Der Hacker-News-Beitrag argumentiert dafür – auf ethischer Grundlage. Nicht schützbarer Code ist nicht automatisch öffentlich; Sie können ihn weiterhin privat halten.
Wer ist für Bugs in KI-generiertem Code verantwortlich?
Das Team, das ihn gemerged hat. Ein Agent kann die Änderung schreiben, aber wer den Pull Request akzeptiert hat, trägt die Verantwortung für das Ergebnis. Halten Sie diese Person in der Aufgabe und im Pull Request fest.
Wie verfolge ich, welchen Code ein KI-Agent geschrieben hat?
Verknüpfen Sie jede Agentenänderung mit einer Aufgabe, fügen Sie Task- und Run-IDs als Commit-Trailer hinzu, verknüpfen Sie den Pull Request mit der Aufgabe und dokumentieren Sie den menschlichen Reviewer. Ein Task-Board, das das Ausführungsprotokoll des Agents aufbewahrt, liefert den Rest.
Ist CC0 für KI-generierten Code sinnvoll?
Ja, für klar trennbare generierte Assets wie Fixtures oder Gerüstcode. CC0 auf gemischte Dateien anzuwenden birgt das Risiko, auch die menschlich geschriebenen Teile freizugeben – markieren Sie solche Dateien also mit SPDX-Headern, statt ganze Repositories umzulizenzieren.