
Argon oder Carbon? Führen Sie die meisten Agent-Tasks auf Gemini 4 Argon aus und übergeben Sie nur die anspruchsvollen Aufgaben an Gemini 4 Carbon. Google empfiehlt es selbst: Argon bleibt der Standard für den Großteil des Software-Engineerings, während Carbon für komplexere Arbeiten gedacht ist. Beide kosten bis zum 30. November 2026 jeweils 2 $ für den Input und 10 $ für den Output pro Million Tokens, allerdings verbraucht Carbon mehr Tokens pro Task.
TL;DR
- Standardmäßig günstig, Eskalation nur bei klaren Anzeichen. Starten Sie jeden Task auf dem schnellen Modell. Eskalieren Sie nur dann, wenn eine überprüfbare Regel die Aufgabe als schwierig einstuft oder sie bereits einmal fehlgeschlagen ist.
- Gleicher Token-Preis bedeutet nicht gleicher Preis pro Task. Carbon liest mehr, denkt länger nach und verifiziert gründlicher – daher verbraucht ein einzelner Task mehr Tokens.
- Vier Signale weisen auf einen schwierigen Task hin: langer Zeithorizont, viele Dateien, sicherheitsrelevante Auswirkungen und ein fehlgeschlagener erster Durchlauf.
- Messen Sie zwei Kennzahlen pro Task: Kosten und Erfolgsquote beim Review. Steuern Sie das Routing anhand dieser Werte, nicht nach Leaderboards.
- Machen Sie das Modell zu einer festen Einstellung, nicht zu einer Einzelfallentscheidung bei jedem Prompt. In Sharkly verfügt jeder Agent über ein Standardmodell, das Sie bei der Zuweisung eines Tasks für einen einzelnen Durchlauf überschreiben können.
Warum „Welches Modell ist das beste?“ die falsche Frage ist
Gemini 4 Carbon wurde am 10. November 2026 unter der Modell-ID gemini-4-carbon allgemein verfügbar (GA). Googles Release-Beitrag tut etwas, was Ankündigungen nur selten tun: Er rät davon ab, das neueste Modell für den Großteil der Aufgaben zu verwenden: „Argon bleibt die ideale Wahl für den Großteil des Software-Engineerings und der Wissensarbeit.“
Carbon hingegen ist laut demselben Beitrag „für Aufgaben konzipiert, die die Grenzen der Modellintelligenz austesten“, und nutzt „mehr Tokens als Argon, um Probleme gründlich zu analysieren, tiefgehender nachzudenken und erweiterte Verifikationsschleifen zu durchlaufen“.
Dieser Ansatz passt genau dazu, wie Teams Agenten einsetzen. Es gibt eine Warteschlange von Tasks mit unterschiedlichem Schwierigkeitsgrad, und jeder Task sollte vom günstigsten Modell erledigt werden, das das Review besteht. Ein einziges „bestes Modell“ für das gesamte Team ist bei einfachen Tasks reine Geldverschwendung und bei schwierigen Aufgaben schlicht überfordert.
Wenn Sie sich zuerst einen vollständigen Überblick über Carbon verschaffen möchten, beschreibt unser Beitrag Gemini 4 Carbon für Coding-Agenten die Details, während der Leitfaden zu Gemini 4 Argon das Standardmodell vorstellt.
Die Routing-Regel: Standardmäßig günstig, Eskalation bei schwierigen Aufgaben
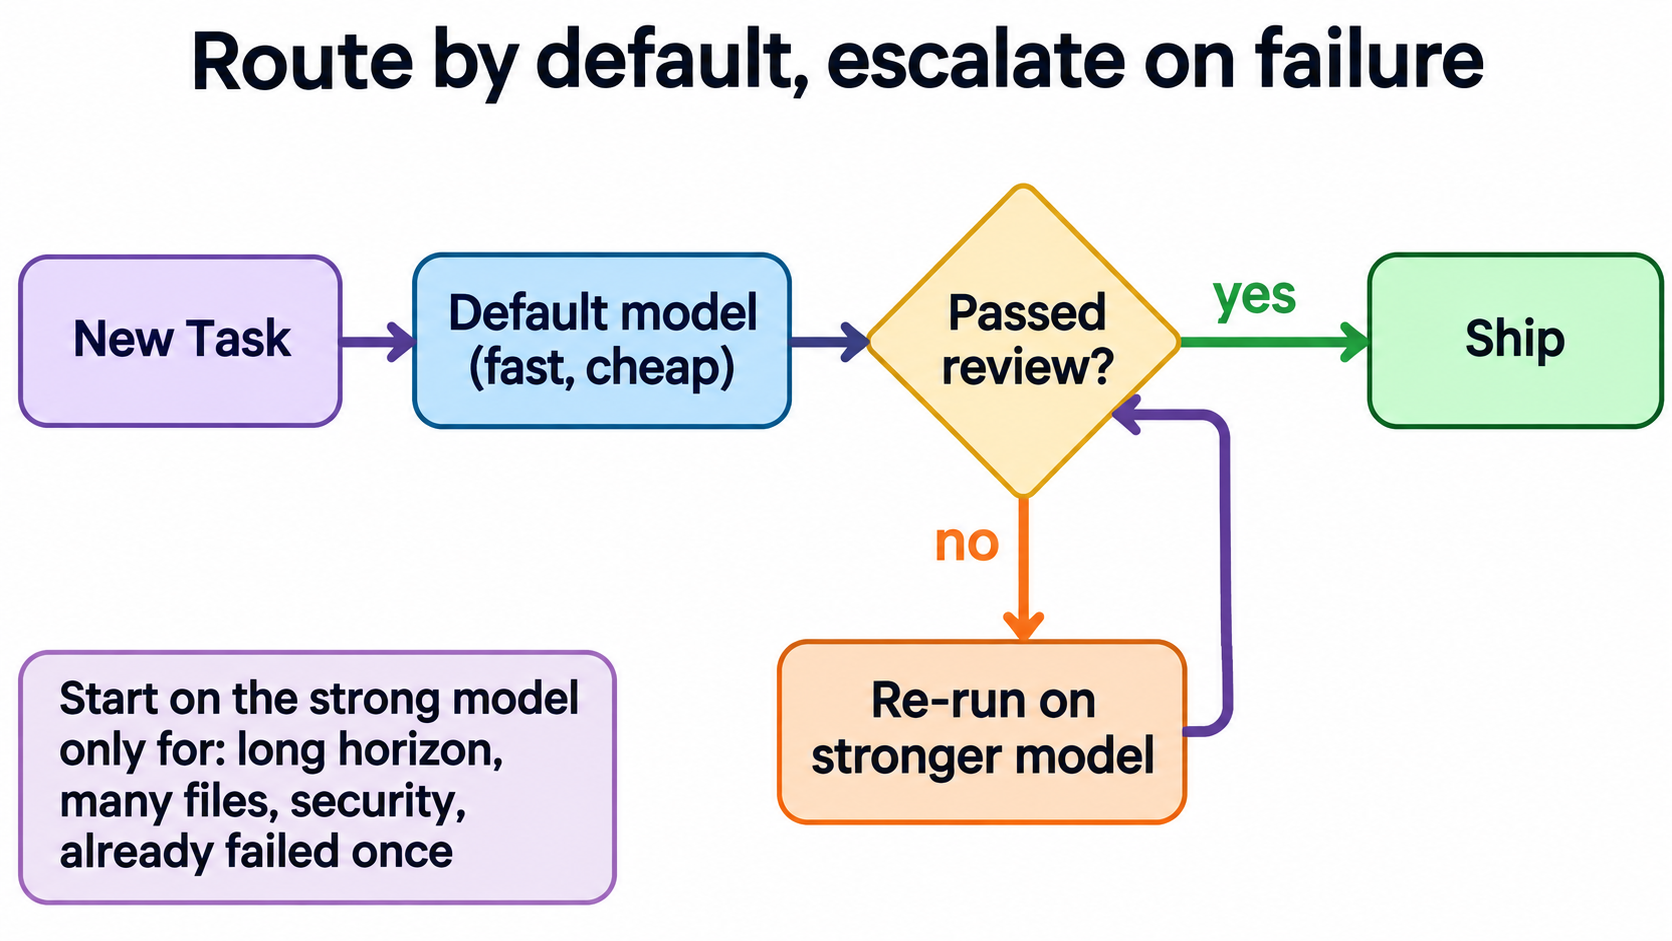
Modell-Routing für Coding-Agenten bedeutet, das Modell pro Task statt pro Team auszuwählen. Die Regel lässt sich in einem Satz zusammenfassen: Jeder Task beginnt auf dem Standardmodell und wechselt erst dann zum leistungsstärkeren Modell, wenn ein definiertes Signal auf eine hohe Komplexität hinweist oder das Standardmodell bereits daran gescheitert ist.
Zwei Faktoren sorgen dafür, dass diese Regel funktioniert:
- Ein Standardmodell, das schnell und für die meisten Tasks gut genug ist. Für Teams, die auf Gemini setzen, ist das laut Googles eigener Empfehlung Argon.
- Ein Eskalationspfad mit eindeutig nachvollziehbaren Auslösern. „Das fühlte sich schwierig an“ ist kein verlässlicher Auslöser. „Berührt Authentifizierungscode“ hingegen schon.
Wann ein Task als schwierig gilt
Es braucht klare Signale, die sich bereits vor der Ausführung eines Tasks ablesen lassen. Die folgenden vier Kriterien decken die meisten Fälle ab:
Langer Zeithorizont
Ein Task, der viele aufeinanderfolgende Schritte erfordert – wie etwa eine Migration mit zehn voneinander abhängigen Änderungen –, erhöht das Risiko, dass ein schwächeres Modell vom Kurs abkommt. Genau hier greifen die zusätzlichen Verifikationsschleifen von Carbon. Das Signal: Die Task-Beschreibung umfasst mehr als fünf Schritte oder ein früherer Durchlauf einer ähnlichen Aufgabe hat das Zeitbudget überschritten.
Viele Dateien
Querschnittliche Änderungen erfordern, dass das Modell größere Teile der Codebasis gleichzeitig im Kontext behält. Das Signal: Die Änderung betrifft mehrere Packages oder mehr als zehn Dateien.
Sicherheitsrelevanz
Authentifizierung, Zahlungsabwicklung, Secrets-Handling und Berechtigungsprüfungen verzeihen keine selbstbewusst vorgetragenen Fehler. Laut Googles Release-Beitrag führt Carbon sowohl in SEC-bench Pro als auch in CWE-bench v1, wenn der Zugriff über das Fairwind Program für Cybersicherheitsexperten erfolgt. Das Signal: Der Task betrifft einen Pfad, der als sensibel markiert ist.
Bereits einmal fehlgeschlagen
Dies ist das einfachste und ehrlichste Signal: Wenn der Durchlauf des Standardmodells das Review nicht bestanden hat, liegt der direkte Beweis vor, dass der Task dessen Fähigkeiten übersteigt. Führen Sie den Task mit den Anmerkungen des Reviewers erneut auf dem stärkeren Modell aus.
Eine Routing-Tabelle für den Einstieg
Nutzen Sie diese Übersicht als ersten Entwurf und passen Sie sie nach zwei Wochen anhand Ihrer eigenen Erfolgsquoten an.
| Task-Typ | Starten mit | Eskalieren auf | Begründung |
|---|---|---|---|
| Tippfehler, Textanpassungen, Dependency-Updates | Fast-Tier (ein Flash- oder Mini-Modell) | Argon | Kleiner Diff, einfach zu reviewen |
| Bugfix mit fehlschlagendem Test | Argon | Carbon | Test liefert klares Erfolgs- oder Fehlersignal |
| Feature in einem einzelnen Modul | Argon | Carbon | Googles empfohlener Standard für die meiste Entwicklungsarbeit |
| Refactoring über viele Dateien hinweg | Carbon | Fable 5.2 oder manuell durch Entwickler | Langer Zeithorizont, viele Dateien |
| Authentifizierung, Zahlungen, Berechtigungen | Carbon | Immer manuelles Review | Sicherheitsrelevanz |
| Jeder Task, der das Review einmal nicht bestanden hat | Eine Stufe höher | Manuell durch Entwickler | Fakten schlagen Vermutungen |
Claude Fable 5.2 liegt bei 8 $ für den Input und 40 $ für den Output pro Million Tokens – das Vierfache des Einführungspreises von Carbon. Es fungiert daher als letzte automatisierte Eskalationsstufe über Carbon und nicht als Standard. Carbons eigener Preis steigt laut einer Fußnote von Google nach dem 30. November 2026 auf 4 $ bzw. 20 $, wodurch sich diese Lücke verringert. Prüfen Sie die aktuellen Zahlen auf der Preisseite der Gemini-API, bevor Sie Budgets festlegen.
Eskalation bei Fehlern, nicht auf Verdacht
Teams neigen dazu, alles, was „schwierig klingt“, vorab an das stärkste Modell zu leiten. Das fühlt sich zwar sicher an, geht aber ins Geld – denn viele dieser Tasks hätte auch das Standardmodell problemlos bewältigt.
Bei einer Eskalation im Fehlerfall fallen zunächst nur die Kosten des kleineren Modells für jeden Task an – und die Kosten des großen Modells nur dort, wo es nachweislich erforderlich war. Ein fehlgeschlagener günstiger Durchlauf kostet oft weniger als ein einziger unnötiger teurer Durchlauf.
Zwei Ausnahmen bestätigen diese Regel, die bereits in der obigen Tabelle berücksichtigt sind: Sicherheitsrelevante Aufgaben beginnen direkt auf der höheren Stufe, da ein fehlerhafter erster Durchlauf unbemerkt gemergt werden könnte, falls das Review ihn übersieht. Umfangreiche Refactorings über viele Dateien starten ebenfalls direkt oben, da ein fehlgeschlagener Versuch hier eine Stunde statt einer Minute kostet.
Ein fehlgeschlagener Durchlauf liefert allerdings nur dann Erkenntnisse, wenn das Review den Fehler auch bemerkt. Da Modelle Tests austricksen können, sollte die Eskalation mit den Prüfungen aus unserem Beitrag Wie man Coding-Agenten beim Schummeln bei Tests ertappt kombiniert werden.
Kosten und Erfolgsquote pro Task messen
Routing ohne verlässliche Zahlen verkommt schnell zur Bauchentscheidung. Tracken Sie daher für jeden Task zwei Kennzahlen:
- Kosten pro Task: Input- und Output-Tokens multipliziert mit dem Preis des jeweiligen Modells, summiert über alle Durchläufe des Tasks einschließlich fehlgeschlagener Versuche.
- Erfolgsquote beim Review: Wurde der erste Durchlauf direkt abgenommen oder war ein erneuter Lauf bzw. ein manueller Eingriff erforderlich?
Daraus ergibt sich die entscheidende Kennzahl: Die Kosten pro akzeptierter Änderung bestimmen das Routing. Ein günstiges Modell, das in der Hälfte der Fälle scheitert, kann unterm Strich teurer sein als ein starkes Modell, das die Aufgabe auf Anhieb löst – genau dies ist die Kernüberlegung in Wann günstigere Modelle mehr kosten.
Daten von Drittanbietern stützen dieses Bild: Laut Artificial Analysis kostete die Ausführung des Intelligence Index 7,76 $ auf Gemini 4 Carbon (high) und 26,54 $ auf Claude Fable 5.2 (max), wobei Fable einen Wert von 65 gegenüber 60 bei Carbon erzielte. Ein Vorsprung von fünf Punkten bei den 3,4-fachen Kosten lohnt sich nur für jene Tasks, bei denen diese fünf Punkte den Ausschlag geben.
Ein einfaches Protokoll reicht für den Anfang völlig aus:
task       model          runs  tokens_in  tokens_out  cost_usd  passed_first
COIN-212   gemini-4-argon    1     48,000      9,500      0.19   yes
COIN-213   gemini-4-argon    2    121,000     22,000      0.46   no
COIN-213   gemini-4-carbon   1    210,000     41,000      0.83   yes
Hier scheiterte COIN-213 zunächst auf Argon, wurde eskaliert und auf Carbon erfolgreich abgeschlossen. Insgesamt kostete der Task 1,29 $, und dieser Eintrag zeigt auf, ob ähnliche Tasks beim nächsten Mal direkt auf Carbon starten sollten.
Routing pro Task auf dem Board umsetzen
Die Regel klingt simpel, lässt sich aber schwer einhalten, wenn Entwickler das Modell jeweils eigenmächtig im Terminal auswählen. Verankern Sie das Routing daher dort, wo die Tasks verwaltet werden.
Jedem Agenten ein festes Modell zuweisen
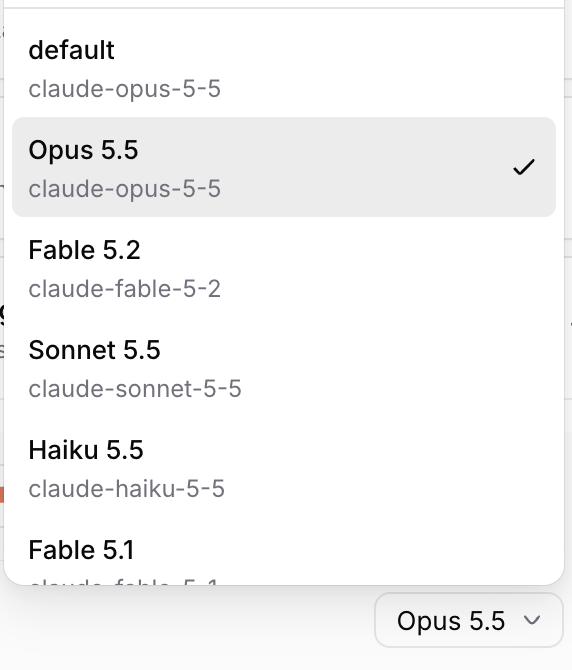
In Sharkly übernimmt ein Agent standardmäßig das Modell seiner Runtime. Über die Zeile „Model“ in den Agent-Einstellungen lässt sich jedoch ein anderes Modell aus dem Katalog dieser Runtime wählen – inklusive Thinking-Tiefe, sofern das Modell dies unterstützt. Die Agent-Dokumentation beschreibt die Details. So erhalten Sie einen Agenten pro Stufe: einen Standard-Agenten auf dem schnellen Modell und einen Eskalations-Agenten auf dem starken Modell.
Einen einzelnen Durchlauf eskalieren
Beim Zuweisen eines Tasks kann das Modell für diesen konkreten Durchlauf ausgewählt und so der Standard des Agenten für diesen Einzelfall überschrieben werden. Das ermöglicht die Eskalation im Fehlerfall in einem einzigen Schritt: Der Reviewer weist den Task zurück, und der erneute Durchlauf startet auf Carbon – ohne den Agenten zu verändern, den alle anderen Teammitglieder nutzen.
Alle Daten an einem zentralen Ort bündeln
Jeder Durchlauf behält sein Ausführungsprotokoll, sodass Ihre Tabelle zu Kosten und Erfolgsquoten auf tatsächlich abgeschlossenen Tasks basiert und nicht auf vagen Schätzungen. Wie sich Arbeit in Crews nach Rollen statt nach Schwierigkeit aufteilen lässt, beschreibt der Artikel Modell-Routing für Agent-Crews. Zum Thema Governance erläutert Wer stoppt deine Agenten? die Kontrollmechanismen, die in der Hand Ihres Teams bleiben. Der Einstieg in Sharkly ist kostenlos.
Alternativen zum taskbasierten Routing
- Ein Modell für alles: Für Einzelentwickler völlig ausreichend, bei stark variierenden Tasks jedoch ineffizient.
- Ein automatisches Router-Modell: Ein vorgeschaltetes kleines Modell klassifiziert jeden Prompt und wählt das Zielmodell aus. Dies macht die Entscheidung jedoch intransparent und kann ein fehlgeschlagenes Review nicht berücksichtigen.
- Agenten-Team-Modi: Googles Vorschau auf /swarm in Antigravity setzt Carbon für Planung und Audits ein, während leichtere Modelle parallel arbeiten. Dies entspricht einem rollenbasierten Routing innerhalb eines Auftrags und ergänzt das taskbasierte Routing optimal.
Fazit
Google hat die Routing-Regel im eigenen Release-Beitrag vorgegeben: Argon als Standard, Carbon nur dann, wenn der Task es rechtfertigt. Definieren Sie Ihre vier Signale für komplexe Tasks, starten Sie alles andere auf dem günstigen Modell, eskalieren Sie bei einem fehlgeschlagenen Review und erfassen Sie Kosten sowie Erfolgsquote pro Task. Nach zwei Wochen liefern Ihnen Ihre eigenen Zahlen eine weitaus präzisere Routing-Tabelle als jeder Benchmark.
Nächster Schritt: Richten Sie zwei Agenten in Sharkly ein – einen mit dem Standardmodell und einen mit dem Eskalationsmodell – und leiten Sie die Tasks dieser Woche über diese beiden Agenten.
FAQ
Sollte ich Gemini 4 Carbon oder Argon für Coding-Agenten verwenden?
Verwenden Sie Argon für die meisten Tasks und Carbon für anspruchsvolle Aufgaben. Laut Googles Release-Beitrag bleibt Argon „die ideale Wahl für den Großteil des Software-Engineerings“, während Carbon für Tasks gedacht ist, die die Grenzen eines Modells ausreizen.
Ist Gemini 4 Carbon teurer als Argon?
Auf Token-Ebene nicht: Beide kosten bis zum 30. November 2026 jeweils 2 $ für den Input und 10 $ für den Output pro Million Tokens. Pro Task in der Regel schon, da Carbon laut Google mehr Tokens für die gründliche Analyse und Verifikation beansprucht.
Wie entwickeln sich die Preise für Gemini 4 Carbon nach dem 30. November?
Laut einer Fußnote von Google läuft der Einführungspreis am 30. November 2026 aus; danach steigt der Preis für Carbon auf 4 $ pro Million Input-Tokens und 20 $ pro Million Output-Tokens.
Was versteht man unter Modell-Routing für KI-Agenten?
Modell-Routing bedeutet, das jeweilige Modell passend zum Schwierigkeitsgrad des Tasks auszuwählen – mit dem Ziel, die geringsten Kosten pro abgenommener Änderung zu erzielen.
Wann sollte ein Task auf ein stärkeres Modell eskaliert werden?
Eskalieren Sie, wenn der Task einen langen Zeithorizont hat, viele Dateien betrifft, sicherheitsrelevanten Code berührt oder das Review auf dem Standardmodell bereits nicht bestanden hat.
Kann ich in Sharkly für jeden Agenten ein eigenes Modell festlegen?
Ja. Jeder Agent besitzt in seinen Einstellungen die Zeile „Model“, über die sich ein Modell aus dem Katalog der Runtime auswählen lässt. Zudem können Sie das Modell beim Zuweisen eines Tasks für einen einzelnen Durchlauf überschreiben.


