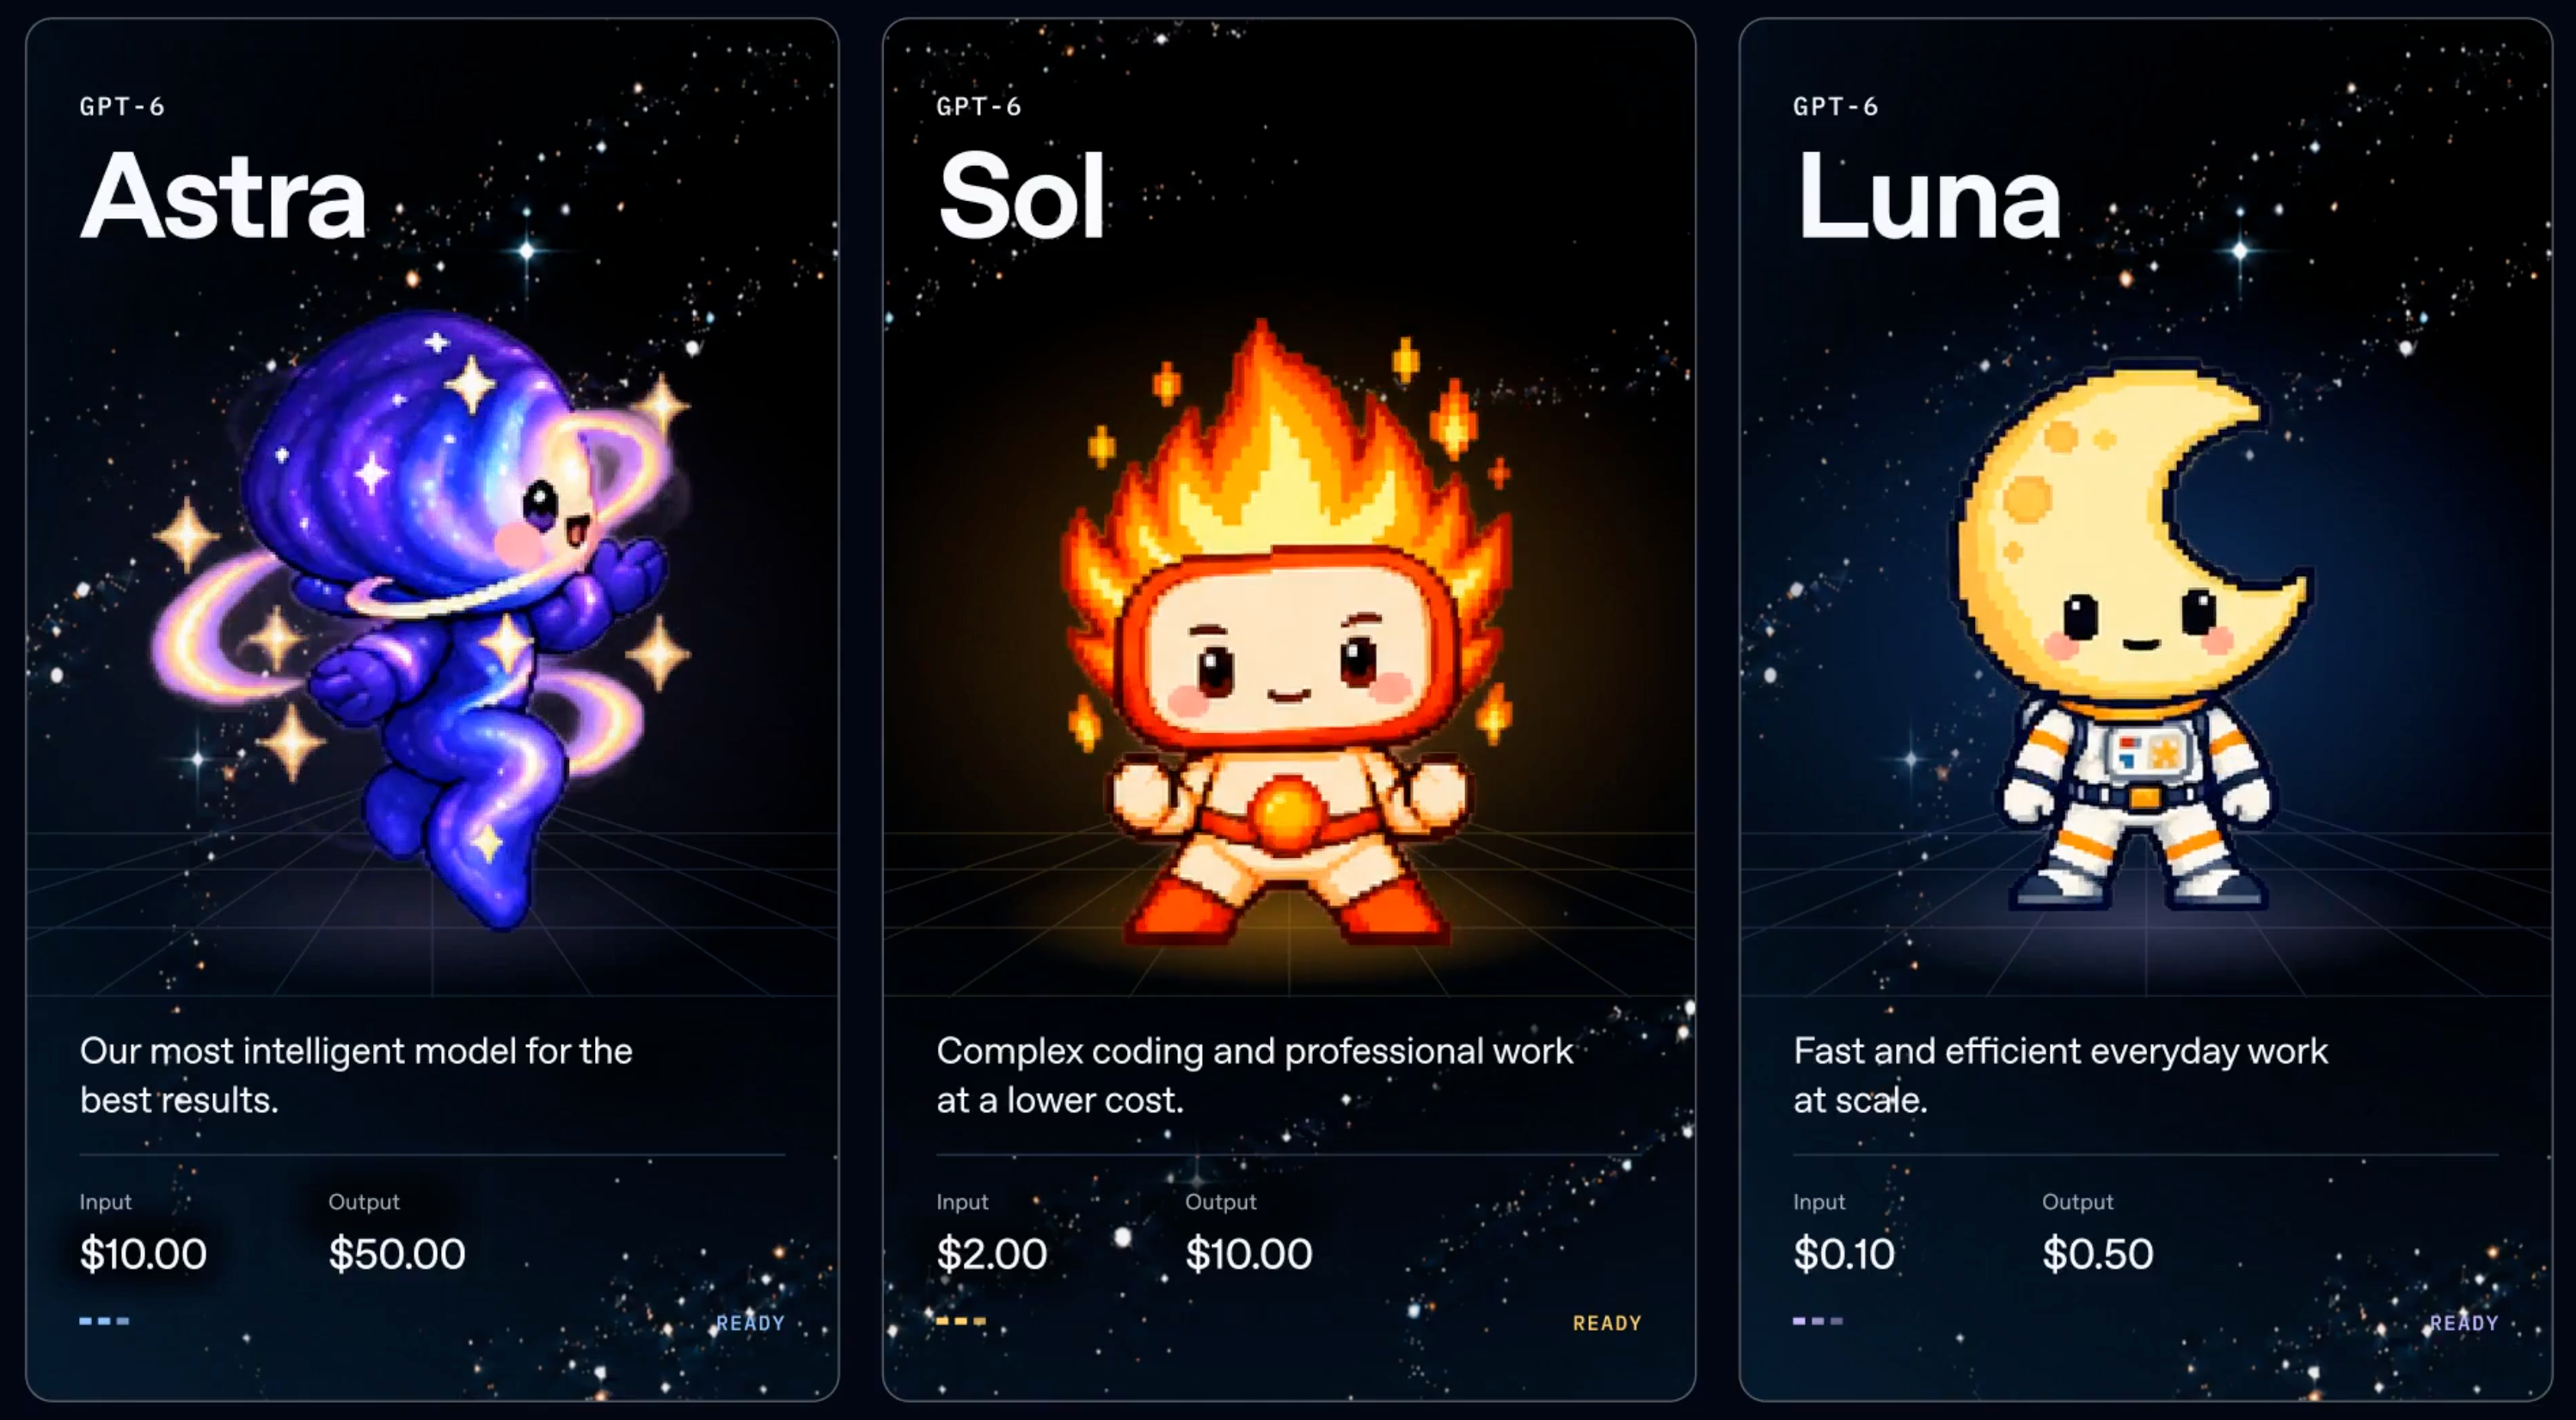
Die Rechnung ist die Zahl, die sich am leichtesten nach unten drücken lässt – und die am wenigsten aussagt. Wenn Sie die Routineaufgaben Ihrer Crew an GPT-6 Luna für 0,10 $ und 0,50 $ pro Million Token übergeben, brechen die Modellkosten innerhalb eines Tages ein. Zwei Wochen später ist die Rechnung immer noch verschwindend gering, das Board zählt mehr abgeschlossene Durchläufe als je zuvor – und die vier Änderungen vom letzten Dienstag warten noch immer darauf, dass sie jemand abnimmt.
Es ist nichts schiefgegangen. Sie haben die Kosten lediglich von einem Posten, den Sie im Blick hatten, auf einen verlagert, den niemand beziffert.
Die Kosten pro abgenommener Änderung umfassen das gesamte Budget und die menschliche Arbeitszeit für jeden einzelnen Versuch, der letztlich zu einer von einer Person akzeptierten Änderung geführt hat. Darin enthalten sind gescheiterte Durchläufe, Output, der nie gemergt wurde, und jede Minute, die jemand investiert hat, um über beides zu entscheiden. Kein Anbieter nennt diese Zahl, kein Benchmark misst sie – und doch ist sie die einzige Kennzahl, die sich im Gleichschritt mit dem bewegt, was Ihr Team tatsächlich ausliefert.
Das Wichtigste in Kürze
Ein günstigeres Modell senkt den Preis pro Versuch – treibt aber drei Faktoren in die Höhe, die mit der Aufmerksamkeit von Reviewern bezahlt werden: Versuche pro ausgelieferter Änderung, Output pro Versuch und Entscheidungen pro ausgelieferter Änderung. Aufmerksamkeit ist am 22.09.2026 nicht billiger geworden. Die Budget-Klasse ist überall dort wirklich günstiger, wo eine Maschine entscheidet, ob ein Versuch bestanden hat; sie wird jedoch heimlich teuer, sobald ein Mensch eingreifen muss. Agenten recherchieren, führen aus, testen und berichten. Menschen geben die Richtung vor, erteilen Freigaben und nehmen das Ergebnis ab. Die Lösung liegt nicht im Routing, sondern in der Kostenrechnung: Messen Sie Versuche und menschliche Arbeitsminuten pro abgenommener Änderung und Runtime. Machen Sie Arbeit, die auf Freigabe wartet, zu einem messbaren Status – statt zu einem diffusen Frustgefühl am Freitagnachmittag.
Drei Kennzahlen – und nur eine davon zählt für Sie
| Einheit | Wer sie nutzt | Was sie aussagt | Was sie verschweigt |
|---|---|---|---|
| Pro Million Token | Preisseiten der Anbieter | Was Input und Output kosten | Wie viele Token Ihre Aufgabe erfordert |
| Pro abgeschlossener Aufgabe | Benchmark-Tabellen | Die Kosten für einen bewerteten Versuch | Fehlversuche, Ihre Codebasis, das Review |
| Pro abgenommener Änderung | Ihr Team | Was eine ausgelieferte Änderung End-to-End gekostet hat | Nichts – und genau deshalb veröffentlicht sie niemand |
Beide KI-Labore sind am 22.09.2026 an den Start gegangen, und beide veröffentlichen Zahlen aus der mittleren Spalte. Lesen Sie diese Tabellen keinesfalls so, als stünden dort die Werte aus der rechten Spalte.
Was die Budget-Klasse kostet und wie sie abschneidet
| GPT-6 Luna | GPT-6 Sol | Claude Opus 5.5 | |
|---|---|---|---|
| API id | gpt-6-luna |
gpt-6-sol |
claude-opus-5-5 |
| Input / Output pro 1M | $0.10 / $0.50 | $2 / $10 | $4 / $20 |
| Cached Input | 90% Rabatt auf Reads | 90% Rabatt auf Reads | $0.20 Read, $5 Write |
| Kontext | 1M | 872k | 1M |
| DeepSWE 1.1 bei maximalem Reasoning | 66.6% | 68.8% | Nicht in den Launch-Unterlagen |
| Artificial Analysis Index | 37 | 48 | 58, Platz 1 von 212 |
Anthropic gibt für Opus 5.5 auf AutomationBench 40,0 % an. OpenAI meldet für Sol bei extra hohem Reasoning auf AutomationBench 1.0.6 einen Wert von 33,2 % bei 0,27 $ pro Aufgabe. Zwei Labore, zwei Testumgebungen, jeweils ein veröffentlichter Preis pro Aufgabe. Diese Werte lassen sich schlicht nicht direkt vergleichen – und genau darum geht es: Keine Tabelle eines Anbieters verrät Ihnen die Kosten pro abgenommener Änderung.
Erster versteckter Faktor: Versuche pro abgenommener Änderung
OpenAI beziffert Luna bei maximalem Reasoning auf 66,6 % bei DeepSWE 1.1 und Sol im Maximum auf 68,8 %. Rein rechnerisch bleibt damit bei Luna rund jeder dritte Versuch ohne erfolgreiches Ergebnis. Ihre Codebasis ist nicht DeepSWE und Ihre Erfolgsquote wird anders aussehen, doch das Grundmuster bleibt bestehen: Ein günstiges Modell mit wenigen Prozentpunkten Rückstand ist nicht einfach pro Durchlauf minimal schlechter – die Wahrscheinlichkeit steigt spürbar, dass Sie ein Ergebnis erhalten, das eine Ehrenrunde drehen muss.
Die reinen Modellkosten für diese Extrarunde bleiben vernachlässigbar. OpenAI gibt an, dass Luna bei maximalem Reasoning im selben Benchmark 93 % günstiger pro Aufgabe ist als Claude Opus 5. Verdoppeln Sie die Anzahl der Versuche, sind Sie nach unserer Rechnung immer noch rund 86 % günstiger. Die API-Rechnung des Modells ist also nie das Problem.
Ein gescheiterter Versuch ist jedoch nirgendwo sonst kostenlos: Er hinterlässt einen Branch, eine Änderungsübersicht und eine Entscheidung, die ein Mensch fällen muss. Ein fehlgeschlagener Durchlauf ist keine Nullnummer. Er ist ein Review-Vorgang, an dessen Ende kein Code steht.
Zweiter versteckter Faktor: Günstige Modelle punkten durch längere Denkzeit
Schauen Sie sich genau an, wie Lunas gute Werte zustande kommen. Die 66,6 % werden bei maximalem Reasoning erzielt, und OpenAI merkt zur Faktentreue an, dass Luna bei höherem Aufwand mit GPT-5.6 Sol mithält – zu etwa einem Hundertstel der Kosten. Die Budget-Klasse erreicht akzeptable Qualität also nur durch höheren Arbeitsaufwand, und dieser schlägt sich in Output-Tokens und Laufzeit nieder.
Artificial Analysis, ein unabhängiger Dritter, misst für die Varianten mit maximalem Reasoning bei Luna 153,9 Output-Token pro Sekunde bei einer Time-to-First-Token von 124,23 Sekunden, während Sol auf 115,2 Token pro Sekunde bei 102,15 Sekunden kommt. Betrachten Sie diese Zahlen als Richtwerte: Sie stammen von Dritten, beziehen sich speziell auf die Maximal-Varianten und verändern sich bei jeder Neumessung.
Für Ihr Team – nicht für Ihre Rechnung – ergeben sich daraus zwei spürbare Folgen: Ein Durchlauf, der zwei Minuten lang stumm bleibt, wirkt wie abgestürzt, also schaut jemand nach. Und ein längerer Trace mit einem umfangreicheren Diff erfordert pro Versuch schlicht mehr Leseaufwand, bevor überhaupt jemand an eine Freigabe denken kann. Zeit zum Lesen ist die knappste Ressource – und Sie haben gerade mehr von dem eingekauft, was genau diese Ressource verbraucht.
Dritter versteckter Faktor: Entscheidungen statt Diffs
Zählen Sie einmal die menschlichen Entscheidungen zwischen der Zuweisung einer Aufgabe und der Abnahme einer Änderung. Bei einer leistungsfähigen Runtime gibt es meist nur einen Pfad: Code prüfen, freigeben. Bei einer günstigen Runtime, die nicht automatisierbar verifizierbare Aufgaben bearbeitet, verzweigt sich dieser Pfad – und jeder Abzweig erfordert einen Menschen:
- Der Durchlauf ist fehlgeschlagen. Auf derselben Runtime erneut versuchen oder an eine stärkere eskalieren?
- Die Tests sind durchgelaufen, aber der Ansatz gefällt Ihnen nicht. Abnehmen oder zur Überarbeitung zurückschicken?
- Der Durchlauf hat drei Teilergebnisse geliefert. Welches davon ist die eigentliche Änderung?
- Der Prozess stoppt mit einer Rückfrage. Wer antwortet, und wo wird die Antwort festgehalten?
Nichts davon taucht auf der Token-Abrechnung auf. Aber alles landet im Kalender derjenigen, die das Code-Review durchführen müssen.
Die Formel mit Ihren eigenen Zahlen
cost per accepted change
  = attempts per accepted change
      x (model cost per attempt + reviewer minutes per attempt x loaded cost per minute)
  + escalation cost when the cheap tier hands the job back
Setzen Sie hier Ihre eigenen Zahlen ein, nicht unsere. Bei 0,10 $ und 0,50 $ pro Million Token tendieren die Modellkosten in der Klammer praktisch gegen null. Die Gesamtkosten werden daher fast ausschließlich von den Arbeitsminuten der Reviewer multipliziert mit der Anzahl der Versuche bestimmt. Der Wechsel zu einer billigeren Runtime verringert einen Kostenpunkt, der ohnehin winzig war, und vervielfacht den, der wirklich ins Gewicht fällt. Manchmal rechnet sich das trotzdem. Aber das ist eine Rechnung, die Sie unmöglich anhand einer Preisseite aufstellen können.
Wann die Budget-Klasse wirklich günstiger ist
Setzen Sie eine günstige Runtime dann ein, wenn eine Maschine entscheiden kann, ob der Versuch erfolgreich war. Typecheck, Unit-Tests, Build-Pipelines, Linter-Regeln, Schema-Validierungen: Das Urteil steht fest, noch bevor ein Mensch Zeit investieren muss. Zusätzliche Versuche fängt das Test-Framework auf, nicht Ihr Feierabend. Das betrifft den Großteil der täglichen Arbeitslast in einer produktiven Crew und ist das stichhaltigste Argument dafür, die routinemäßigen 80 % der Aufgaben an Luna zu delegieren.
Verwenden Sie keine günstige Runtime, wenn die Abnahme ein menschliches Urteil erfordert: Architekturentscheidungen, Datenmigrationen, alles Sicherheitsrelevante oder Aufgaben, bei denen die Frage „Stimmt das so?“ nicht per Befehl beantwortet werden kann. An dieser Stelle verwandelt sich der Qualitätsunterschied eins zu eins in Review-Minuten. Das Wirtschaftlichste, was Sie kaufen können, ist ein Versuch, den Sie nur ein einziges Mal lesen müssen.
Definieren Sie klare Eskalationsregeln, statt sich auf das Bauchgefühl zu verlassen – denn gegen einen günstigeren Preis zieht das Bauchgefühl jedes Mal den Kürzeren. Modell-Routing sollte sich in erster Linie an der Überprüfbarkeit orientieren und erst in zweiter Linie an den Kosten.
Warum Ihnen kein Anbieter die Wahrheit sagt
Beide Labore haben am selben Tag Vergleichstests gegeneinander veröffentlicht. Als Referenz wählte OpenAI Claude Opus 5 – nur Stunden bevor Anthropic das Modell durch Opus 5.5 ablöste. Die günstige Modellreihe jedes Anbieters dient vor allem als Einstieg in den eigenen Vertriebstrichter. Keiner wird je den Satz drucken: „Unser Budget-Modell kostet Ihre Reviewer eine Extra-Schleife.“ Und es ist den Anbietern nicht einmal vorzuwerfen: Die tatsächliche Zahl hängt von Ihrer Codebasis und Ihrem Team ab.
Sharkly verkauft keine Modell-Token. Die Nutzung läuft über Ihre eigenen Abonnements oder API-Schlüssel in den Tools, die Ihr Team ohnehin nutzt – für uns macht es keinen Unterschied, für welche Runtime Sie sich entscheiden. Nur aus dieser unabhängigen Position heraus lässt sich diese Argumentation ehrlich führen. Und genau deshalb sollte Ihr Workflow das nächste günstige Modell problemlos überstehen, ohne dass Sie alles neu aufsetzen müssen.
Was stattdessen auf Ihr Dashboard gehört
Menschliche Arbeitsminuten pro abgenommener Änderung, aufgeschlüsselt nach Runtime. Steigt dieser Wert nach einem Modellwechsel, ist das vermeintlich günstigere Modell unterm Strich teurer – und Sie haben den handfesten Beweis schwarz auf weiß. Die Kosten in Dollar pro Durchlauf beantworten eine Frage, die seit dem 22.09.2026 keine Relevanz mehr hat.
Versuche pro abgenommener Änderung, aufgeschlüsselt nach Runtime. Dieser Faktor entscheidet über alles andere, und kein Anbieter kann ihn für Sie ermitteln. Sie erhalten ihn nur, indem Sie erfassen, welche Runtime welchen Versuch für eine konkrete Aufgabe erzeugt hat.
„Wartet auf Freigabe“ als eigenständiger Status. Wenn Ausführung, Blocker, Ergebnisse und Folgefragen direkt in die Timeline der jeweiligen Aufgabe zurückfließen, wird der Rückstau menschlicher Reviews zählbar statt zur reinen Anekdote. Verlangen Sie, dass jeder Durchlauf mit den entsprechenden Nachweisen geliefert wird:
Before a run reaches a person, the Task carries:
- the change summary
- typecheck, test, and build results
- known limits and what was not attempted
- the attempt number and which Runtime produced it
Im kleinen Rahmen brauchen Sie diesen Aufwand nicht. Wenn eine Person zwei Agenten betreut und die Ergebnisse noch am selben Nachmittag prüft, bleiben Sie dabei: Zusätzliche Statuswerte und Warteschlangen verwalten sonst nur ein Problem, das Sie noch gar nicht haben. Die genaue Erfassung wird in dem Moment unverzichtbar, in dem niemand mehr aus dem Kopf sagen kann, wie viele fertige Durchläufe gerade auf Abnahme warten.
Der Teil, der nicht günstiger geworden ist
Zwei Labore haben am selben Tag den Preis pro Versuch drastisch gesenkt. Keines von beiden hat jedoch eine Lösung ausgeliefert, die Ihnen das Lesen eines Diffs abnimmt – und die Verantwortung für die Änderung liegt nach wie vor bei einem Menschen. Ein billigeres Modell bedeutet keinen billigeren Workflow. Es bedeutet lediglich einen billigeren Versuch – und diese Versuche fließen in einen Prozess, dessen teuerster Schritt die menschliche Prüfung ist.
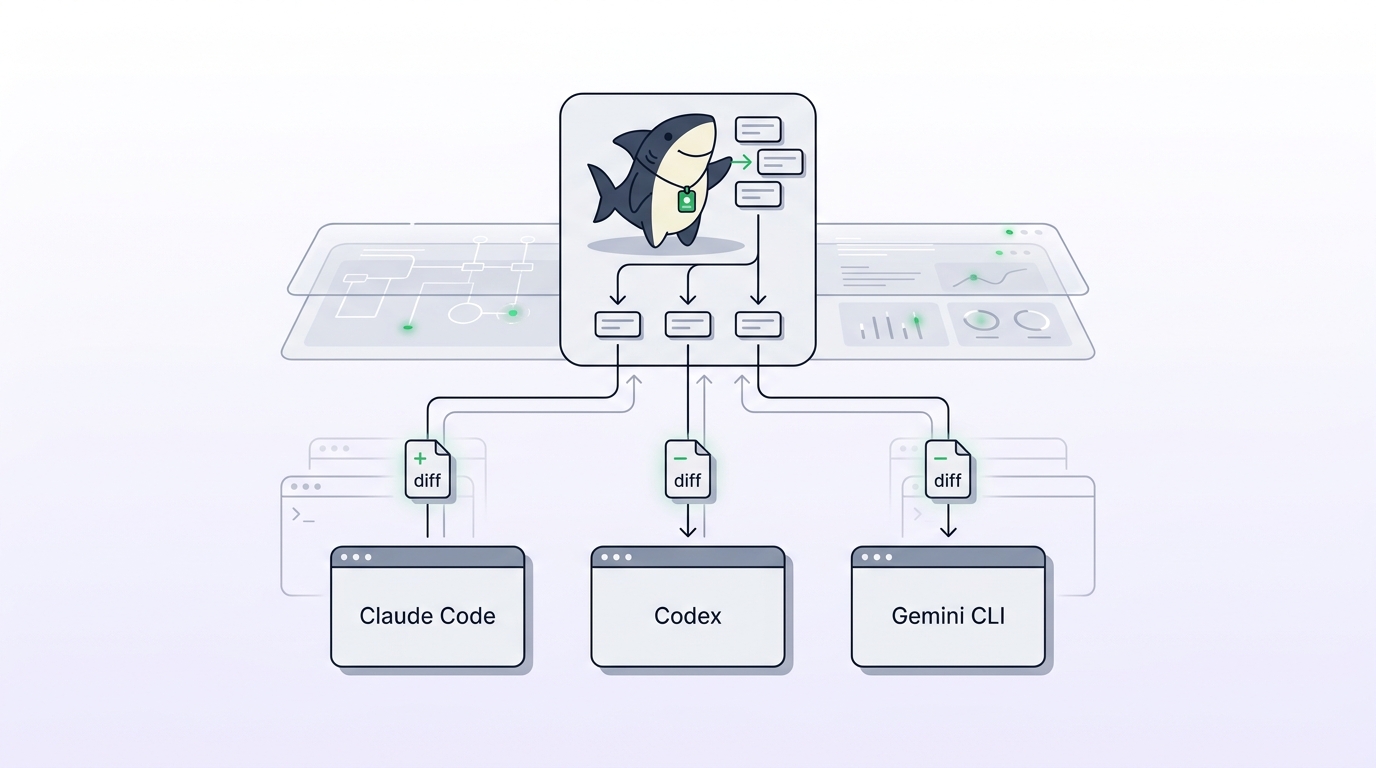
Wenn Sie bereits mehrere Coding-Agenten parallel einsetzen, bietet Sharkly Ihnen eine zentrale Übersicht: Sie sehen genau, welche Runtime welchen Versuch generiert hat, welche Belege vorliegen und wie viel Arbeit aktuell auf eine Freigabe durch Ihr Team wartet.