
Respuesta rápida: Para corregir fallos en la CI con un agente de IA, envía el evento de error a un webhook, permite que un agente de código evalúe si puede resolverlo, reprodúcelo en local en un worktree limpio y sube la solución a una rama mediante un draft pull request. Una persona se encarga de revisarlo y fusionarlo. Si no se puede reproducir en local, no se sube nada.
Un build en rojo a las 4 de la tarde cuesta mucho más que la solución en sí. Alguien tiene que interrumpir lo que estaba haciendo, abrir el log, desplazarse por más de 900 líneas de salida de configuración y encontrar un error de lint o un snapshot desactualizado. Arreglarlo lleva dos minutos; el cambio de contexto, veinte.
Esa brecha es justo donde un agente de código demuestra su valor. Es muy probable que ya utilices Claude Code, Codex u otro agente en tu día a día. La pieza que falta es la integración: algo que detecte el fallo, se lo entregue al agente con el contexto adecuado y evite que introduzca soluciones a ciegas en tu repositorio. En esta guía configuramos esa conexión con GitHub Actions y una Automation de Sharkly, un esquema que funciona con cualquier sistema de CI capaz de enviar una solicitud HTTP.
Qué puede solucionar bien un agente de IA en CI (y qué no)
Un agente rinde al máximo ante fallos reproducibles en un equipo local y con soluciones pequeñas y verificables. En cambio, su eficacia decae ante problemas relacionados con infraestructura, credenciales o servicios de terceros. Clasifícalos antes de automatizar:
| Tipo de fallo | Idoneidad del agente | Motivo |
|---|---|---|
| Errores de lint y formato | Alta | Deterministas: el linter confirma la corrección |
| Errores de tipos | Alta | El compilador confirma la corrección |
| Snapshot roto tras un cambio intencionado en la interfaz | Buena | Fácil de reproducir, pero un humano debe confirmar que el cambio era el esperado |
| Test intermitente (flaky test) | Media | La reproducción requiere varias ejecuciones; a menudo se trata de una condición de carrera real |
| Test unitario fallido tras un cambio de lógica | Media | El test podría ser correcto y el código estar mal |
| Runner sin espacio en disco, caídas por timeout de red | Baja | No hay nada que corregir en el repositorio |
| Secretos ausentes o caducados, errores de permisos | Nunca | El agente no debe tocar las credenciales |
La regla fundamental que se desprende de esta tabla es clara: el agente solo entrega una corrección que haya visto pasar de rojo a verde en su propio Computer. En un artículo de diseño que el equipo de DeepSeek Harness publicó en X, a este patrón lo denominan «reproducir y corregir en silencio» (silently reproduce and fix): un activador monitorea los eventos, no interviene por defecto y solo saca a la luz una solución sencilla y confirmada. Dicho artículo describe el prototipo de un diseño y no un producto final, pero el principio se aplica a cualquier configuración que implementes por tu cuenta.
Cómo funciona el bucle de corrección de CI
El ciclo consta de cinco partes: un evento de fallo, un webhook firmado, un filtro de bajo coste, una reproducción aislada y una fase de revisión humana.
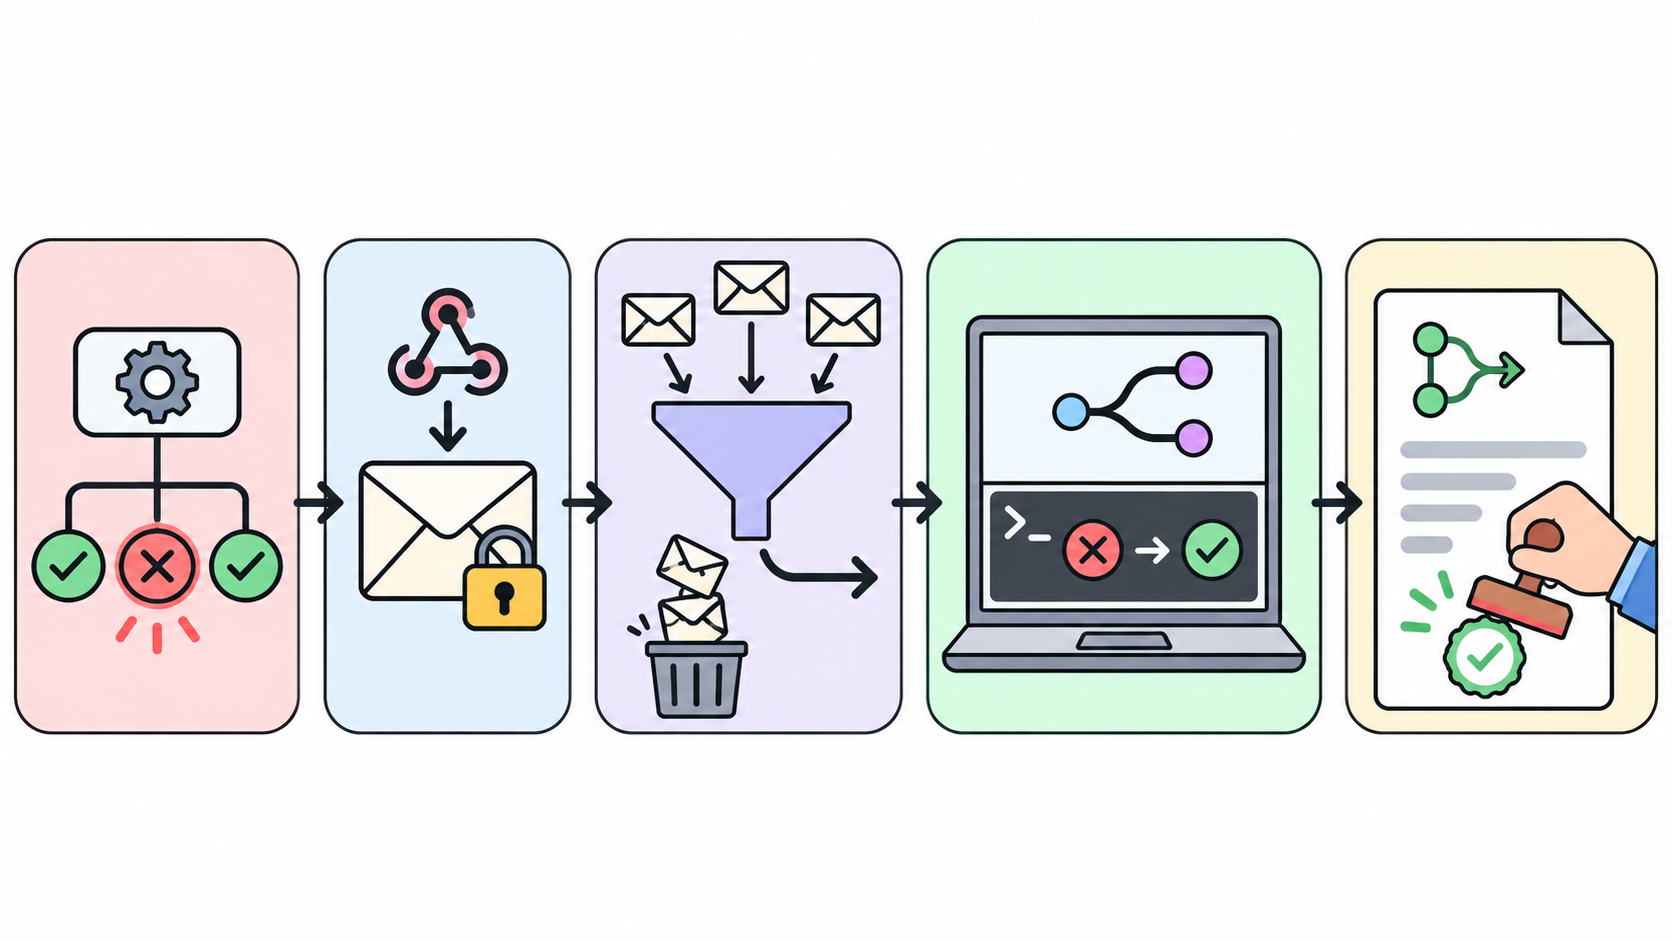
- Tu CI termina una ejecución con un fallo.
- Un workflow ligero envía un cuerpo JSON firmado a la URL de un webhook.
- El agente lee los datos y descarta todo lo que quede fuera de su alcance, como un repositorio incorrecto o un error en una rama de release.
- El agente crea una tarea, extrae el código en un worktree limpio, reproduce el fallo y lo soluciona.
- Sube los cambios a una rama y crea un draft pull request. Una persona se encarga de aprobarlo o cerrarlo.
Los pasos 3 y 4 se ejecutan como una Automation de Sharkly. Una Automation es un conjunto guardado de instrucciones junto con el Agent o Crew que las ejecuta, iniciado por un disparador (trigger): una programación temporal, un cambio de estado en una tarea, una frase en un comentario o un webhook.
Paso 1: Enviar el fallo de CI a un webhook
GitHub Actions cuenta con un evento workflow_run que se dispara cuando finaliza otro workflow. Como se activa con cualquier conclusión, se filtra por failure mediante una condición en el job. Un detalle importante de la documentación de GitHub: el archivo del workflow debe existir en la rama por defecto; de lo contrario, nunca se ejecutará.
Este workflow escucha a un workflow llamado CI, genera un pequeño payload JSON, lo firma y lo envía:
name: Report CI failure
on:
  workflow_run:
    workflows: [CI]
    types: [completed]

jobs:
  notify:
    if: ${{ github.event.workflow_run.conclusion == 'failure' }}
    runs-on: ubuntu-latest
    steps:
      - name: Send signed webhook
        env:
          WEBHOOK_URL: ${{ secrets.SHARKLY_WEBHOOK_URL }}
          SIGNING_SECRET: ${{ secrets.SHARKLY_SIGNING_SECRET }}
          REPO: ${{ github.repository }}
          RUN_ID: ${{ github.event.workflow_run.id }}
          RUN_URL: ${{ github.event.workflow_run.html_url }}
          BRANCH: ${{ github.event.workflow_run.head_branch }}
          SHA: ${{ github.event.workflow_run.head_sha }}
        run: |
          BODY=$(jq -nc --arg repo "$REPO" --arg run_id "$RUN_ID" \
            --arg url "$RUN_URL" --arg branch "$BRANCH" --arg sha "$SHA" \
            '{event:"ci_failure",repo:$repo,run_id:$run_id,run_url:$url,branch:$branch,sha:$sha}')
          TS=$(date +%s)
          SIG=$(printf '%s\n%s' "$TS" "$BODY" \
            | openssl dgst -sha256 -hmac "$SIGNING_SECRET" -binary | base64)
          curl -fsS -X POST "$WEBHOOK_URL" \
            -H "Content-Type: application/json" \
            -H "X-Webhook-Timestamp: $TS" \
            -H "X-Webhook-Signature: v1=$SIG" \
            --data-raw "$BODY"
Los nombres de las ramas provienen de los colaboradores, por lo que el workflow los pasa mediante env y jq en lugar de concatenarlos directamente en el script de shell. Guarda ambos valores como secretos cifrados del repositorio, nunca directamente en el archivo.
Paso 2: Crear la Automation y su disparador de webhook
Dentro de tu Space, crea una Automation, asígnala al Agent que debe encargarse de las correcciones y añade un disparador de Webhook. Sharkly muestra la URL completa una sola vez, al crear o regenerar el disparador, así que cópiala directamente en el secreto de GitHub.
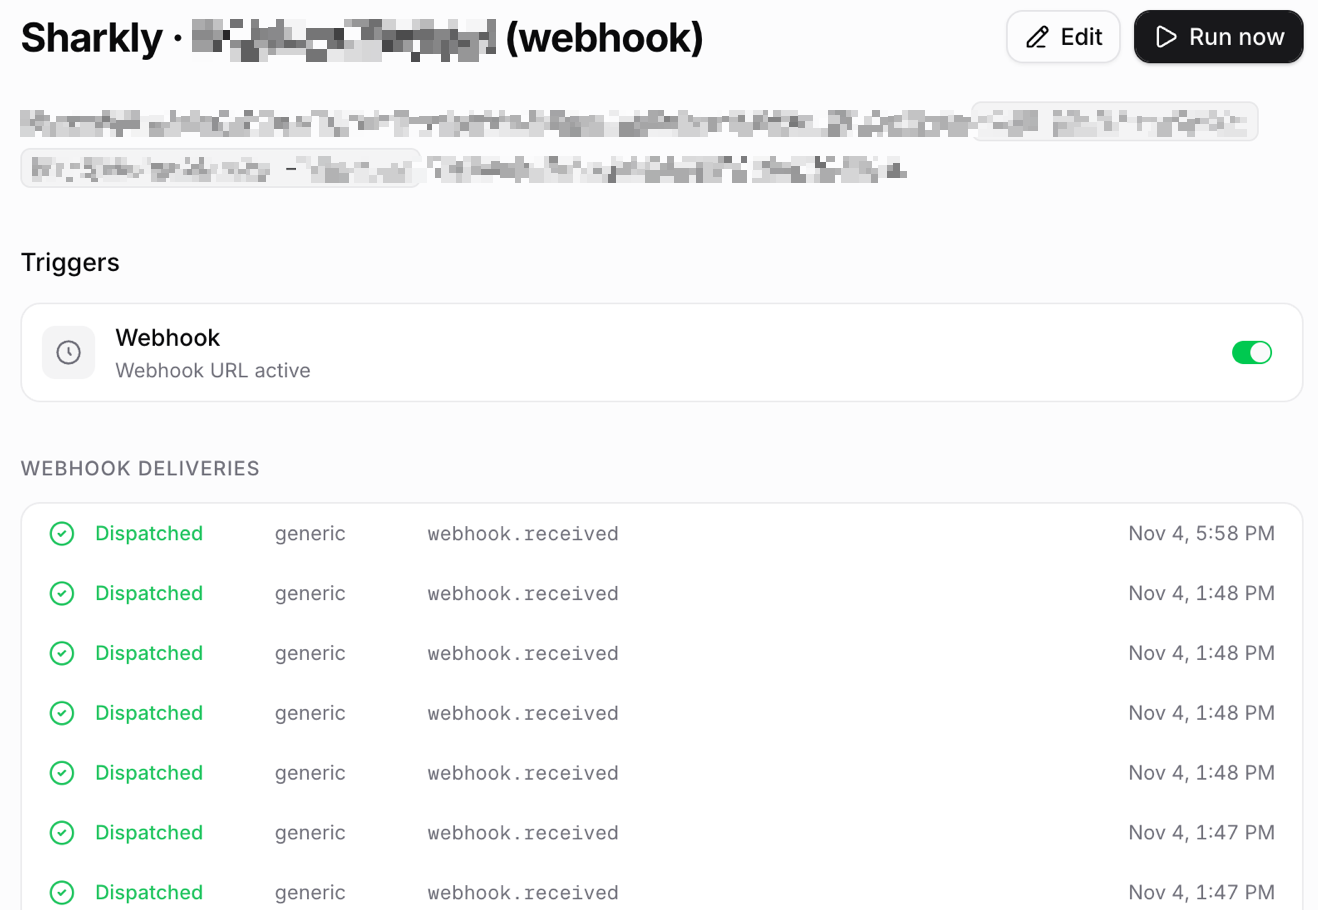
Activa un secreto de firma (signing secret). Sin él, la URL funciona como un secreto al portador: cualquiera que la tenga puede iniciar una ejecución. Con él, según la documentación de Automations, cada solicitud debe incluir una cabecera X-Webhook-Signature compuesta por v1= seguido de un HMAC-SHA256 en Base64 calculado sobre la marca de tiempo, un salto de línea y el cuerpo sin procesar, firmado con el secreto whsec_. Sharkly rechaza marcas de tiempo con una diferencia superior a 300 segundos y solo acepta una firma determinada una vez en un intervalo de 10 minutos, lo que impide ataques de repetición con peticiones interceptadas.
El disparador debe estar habilitado y la Automation en estado Active para que una petición válida inicie una ejecución. Pruébalo primero con «Run now».
Paso 3: Escribir instrucciones que primero filtren y luego corrijan
Una Automation ejecutada desde un webhook no crea una tarea automáticamente. Como la ejecución no tiene ninguna tarea vinculada, tus instrucciones deben registrar una; de este modo, cada fallo contará con un registro, un hilo para consultas y un estado visible para todo el equipo. Coloca las comprobaciones rápidas y de bajo coste al principio para que la mayoría de los eventos se resuelvan en cuestión de segundos:
You receive a CI failure webhook. The trigger payload is JSON with
event, repo, run_id, run_url, branch, sha.

1. Stop with no output unless event == "ci_failure" and repo is
   acme/web. Stop if branch starts with "release/".
2. Search open tasks for run_id. If one exists, stop.
3. File a task titled "CI fix: <repo> run <run_id>" with run_url in
   the body. Do all further work under that task.
4. Read the failed steps: gh run view <run_id> --log-failed
5. If the cause is a secret, permission, runner, or network problem,
   comment the diagnosis on the task and stop. Change nothing.
6. Check out sha in a fresh worktree. Run the failing command and
   confirm it fails the same way. If it does not reproduce, comment
   what you tried and stop. Never push an unreproduced fix.
7. Make the smallest change that fixes it. Do not edit CI config,
   lockfiles, or tests you were not asked to fix. Rerun the command
   and the nearest test suite.
8. Push to branch ci-fix/<TASK-ID> and open a draft PR with
   gh pr create --draft, task ID in the title. Comment the PR link
   on the task and hand it to a human for review.
Aquí hay dos detalles clave. Actualmente, los disparadores por estado o comentario coinciden en toda la organización, motivo por el cual la documentación recomienda validar las entradas dentro de las propias instrucciones; aunque un webhook está limitado a su URL, el paso 1 sigue protegiendo frente a solicitudes mal enrutadas. Por su parte, incluir el ID de la tarea en el nombre de la rama cumple una función fundamental: con la integración de GitHub conectada, cualquier ID de tarea en la rama, el título o el cuerpo de la PR vincula automáticamente el pull request con la tarea correspondiente.
Paso 4: Ejecutarlo en un Computer dentro de un worktree aislado
Un Computer es el host conectado en el que se ejecuta tu Agent, dotado de sus propios Runtimes, archivos y credenciales de Git. Configura el repositorio del Agent en modo Temporary para que cada ejecución cuente con su propio directorio de tarea y un worktree independiente. Así, dos fallos recibidos con un minuto de diferencia no sobrescribirán los archivos del otro. Para conocer los detalles técnicos, consulta agentes en paralelo en worktrees aislados y la documentación de git worktree.
El acceso a Git procede del Computer, no de la GitHub App. La integración se encarga de vincular pull requests y sincronizar issues; clonar y subir cambios sigue dependiendo de la clave SSH, el token HTTPS o la sesión de gh configurada en ese host. Otorga a esa credencial permisos de push únicamente sobre ramas y protege tu rama por defecto para que cualquier merge requiera una revisión.
Costes y salvaguardas
Cada ejecución se factura según el plan del propio Runtime. Sharkly no vende tokens, por lo que una ejecución para corregir la CI cuesta lo mismo que te costaría hoy una sesión de Claude Code o Codex de esa misma duración. El filtro inicial del paso 1 es tu principal mecanismo de control de costes: un evento que se detiene en el paso 1 consume apenas unos cientos de tokens en lugar de los necesarios para una reproducción completa.
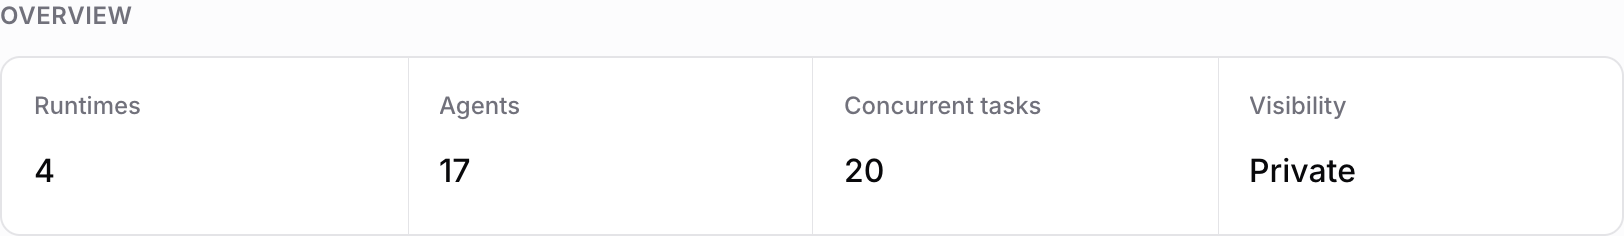
La concurrencia es el segundo mecanismo de control. Cada Computer tiene un límite de tareas simultáneas, y las ejecuciones en directorios temporales utilizan por defecto la mitad de este límite. Cuando se alcanza la capacidad máxima, las ejecuciones adicionales se ponen en cola en vez de saturar una única máquina. De este modo, una mañana difícil con 30 builds en rojo se convierte en una cola ordenada y no en un colapso.
El resto son reglas que solo necesitas definir una vez:
- Solo draft PRs. El agente nunca fusiona ramas. Consulta agentes de código con intervención humana (human-in-the-loop) para saber dónde situar el punto de revisión.
- Un solo intento por ejecución. Si la primera corrección falla en su propia comprobación, el agente deja un comentario y se detiene.
- Una lista de exclusión (deny list): configuración de CI, secretos, lockfiles y migraciones.
- Pausa la Automation desde su página cuando modifiques las instrucciones y reactívala tras probarla con «Run now».
Verifica antes de confiar plenamente. El ciclo planificar, observar y verificar también se aplica aquí: revisa una semana del historial de ejecuciones antes de ampliar la lista de repositorios.
Alternativas
Puedes crear una tarea por cada fallo en lugar de recurrir a una Automation basada en webhooks. Haz que el workflow invoque un script que llame a sharkly task create y deja que el Agent asignado la tome. Con esto obtendrás una tarea por cada build en rojo, incluidas aquellas que el agente debería ignorar, por lo que resulta más adecuado para repositorios de bajo volumen. Los equipos que ya gestionan sus incidencias mediante GitHub también pueden empezar por asignar un issue de GitHub a un agente de IA.
Empieza con un solo repositorio
Elige el repositorio con mayor cantidad de errores de lint y de tipos, configura el workflow anterior y ejecuta la Automation manualmente tres veces antes de permitir que el webhook se dispare solo. Cuando llegue el momento de escalar más allá de un único agente, cómo ejecutar 10 agentes de código con IA a la vez te mostrará los pasos siguientes. Puedes empezar con Sharkly gratis: conecta un Computer y deja que tu agente actual se encargue del próximo build en rojo.
Preguntas frecuentes
¿Puede un agente de IA corregir fallos en las compilaciones de CI por su cuenta?
Puede corregir errores de lint, de tipos y de snapshots que logre reproducir en local. No debería hacer merge de forma autónoma. Mantén el resultado como un draft PR y deja que una persona lo apruebe.
¿Cómo activo un agente de IA cuando falla GitHub Actions?
Añade un workflow vinculado al evento workflow_run con types: [completed] y una condición en el job que compruebe conclusion == 'failure'. Ese job enviará una solicitud firmada a la URL del webhook del agente.
¿Qué evita que el agente suba una solución incorrecta?
La regla de reproducción. El agente debe ver el fallo en local, aplicar un cambio y comprobar que ese mismo comando finaliza con éxito. Si no hay reproducción, simplemente dejará un comentario en la tarea y no subirá ningún cambio.
¿La integración de GitHub de Sharkly abre pull requests?
No. Se limita a vincular pull requests con tareas y sincronizar issues. Es el agente quien abre la PR utilizando las credenciales de Git y gh disponibles en su Computer.
¿Qué ocurre con los tests intermitentes (flaky tests)?
Configura el agente para que vuelva a ejecutar el test fallido varias veces antes de tomar una decisión. Si pasa en algunas ejecuciones y falla en otras, debe reportar la intermitencia en la tarea en lugar de intentar aplicar un parche superficial.
¿Cuánto cuesta una ejecución de corrección de CI?
El coste equivale a los tokens que consuma tu Runtime durante esa sesión. Las ejecuciones de Sharkly se facturan directamente contra tu plan de Claude Code, Codex o API.


