
Anthropic dice que ejecutar Claude Opus 5.5 cuesta un 40% menos que Opus 5. Alguien de tu equipo ya ha hecho la suma obvia: con el mismo presupuesto, aproximadamente 1,7 veces más ejecuciones de agentes y, por tanto, alrededor de 1,7 veces más trabajo entregado. Esa cuenta cuadra en lo aritmético y falla en lo operativo, y la semana en que se actúe en consecuencia será la semana en que tu tablero se llene de ejecuciones terminadas que nadie ha leído.
El límite para ejecutar más agentes en paralelo nunca fue la factura del modelo, sino la capacidad de una sola persona para leer un diff, entender qué decidió un agente y aceptarlo. Una bajada de precios no cambia nada en ese número: lo único que hace es que el trabajo llegue antes hasta ese límite.
TL;DR
Un techo de revisión es la cantidad de ejecuciones de agentes ya completadas que un equipo puede realmente leer, juzgar y aceptar en un día, y lo determinan las personas, no los tokens. Los modelos más baratos aumentan la tasa de llegada a ese techo y dejan el techo intacto, así que el primer efecto visible de una bajada de precios es una cola más larga, no un lanzamiento más rápido. Los agentes investigan, ejecutan, prueban e informan. Las personas marcan la dirección, conceden autoridad y aceptan el resultado. La respuesta útil es limitar la concurrencia en función de los revisores y no del presupuesto, y separar el trabajo de agentes que converge en un único resultado revisable del trabajo que se ramifica en muchos. Sharkly mantiene el contexto, el progreso, los bloqueos, los resultados y la revisión humana visibles en la Tarea, desde la solicitud hasta el despliegue, que es justo lo que hace que la cola se pueda contar.
Qué es lo que se abarató de verdad
Dos laboratorios lanzaron novedades el 22 de septiembre de 2026. Esta es la parte que toca tu factura.
| Claude Opus 5 | Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | |
|---|---|---|---|---|
| ID de la API | claude-opus-5 |
claude-opus-5-5 |
gpt-6-sol |
gpt-6-luna |
| Entrada por 1M de tokens | $5 | $4 | $2 | $0,10 |
| Salida por 1M de tokens | $25 | $20 | $10 | $0,50 |
| Entrada en caché | n/a | $0,20 lectura, $5 escritura | 90% de descuento en lecturas | 90% de descuento en lecturas |
Anthropic afirma que ejecutar Opus 5.5 cuesta un 40% menos que Opus 5 y que genera resultados en torno a un 30% más rápido. Las tarifas de lista de arriba son un 20% inferiores al precio por token de Opus 5, lo cual es aritmética nuestra a partir de dos cifras publicadas y una afirmación distinta de ese 40%. OpenAI afirma que Sol y Luna son un 50% más baratos que el precio promocional de GPT-5.6, y «promocional» es palabra de la propia OpenAI, así que ese titular se mide contra una tarifa con descuento y no contra una de lista.
El coste por tarea completada se movió más que el coste por token. En AutomationBench 1.0.6, OpenAI reporta que GPT-6 Sol con razonamiento extra alto obtiene un 33,2% a $0,27 por tarea, frente a Claude Opus 5 con razonamiento máximo, que obtiene un 26,9% con un coste 11,1 veces superior al de Sol. En DeepSWE 1.1, OpenAI sitúa a GPT-6 Luna con razonamiento máximo en un 66,6% y un 93% más barato por tarea que Opus 5.
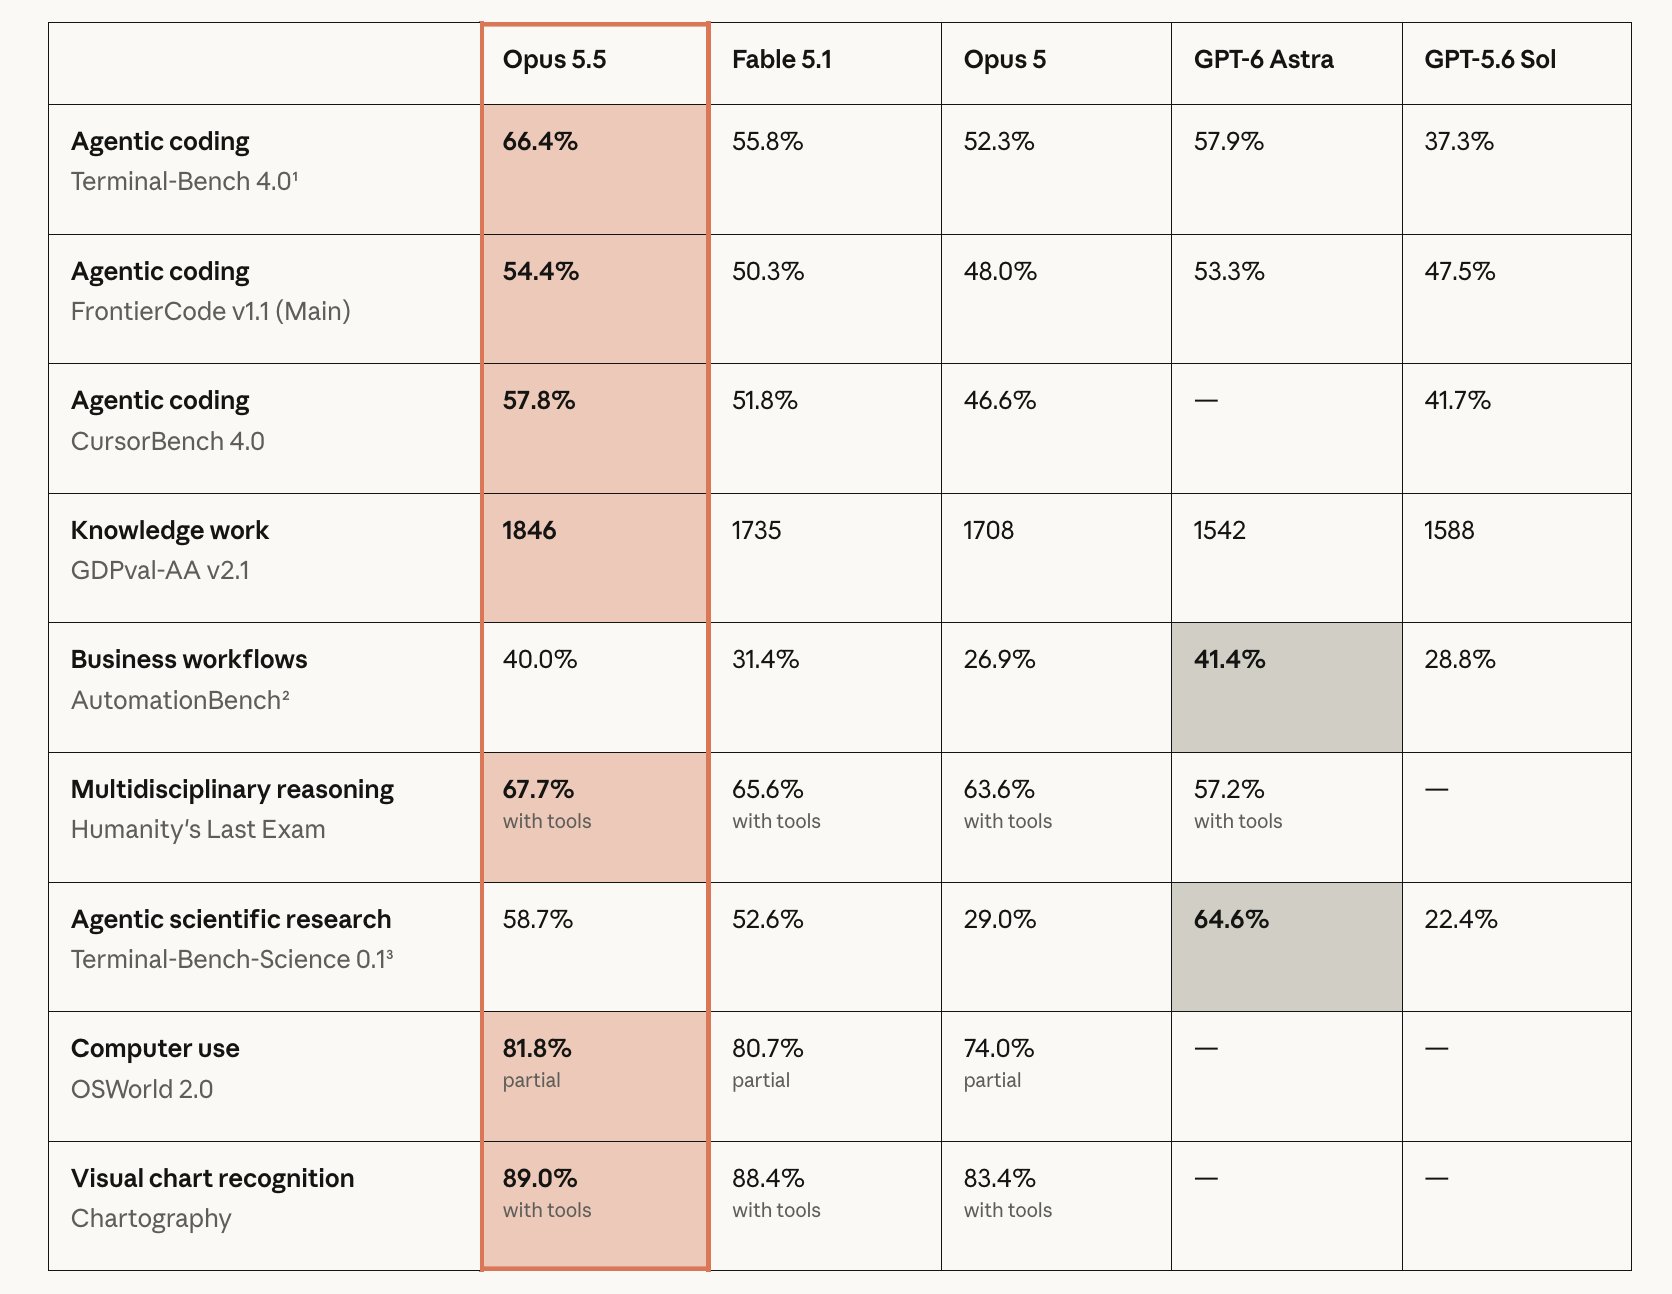
Así que el precio de un intento se desplomó, en dos proveedores distintos, en un solo día. Nada más de tu semana ha cambiado.
La cuenta que todos han hecho esta semana
Mantén el gasto constante y divide. Con un 40% menos de coste por ejecución, la misma cifra mensual compra unas 1,67 veces más ejecuciones de Opus 5.5 que de Opus 5. Y si desvías a Luna la mitad rutinaria del trabajo, el multiplicador deja de ser interesante, porque a $0,10 y $0,50 por millón de tokens la partida del modelo ya no es lo que estás presupuestando.
Ahora haz la segunda cuenta, la que decide si algo de todo esto llega a producción. Toma el número de ejecuciones completadas que uno de tus ingenieros puede leer de verdad en un día. No echarles un vistazo por encima, no aprobarlas porque la marca está en verde: leer el diff, entender qué decidió hacer el agente y asumir la responsabilidad de ello. Sea cual sea ese número, era el mismo el 21 de septiembre de 2026 y lo será el próximo trimestre. La aritmética de la capacidad de revisión sale mal incluso antes de una bajada de precios, y una bajada de precios solo cambia el lado de la entrada.
Una bajada de precios no es un aumento de capacidad. Es un cambio en lo barato que resulta generar algo que sigue necesitando a una persona.
La pista: el coste no era lo que te frenaba
Si el coste del modelo fuera la restricción real, los equipos habrían estado usando la configuración más barata que funcionase. No lo hacían. Los propios datos de OpenAI dicen que el investigador medio de su organización consume más de $600 al día de inferencia a precios de API, y que el percentil 90 consume $7.000 al día. Su tabla de benchmarks publicada muestra equipos que usan a sabiendas una configuración 11,1 veces más cara por tarea para obtener una puntuación más baja, porque un resultado en el que confías vale más que uno que tienes que comprobar dos veces.
Esa es la forma que tiene la restricción real. La gente paga un múltiplo elevado por resultados que exigen menos escrutinio humano por unidad. El recurso escaso que se compra es la atención, no la computación, y ya se compraba con una prima muy alta.
Lo que significa que una bajada de precios aterriza de forma asimétrica: abarata el lado que genera y deja el lado que acepta exactamente donde estaba.
Fan-out que converge y fan-out que acaba en el tablero
Esta es la distinción que hace que los modelos baratos sean de verdad útiles en lugar de silenciosamente caros, y es la que la mayoría de los equipos se salta.
Hay paralelismo que converge. Tres agentes intentan la misma migración en worktrees aislados, un conjunto de tests y un agente líder eligen el que pasa, y a una persona le llega un único resultado. El coste se triplicó y la carga de revisión no se movió. Aquí es donde una bajada de precios te compra rendimiento real y donde la nueva economía justifica cambiar tu configuración.
Hay paralelismo que diverge. Diez agentes cogen diez Tareas no relacionadas y producen diez diffs, diez resúmenes de cambios y diez decisiones de aceptación. El coste son las mismas diez ejecuciones. La carga de revisión es diez veces la unidad de atención de una persona.
| Fan-out convergente | Fan-out divergente | |
|---|---|---|
| Ejemplo | 3 intentos de una misma migración, gana el mejor | 10 Tareas, 10 responsables, 10 diffs |
| Qué compran los modelos más baratos | Más intentos y más probabilidad de que uno sea bueno | Más trabajo terminado esperando |
| Elementos de revisión generados | 1 | 10 |
| Seguro para escalar solo por precio | Sí | No |
Usa modelos baratos para ampliar el fan-out convergente hasta donde te llegue la paciencia con los reintentos. No los uses para ampliar el fan-out divergente más allá de tus revisores, por asequibles que se hayan vuelto las ejecuciones. Ese es el par de decisiones honesto, y la segunda mitad es la que cuesta dinero cuando se ignora.
Qué cambiar en lugar del presupuesto
Limita la concurrencia en función de los revisores, no del gasto. Escribe la regla donde el Crew pueda verla: las Tareas abiertas en espera de aceptación humana no deberían superar el número de revisores de turno multiplicado por las revisiones que cada uno completa en un turno. Tus dos números, no los nuestros. Cuando se alcanza el límite, los agentes dejan de coger Tareas nuevas aunque el presupuesto lo permita. En este punto, una regla de enrutamiento escrita gana a una preferencia, porque una preferencia pierde en silencio frente a un precio más bajo.
Haz que «esperando a una persona» sea un estado visible. Una ejecución que terminó y otra que se detuvo a preguntar algo se ven idénticas desde fuera, y las dos son invisibles si el único registro es una terminal. La ejecución, los bloqueos, los resultados y la conversación posterior deberían volver a la línea de tiempo de la Tarea, para que la cola sea algo que puedes contar y no una sensación que te invade el viernes.
Pon precio a la revisión, no a los tokens. Un seguimiento de costes entre agentes que informa de dólares por ejecución responde a una pregunta que ya no aprieta. La cifra que merece estar en un panel son los minutos humanos por cambio aceptado. Si esa cifra subió después de pasarte a un modelo más barato, el modelo más barato es más caro.
Gasta parte del ahorro en evidencias. Una ejecución que adjunta su typecheck, los resultados de los tests, el resumen de cambios y los límites conocidos cuesta más tokens y menos atención. Con las lecturas de entrada en caché de Opus 5.5 a $0,20 por millón y un 90% de descuento en las lecturas en caché de GPT-6, la pasada extra de verificación sale casi gratis y te devuelve el recurso que de verdad escaseaba.
Dónde deja esto la semana
Dos laboratorios recortaron el precio de un intento el mismo día, y uno de ellos comparó contra un modelo que fue sustituido unas horas después. Ninguno de los dos ha lanzado nada que lea un diff por ti. La propiedad humana del trabajo es la parte que no se abarató un 40%, y es la que decide qué llega a producción.
Si ya tienes varios agentes de programación en marcha, el movimiento útil esta semana no es subir el número de concurrencia. Es averiguar cuál es de verdad tu techo de revisión y ajustar la concurrencia a esa cifra. Sharkly te da un único lugar donde ver las ejecuciones, los bloqueos, los resultados y la cola de trabajo que espera a que una persona lo acepte.


