
Anthropic lanzó Claude Sonnet 5.5 el 28 de septiembre a 2 $ por millón de tokens de entrada y 10 $ por millón de tokens de salida, el mismo precio de catálogo que Sonnet 5 y la mitad que Opus 5.5. Según Anthropic, funciona más de un 30 % más rápido que Sonnet 5 y cuesta hasta un 30 % menos por tarea. Para un equipo que ejecuta varios agentes de programación, la gran noticia es que el modelo ideal para asignar a los Agents del día a día ahora se sitúa apenas unos puntos por debajo del buque insignia en casi todas las filas de la tabla de lanzamiento de Anthropic.
Integrarlo en el tablero no es tan automático como parece. En Claude Code, el modelo default se resuelve como Opus 5.5 en los planes Pro, Max, Team, Enterprise y en la API de Anthropic, por lo que un Computer que ejecute Claude Code seguirá usando el modelo insignia hasta que alguien lo modifique manualmente. El alias sonnet solo apunta a Sonnet 5.5 en la API de Anthropic; en Bedrock, Google Cloud y Microsoft Foundry todavía se resuelve como Sonnet 4.5. Un equipo que crea haberse «pasado a Sonnet» puede encontrarse con tres modelos distintos en tres Computers sin forma de saber qué ejecución utilizó cuál. Esta guía propone el camino más simple y efectivo: un Computer, un Agent, una Task real y, a partir de ahí, decidir en qué casos Opus 5.5 sigue justificando su precio.
TL;DR
Actualiza Claude Code en el Computer a la versión v2.1.284 o posterior, fija el id completo claude-sonnet-5-5 en lugar del alias sonnet y vuelve a escanear hasta que el Claude Code Runtime aparezca como Available. Redacta instrucciones para el Agent que eviten las comprobaciones intermedias prematuras y los añadidos innecesarios propios de Sonnet 5.5, mantén el directorio de trabajo como Temporary, ajusta el tiempo de espera para tareas bien delimitadas y asigna una sola Task. En una Crew, asigna los miembros habituales a Sonnet 5.5 y reserva Opus 5.5 para las funciones de líder y revisor. Los Agents investigan, ejecutan, prueban y reportan. Las personas marcan la dirección, delegan la autoridad y validan el resultado final.
Dónde reside la configuración del modelo
Sharkly no elige los modelos por ti. La documentación de Agents lo explica con claridad: «El Agent adopta el modelo predeterminado del Runtime. No garantiza ni muestra un nombre de modelo concreto. Cambia los modelos en la configuración de herramientas del Runtime o del Computer, no en el Agent». La misma página añade que el Agent no incluye un selector de modelo ni un control para la profundidad de razonamiento (thinking depth).
Esto resulta crucial en el caso de Sonnet 5.5, ya que el nivel de esfuerzo (effort) es el factor que más altera el comportamiento de este modelo, y dicho esfuerzo reside donde vive el modelo: en Claude Code dentro del Computer. El Agent define la metodología de trabajo, el Computer proporciona el entorno anfitrión, el Runtime (en este caso, Claude Code) ejecuta la sesión y la Task se mantiene como el registro compartido.
Paso 1: configurar Sonnet 5.5 en Claude Code dentro del Computer
Sonnet 5.5 requiere Claude Code v2.1.284 o superior, tal como indican los documentos de configuración de modelos de Claude Code. Actualízalo en el Computer e inicia sesión con un plan de pago o una clave de API autorizada; Claude Code no está disponible en la versión gratuita de Claude (qué puede y qué no puede ejecutar una cuenta de chat). A continuación, ejecuta claude --model claude-sonnet-5-5 en una terminal estándar dentro de ese host. Si la sesión arranca, Sharkly podrá utilizarlo.
Asegúrate de fijar el id completo y no el alias. Así es como se resuelve sonnet en Claude Code hoy en día:
| De dónde obtiene Claude Code el modelo | El alias sonnet se resuelve como |
|---|---|
| Anthropic API | Sonnet 5.5 |
| Claude Platform en AWS | Sonnet 4.6 |
| Amazon Bedrock | Sonnet 4.5 |
| Google Cloud Agent Platform | Sonnet 4.5 |
| Microsoft Foundry | Sonnet 4.5 |
El identificador es claude-sonnet-5-5 en todas partes salvo en Bedrock, donde el modelo se ejecuta mediante el perfil global entre regiones global.anthropic.claude-sonnet-5-5. El modo opusplan también arrastra el problema de los alias: planifica con Opus y ejecuta con el modelo al que apunte sonnet en ese momento.
Para que la configuración sea permanente, define el modelo directamente en la configuración de Claude Code en ese Computer; de esta manera, cada ejecución iniciada por el servicio local utilizará Sonnet 5.5 en lugar del valor predeterminado Opus 5.5. Luego, repite la verificación en la terminal.
De vuelta en Sharkly, entra en el detalle del Computer y utiliza la acción de reescaneo o prueba de conexión. El Claude Code Runtime debe figurar como Available. Que un Computer aparezca como online solo significa que su servicio local está enviando señales de actividad (heartbeats); lo que realmente confirma que se puede iniciar una ejecución es el estado del Runtime.
Paso 2: diseñar el Agent adaptado al comportamiento de Sonnet 5.5
Entra en Agents, selecciona New Agent y elige el Computer junto con el Claude Code Runtime. La guía de prompting para Sonnet 5.5 de Anthropic describe ciertos patrones de comportamiento que acaban repercutiendo de lleno en la cola de revisión.
El nivel de esfuerzo determina el modelo que realmente estás aprovechando. Claude Code ejecuta Sonnet 5.5 con un esfuerzo medium por defecto, y el razonamiento no se puede desactivar en este entorno. La mayoría de las métricas destacadas del lanzamiento se obtuvieron configurándolo al máximo (max). Los gráficos de Anthropic sitúan a Sonnet 5.5 en un 39,2 % en CursorBench 4.0 con esfuerzo medium frente a un 55,5 % con max, con un coste estimado de 0,70 $ y 9,67 $ por tarea, respectivamente. No se trata de un ajuste correcto y otro incorrecto, sino de presupuestos totalmente distintos. La guía aconseja utilizar medium para desarrollo agéntico en tareas con especificaciones claras, reservando xhigh y max únicamente cuando los beneficios justifiquen el coste.
Tiende a interrumpir antes de tiempo para pedir confirmación. Con niveles de esfuerzo low y medium, Sonnet 5.5 tiende a detenerse y solicitar confirmación en tareas agénticas largas. En Sharkly, estas consultas se registran como comentarios en la Task, lo que hace que quede a la espera de respuesta humana y permanezca bloqueada en el Inbox de alguien hasta que se atienda. Indica al Agent que continúe asumiendo premisas explícitas. Además, con esfuerzo low puede llegar a marcar código como completado sin haber pasado los tests, por lo que es imprescindible exigirle comprobaciones obligatorias.
Añade elementos que nadie ha pedido. La guía advierte de la creación no solicitada de tests, documentación y archivos secundarios en cualquier nivel de esfuerzo, junto con rondas de revisión adicionales o subagentes revisores en xhigh y max. La nota al pie del lanzamiento de Anthropic demuestra su coste: Sonnet 5.5 obtuvo una puntuación inferior en FrontierCode al nivel max en comparación con xhigh debido a que activaba con mayor frecuencia la habilidad de revisión de código de Claude Code, que despliega múltiples subagentes; en dos casos analizados por Cognition, esto provocó límites de tiempo agotados (timeouts) o modificaciones fuera del alcance previsto. Para el revisor humano, esto se traduce en un diff mucho más grande con cambios ajenos a la Task.
Límite de tiempo y directorio. Anthropic posiciona Sonnet 5.5 para «tareas cotidianas bien delimitadas», así que dimensiona el timeout por Task en función de ese enfoque; si una ejecución lo agota, divide la Task antes de ampliar el límite. Mantén el directorio de trabajo como Temporary: cada Task obtiene un directorio aislado y las ejecuciones vinculadas a repositorios preparan un worktree limpio, impidiendo que tareas paralelas se sobreescriban entre sí. Deja la concurrencia en su valor predeterminado —el 50 % del límite del Computer— hasta comprobar cómo responde ante una carga de trabajo real.
Instrucciones sugeridas para adaptar:
Read the Task description and recent comments before editing.
Keep changes limited to the requested behavior. Do not add tests,
docs, or new files unless the Task asks for them; list any you
think are missing in your report instead.
Do not stop to ask whether to continue. When a detail is ambiguous,
proceed with a stated assumption and record it in your report.
Ask only when different interpretations would materially change
the result.
Run the closest relevant checks before reporting done, and report
failures without hiding them.
Do not start extra review rounds or reviewer subagents.
If a safeguard notice or refusal appears, say so in your report.
Stop and ask before anything destructive or outside the attached
repositories.
Paso 3: asignar una Task y crear una Crew de dos niveles
Elige una Task con un criterio de aceptación bien definido, asigna el Agent como Assignee y muévela desde Backlog —donde esperan las Tasks asignadas— hacia un estado listo para trabajar. La ejecución pasará por los estados queued, dispatched y running, mientras la pestaña Executions transmite los logs en tiempo real.
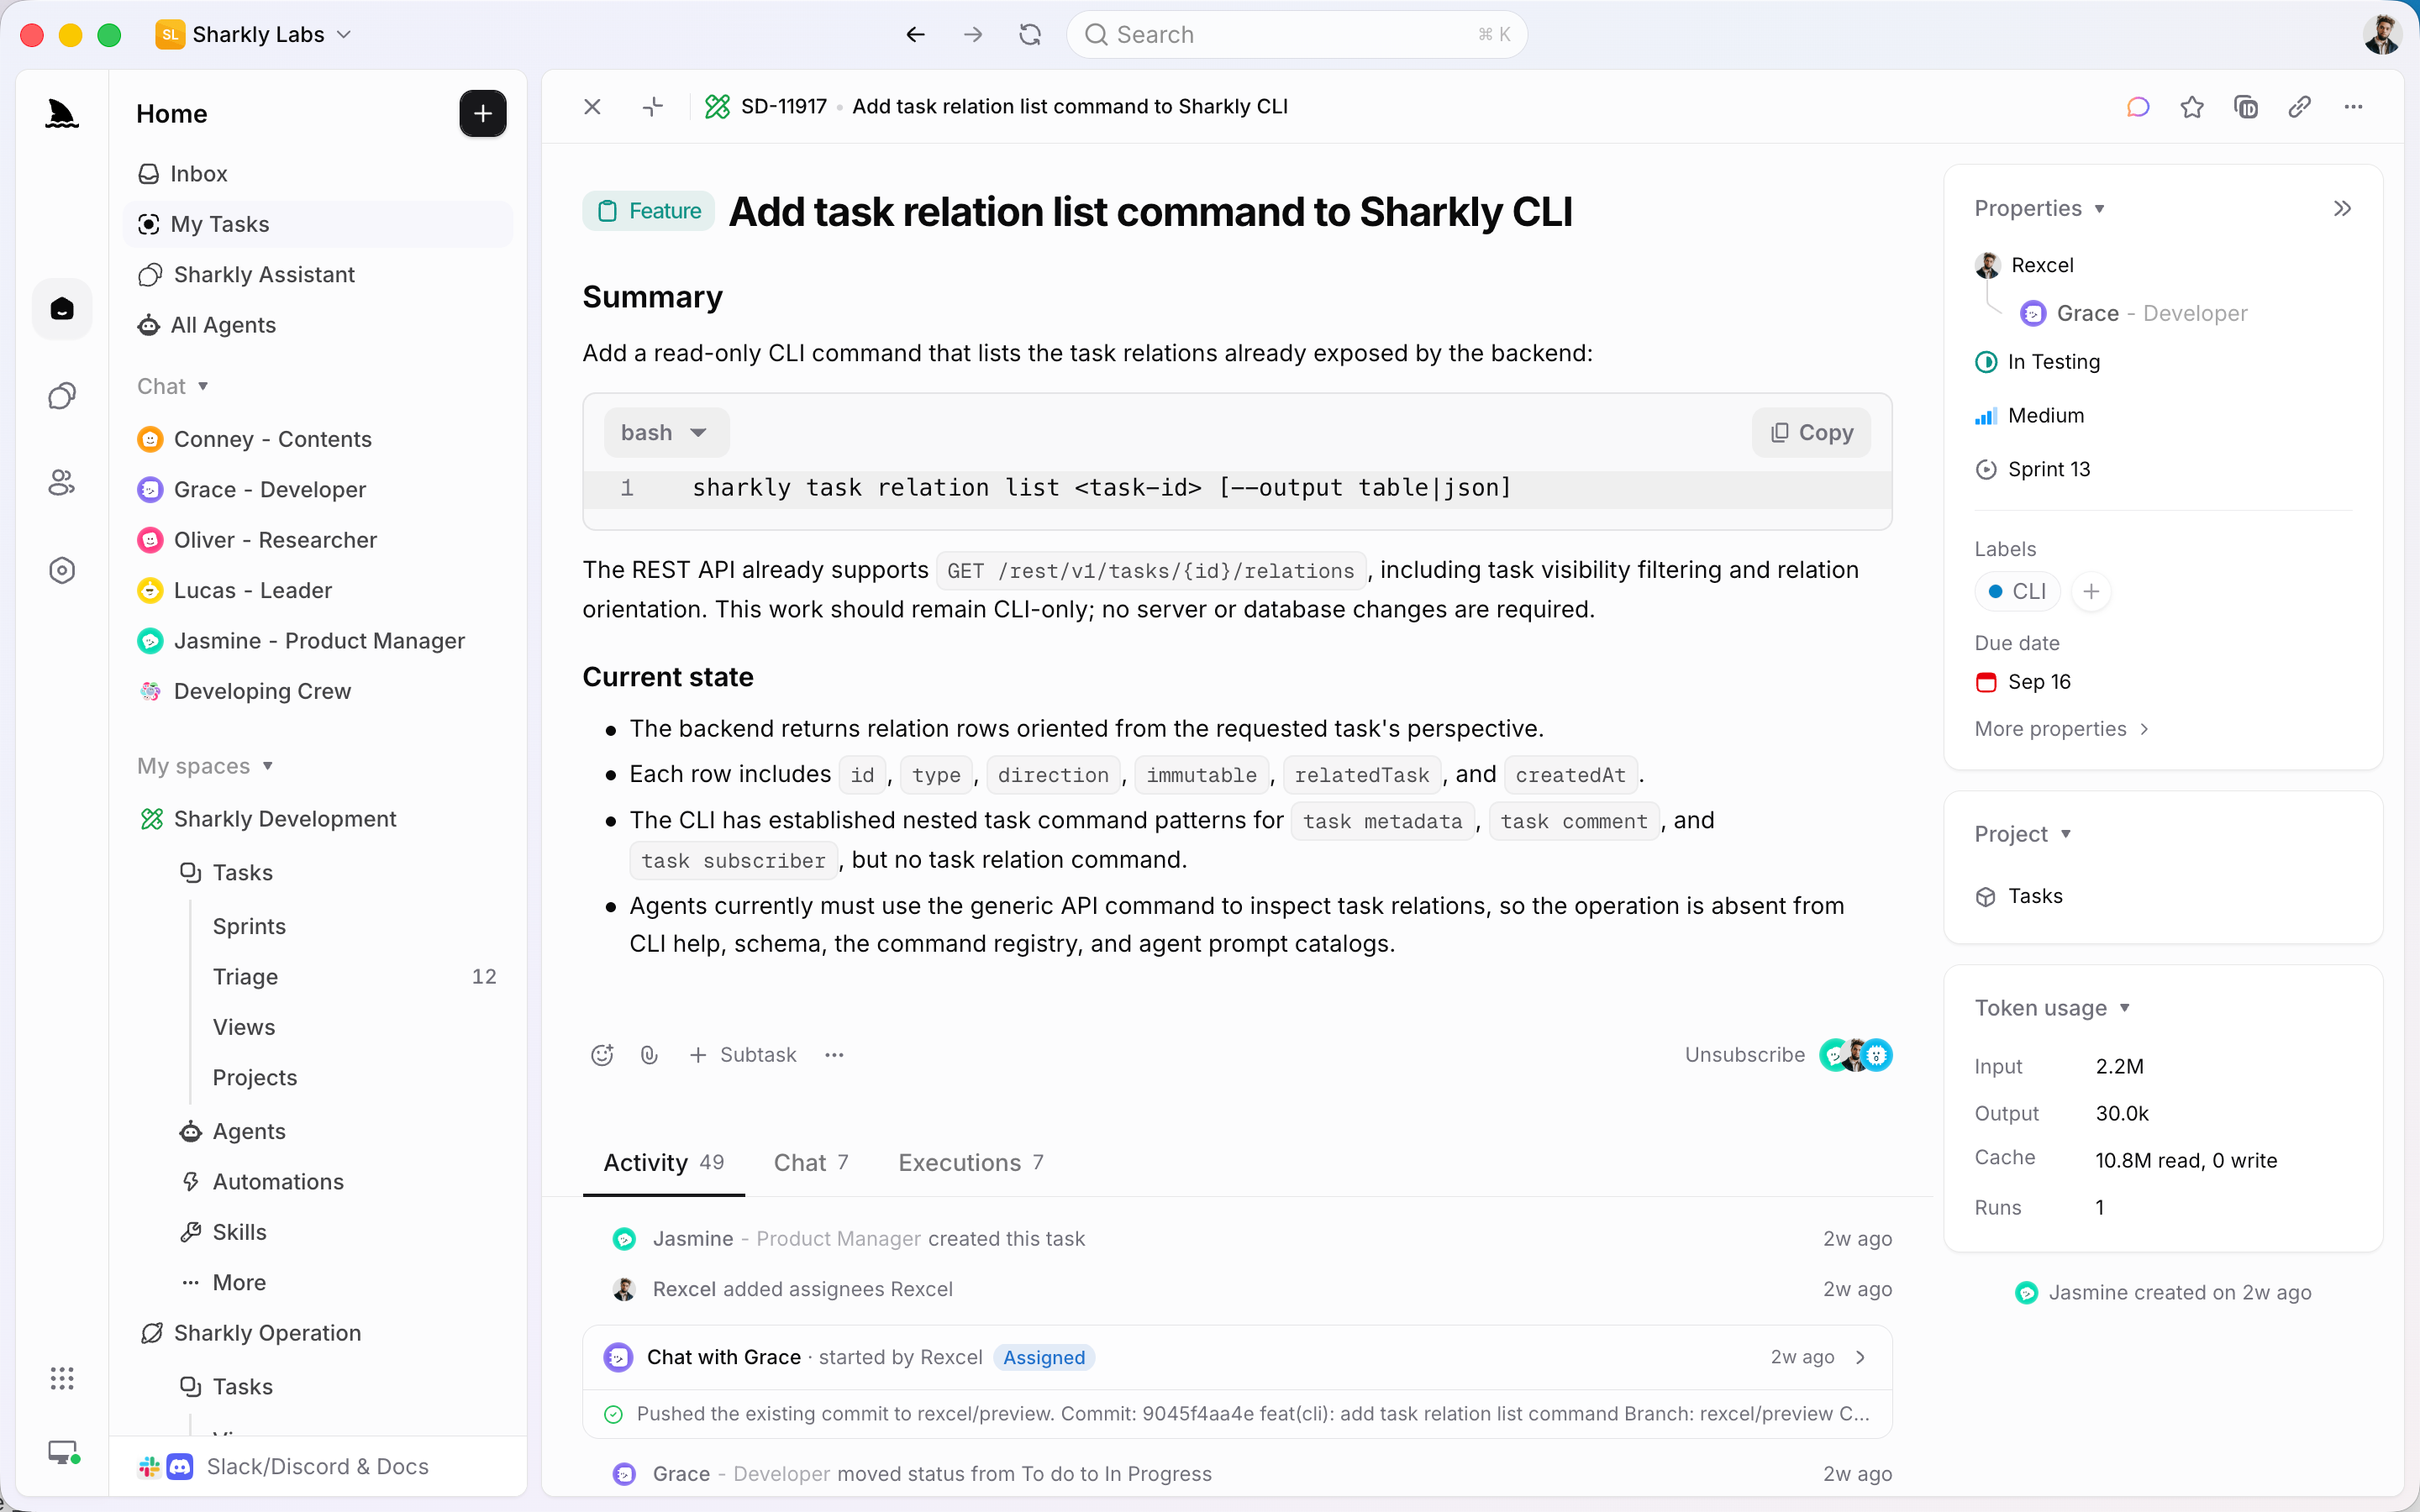
Mantén esa primera Task en un único Agent. Una Crew es un grupo reutilizable de People y Agents coordinado por un Agent líder, y cobra verdadero sentido cuando dicho líder debe interpretar un objetivo amplio y consolidar el trabajo de varios miembros en una única Task. Para la resolución acotada de un bug, un solo Agent es la opción adecuada.
Dentro de una Crew, la distribución del trabajo se alinea con la estrategia de Anthropic: Opus 5.5 «sigue siendo claramente superior en trabajos complejos y de planteamiento abierto», lo que encaja a la perfección con el rol de líder: planificar, delegar y revisar. El trabajo de los miembros consiste en tareas bien delimitadas, ideales para Sonnet 5.5. De hecho, uno de los primeros evaluadores citados en la página de lanzamiento describe este mismo esquema, utilizando Sonnet 5.5 para implementar la arquitectura definida previamente por Opus 5.5.
| Modelo del Runtime | ID de la API | Entrada / salida por 1M | Casos de uso |
|---|---|---|---|
| Claude Sonnet 5.5 | claude-sonnet-5-5 |
$2 / $10 | Miembros habituales: corrección de errores, funciones delimitadas, documentación |
| Claude Opus 5.5 | claude-opus-5-5 |
$4 / $20 | Líder, revisor, tareas abiertas |
| Claude Sonnet 5 | claude-sonnet-5 |
$2 / $10 | El Sonnet anterior; modelo de reserva ante peticiones de ciberseguridad marcadas |
| GPT-6 Sol | gpt-6-sol |
$2 / $10 | Un segundo Runtime, en Codex, al mismo precio |
Dado que el punto documentado para definir el modelo es la configuración de herramientas del Computer, el enfoque de dos niveles más directo consiste en contar con dos Computers: uno donde Claude Code mantenga Opus 5.5 por defecto para el rol de líder, y otro fijado en claude-sonnet-5-5 para los miembros. La frontera entre ambos debe plasmarse en una regla de enrutamiento clara; el artículo sobre Sonnet 5.5 u Opus 5.5 la detalla paso a paso, y la comparativa de Sonnet 5.5 frente a GPT-6 Sol analiza la otra opción de Runtime en ese mismo rango de precio. El consumo del modelo se procesa a través de las suscripciones o claves de API configuradas en dichas herramientas, por lo que estas tarifas se reflejarán en la factura de tu proveedor, no en Sharkly.
Qué cambia en el panel de control
Ejecuciones más veloces que recaen en el mismo equipo de revisores. Completar más tareas al día con el mismo presupuesto no amplía mágicamente las horas disponibles del revisor, y la costumbre del modelo de incorporar tests y documentación adicional hace que cada diff sea mayor. Planifica en función de la capacidad de revisión humana, no del precio del modelo.
Una ejecución marcada puede no haber sido procesada por Sonnet 5.5. Este es el primer Sonnet dotado de salvaguardas avanzadas para ciberseguridad. Anthropic advierte de que las tareas de ciberseguridad consideradas de mayor riesgo «se derivarán de manera visible a Sonnet 5», y la ficha técnica del sistema señala un incremento de rechazos incluso ante peticiones de seguridad legítimas. Que sea visible durante la sesión no implica que se refleje en el tablero: Sharkly no muestra el nombre del modelo, por lo que nada en la Task indicará qué modelo ha respondido a menos que el Agent lo anote de forma explícita. Por esa razón se solicita expresamente en las instrucciones anteriores.
El proceso de razonamiento permanece en el modelo que lo generó. Sonnet 5.5 no puede interpretar los bloques de razonamiento (thinking blocks) de Opus 5.5, ningún otro modelo puede leer los de Sonnet 5.5 y los bloques incompatibles se descartan sin emitir ningún error. Incluso en una misma sesión de Claude Code, alternar entre ambos conserva el texto visible pero elimina todo el razonamiento subyacente. En los traspasos entre Agents dentro de una Crew, ese razonamiento nunca se transfiere: el revisor solo recibe lo que el miembro dejó por escrito en la Task. El artículo sobre cómo los traspasos entre modelos pierden el razonamiento aborda la solución, y las plantillas de traspaso ofrecen una estructura práctica para resolverlo.
El modelo se ha actualizado esta semana. La asignación, el contexto, el progreso, los bloqueos, los resultados y la revisión humana permanecen visibles en el mismo lugar para todo el equipo. Puedes implementar este flujo manualmente mediante worktrees o confiar en Sharkly para gestionar todo el ciclo de trabajo.


