

Pídele a tu agente de programación que te diga dónde se llama a una función y observa lo que ocurre. Hace un grep, lee tres archivos, vuelve a hacer grep con otro patrón, lee cuatro más y al final responde correctamente, después de haber llenado su contexto con código fuente que olvidará en cuanto termine la sesión. Haz una pregunta de seguimiento y repetirá todo el proceso desde cero.
codebase-memory-mcp elimina ese bucle. Con 41.536 estrellas, licencia MIT y escrito en C, es la incorporación de la ola de herramientas para agentes de este año que ofrece la mejor rentabilidad con el menor cambio en tu forma de trabajar. Le da al agente memoria de tu código. No le da a tu equipo memoria del trabajo, y son dos problemas distintos.
TL;DR
Este es uno de los cinco análisis en profundidad de nuestro recopilatorio de herramientas de código abierto que amplían las capacidades de los agentes de programación.
codebase-memory-mcp indexa un repositorio en un grafo de conocimiento persistente de funciones, clases, cadenas de llamadas y rutas, y luego responde a preguntas estructurales desde el grafo en lugar de recurrir al grep. El proyecto mide cinco consultas estructurales en unos 3.400 tokens a través del grafo, frente a unos 412.000 archivo por archivo. Es un único binario nativo, no necesita runtime ni clave de API, se ejecuta por completo en local y funciona con cualquier cliente MCP. Instálalo primero. Después decide por separado dónde va a vivir el registro de lo que hicieron tus agentes.
Qué hace
El análisis sintáctico se realiza con tree-sitter en más de 160 lenguajes, con una capa de resolución semántica de tipos para un grupo principal que incluye Python, la familia de TypeScript y JavaScript, Go, Java, Rust, C# y C++. El resultado se expone mediante 15 herramientas MCP que cubren búsqueda, trazado de cadenas de llamadas, visión general de la arquitectura, análisis de impacto, detección de código muerto, consultas al grafo y enlaces HTTP entre servicios. Puede usarlo cualquier cliente que hable el Model Context Protocol, y el proyecto enumera 45 superficies de agente compatibles.
| Métrica | Valor reportado |
|---|---|
| Cinco consultas estructurales | ~3.400 tokens frente a ~412.000 archivo por archivo |
| Comparativa revisada por pares | 10 veces menos tokens, 2,1 veces menos llamadas a herramientas, 83% de calidad en las respuestas |
| Índice del kernel de Linux | 28 millones de líneas, 75.000 archivos, 3 minutos |
| Latencia de consulta estructural | Por debajo de 1 ms |
Compara las dos cifras de tokens. La reducción del 99% corresponde a cinco consultas estructurales, el mejor escenario posible del grafo. La cifra del preprint, medida en 31 repositorios, es de 10 veces. Planifica contando con 10 veces y toma cualquier mejora como un extra.
Instalación
curl -fsSL https://raw.githubusercontent.com/DeusData/codebase-memory-mcp/main/install.sh | bash
Windows cuenta con un instalador de PowerShell, y el proyecto recomienda leerlo antes de ejecutarlo. El instalador detecta tus agentes de programación y escribe sus entradas MCP. Reinicia el agente y pídele que indexe el proyecto.
Dos ajustes que conviene aplicar desde el primer día:
codebase-memory-mcp config set auto_index true
codebase-memory-mcp --ui=true --port=9749
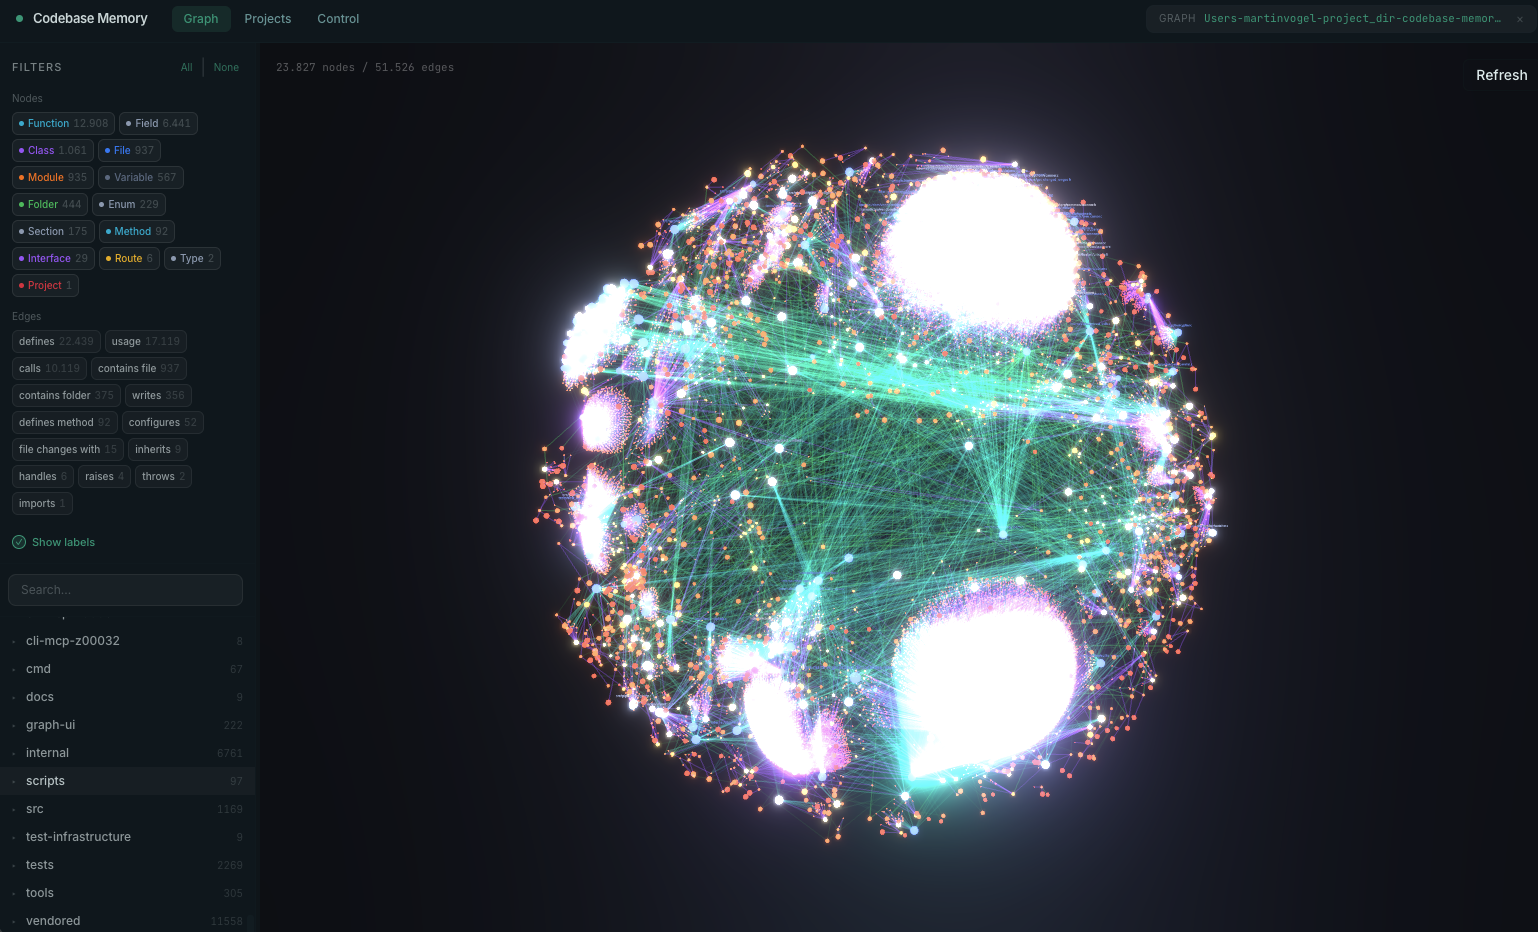
El visor del grafo viene integrado en el binario y es una buena forma de comprobar que el índice ha cubierto lo que esperabas.
El propio proyecto documenta dos advertencias que merecen treinta segundos de atención. Es posible que Microsoft Defender marque un binario de una release como falso positivo; el proyecto señala que, por lo general, 61 de unos 62 motores lo consideran limpio y que esa misma familia de detecciones afecta a la CLI de GitHub y a la propia cadena de herramientas de Go de Microsoft. Y la herramienta lee tu código y escribe en los archivos de configuración de tus agentes, que es precisamente su función, dicho sin rodeos. Lee el script de instalación antes de canalizarlo a un shell.
Por qué empezar por esta
Todo lo demás en la ola actual de herramientas te pide que cambies tu forma de trabajar. Las bibliotecas de roles cambian cómo escribes los prompts. Los worktrees en paralelo cambian cómo te organizas. El acceso web cambia qué le pides.
Esta no cambia nada y abarata cada sesión. No hay ningún hábito que aprender.
El efecto sobre la calidad es la mitad que menos se valora. Un agente que gasta 400.000 tokens leyendo archivos dispone de ese mismo espacio menos para razonar sobre tu problema, y su recuerdo de lo que leyó al principio se degrada a lo largo de una sesión extensa. Responder desde un grafo mantiene el contexto libre.
El cambio se nota en lo que preguntas. Las preguntas que antes evitabas porque costaban 50.000 tokens y dos minutos ahora son casi gratis. El análisis de impacto antes de cambiar una firma convierte un «creo que esto es seguro» en una lista. Trazar cadenas de llamadas en un repositorio que no conoces es mejor que leer hacia arriba por cinco archivos con la esperanza de encontrar el punto de entrada.
La memoria del código no es la memoria del trabajo
Aquí está el límite, y es nítido.
El grafo se construye a partir de tu código, así que sabe qué es tu código. Puede decirte que el helper de reintentos llama al cliente de pagos. No puede decirte por qué cambió el backoff en julio, quién lo decidió, cuál era la alternativa ni si alguien lo revisó. Esa historia vivía en una sesión de terminal que ya no existe.
Los equipos lo perciben como una asimetría extraña: el agente recuerda mejor el código que cualquier persona del equipo y no recuerda en absoluto las decisiones que lo produjeron.
Además, el índice es por máquina. Vive en un directorio de caché bajo una cuenta, se comparte entre tus sesiones locales mediante un daemon de coordinación y se detiene en el límite de esa máquina.
Dónde vive el registro del trabajo
Una Task es la unidad principal de trabajo en Sharkly. Reúne la petición, el contexto, la ejecución, los bloqueos y el resultado en un único lugar compartido, en lugar de repartirlos entre prompts privados y sesiones de terminal.
Cada pieza tiene una función. El Agent define cómo debe gestionarse el trabajo. El Computer aporta el host y los recursos locales. El Runtime ejecuta la sesión real del agente, usando la herramienta de programación que ya está instalada allí. La Task sigue siendo el registro compartido.
Esa separación hace concreta la combinación. El índice es un recurso local de un Computer, así que el Computer que aloja un repositorio indexado es donde existe un grafo en caliente en lugar de un arranque en frío de tres minutos. Un Agent es una configuración guardada, así que el montaje en el que tu agente tiene el índice y los permisos adecuados se reutiliza en lugar de reconstruirse en cada máquina. Y la ejecución, los bloqueos, los resultados y el debate de seguimiento vuelven a la línea temporal de la tarea, que es donde sobrevive el razonamiento que hay detrás de un cambio.
Sharkly no sustituye a Claude Code, a Codex ni a codebase-memory-mcp. Añade a su alrededor una capa compartida de tareas, Computer, contexto, control y revisión. El uso de modelos sigue realizándose a través de las suscripciones o claves de API configuradas en esas herramientas.
Memoria del código más memoria del trabajo: esa es la combinación. Una da al agente el recuerdo del repositorio. La otra da al equipo el recuerdo de lo que los agentes hicieron en él.
Cuándo necesitas cada una
Instala codebase-memory-mcp ya, sea cual sea el tamaño de tu equipo. Es local, no exige cambiar el flujo de trabajo y la reducción de costes se aplica igual a un desarrollador que a veinte.
Añade un sistema de trabajo compartido cuando el razonamiento tenga que sobrevivir a la sesión: cuando la revisión ocurra antes del lanzamiento, cuando más de una persona toque el mismo repositorio o cuando alguien vaya a preguntar dentro de tres meses por qué se hizo un cambio. Un grafo responderá qué hace el código. Nunca responderá por qué.
Los agentes investigan, ejecutan, prueban e informan. Las personas marcan la dirección, otorgan autoridad y aceptan el resultado.
Preguntas frecuentes
¿Funciona con agentes distintos de Claude Code? Sí. Es un servidor MCP, así que sirve cualquier cliente MCP, y el proyecto enumera 45 superficies de agente compatibles, entre ellas Cursor, Codex, Windsurf, OpenCode y Aider.
¿Mi código sale de mi máquina? No. El procesamiento es totalmente local, y el proyecto afirma que no realiza ninguna petición de red propia ni comprueba si hay actualizaciones en segundo plano. El código fuente está disponible si prefieres verificar en lugar de confiar.
¿Es realista esa reducción del 99% en tokens? Esa cifra corresponde a cinco consultas estructurales, el mejor caso. La cifra revisada por pares en 31 repositorios es de 10 veces menos tokens y 2,1 veces menos llamadas a herramientas. Planifica contando con 10 veces.
¿Qué tamaño de repositorio puede manejar? El caso extremo que se menciona es el kernel de Linux, con 28 millones de líneas, en tres minutos. Los repositorios de aplicaciones normales se indexan en milisegundos.
¿Ayuda cuando se ejecutan varios agentes a la vez? Sí, y más de lo habitual. Cinco agentes haciendo grep en el mismo repositorio suponen cinco veces el desperdicio. Cada ejecución de una Task sigue teniendo su propio worktree aislado, mientras que el índice estructural se comparte en el Computer.
En resumen
Es la herramienta menos visible de la ola de 2026 y la que mejor rentabilidad ofrece. Un único binario nativo, ningún cambio en el flujo de trabajo y una reducción medida de un orden de magnitud en los tokens que un agente gasta respondiendo preguntas que no debería tener que resolver con grep. Instálalo, indexa tu proyecto y abre el visor del grafo una vez para ver qué ha construido.
Después, ten claro el límite. Recuerda el repositorio, no el trabajo, y las decisiones que hay detrás de un cambio mueren con la sesión a menos que algo las conserve. Sharkly se encarga de eso: la Task es el registro compartido, la ejecución corre en los Computers que conectas a través de los runtimes que ya pagas y los resultados vuelven a un lugar donde una persona puede revisarlos y aceptarlos.


