

Jev es un nuevo modelo de TypeSafe AI que no escribe código ni prosa. Le entregas un fragmento del estado de un programa, declaras las preguntas que necesitas responder y te devuelve respuestas tipadas con probabilidades calibradas. TypeSafe lo llama un System One Model. Llegó a Vercel AI Gateway el 16 de septiembre de 2026, y por eso de repente aparece en todos los feeds.
Para un equipo que ejecuta varios agentes de programación, lo interesante no es el modelo, sino dónde encaja un modelo de decisión dentro del stack. Tus agentes generan el trabajo. El problema difícil, como argumentamos en por qué la revisión humana es el cuello de botella, es decidir qué hacer con la salida de cinco ejecuciones a la vez: cuál necesita a una persona, cuál puede fusionarse, cuál está atascada. Jev está diseñado exactamente para ese tipo de pregunta. En este artículo explicamos qué es, qué no es y dónde encaja por encima de tus agentes.
Qué es Jev
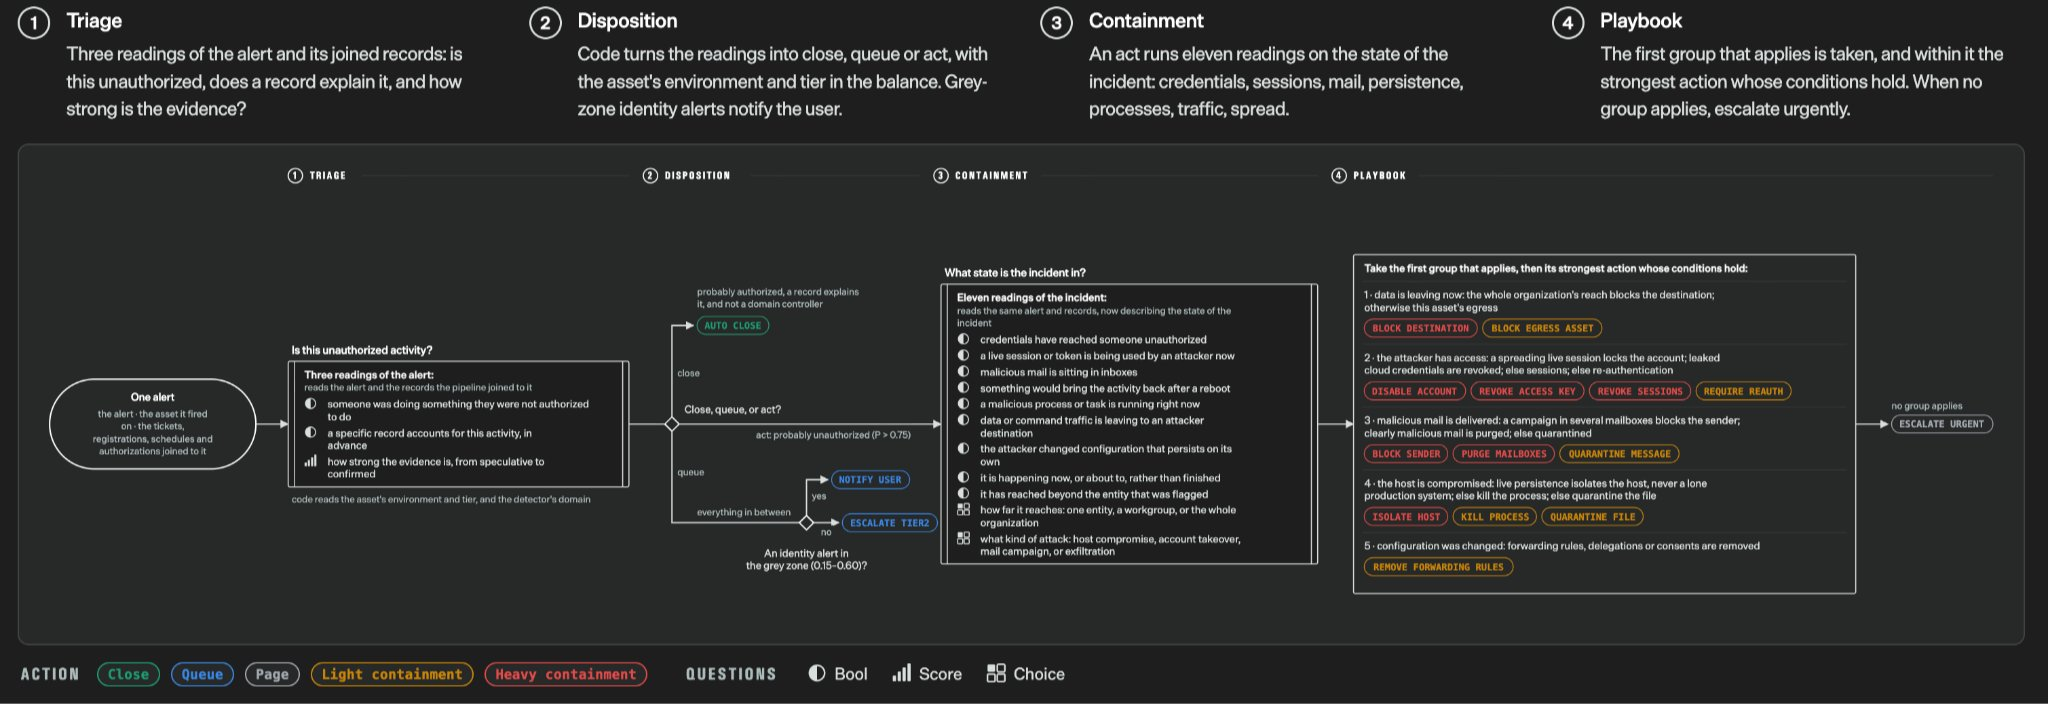
Un System One Model es un modelo que devuelve decisiones en lugar de texto. La publicación de lanzamiento de TypeSafe lo describe como «entra estado no estructurado, salen decisiones probabilísticas tipadas». Tres propiedades son las que importan.
La forma de la salida se declara antes de la llamada. Defines el tipo de cada pregunta de antemano y el modelo solo puede responder dentro de ese tipo. No hay texto que parsear ni desajustes de esquema que detectar.
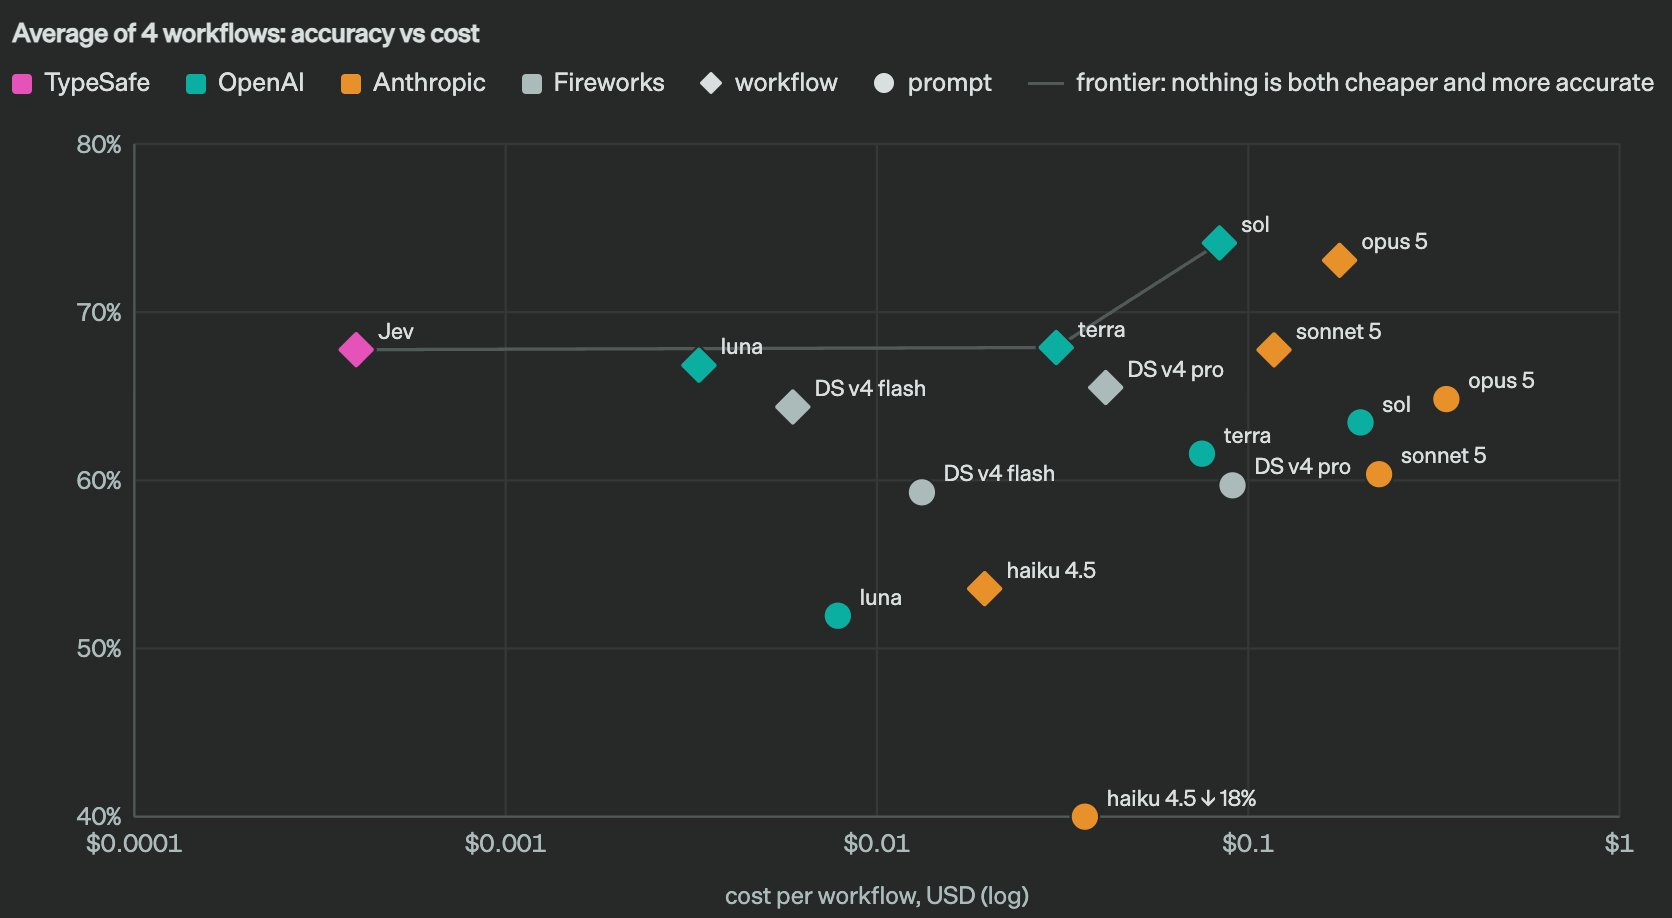
Cada respuesta lleva una probabilidad. Una pregunta de sí/no devuelve 0.97, no true. Una elección devuelve la distribución completa entre las opciones. TypeSafe lo entrenó con un método que llama Reinforcement Learning for Calibrated Decisions, y la promesa es que una mayor confianza implica una mayor precisión, de modo que puedes fijar un umbral: automatiza por encima de él y envía el resto a una persona.
Todas las preguntas se responden en paralelo, en una sola petición. Por eso TypeSafe habla de tiempos de extremo a extremo de 70 ms a 500 ms. Son cifras del proveedor, no un benchmark independiente, pero la arquitectura las explica: no se genera nada token a token.
Los tres tipos de pregunta
La API de Jev expone tres primitivas. Cada una es un objeto JSON bajo una clave que tú eliges, y todas se evalúan contra el mismo state.
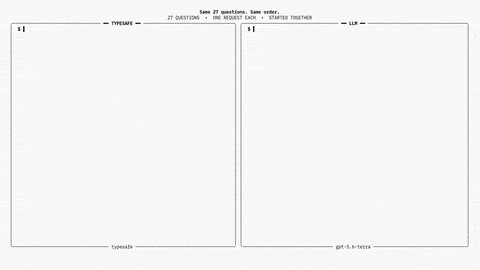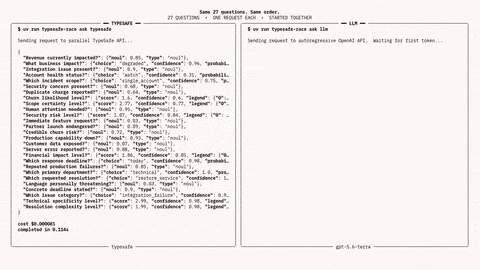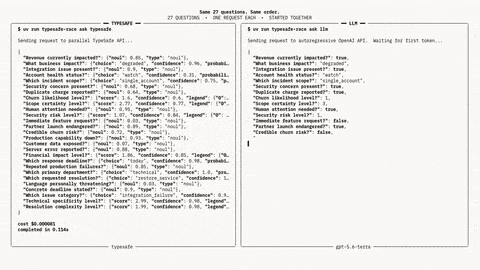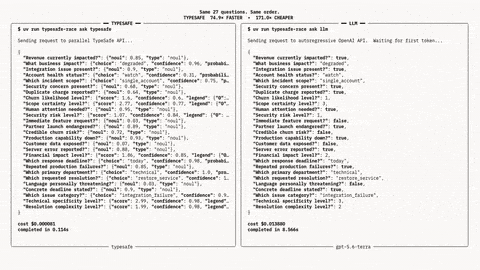
Noul es una probabilidad de sí/no. {"type": "noul", "instructions": "Does this run need a human before merge?"} devuelve {"noul": 0.91}. Tú le aplicas un umbral en el código.
Choice elige una opción de un conjunto con nombre de hasta 255. Le pasas criteria asociando nombres de opción a descripciones, y la respuesta incluye la elección, la distribución completa y una cifra de confianza.
Score sitúa el estado en una rúbrica ordenada de 2 a 10 niveles. La respuesta es una posición ponderada por probabilidad, de modo que un bug puede puntuar 1.3 entre «existe un workaround» y «bloqueante».
A través del Vercel AI SDK el tipo de sí/no se llama boolean y el campo es probability; contra el endpoint propio de TypeSafe es noul. La misma idea, una clave distinta.
Dónde encaja un modelo de decisión por encima de tus agentes
Este es el modelo mental que usamos. Los modelos producen tokens. Los agentes de programación (Claude Code, Codex, Gemini CLI, OpenCode) convierten tokens en cambios sobre un Computer. La capa de gestión decide quién trabaja en qué y qué ocurre con el resultado. Jev pertenece a esa capa superior, no a la intermedia. No es un agente y no puede editar un archivo. Es una respuesta rápida y tipada a una pregunta de gestión.
En cualquier tablero que ejecute agentes en paralelo surgen tres preguntas, y cada una se corresponde con una primitiva de Jev.
¿Qué Assignee debería encargarse de esta Task? Una Choice sobre tus Agents, con criteria que describa en qué destaca cada uno. El estado es el título, la descripción y el repositorio vinculado de la Task. Este es el paso de triaje que describimos en gestión y triaje de backlog con IA, hecho como una única llamada de 100 ms en lugar de una persona leyendo cuarenta tickets.
¿Necesita esta ejecución a una persona antes de fusionarse? Un Noul sobre el resumen del diff de la ejecución, los resultados de tests y las rutas tocadas. Por encima de 0.85, reténla para revisión; por debajo de 0.15, deja que la puerta de aprobación la deje pasar; en el medio, márcala. La idea no es eliminar al revisor, sino asegurarte de que su tarde se dedique a las ejecuciones que realmente lo necesitan.
¿Qué riesgo tiene este cambio? Un Score de «cosmético» a «toca auth o pagos», aplicado al mismo estado. Ese número ordena la cola de revisión, que es prácticamente para lo que sirve hacer seguimiento del trabajo completado por agentes de programación.
La comunidad llegó antes. En la semana siguiente al lanzamiento, los desarrolladores publicaron un flujo de revisión de código por etapas construido sobre Jev, un plugin de Claude Code que sustituye los resúmenes de compactación por decisiones de Jev sobre qué llamadas a herramientas conservar, y un «capataz de fábrica de software» que enruta el trabajo con él. Todos ellos son una capa de decisión por encima de un agente, que es el patrón que importa.
Una regla de decisión honesta
Usa Jev cuando la pregunta tenga un conjunto fijo de respuestas y necesites una probabilidad junto a ella: enrutamiento, severidad, «necesita revisión», «está atascada», «es honesta esta descripción del PR». Son las preguntas que un tablero hace cien veces al día.
No uses Jev cuando la pregunta requiera un juicio que no está en el estado. «¿Es esta la arquitectura correcta?» no es una Choice. «¿Aceptará el cliente esto?» no es un Score. Una probabilidad sobre esas preguntas es un número que parece una decisión. Deja a una persona, o a un modelo de lenguaje capaz de explicar su razonamiento, en ese lado de la línea.
Y no permitas que una probabilidad sustituya la puerta de revisión. Un 0.96 en «seguro para fusionar» es una señal fuerte para poner la ejecución al principio de la cola de una persona, no un motivo para saltársela. El límite que traza Sharkly es que la automatización se detiene donde se requiere el criterio del equipo, y un modelo de decisión no mueve esa línea. Lo que hace es acortar y ordenar mejor la cola del lado humano.
Cómo llamarlo
Directo: POST https://api.typesafe.ai/v1/systemone con una clave Bearer de console.typesafe.ai, modelo jev-latest (actualmente jev-1.13.0). A través de Vercel AI Gateway: modelo typesafe-ai/jev mediante experimental_evaluate en AI SDK 7, y ten en cuenta que la documentación del Gateway dice que la evaluación solo está disponible a través del AI SDK, no en los endpoints compatibles con OpenAI.
Una llamada de triaje que responde las tres preguntas a la vez:
{
  "model": "jev-latest",
  "state": { "task": "Fix double charge on retry", "diff_summary": "touches billing/retry.ts, adds idempotency key", "tests": "42 passed" },
  "questions": {
    "assignee": { "type": "choice", "instructions": "Which Agent should take this?",
      "criteria": { "codex": "backend and payments", "claude_code": "refactors and tests", "gemini_cli": "frontend" } },
    "needs_review": { "type": "noul", "instructions": "Does this change need a human before merge?" },
    "risk": { "type": "score", "instructions": "How risky is this change?",
      "criteria": ["cosmetic", "logic change with tests", "touches auth, billing, or data"] }
  }
}
Precio según la página de modelos de TypeSafe: 0,042 $ por millón de tokens de entrada, la salida no se cobra, 64k tokens por petición con 32k para el estado, solo texto. A ese precio, la llamada de triaje de arriba cuesta una fracción de céntimo, que es lo que hace viable ejecutarla en cada Task y cada ejecución.
Cómo se relaciona esto con Sharkly
Sharkly no llama a Jev por ti, y no es un modelo de decisión. Es la capa compartida de tareas, Computers, contexto y revisión que rodea a los agentes que ya ejecutas. Lo que te da un modelo como Jev es una forma barata y tipada de tomar las decisiones de enrutamiento y revisión que esa capa saca a la superficie: qué Assignee, qué cola, cuánta urgencia. Conéctalo a una Automation que crea una Task y elige el Agent, o ejecútalo sobre la salida de una ejecución completada antes de que el resultado llegue a un revisor. En cualquier caso, la decisión acaba en un lugar donde una persona puede verla, que es la parte que debe seguir siendo cierta diga lo que diga la probabilidad.
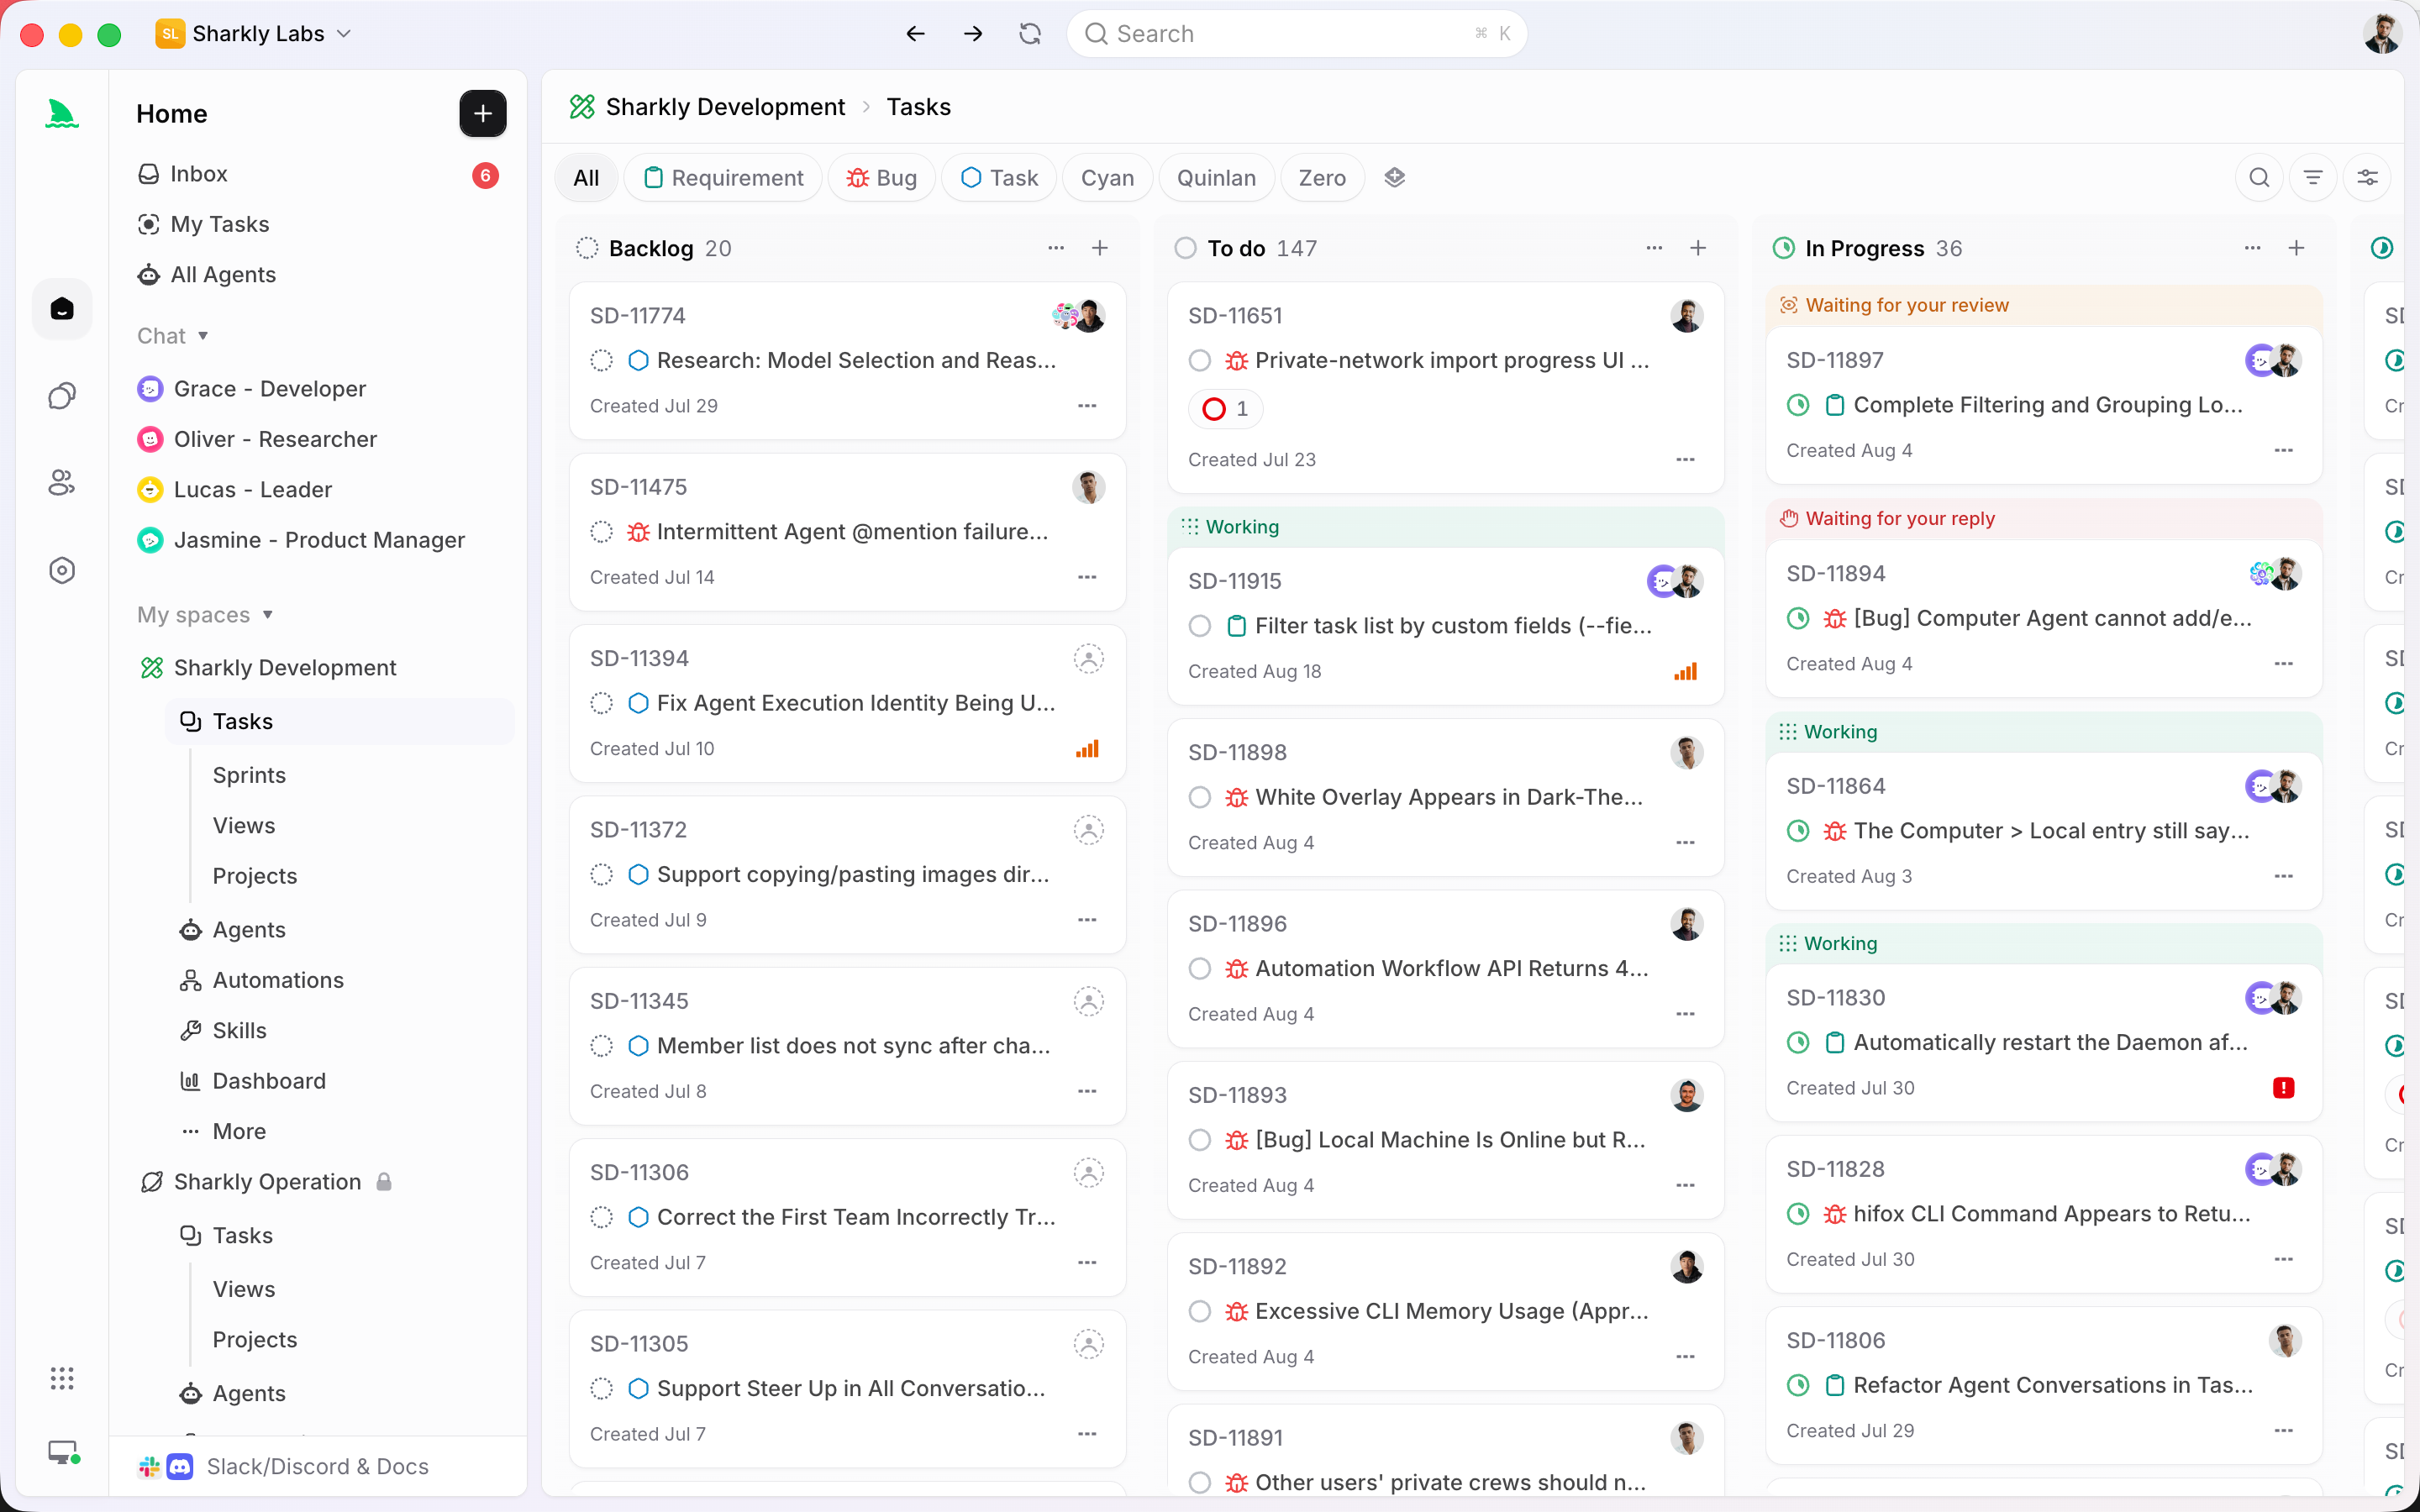
Si ejecutas más de un agente y lo que duele es la cola de revisión, empezar con Sharkly cubre el tablero, los Computers y el flujo de revisión en el que se enchufa un modelo de decisión.
Preguntas frecuentes
¿Jev es un agente de programación?
No. No puede generar código ni editar un archivo. Responde a preguntas declaradas sobre el estado que le das, con una probabilidad. Los agentes producen el trabajo; Jev ayuda a decidir qué hacer con él.
¿Puede sustituir la revisión de código?
No, y no debería. Puede ordenar la cola de revisión y sacar de ella los casos claros. La decisión de fusionar sigue siendo de una persona, que es el límite del que depende todo este flujo de trabajo.
¿Qué significa calibrado?
Si Jev dice 0.9, debería acertar aproximadamente el 90 % de las veces en ese tipo de pregunta. Compruébalo con tus propias ejecuciones antes de fiarte de un umbral: unas cuantas docenas de diffs etiquetados bastan para ver si el número significa lo que dice.
¿Necesito Vercel para usarlo?
No. La API directa funciona con una clave Bearer. El Gateway es una comodidad si ya usas el AI SDK.


