
Empiezas un agente de programación con una tarea real, cierras el portátil y te vas a comer. Esa parte es fácil. Lo difícil es lo que encuentras al volver: una terminal cuyo contenido ya se ha perdido por arriba, un diff que no viste escribirse y ninguna respuesta clara a la única pregunta que importa: si el trabajo es lo bastante bueno como para conservarlo.
Ejecutar un agente sin supervisión tiene dos mitades, y la mayoría de las configuraciones solo resuelve la primera. La primera mitad consiste en mantener el proceso vivo y productivo mientras nadie mira. La segunda es la cola de revisión: el montón de ejecuciones terminadas, a medias y fallidas que esperan una decisión humana cuando vuelves. Si te saltas la segunda mitad, los agentes sin supervisión solo trasladan el cuello de botella de escribir código a reconstruir lo que pasó.
Este artículo cubre ambas mitades: cómo montar tú mismo una ejecución sin supervisión, el modo de fallo en cada paso y dónde deja de escalar esa configuración casera. Cuando una terminal se convierte en cinco, un tablero de tareas como Sharkly se sitúa por encima de tus agentes de programación. Tú sigues usando Claude Code, Codex o Gemini CLI para hacer el trabajo, y Sharkly reúne la tarea, la ejecución y la revisión en un solo lugar en vez de repartirlas entre terminales que ya has cerrado.
Qué implica realmente ejecutar un agente sin supervisión
Una ejecución sin supervisión es un agente de programación llevando a cabo una tarea en un host que no estás vigilando activamente, con su salida capturada para revisarla después. Esa definición tiene tres partes esenciales: una tarea que el agente puede terminar sin ti, un host que sigue funcionando cuando te desconectas y un registro que puedes leer después.
El registro es la parte que la gente subestima. Cuando observas a un agente en directo, tú eres el log: ves que elige el archivo equivocado, lo interrumpes, corriges el rumbo. Sin supervisión, nada de eso ocurre. Todo lo que hizo el agente tiene que sobrevivir en un formato que puedas inspeccionar en frío, horas después, sin recordar qué le pediste. Los agentes investigan, ejecutan, prueban y reportan. Las personas marcan la dirección, otorgan autoridad y aceptan el resultado. Ese contrato solo se sostiene si el informe es real y completo cuando vuelves a él.
Así que el objetivo no es «hacer que el agente se ejecute sin mí», sino «hacer que el agente se ejecute sin mí y me devuelva algo que pueda revisar». Son problemas distintos, y el segundo es donde suelen romperse los flujos de trabajo sin supervisión.
Montar tú mismo una ejecución sin supervisión
Esta es la versión manual mínima, con el modo de fallo que muerde en cada paso.
Paso 1: aísla el trabajo. Dale a la ejecución su propio checkout para que no choque con tu editor ni con otro agente.
git worktree add ../task-auth-refactor -b task/auth-refactor
cd ../task-auth-refactor
Modo de fallo: si te lo saltas, dos ejecuciones en el mismo directorio sobrescribirán los cambios sin confirmar de la otra. Consulta un checkout por tarea para entender por qué los worktrees, y no solo las ramas, son la frontera de aislamiento.
Paso 2: desacopla el proceso. Tu sesión SSH o tu terminal se cerrará, y un proceso en primer plano muere con ella (SIGHUP). Mantenlo vivo con nohup o una sesión de tmux:
nohup claude -p "Refactor auth to use the new token service; run the tests" \
  > run.log 2>&1 &
Modo de fallo: si lo ejecutas en un shell normal en primer plano, cerrar la tapa mata al agente a mitad de una edición de varios archivos y deja un árbol roto. nohup arregla el tiempo de vida, pero no te da forma de volver a entrar; tmux te permite reconectarte y ver qué está pasando.
Paso 3: captúralo todo. El > run.log 2>&1 de arriba no es opcional. Es la cola de revisión en su forma más cruda.
Modo de fallo: sin un log capturado no puedes responder a «¿por qué se detuvo?». El bloqueo silencioso más habitual es un agente esperando indefinidamente en un prompt interactivo que nadie va a responder, porque sin supervisión no hay nadie ahí para escribir «sí». Ejecuta en modo no interactivo y preaprueba el conjunto reducido de acciones que la tarea necesita.
Paso 4: acota el radio de impacto. Decide, antes de irte, qué puede hacer el agente por su cuenta y qué te necesita a ti. Restringe el alcance de archivos, prohíbe el force-push y no dejes nunca que una ejecución sin supervisión haga merge a una rama protegida.
Modo de fallo: una ejecución con permisos de más que hace push directamente a main no es una victoria de productividad, es un incidente. Las puertas de aprobación existen para que el agente se detenga en el último punto seguro y espere.
Paso 5: entérate de cuándo terminó y cómo. Comprueba el código de salida y envíate una señal para no tener que consultar el log a mano:
claude -p "..." > run.log 2>&1; echo "exit $?" | mail -s "auth run done" [email protected]
Modo de fallo: sin señal de finalización, «sin supervisión» se convierte en «reviso la terminal cada veinte minutos», que no es más que trabajo supervisado con latencia extra.
Dónde deja de escalar la configuración casera
Un agente, un worktree, un archivo de log: esto funciona, y para una única ejecución no necesitas nada más pesado. La configuración se rompe en el momento en que hay más de uno.
Ejecuta tres agentes en tres tareas y ahora tienes tres worktrees, tres archivos de log, tres códigos de salida y tres correos de finalización que malinterpretarás de un vistazo. El aislamiento sigue aguantando. Lo que se desmorona es la cola de revisión. Nada te dice qué ejecución terminó limpiamente, cuál falló en los tests y cuál está esperando tranquilamente un prompt. Reconstruyes eso a mano, leyendo los logs uno por uno, que es exactamente el trabajo del que intentabas deshacerte.
Este es el coste real, y es fácil pasarlo por alto porque cada pieza parece estar bien por separado. Monitorizar varias ejecuciones en paralelo se convierte en un problema de verdad en cuanto el número supera lo que cabe en una pantalla. Un archivo de log responde a «qué imprimió esta ejecución», no a «de mis seis ejecuciones, cuáles tres me necesitan ahora mismo». Las señales de estado y de fallo que merece la pena capturar no se organizan solas en una cola. Y la cola es el sentido entero de trabajar mientras estás fuera: quieres una lista priorizada de decisiones, no un directorio de salida en bruto.
Qué cambia un tablero de tareas
Un tablero de tareas es donde se resuelve la segunda mitad del problema. La ejecución sin supervisión sigue ocurriendo en un Computer al que te conectas, con tu Runtime actual haciendo la programación. Lo que cambia es dónde aterriza el resultado.
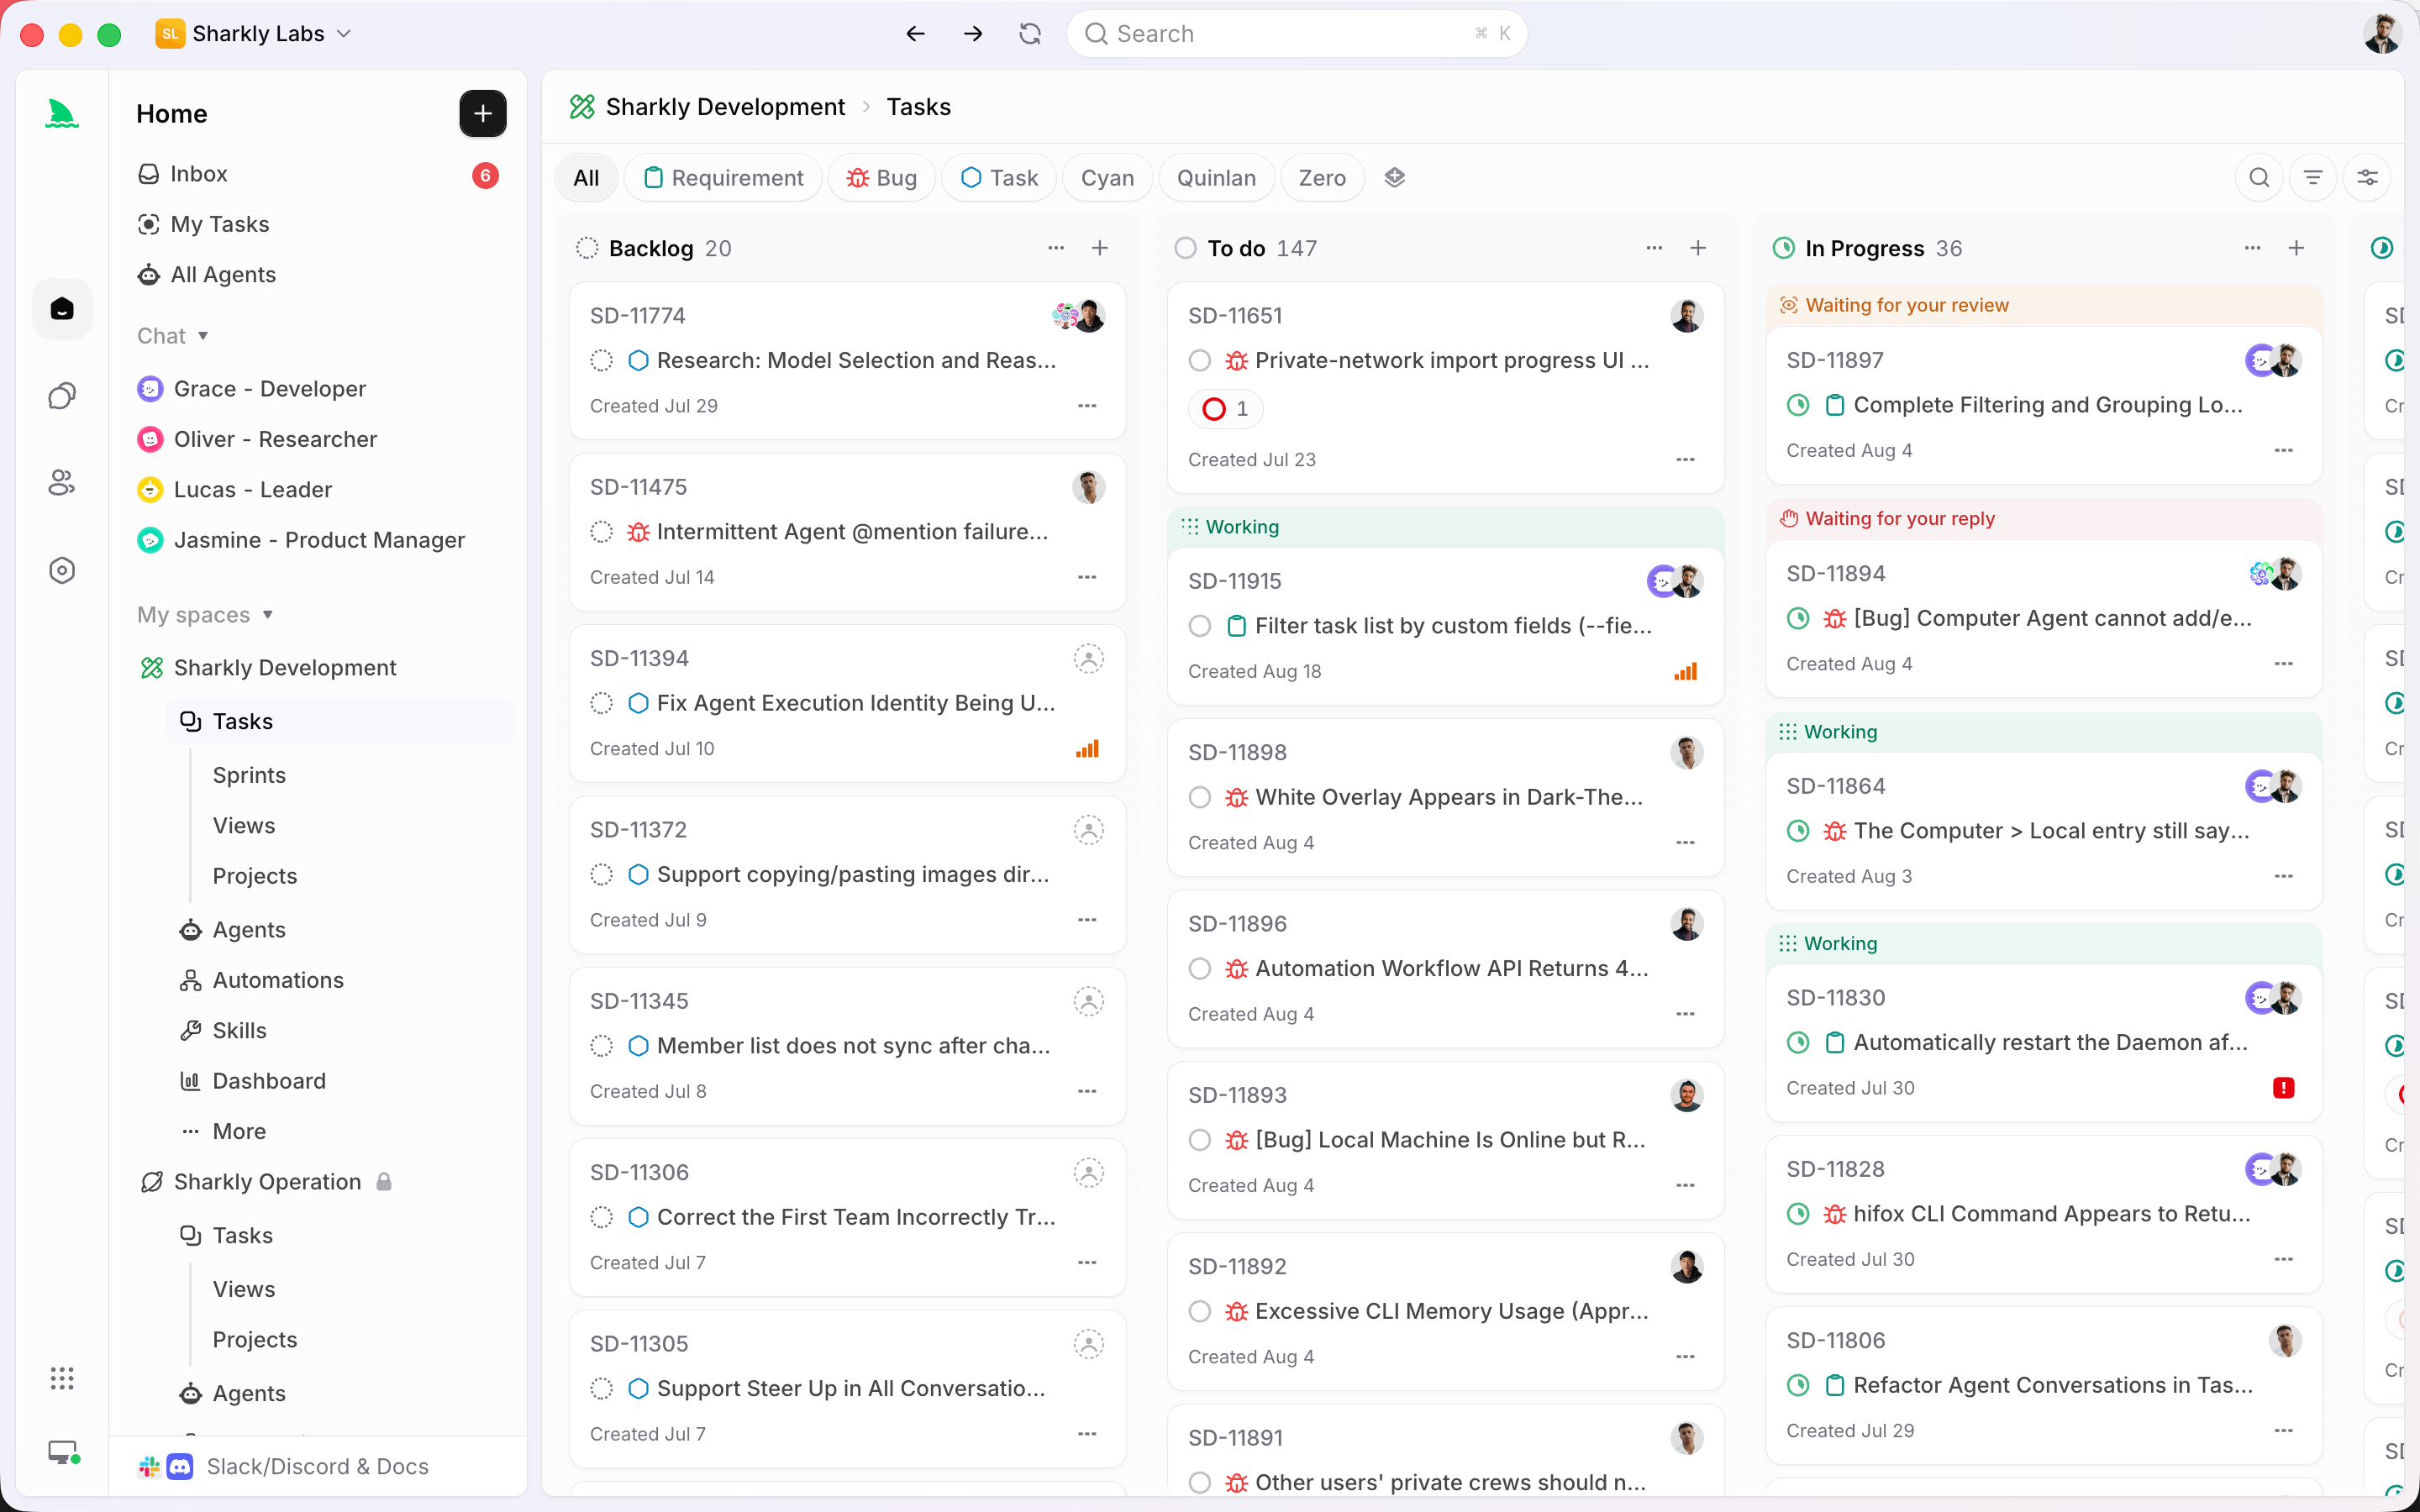
En Sharkly, el trabajo, la ejecución y la revisión viven en una única Task. Asignas la Task a un Agent, una configuración guardada de instrucciones, Runtime y repositorios, no un prompt puntual que reescribes cada vez. El Agent reclama la Task, se ejecuta en un worktree aislado, y su ejecución, bloqueos y resultados vuelven a la línea temporal de la Task. Cuando vuelves, no tienes que hacer grep en seis archivos de log. Abres el tablero y lees la cola: qué terminó, qué falló, qué te está esperando.
Esta es la frontera que merece la pena dejar clara. Sharkly no sustituye a Claude Code, Codex ni otras herramientas de ejecución. Añade la capa compartida de tareas, Computer, contexto y revisión alrededor de las herramientas que tu equipo ya usa. El agente sigue escribiendo el código. Sharkly se asegura de que, mientras tú no estabas, el código volviera a un sitio donde puedes verlo, con el resumen de cambios y los resultados de los tests adjuntos, y de que la aceptación final siga siendo una decisión humana. La automatización se detiene donde se requiere criterio.
Puedes construir todo esto a mano con worktrees, nohup y un comando de correo. La regla de decisión honesta: si ejecutas un agente de vez en cuando, la configuración manual está bien y Sharkly es una sobrecarga que no necesitas. La ecuación cambia cuando varios agentes se ejecutan por tareas y repositorios y la cola de revisión se convierte en aquello a lo que dedicas la mañana. Si quieres seguir usando varios agentes de programación en lugar de comprometerte con un único ecosistema, esa cola es el problema en torno al cual Sharkly está diseñado.
La cola de revisión es el verdadero cuello de botella
Aquí hay una suposición que merece la pena cuestionar: la gente optimiza la ejecución sin supervisión y trata la revisión como algo secundario. Es al revés. Ejecutar agentes en paralelo mientras duermes solo es una ventaja si revisar su salida a la mañana siguiente es más rápido que haber hecho el trabajo tú mismo. Cuando cinco agentes terminan de un tirón durante la noche y revisar los cinco diffs lleva más tiempo que escribir dos de ellos, el paralelismo no produjo nada.
Así que diseña primero la cola de revisión. Decide qué debe incluir «terminado» antes de que una ejecución llegue a ti: tests que pasan, un typecheck, un resumen de cambios y una nota de límites conocidos. Ordena la cola por riesgo, no por hora de finalización, para que la ejecución que tocó la autenticación reciba tu atención antes que la que corrigió una errata. Haz que «solicitar cambios» sea tan barato como «aprobar», porque la mitad de las ejecuciones sin supervisión estarán casi bien pero no del todo. La revisión es el cuello de botella en cualquier flujo de trabajo con agentes en paralelo, y dónde se ejecutan físicamente los agentes, tu servidor, tu portátil o ambos, importa mucho menos que si su salida llega como una cola que puedes vaciar.
Una lista de comprobación que puedes aplicar hoy
Antes de alejarte de un agente, confirma:
- Aislamiento: la ejecución tiene su propio worktree, no tu checkout de trabajo.
- Tiempo de vida: el proceso sobrevive a una desconexión (
nohup,tmuxo un Computer gestionado), así que cerrar la tapa no lo mata a mitad de edición. - Captura: stdout y stderr van a un log duradero o a una línea temporal de Task que puedes leer en frío.
- No interactivo: el agente no se quedará atascado en un prompt que nadie va a responder.
- Radio de impacto: el alcance de archivos está limitado, el force-push está desactivado y ninguna ejecución sin supervisión hace merge a una rama protegida.
- Señal de finalización: te avisan cuando termina y si pasó, sin necesidad de consultar el estado.
- Contrato de revisión: cada ejecución terminada llega con tests, un resumen de cambios y límites conocidos, y la aceptación sigue siendo tuya.
Las seis primeras hacen que la ejecución sea sin supervisión. La última hace que merezca la pena. Si ya ejecutas varios agentes y la revisión matutina es donde se va tu tiempo, pasa tus agentes de programación actuales por Sharkly para que la cola llegue a ti organizada en lugar de dispersa.


