
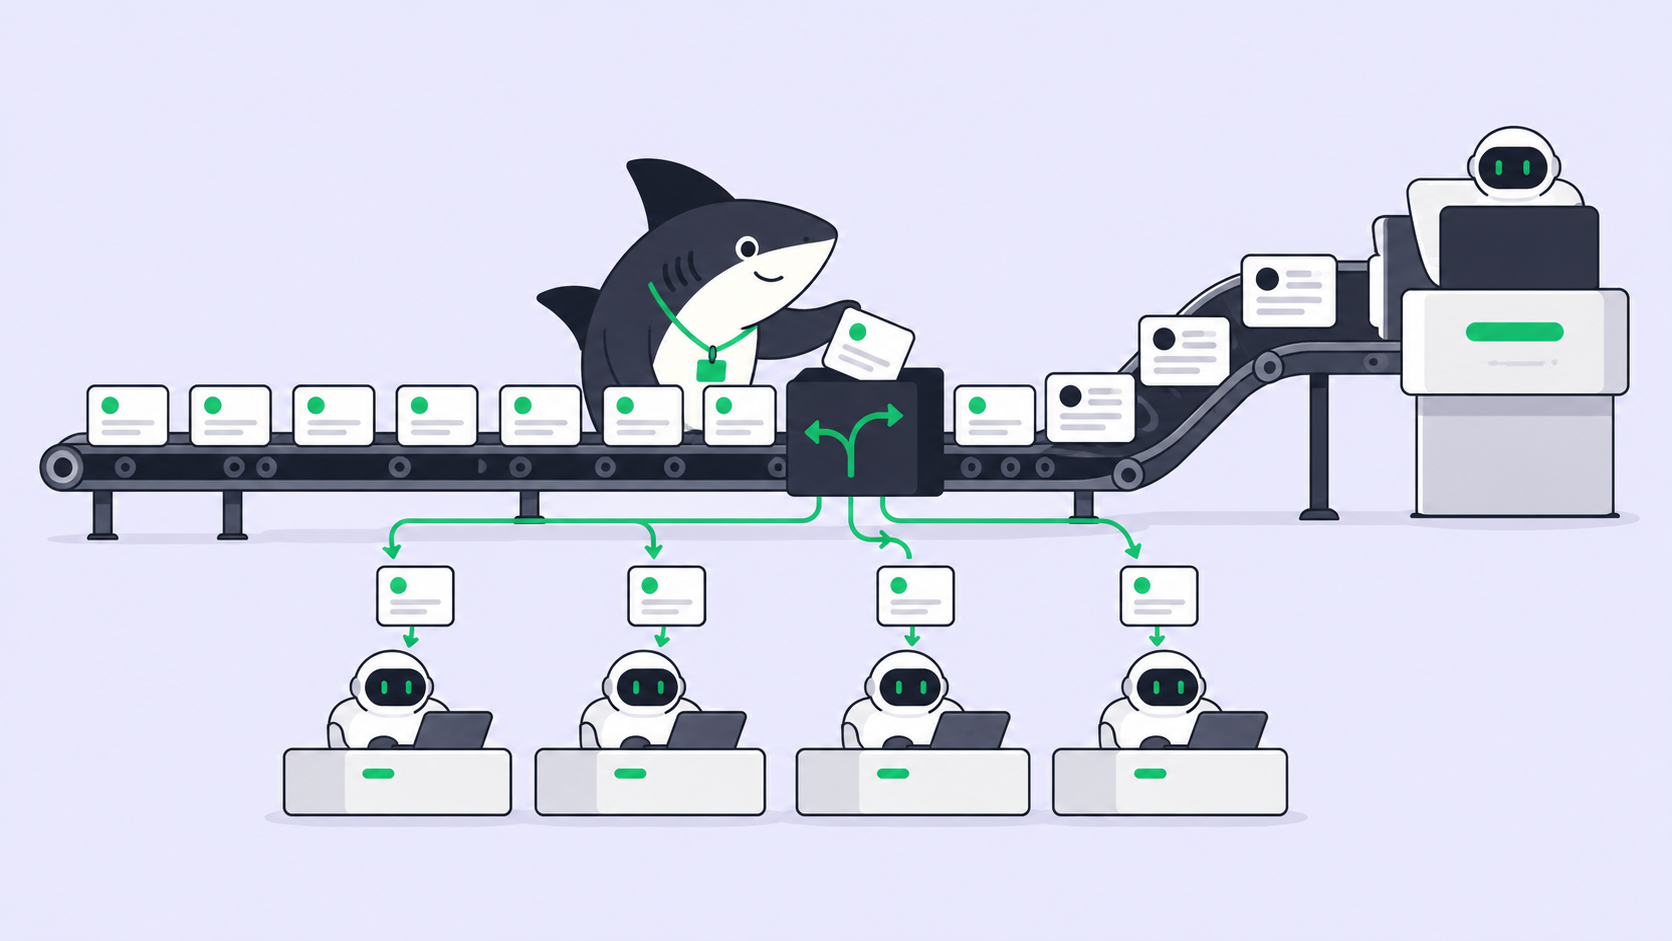
La comparativa entre GPT-6.1 Terra y GPT-6.1 Sol se reduce a una sola compensación: Terra cuesta exactamente la mitad que Sol por token y, según OpenAI, funciona más de tres veces más rápido, mientras que Sol obtiene una puntuación de 54 frente al 48 de Terra en un benchmark externo de agentes de programación. OpenAI lanzó Terra el 26 de octubre como gpt-6.1-terra, el nuevo nivel intermedio entre Sol y GPT-6 Luna.
Si solo utilizas un agente de programación, elige el modelo que más te inspire confianza y sigue adelante. Pero si ejecutas una docena, la configuración predeterminada importa mucho más que la excepción, ya que es en ella donde se factura la gran mayoría de los pasos de tus agentes. En este artículo te presentamos una regla de enrutamiento para un Crew en Sharkly: Terra por defecto para los miembros, Sol para el líder y los casos complejos residuales, junto con el coste por cada 1000 pasos de agente para cada combinación.
TL;DR
Establece GPT-6.1 Terra como el modelo de ejecución predeterminado para los miembros del Crew que realizan tareas rutinarias de programación, redacción y uso del ordenador. Reserva GPT-6.1 Sol para el líder del Crew y para las tareas que hayan fallado dos veces en Terra. Según nuestro perfil de pasos de muestra, una configuración basada exclusivamente en Sol cuesta 26,55 $ por cada 1000 pasos de agente, una basada solo en Terra cuesta 13,28 $ y utilizar miembros con Terra bajo un líder con Sol cuesta 14,60 $. Una regla que priorice Terra con escalado a Sol sigue saliendo más económica que utilizar exclusivamente Sol hasta que la mitad de tus tareas requieran escalado.
GPT-6.1 Terra frente a GPT-6.1 Sol de un vistazo
| GPT-6.1 Terra | GPT-6.1 Sol | |
|---|---|---|
| ID de API | gpt-6.1-terra |
gpt-6.1-sol |
| Entrada / caché / salida por millón de tokens | $1 / $0.05 / $5 | $2 / $0.10 / $10 |
| Coding Agent Index (Artificial Analysis) | 48 | 54 |
| Velocidad (OpenAI) | más de 3 veces más rápido de media | referencia base |
| Nivel mínimo de esfuerzo | none |
low |
| Posicionamiento según OpenAI | uso del ordenador, redacción, comprensión visual | programación de máxima complejidad |
Cada línea de precio cuesta exactamente la mitad. Esto simplifica enormemente la decisión en términos de costes y traslada la verdadera incógnita a la calidad: ¿con qué frecuencia la menor puntuación de Terra en programación se traduce en tener que repetir ejecuciones?
Existen algunos detalles en las tarifas de Terra que son relevantes para bucles de agentes prolongados. Batch y Flex cuestan la mitad de la tarifa estándar, mientras que el modo Fast cuesta el doble. Las peticiones con más de 272 000 tokens de entrada se facturan al doble en las tarifas de entrada y caché, y a 1,5 veces en la de salida para toda la solicitud. Puedes consultar la tabla de tarifas completa en la página de precios de OpenAI.
Qué determina un entorno de ejecución predeterminado
El modelo de ejecución predeterminado es el que utiliza un agente cuando no se especifica uno concreto para una ejecución. En un Crew, determina cuánto cuesta la gran mayoría de tus pasos, cuánto tiempo esperan las tareas en cola y cuántos resultados llegan a revisión cada día.
En este contexto, un paso de agente se refiere a una llamada al modelo dentro del bucle del agente: leer el contexto, razonar y emitir una llamada a una herramienta o una edición de código. Una sola tarea puede requerir docenas de pasos. Por esta razón, calcular los costes por paso resulta mucho más útil que hacerlo por tarea al comparar entornos de ejecución: la duración de una tarea varía enormemente, pero la estructura de un paso se mantiene constante.
Coste por cada 1000 pasos de agente
Para comparar las distintas combinaciones, definamos un paso representativo: 30 000 tokens de entrada (con un 85 % de aciertos en la caché de prompts) y 1500 tokens de salida, incluido el razonamiento. Los bucles de agente prolongados reenvían el contexto del repositorio en cada paso, por lo que una tasa de acierto en caché elevada es habitual una vez que la sesión entra en calor.
Con los precios oficiales facturados mediante clave de API, dicho paso cuesta 0,0133 $ en Terra y 0,0266 $ en Sol. Al extrapolarlo a 1000 pasos:
| Combinación del Crew | Porcentaje de pasos en Sol | Coste por cada 1000 pasos |
|---|---|---|
| Solo Sol | 100% | 26,55 $ |
| Miembros con Terra, líder con Sol | 10% | 14,60 $ |
| Miembros con Terra, líder y casos complejos con Sol | 25% | 16,59 $ |
| Solo Terra | 0% | 13,28 $ |
| Solo Terra con mayor nivel de esfuerzo (3000 tokens de salida) | 0% | 20,78 $ |
De estos datos destacan dos conclusiones. En primer lugar, asignar el rol de líder a Sol supone solo unos 1,30 $ adicionales por cada 1000 pasos en comparación con una configuración exclusiva de Terra, ya que el líder se encarga de planificar y delegar, asumiendo una fracción reducida de los pasos totales. En segundo lugar, Terra con un mayor nivel de esfuerzo sigue siendo más económico que Sol en su configuración por defecto: duplicar los tokens de salida en Terra cuesta menos que cambiar de modelo.
Estas cifras no incluyen los cargos por escritura en caché. Si tus Computers inician sesión mediante una suscripción de ChatGPT en lugar de una clave de API, el ahorro no se reflejará directamente en dólares, sino en una mayor cantidad de ejecuciones disponibles antes de alcanzar los límites de tu plan. Según OpenAI, Terra está «disponible para todos los usuarios de Plus, Pro, Enterprise y Edu en ChatGPT Work y Codex»; los planes Free y Go no lo incluyen.
Regla de enrutamiento para un Crew de Sharkly
Un Crew en Sharkly es un grupo reutilizable de personas y agentes coordinado por un agente líder. La ejecución sigue una jerarquía centrada en el líder: este lee la tarea y las instrucciones del Crew, y posteriormente realiza el trabajo o delega partes concretas mencionando a los agentes miembros. Esta estructura encaja a la perfección con dos entornos de ejecución.
- El líder con GPT-6.1 Sol. El líder interpreta objetivos ambiguos y decide los siguientes pasos. Un plan equivocado desvía a todos los miembros, por lo que este puesto justifica el uso del modelo más potente. Nuestra guía para líderes de Crew explica por qué actualizar el rol del líder resulta comparativamente muy económico.
- Miembros con GPT-6.1 Terra en
medium. Las tareas rutinarias de programación, refactorizaciones, pruebas, documentación, descripciones de PR y tareas de uso del ordenador comienzan aquí. - Escalar al segundo fallo. Cuando un miembro con Terra falla una tarea dos veces, una persona la reasigna a la variante con Sol. No permitas que los agentes escalen de forma autónoma por pura intuición; conviene que la decisión quede registrada y visible en la tarea.
- Monitorizar las derivaciones por tipo de tarea. Si una categoría concreta de tarea, como las migraciones entre microservicios, escala sistemáticamente, enrútala a Sol desde el principio.
- Delegar el triaje a Luna. El etiquetado y la clasificación inicial pueden descender un nivel más; la guía de GPT-6 Luna detalla ese flujo de trabajo.
Esta es una regla de partida, no una verdad absoluta respaldada por un benchmark. Pruébala durante un sprint y deja que tu propia tasa de escalado determine dónde trazar la línea.
Cuándo deja de ser rentable priorizar Terra
Escalar tareas tiene un coste: un intento fallido en Terra representa dinero invertido antes de iniciar la ejecución en Sol. Calculemos el peor de los casos, en el que el intento en Terra consume tantos pasos como requeriría una ejecución completa en Sol. Si una ejecución en Sol cuesta S, un intento en Terra cuesta 0,5S. Si una proporción f de tareas se escala, el coste esperado por tarea es 0,5S + f multiplicado por S.
Dicho coste iguala al de usar exclusivamente Sol cuando f alcanza 0,5. Por tanto, priorizar Terra sigue siendo más rentable hasta que la mitad de tus tareas requieran escalado. Esta misma lógica se aplica a ejecuciones más extensas: Terra sigue siendo más económico por tarea siempre y cuando no necesite el doble de pasos que Sol para completarla.
Dado que el umbral de rentabilidad económica está muy lejos, el verdadero factor limitante suele ser el tiempo humano. Cada intento fallido supone un diff que alguien debe revisar, un registro que alguien debe inspeccionar y una reasignación manual. Si la tasa de escalado supera el 20 % en un tipo específico de tarea, migra esa categoría directamente a Sol, aunque el cálculo de tokens siga favoreciendo a Terra.
La velocidad también influye en la ecuación. Un modelo que finaliza más de tres veces más rápido libera antes el Computer, lo que permite que las tareas en cola comiencen antes y que un mayor número de ejecuciones concluya dentro del límite de tiempo asignado.
Cómo configurar la regla en Sharkly
Sharkly no comercializa tokens. Las ejecuciones se facturan directamente contra el plan de Codex o la clave de API vinculada al Runtime en cada Computer. Por tanto, comprueba primero que Terra funcione en ese entorno: necesitas la CLI de Codex 0.159.0 o superior y ejecutar codex -m gpt-6.1-terra en una terminal.
En Sharkly, la documentación de Agents especifica que un agente «adopta el modelo del Runtime de forma predeterminada», y la fila Model permite seleccionar otro modelo del catálogo disponible en dicho Runtime. También es posible definir el modelo mediante Custom arguments tanto en el agente como en el Runtime.
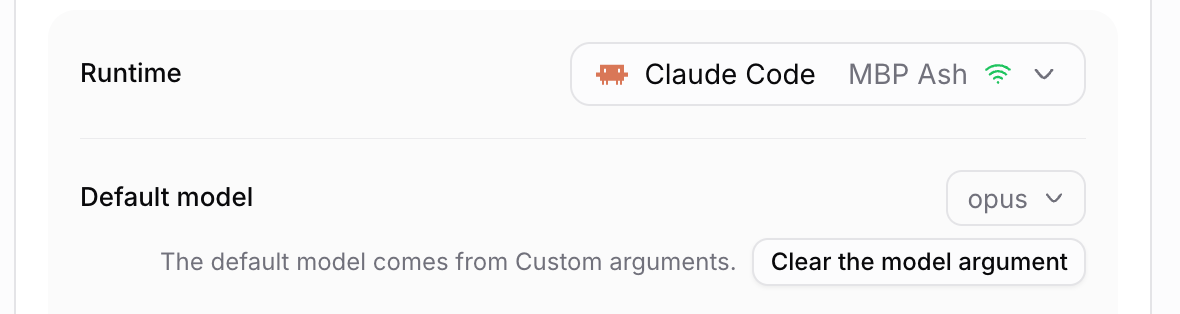
Es preferible estructurar esta regla mediante variantes en lugar de modificar la configuración base. A continuación se muestra un esquema de las tres opciones:
Agent "Codex, routine"   Custom arguments: --model gpt-6.1-terra   effort: medium
Agent "Codex, hard tail" Custom arguments: --model gpt-6.1-sol     effort: medium
Crew leader              Custom arguments: --model gpt-6.1-sol
La documentación cita «utilizar un modelo predeterminado distinto» como un caso de uso idóneo para crear una variante de agente: esto conserva las instrucciones y los repositorios del original y solo reemplaza el modelo. Contar con dos variantes mantiene el panel despejado y legible, ya que cada tarea muestra de inmediato en qué línea se ejecutó. Si solo deseas realizar una prueba puntual, el selector de modelo por ejecución dentro del selector de asignación (Assignee) anula el valor predeterminado del agente exclusivamente para esa ejecución.
Sharkly conserva el contexto, el progreso, los bloqueos, los resultados y la revisión humana dentro de la propia tarea, independientemente del modelo con el que se haya ejecutado; precisamente esto es lo que permite medir con precisión la tasa de escalado.
Lo que un modelo predeterminado más económico no soluciona
Terra reduce el coste de generar cambios, pero no el de aceptarlos. Ejecuciones a mitad de precio y al triple de velocidad pueden traducirse en un aluvión de diffs pendientes de revisión humana al final de la semana. Revisa tu cola de revisión antes de añadir más miembros; nuestro artículo sobre cómo la revisión humana representa el verdadero cuello de botella analiza este aspecto en detalle.
Tampoco resuelve las tareas más complejas. La propia OpenAI recomienda Sol o GPT-6 Astra para los desarrollos más exigentes, y la diferencia de seis puntos en el Coding Agent Index apunta en la misma dirección. La regla que hemos propuesto delega deliberadamente ese tipo de trabajo en Sol.
Conclusión
Establece Terra como la opción predeterminada y Sol como la excepción. En nuestro perfil de pasos de muestra, este enfoque reduce la factura prácticamente a la mitad en comparación con utilizar únicamente Sol, manteniendo al líder y los casos complejos en el modelo superior. Monitorea la tasa de escalado, y no solo el precio por token, para determinar cuándo conviene migrar un tipo de tarea.
Tu siguiente paso: crea una variante con Terra de un agente de Codex, intégrala en un Crew bajo un líder con Sol y ponla a prueba durante un sprint. Actualmente, Sharkly es gratuito para organizaciones de hasta 5 personas, según se indica en la página de precios.
Preguntas frecuentes
¿Es GPT-6.1 Terra mejor que GPT-6.1 Sol para programar?
No. Sol obtiene una puntuación de 54 en el Coding Agent Index de Artificial Analysis, frente a los 48 de Terra. Terra destaca en coste y velocidad, motivo por el cual resulta ideal para tareas rutinarias de desarrollo en lugar de los desafíos más complejos.
¿Cuánto más económico es GPT-6.1 Terra respecto a GPT-6.1 Sol?
Exactamente la mitad en todos los conceptos: 1 $ frente a 2 $ en entrada, 0,05 $ frente a 0,10 $ en caché y 5 $ frente a 10 $ en salida por millón de tokens.
¿Debería el líder del Crew ejecutarse con Terra?
Es preferible comenzar con Sol. El líder solo ejecuta una fracción reducida de los pasos totales, por lo que mejorarlo cuesta muy poco, mientras que un plan deficiente desorientaría a todos los miembros.
¿Se puede usar el nivel de esfuerzo none en Sol?
No. GPT-6.1 Sol eliminó none, y su nivel mínimo es low. Terra recupera la opción none.
¿Es gratuito GPT-6.1 Terra?
No. No cuenta con un nivel de API gratuito y los planes Free y Go de ChatGPT no lo incluyen. Nuestro artículo sobre cómo ejecutar GPT-6.1 Sol sin clave de API profundiza en las diferencias entre el uso mediante suscripción y la facturación por tokens.
¿Cómo cambio una tarea concreta a Sol sin modificar el agente?
Utiliza la selección de modelo por ejecución dentro del selector de asignación (Assignee). Esto anula el valor predeterminado del agente únicamente para esa ejecución.


