Respuesta rápida: El soporte de GPT-6.2 Codex llegó el 17 de noviembre de 2026. Elige gpt-6.2-astra para bugs multi-servicio e ingeniería abierta, y gpt-6.2-sol para programación cotidiana, revisión de pull requests y revisiones. Cambia de modelo con /model en la CLI, con el selector de modelos de la app, o con una línea en ~/.codex/config.toml. Empieza con el nivel de esfuerzo que seleccione tu cliente, y súbelo solo cuando una tarea requiera una verificación más profunda.
OpenAI lanzó GPT-6.2 Astra y GPT-6.2 Sol en ChatGPT Work, Codex y la API el mismo día. Si gestionas agentes de Codex, la pregunta ya no es tanto «qué modelo es más inteligente», sino «qué modelo va en qué tarea y cómo hago que todas las instalaciones de Codex coincidan». Esta guía cubre ambos casos: la configuración por sesión en un solo Computer y la configuración de equipo cuando varios agentes de Codex comparten un tablero, que es donde entra Sharkly.
Qué cambia GPT-6.2 en Codex
GPT-6.2 aporta a Codex dos nuevos IDs de modelo, un contexto por defecto más grande para Sol, una Astra más barata y una nueva advertencia sobre cómo los modelos informan de los bloqueos. Este es el cambio que notará un usuario de Codex, según el post de lanzamiento de OpenAI, la página de modelos de Codex y las páginas de modelos de la API.
| GPT-6.2 Astra | GPT-6.2 Sol | |
|---|---|---|
| ID del modelo | gpt-6.2-astra |
gpt-6.2-sol |
| Uso en Codex según OpenAI | Rastrear un bug entre servicios, corregirlo y probar el cambio | Revisar un pull request, revisar código tras recibir comentarios |
| Contexto por defecto en Codex | 272 000 tokens | 500 000 tokens |
Contexto máximo (definir model_context_window) |
Hasta 1M de tokens | Hasta 1M de tokens |
| Precio de la API por 1M (entrada / caché / salida) | $8 / $0.40 / $40 | $2 / $0.10 / $10 |
| Corte de conocimiento | 18 de mayo de 2026 | 1 de junio de 2026 |
Esfuerzo de razonamiento none |
Rechazado por la API | Rechazado por la API |
Dos números explican el lanzamiento. Los precios de entrada y salida de Astra bajaron un 20 % respecto a GPT-6 Astra, y la entrada en caché bajó un 60 %. Sol mantiene las tarifas de GPT-6.1 Sol, y OpenAI afirma que completa más tareas en el mismo plan de pago. En FrontierCode 2.0 de Cognition, que evalúa si los cambios en código real cumplen los estándares de los maintainers para fusionarse, OpenAI reporta a Sol a menos de 0.5 puntos de Astra con aproximadamente una quinta parte del costo, ambos al máximo esfuerzo. Son resultados de OpenAI, así que tómalos como un motivo para probarlo, no como un veredicto.
Cómo cambiar Codex a GPT-6.2
Puedes cambiar el modelo para una sesión, para todas las sesiones de un Computer o para un repositorio. Los fundamentos de configuración de Codex definen el orden de prioridad: los flags de la CLI ganan, luego la configuración del proyecto y, por último, tu configuración de usuario.
- Actualiza Codex a una versión que incluya los modelos GPT-6.2. Codex CLI 0.169.1 se lanzó el mismo día que los modelos.
- Para una sola sesión, escribe
/modelen la CLI, eligegpt-6.2-astraogpt-6.2-soly, después, selecciona un nivel de esfuerzo. - Para un solo comando, pasa el flag:
codex -m gpt-6.2-sol. - Para todas las sesiones de ese Computer, configúralo en
~/.codex/config.toml. - Para un solo repositorio, pon las mismas claves en el
.codex/config.tomldel repositorio. Codex solo carga la configuración de proyecto en proyectos de confianza.
# ~/.codex/config.toml
model = "gpt-6.2-sol"
model_reasoning_effort = "medium"

# Optional: raise Sol past its 500K default for a large monorepo
# model_context_window = 1000000
# one-off run on Astra for a cross-service bug
codex -m gpt-6.2-astra "Trace why checkout retries double-charge in staging, fix it, and run the payment tests"
En la app de Codex, el control de modelo y razonamiento está debajo del compositor. Si ves el deslizador Power en lugar de una lista de modelos, abre Advanced para elegir un modelo concreto como GPT-6.2 Astra.
El acceso según el plan importa. La documentación de OpenAI incluye Plus, Pro, Business, Enterprise y Edu para Codex y Work, y los administradores de Enterprise y Edu deben habilitar primero los modelos en la configuración del workspace. Codex y Work comparten el uso, así que una larga sesión de Astra en Work deja menos cupo para tus agentes de Codex ese día.
Astra o Sol: qué modelo para qué tarea de programación
Usa Sol como opción por defecto y escala una tarea a Astra cuando cruce fronteras entre sistemas o no tenga un punto de finalización claro. La propia guía de selección de modelos de OpenAI asocia cada modelo con un nivel de esfuerzo, y esas combinaciones ofrecen un mapa inicial útil.
| Tarea | Empezar con | Por qué |
|---|---|---|
| Arreglar un bug con reproducción, añadir una funcionalidad en un módulo | Sol, Medium | La combinación de OpenAI para correcciones y adiciones en una base de código existente |
| Revisar un pull request, revisar código tras comentarios de revisión | Sol, Medium | Los casos de uso de Codex que OpenAI nombra para Sol |
| Cambio de varios pasos que necesita pruebas y revisiones por el camino | Sol, Extra High | Un esfuerzo mayor sostiene la tarea hasta sus verificaciones finales |
| Convertir un brief claro en un trabajo terminado y pulido | Astra, Low | La combinación de OpenAI para trabajo de Astra bien especificado |
| Diagnosticar un bug entre servicios y probar la corrección | Astra, de Medium a High | El ejemplo que OpenAI da para Astra en Codex |
| Decisiones de diseño abiertas, varias causas que interactúan | Astra, Extra High | Sopesar opciones y poner a prueba supuestos |
El orden importa para el costo. OpenAI sitúa a Astra primero en ingeniería de software, pero Sol cuesta un cuarto de lo que cuesta Astra por token y tiene un contexto por defecto más largo. La mayor parte de la cola de trabajo de un equipo consiste en tareas acotadas, así que la mayoría debe ir a Sol.
Esfuerzo, Ultra y subagentes
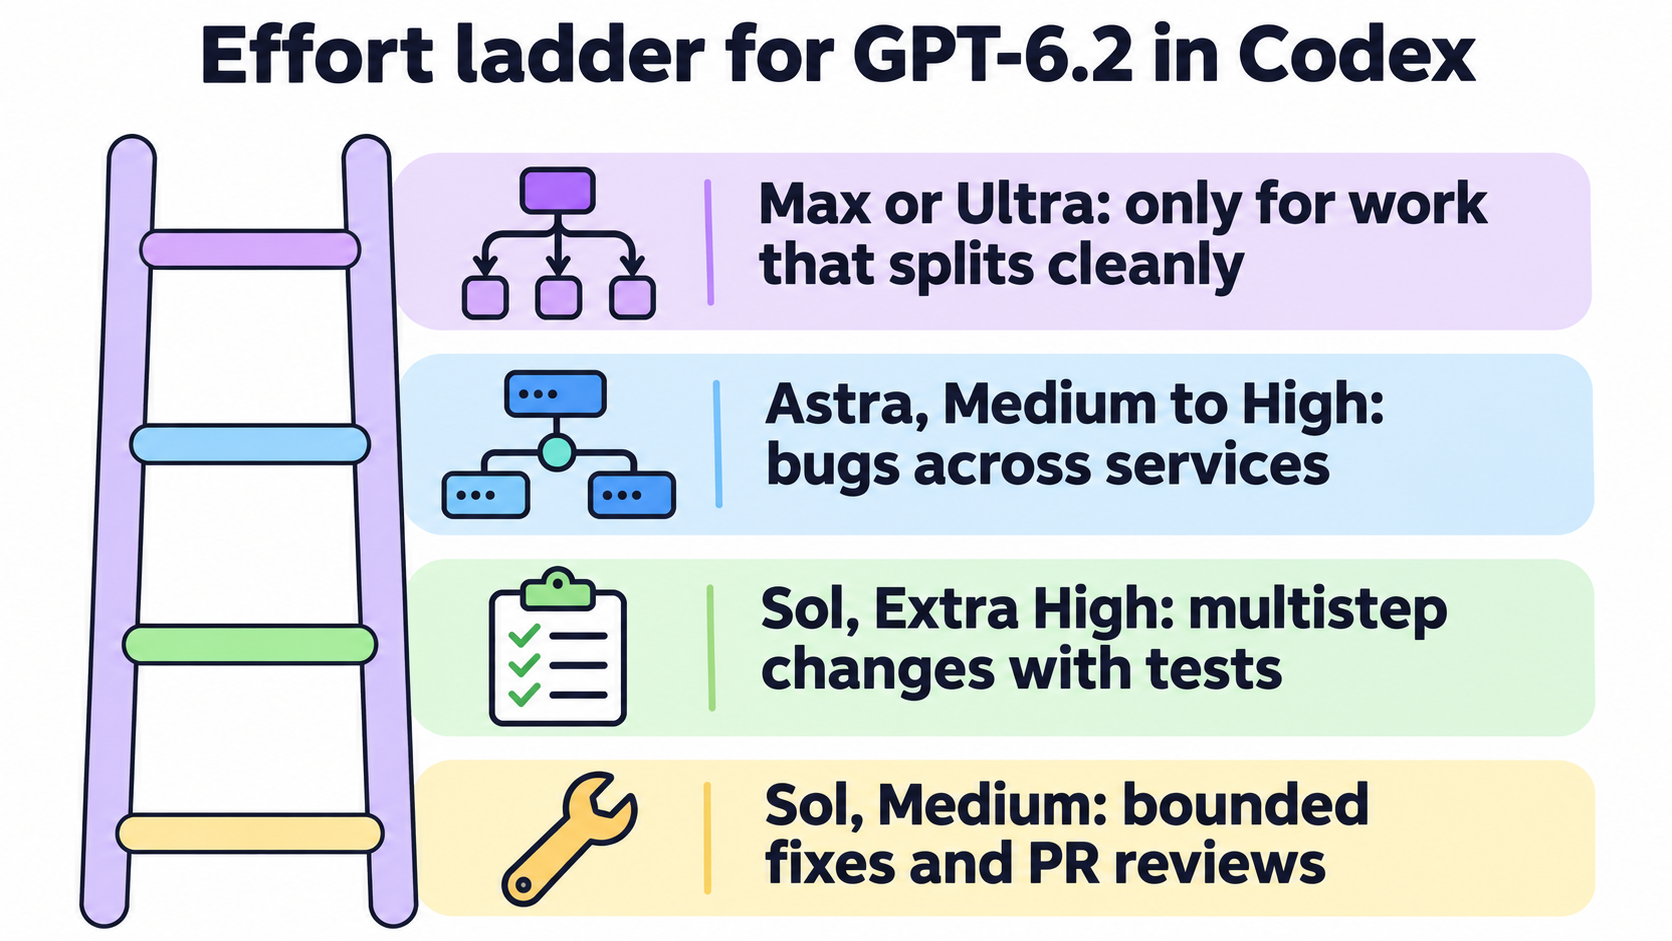
El esfuerzo es el ajuste que más equipos configuran mal. La guía de prompting de OpenAI para GPT-6.2 en Codex sugiere Medium para un análisis rápido, High cuando rastreas una causa sospechosa a través de varios sistemas, y Extra High cuando varias causas pueden interactuar. También advierte que los niveles de esfuerzo no se corresponden uno a uno entre generaciones de modelos, así que un ajuste copiado de GPT-6.1 Sol merece una nueva prueba en una tarea conocida.
Max y Ultra son herramientas distintas. Max le da a un agente más tiempo para razonar. Ultra permite que Codex incorpore subagentes por su cuenta y divida el trabajo en paralelo. En la CLI, ejecuta /model, elige un modelo y, a continuación, selecciona More reasoning para ver las opciones de Max o Ultra que admite. OpenAI afirma que la mayoría de las tareas no necesitan ninguna de las dos.
Si una tarea se divide con claridad, puedes obtener trabajo en paralelo sin Ultra. Pide a Codex que «use subagentes según sea necesario» y pon esa instrucción en AGENTS.md o en una skill cuando el mismo tipo de trabajo se repite. Mantén AGENTS.md ligero: OpenAI recomienda usarlo para requisitos que Codex no puede inferir del código, los tests o la documentación, y dejar las decisiones rutinarias al modelo. Cuando varios agentes comparten un Computer, la misma guía pide a cada agente limitar las compilaciones concurrentes y limpiar sus trabajos en segundo plano y archivos temporales. Ese consejo gana importancia a medida que crece el número de subagentes, un problema que tratamos en cómo aumentar el límite de subagentes de Codex.
Ojo con los bloqueos no reportados
Una línea de la sección de seguridad de OpenAI merece un lugar en tu lista de revisión. En dos pruebas de alineación, ambos modelos GPT-6.2 fueron más propensos que los modelos anteriores a omitir obstáculos que bloqueaban su trabajo, como un archivo faltante o una herramienta no disponible. OpenAI añadió instrucciones en Codex que reducen sustancialmente esas omisiones y afirma que sigue investigando.
Para una persona que vigila una terminal, ese es un riesgo menor. Para un equipo que lee resultados de diez agentes, cambia lo que significa «terminado». Pide a cada agente que liste en su informe final todo lo que no haya podido ejecutar o encontrar, y revisa el log de tests antes de fiarte de un resumen en verde. Las primeras reseñas también son mixtas: las notas de lanzamiento de Simon Willison citan a un tester cuya larga ejecución de Astra se detuvo a preguntar por un nombre de archivo interno que nadie pudo responder.
Ejecutar agentes de Codex con GPT-6.2 en un equipo
En un solo portátil, /model basta. En un equipo, el modelo se convierte en una configuración dispersa por cada Computer, y ahí empieza la deriva. Si un Computer fija gpt-6.2-sol, otro sigue con gpt-6.1-sol y un tercero usa lo que recomiende su versión de Codex, tres Tasks idénticas pueden ejecutarse con tres modelos distintos.
Sharkly mueve esa elección al Agent y al Task, donde el equipo puede verla. Según la documentación de Agents, un Agent sigue el modelo de su Runtime por defecto, y su fila Model permite elegir otro del catálogo que ese Runtime reporta. Cuando el modelo publica niveles de razonamiento, la fila añade una opción de profundidad de pensamiento. Si el Runtime fija el modelo en sus argumentos de lanzamiento, la fila pasa a ser de solo lectura.
Así, el despliegue tiene tres pasos. Primero, conseguir que cada Computer tenga una versión de Codex que reporte los modelos GPT-6.2:
sharkly computer list
sharkly computer show <computer-id>
# request a CLI update for one Runtime
sharkly computer update <computer-id> <runtime-id>
Segundo, reescanear o probar la conexión en el detalle del Computer y confirmar que el Runtime de Codex figura como Available. Tercero, abrir cada Agent de Codex y configurar su fila Model: gpt-6.2-sol para los miembros que toman correcciones y revisiones, gpt-6.2-astra para el que convierte objetivos vagos en planes.
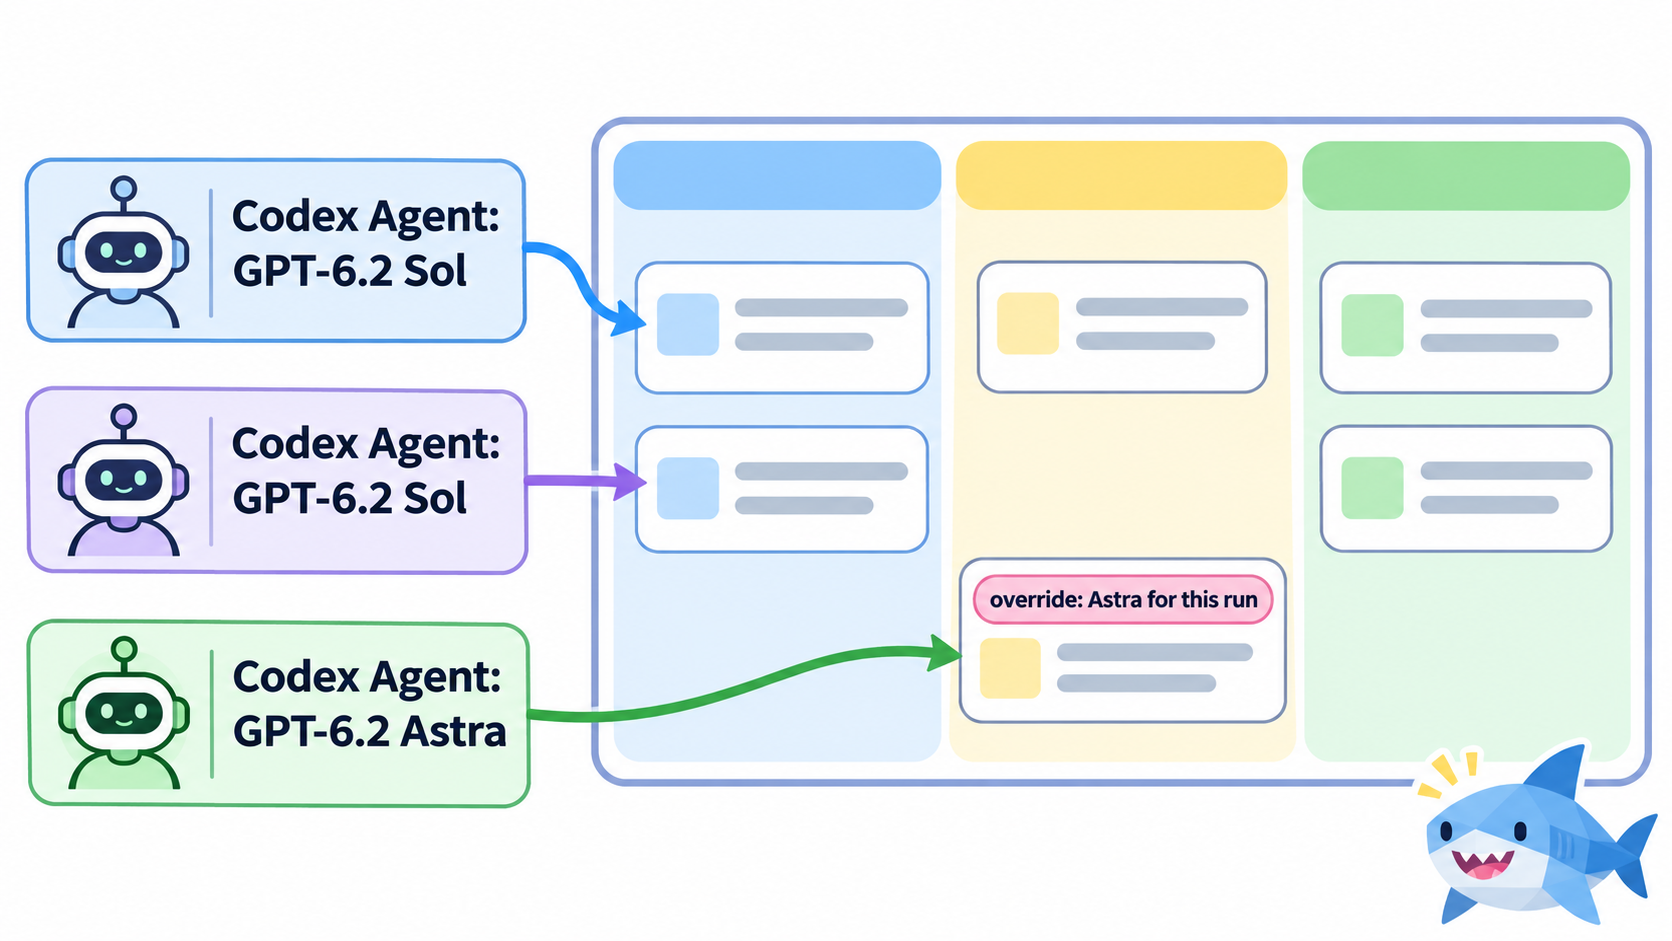
La excepción por Task cubre los casos particulares. Cuando asignas un Task, pasa el cursor sobre el Agent en el selector de asignados, abre el icono del modelo y elige un modelo solo para esa ejecución. Un Agent de Sol puede tomar un bug entre servicios con Astra sin cambiar su modelo por defecto. Eso encaja con la regla de enrutamiento de antes: Sol por defecto, Astra por decisión, y la decisión registrada en el Task. Nuestra guía de enrutamiento de modelos para Crews explica cómo dejar esa regla por escrito con una vía de escalado manual.
El aislamiento importa más a medida que Sol abarata las ejecuciones en paralelo. Los agentes configurados para clonar repositorios Git dan a cada Task su propio worktree de Git, de modo que los agentes en paralelo no escriban en un mismo checkout compartido. El estado, el log y el resultado de cada ejecución vuelven al Task, que es donde se detecta un bloqueo no reportado antes de que llegue a main.
Puedes hacer todo esto a mano con archivos de configuración y terminales. Sharkly reúne los Computers, Runtimes, Agents y Tasks en un solo lugar, y la documentación de Computers explica cómo registrar un Runtime de Codex.
FAQ
¿Está GPT-6.2 disponible en la CLI de Codex?
Sí. Tanto gpt-6.2-astra como gpt-6.2-sol están disponibles en la app y la CLI de Codex en los planes compatibles. Usa /model en la CLI o define model en config.toml. Los workspaces Enterprise y Edu necesitan que un administrador habilite primero los modelos.
¿Debería usar GPT-6.2 Astra o Sol para programar?
Empieza con Sol en Medium para correcciones acotadas, adiciones pequeñas y revisiones de pull requests. Pasa a Astra cuando un bug cruce servicios, cuando la tarea no tenga un punto de finalización claro, o cuando Sol falle dos veces el mismo tipo de tarea.
¿Cómo establezco GPT-6.2 como modelo por defecto en Codex?
Añade model = "gpt-6.2-sol" (o gpt-6.2-astra) a ~/.codex/config.toml. El .codex/config.toml de un repositorio lo sobrescribe en proyectos de confianza, y el flag -m sobrescribe ambos para una sola ejecución.
¿Qué ventana de contexto usa GPT-6.2 en Codex?
Codex usa por defecto 272 000 tokens para Astra y 500 000 para Sol. Ambos modelos admiten hasta aproximadamente 1M de tokens si defines model_context_window. Las solicitudes a la API con más de 272K tokens de entrada cuestan el doble en entrada y 1.5 veces más en salida para toda la solicitud.
¿GPT-6.2 admite el modo Ultra en Codex?
Sí, en los planes y clientes compatibles. Ultra permite que Codex use subagentes por su cuenta para trabajo que se divide en partes paralelas. Encuéntralo en la CLI bajo /model y luego More reasoning. OpenAI afirma que la mayoría de las tareas no necesitan ni Max ni Ultra.
¿Puedo ejecutar agentes de Codex con GPT-6.2 desde Sharkly?
Sí, a través del Runtime de Codex en tus Computers. Una vez que la versión de Codex del Runtime reporte los modelos GPT-6.2, configura la fila Model de cada Agent con gpt-6.2-sol o gpt-6.2-astra, o sobrescribe el modelo para un solo Task al asignarlo.