Respuesta rápida: ¿Debería ser de código abierto el código generado por IA? No existe ninguna regla legal que lo exija. El argumento a favor se apoya en dos puntos: los modelos aprendieron a partir de código de código abierto, y el código escrito íntegramente por una IA podría no ser protegible por derechos de autor. Sea cual sea tu postura, tu equipo necesita lo mismo primero: un registro de qué agente escribió qué, a partir de qué tarea, y quién lo revisó.
El 17 de noviembre de 2026, una publicación titulada “All AI-generated code should be Open Source” se situó en lo más alto de Hacker News con más de 1.200 puntos y 650 comentarios. El hilo es ruidoso, pero la pregunta que hay detrás es práctica. Si tus agentes escriben una proporción creciente de tu base de código, ¿quién es dueño de ese código, bajo qué licencia, y quién responde cuando falla?
Qué dice el argumento de “el código generado por IA debería ser de código abierto”
El caso a favor de abrir el código generado por IA combina una afirmación ética con una legal: los modelos fueron entrenados con código de código abierto y de Creative Commons, así que cerrar su salida implica un blanqueamiento de esas licencias; además, el código sin autor humano podría no ser protegible por derechos de autor de todos modos, por lo que debería publicarse bajo una licencia abierta o CC0.
La publicación de Jakub Jankiewicz plantea cuatro puntos:
- Datos de entrenamiento. Los modelos aprendieron de décadas de código de código abierto y de respuestas de Stack Overflow, que llevan licencias Creative Commons que exigen atribución. Convertir eso en código cerrado “se siente como un blanqueo de licencias”, en sus palabras.
- Autoría. El código generado puramente por IA no tiene autor humano, por lo que no debería ser protegible por derechos de autor. Señala la disputa de la selfie del mono y la posición de la Oficina de Copyright de EE. UU. sobre la IA.
- Jurisdicción. Algunos países, como el Reino Unido, otorgan protección limitada a las obras generadas por computadora, así que las reglas no son uniformes.
- El remedio. Los desarrolladores deberían publicar el código generado por IA bajo una licencia de código abierto o dedicarlo al dominio público con CC0, al menos donde los humanos no hicieron mucho más que escribir prompts.
Ese último punto es el que más importa para los equipos: apunta al código que nadie revisó ni modificó, no al código que un humano diseñó y un agente tecleó.
Derechos de autor y código generado por IA: cuál es el estado de la ley
La mitad legal del argumento tiene apoyo real en EE. UU. y menos apoyo en otros lugares.
En enero de 2025, la Oficina de Copyright de EE. UU. publicó la Parte 2 de su informe sobre IA, sobre la protección por derechos de autor. Su postura: los derechos de autor requieren autoría humana, los prompts por sí solos generalmente no dan a una persona suficiente control sobre la salida, y las contribuciones humanas como seleccionar, organizar o modificar la salida sí pueden estar protegidas. En marzo de 2025, el Circuito de D.C. confirmó en Thaler v. Perlmutter que la Ley de Copyright exige un autor humano.
El Reino Unido toma una línea distinta. La sección 9(3) del Copyright, Designs and Patents Act de 1988 considera autor de una obra generada por computadora a la persona que realizó los arreglos necesarios para su creación.
Así que en EE. UU., un archivo que un agente produjo sin ediciones humanas significativas puede tener una protección de derechos de autor débil o inexistente. Un archivo que un desarrollador reestructuró, recortó y amplió probablemente sí la tenga. La mayoría del código en producción se sitúa entre esos dos extremos, y la línea pasa por tu proceso de revisión.
Los contraargumentos, lado a lado
Las objeciones más fuertes del hilo no son “el autor se equivoca sobre la ley”. Se refieren a lo que se deduce de ella.
| El argumento | El contraargumento |
|---|---|
| Modelos entrenados con código abierto, así que la salida debería ser abierta | Las reclamaciones sobre datos de entrenamiento se están litigando en los tribunales; una licencia sobre la salida no las resuelve |
| El código no protegible por derechos de autor debería publicarse | No protegible no es lo mismo que publicado; nada en el informe de la Oficina de Copyright te obliga a liberar código |
| El código de bajo esfuerzo merece protección | Casi ningún código en producción es de esfuerzo cero: especificaciones, revisión, pruebas y ediciones son trabajo humano |
| Las licencias abiertas honran el bien común | Un CC0 generalizado puede eliminar la protección de las contribuciones humanas mezcladas en el mismo archivo |
| La regla debería ser uniforme en todos los países | La ley de derechos de autor es nacional; la regla del Reino Unido ya difiere de la de EE. UU. |
¿Quién responde por el código escrito por agentes?
El debate sobre la licencia sigue abierto. La responsabilidad, no. La persona que fusionó el cambio es la propietaria, sea lo que sea lo que escribió el primer borrador.
Esa es la idea central de nuestra publicación sobre la propiedad humana del trabajo de los agentes. Un error en código escrito por un agente sigue siendo tu error. Un secreto filtrado en un pull request de un agente sigue siendo tu incidente.
Los agentes investigan, ejecutan, prueban e informan. Las personas fijan la dirección, otorgan autoridad y aceptan el resultado. El debate sobre el código abierto no cambia esa división; aumenta el coste de perderla de vista.
Procedencia del código generado por IA: qué registrar
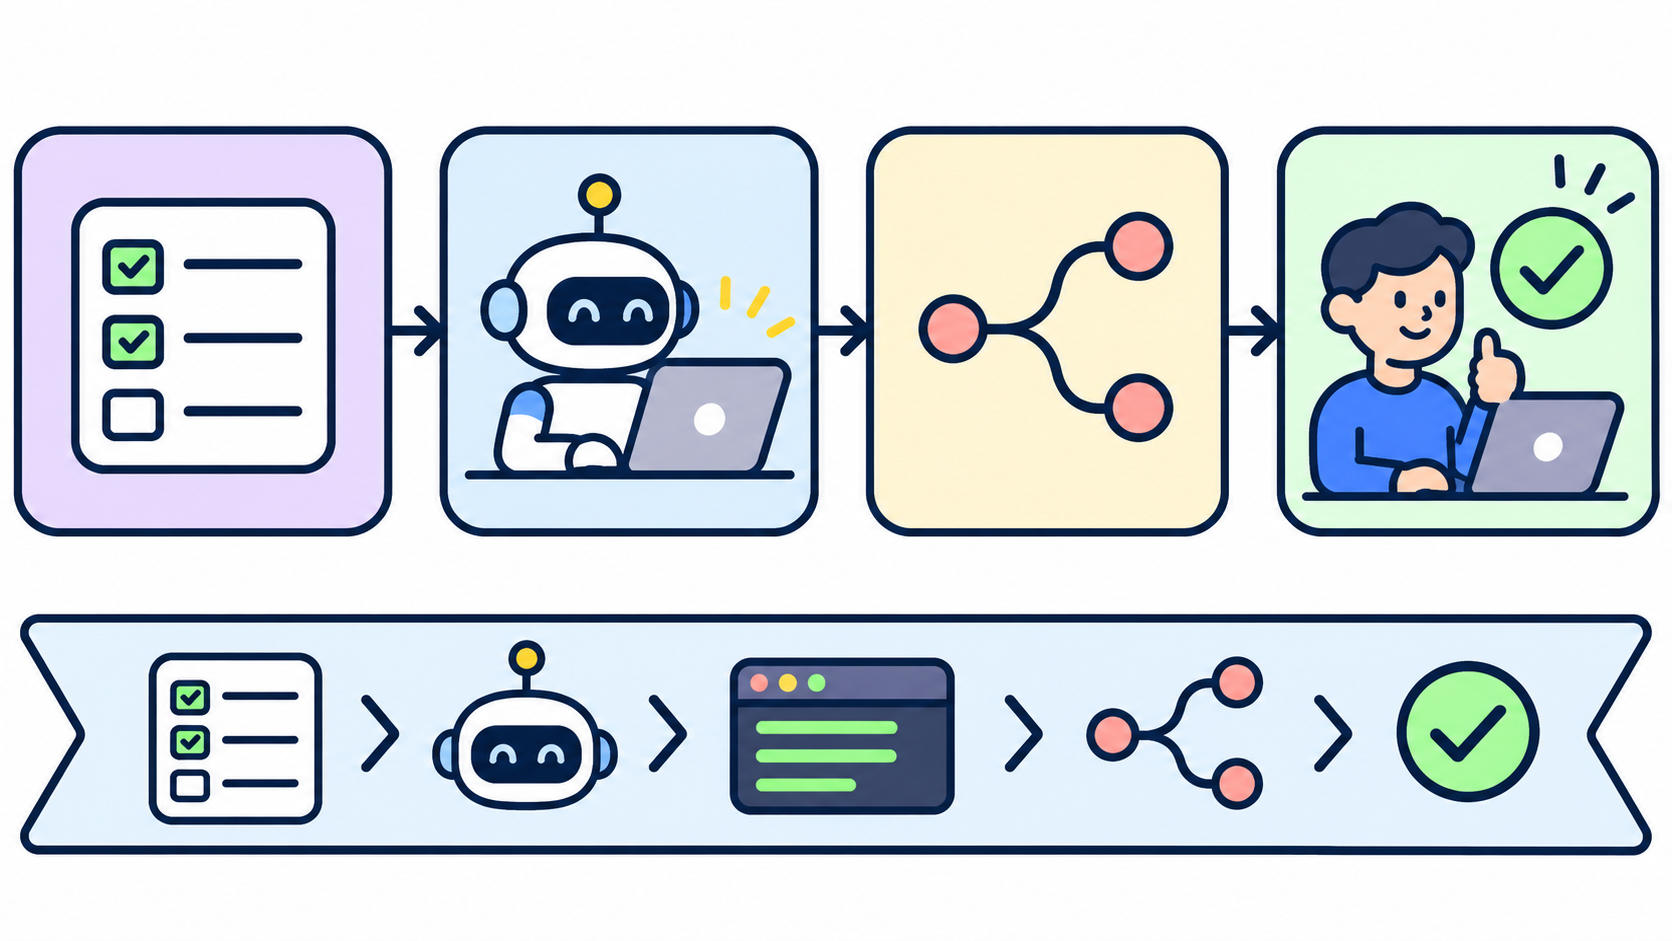
La procedencia es el registro de dónde provino un cambio. Para el código escrito por agentes, un registro útil responde a seis preguntas:
- Qué tarea solicitó el cambio, con su requisito y criterios de aceptación.
- Qué agente hizo el trabajo, y sobre qué runtime y modelo.
- Qué ejecución lo produjo, con hora de inicio, hora de fin y origen del disparador.
- Qué pull request lo llevó al repositorio.
- Quién lo revisó, y qué cambió antes de aceptarlo.
- Qué licencia aplica el repositorio a ese código.
La mayoría de los equipos ya tienen partes de esto. El pull request tiene el diff y el revisor. Git puede transportar metadatos estructurados mediante commit trailers. Algunos agentes de programación, Claude Code entre ellos, añaden un trailer de coautor por defecto, y puedes extender esa convención con tus propias claves:
fix(auth): return 401 instead of 500 on expired refresh token

Refresh tokens past their TTL threw an unhandled TokenExpiredError
in the session middleware. Map it to a 401 with a retry hint.

Co-Authored-By: Claude <[email protected]>
Agent-Task: COIN-1287
Agent-Run: 3f9c2a71-0b4e-4c8a-9d51-6e2f4b7a1c09
Reviewed-By: Priya Shah
Human-Edits: renamed handler, added regression test
Los trailers viajan con el commit, así que sobreviven a los traslados de repositorio. Lo que no pueden contener es la ejecución en sí: las llamadas a herramientas, los intentos fallidos, la discusión detrás de la forma final.
Para el seguimiento de licencias a nivel de archivo, los identificadores de SPDX y las convenciones de REUSE dan a cada archivo una cabecera de licencia que las herramientas pueden verificar. Si tu equipo decide que algunos recursos generados se publican bajo CC0, es aquí donde esa decisión se vuelve comprobable.
Cómo Sharkly mantiene el registro en la tarea
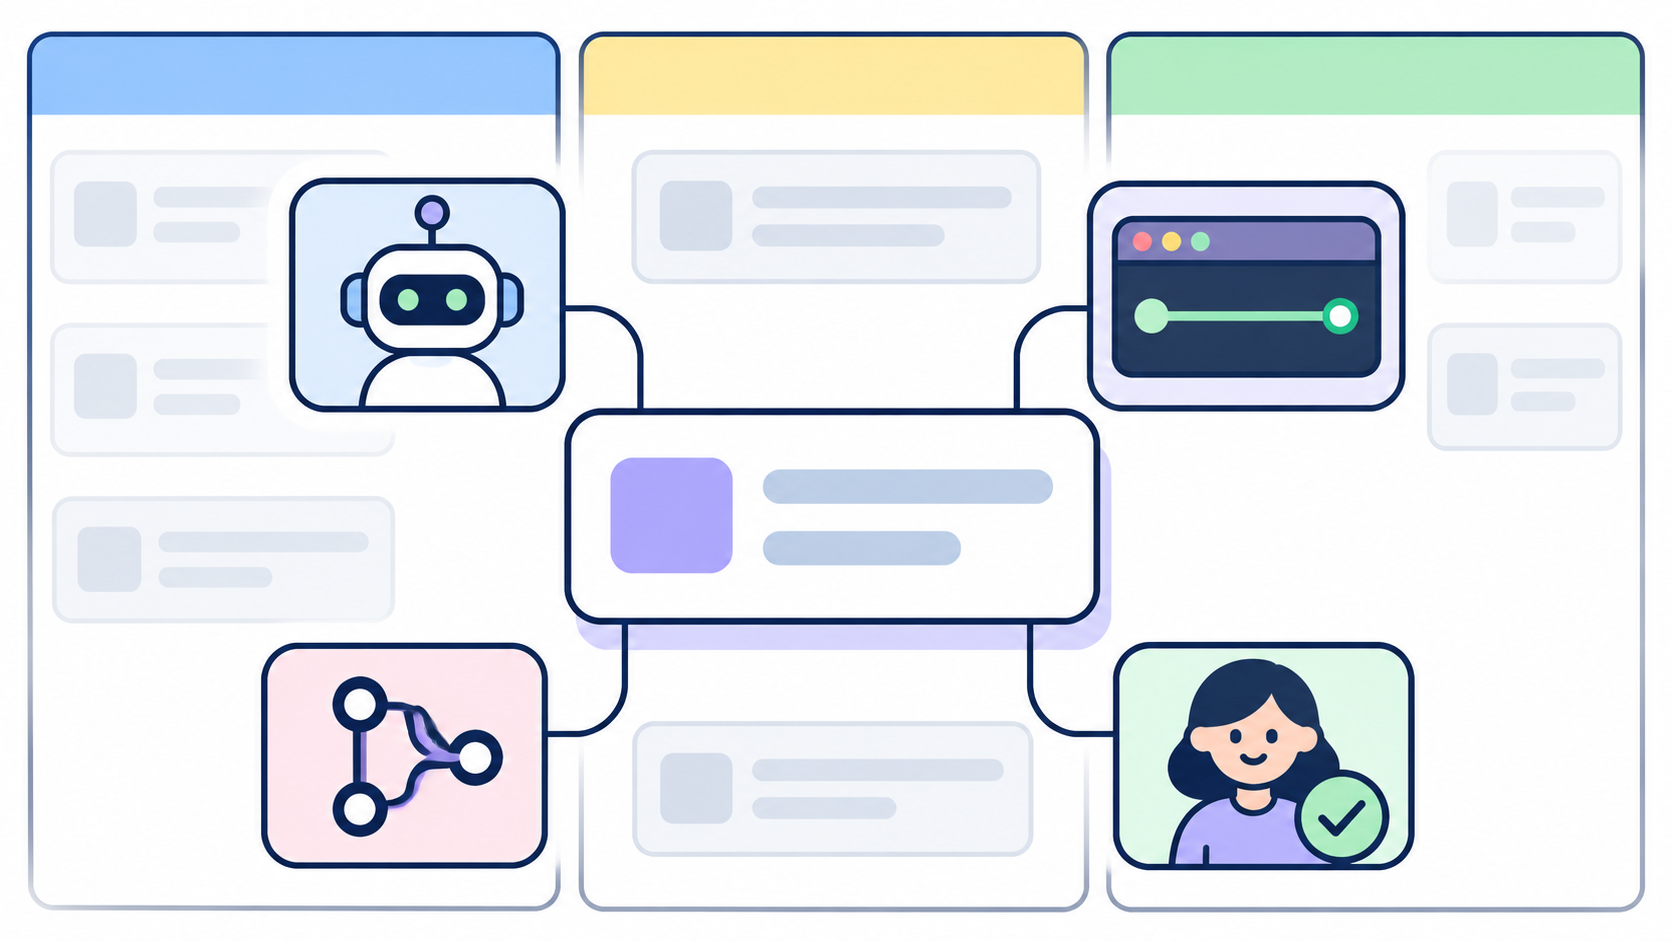
Sharkly es un sistema de gestión del trabajo para personas y agentes de programación. Asignas una tarea a un agente igual que la asignarías a una persona, y la tarea permanece como el registro compartido para el equipo.
Ese registro es la cadena de procedencia que a la mayoría de los equipos les falta:
- La tarea contiene el requisito, el responsable asignado, comentarios, adjuntos y una línea de tiempo de actividad de los cambios en la tarea.
- El registro de ejecución muestra, por ejecución, por qué se puso en cola, cuándo comenzó y terminó, las llamadas a herramientas y los eventos del runtime, el origen del disparador y cualquier detalle de fallo, tal como describen los documentos de ejecución de tareas.
- Los comentarios del agente destinados al equipo se guardan como comentarios vinculados a la ejecución, así que la explicación queda junto a la evidencia.
- Señales de revisión: un agente puede dejar una tarea esperando revisión humana, lo que la enruta a la persona responsable en lugar de fusionarla en silencio.
- Enlaces de pull requests: la integración de GitHub vincula pull requests y sincroniza issues en un espacio, de modo que el cambio de código y la tarea se apuntan mutuamente.
Sharkly no decide tu licencia y no es un producto de cumplimiento. Mantiene los hechos de los que depende una decisión de licencia en un solo lugar en lugar de sesiones privadas de terminal.
Una política de procedencia que puedes adoptar esta semana
Usa la política más pequeña que responda a las seis preguntas anteriores. Empieza aquí:
- Una tarea por cada cambio de agente. Sin trabajo de agente sin ID de tarea. El chat ad hoc está bien para explorar; todo lo que se publica recibe una tarea.
- Pon el ID de tarea en la rama y en el commit. Un trailer o un prefijo de rama es suficiente para buscar más adelante.
- Exige un revisor humano con nombre. El nombre del revisor va en el pull request y en la tarea, y sus ediciones se anotan.
- Escribe una línea de licencia por repositorio. Decide si el código escrito por agentes sigue la licencia existente del repositorio (lo habitual para la mayoría de los equipos) u otra cosa, y escríbelo en
CONTRIBUTING.md. - Etiqueta los archivos cuya licencia difiere. Usa cabeceras SPDX si eliges CC0 u otra licencia para los recursos generados.
- Conserva los registros de ejecución tanto como los pull requests. Si conservarías el hilo de revisión, conserva la ejecución que produjo el diff.
Para profundizar en la mecánica de revisión, consulta cómo revisar código generado por IA con evidencia a nivel de tarea y dónde colocar compuertas de aprobación para agentes de programación.
Usa una política ligera cuando los agentes solo toquen herramientas internas y pruebas. Usa los seis pasos completos cuando el código de los agentes llegue a los clientes, se ejecute en entornos regulados o aterrice en un repositorio que ya publicas bajo una licencia de código abierto.
¿Debería tu equipo hacer de código abierto el código escrito por sus agentes?
Probablemente no por defecto, y no solo por este hilo. La ley sigue evolucionando, la mayoría de la salida de los agentes en un flujo de trabajo revisado contiene contribuciones humanas reales, y una publicación generalizada bajo CC0 puede regalar más de lo que pretendías.
La mejor jugada es hacer que la pregunta sea respondible. Cuando un cliente o tu equipo legal pregunte “cuánto de esto lo escribió un agente, y quién lo verificó”, abres un registro y muestras la tarea, la ejecución, el pull request y el revisor.
Si ya usas Claude Code, Codex u otro agente de programación, conecta un equipo a Sharkly, asigna una tarea de bajo riesgo a un agente, y comprueba qué muestra el registro de la tarea cuando la ejecución termine. Ese registro es tu cadena de procedencia, sea cual sea el desenlace del debate sobre el código abierto.
FAQ
¿Es el código generado por IA protegible por derechos de autor?
En EE. UU., el código producido por IA sin contribuciones humanas significativas probablemente no sea protegible por derechos de autor, según el informe de 2025 de la Oficina de Copyright y Thaler v. Perlmutter. La selección, organización y modificación humanas de la salida sí pueden estar protegidas. Otros países, incluido el Reino Unido, tratan las obras generadas por computadora de manera distinta.
¿Tengo que hacer de código abierto el código que escribió un agente de IA?
Ninguna ley lo exige. La publicación de Hacker News argumenta que deberías hacerlo por razones éticas. El código no protegible por derechos de autor no es automáticamente público; puedes mantenerlo privado.
¿Quién es responsable de los errores en el código generado por IA?
El equipo que lo fusionó. Un agente puede escribir el cambio, pero la persona que aceptó el pull request es propietaria del resultado. Registra a esa persona en la tarea y en el pull request.
¿Cómo hago seguimiento de qué código escribió un agente de IA?
Vincula cada cambio de agente a una tarea, añade los IDs de tarea y de ejecución como commit trailers, enlaza el pull request a la tarea y registra al revisor humano. Un tablero de tareas que conserva el registro de ejecución del agente te da el resto.
¿Tiene sentido CC0 para el código generado por IA?
Puede tenerlo para recursos generados claramente separables, como fixtures o scaffolding. Aplicar CC0 a archivos mixtos arriesga liberar también las partes escritas por humanos, así que etiqueta esos archivos con cabeceras SPDX en lugar de relicenciar repositorios enteros.