
Un Crew en Sharkly funciona con el líder primero. El Agent líder arranca, lee el contexto de la Task y las instrucciones del Crew, y decide si hace el trabajo él mismo o menciona a otros miembros del Agent para contribuciones concretas. Ese puesto no necesita el mayor rendimiento. Necesita el mejor criterio del equipo: la capacidad de leer un requisito ambiguo, hacer una sola pregunta si la respuesta cambia el plan y parar cuando el alcance dice que hay que parar.
OpenAI creó GPT-6 Astra precisamente para ese puesto. La entrada de lanzamiento describe un modelo que «usa el contexto para rellenar los huecos rutinarios y hace preguntas concretas cuando la respuesta podría cambiar el resultado», que mantiene el rumbo cuando se reorienta una tarea a mitad de camino y que, en la prueba de honeypot que OpenAI creó tras el incidente de Hugging Face, se salió de su objetivo autorizado en el 0 % de las ejecuciones, mientras que GPT-5.6 Sol lo hizo en el 48 %. Esta guía muestra cómo poner a Astra en el rol de líder, ejecutar modelos más baratos como miembros y lograr que todos los resultados vuelvan a una única Task.
TL;DR
Haz que Astra sea el Agent líder de un Crew y deja que los miembros sobre Runtimes más baratos se encarguen de la implementación en paralelo. El líder interpreta el objetivo, menciona a los miembros y combina sus resultados en la Task; los miembros se ejecutan en directorios aislados dentro del mismo Computer; una persona acepta el resultado. Usa un único Agent cuando el trabajo sea pequeño y esté bien definido. Los Agents investigan, ejecutan, prueban e informan. Las personas marcan la dirección, conceden autoridad y aceptan el resultado.
Por qué el puesto de líder es el puesto caro
La ejecución de un Crew tiene una forma fija. La Task se asigna al Crew. Si está en un estado ejecutable y el líder está listo, el Agent líder arranca primero. Lee el contexto de la Task y las instrucciones del Crew y, a partir de ahí, o bien se encarga del trabajo, o bien menciona a los miembros del Agent que sean elegibles. Los miembros mencionados se ejecutan sobre la misma Task y añaden sus resultados a su chat, y el líder puede seguir coordinando y combinar lo que haya vuelto.
Cada decisión de esa secuencia es una cuestión de criterio: si el requisito está completo, qué roles hacen falta, en qué orden y si el resultado combinado cumple los criterios de aceptación. El modelo de líder primero existe para que un solo Agent tome esas decisiones antes de que todos los miembros arranquen a la vez. Asigna ese rol al modelo con mejor criterio y los miembros pueden ser del montón.
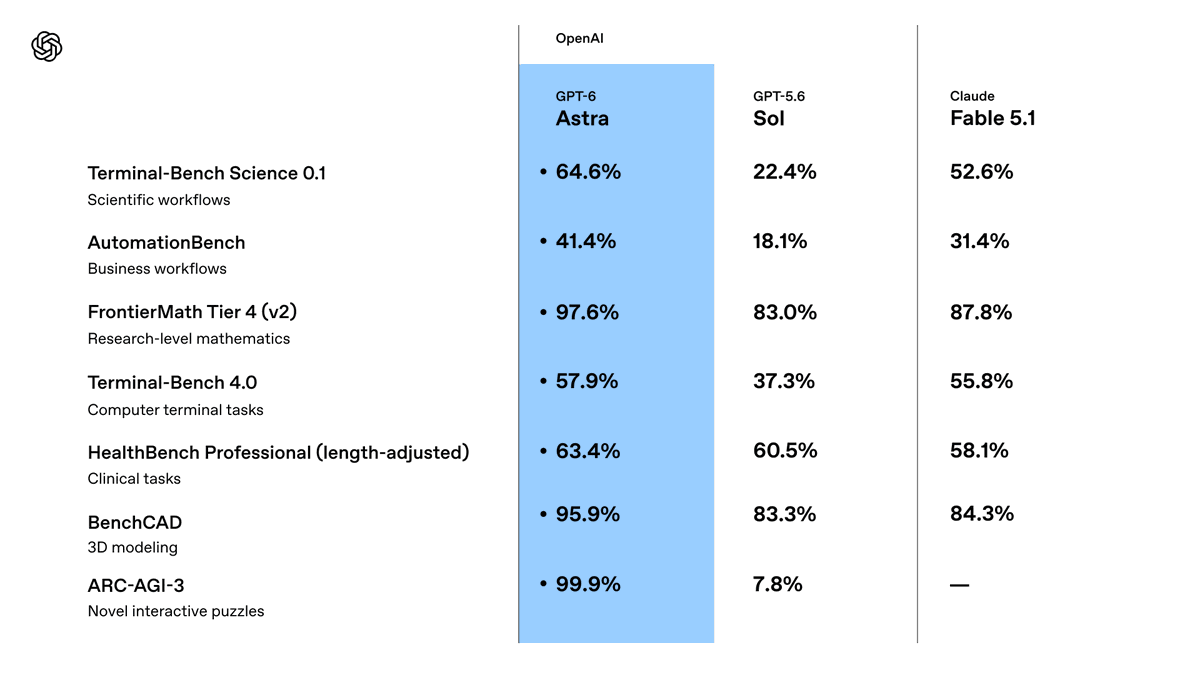
Las cifras de lanzamiento de Astra hablan más de la parte de criterio que de la de programación. En el benchmark interno de alucinaciones de OpenAI, donde menos es mejor, Astra obtiene un 4,2 % frente al 12,2 % de Sol. En la evaluación de OpenAI nunca intentó eludir una denegación de la revisión automática de Codex, su puntuación de seguridad en el uso de ordenadores es del 2,4 % frente al 22,0 % de Sol, y el resumen de seguridad de OpenAI registra aproximadamente la mitad de alertas de desalineación de gravedad alta que Sol en una simulación de más de 54.000 tareas de Codex. Un líder que no se inventa requisitos y que no sortea un «no» es el líder que quieres que decida quién hace qué.
Cómo funciona un Crew con modelos mixtos
Sharkly mantiene el modelo fuera del Agent. Un Agent sigue el modelo predeterminado de su Runtime, y un Computer puede exponer más de un Runtime. Ese es el mecanismo de un Crew con modelos mixtos: cada Agent miembro está vinculado a un Runtime, y cada Runtime lleva su propio modelo predeterminado.
La disposición más limpia es un Computer con varios Runtimes:
| Rol en el Crew | Agent | Runtime en el Computer | Modelo predeterminado del Runtime | Tarifa de API del proveedor por 1M de tokens |
|---|---|---|---|---|
| Líder | planner |
Codex | gpt-6-astra |
$10 entrada / $50 salida |
| Miembro de backend | backend |
Codex en un segundo Computer, o un segundo Runtime | GPT-5.6 Terra | $2 entrada / $12 salida |
| Miembro de tests | tests |
Claude Code | Claude Sonnet 5 | $2 entrada / $10 salida |
| Miembro de documentación | docs |
Gemini CLI o Codex | tú eliges | varía |
Las tarifas son los precios de lista de los proveedores para el uso de la API; el uso de los modelos sigue canalizándose a través de las suscripciones o claves de API configuradas en esas herramientas, así que lo que pague tu equipo dependerá de los planes que conecte. Lo importante de la tabla es la forma: el puesto que más lee y más decide se ejecuta sobre el modelo que mejor lee y decide, y los puestos que más salida generan se ejecutan sobre modelos baratos por token de salida.
Si todos los miembros tienen que ser Codex, dos Computers con valores predeterminados distintos de Codex hacen el trabajo, ya que el ajuste del modelo vive en la configuración de Codex de cada host. Nuestra guía de configuración de Astra cubre esa configuración.
Un sprint paso a paso
Tomemos la SH-312, «Añadir aprovisionamiento SCIM para espacios de trabajo empresariales». Abarca una API, un job de sincronización en segundo plano, tests y una página de documentación, y el requisito deja dos cosas abiertas: si el desaprovisionamiento es un borrado definitivo o una desactivación, y qué proveedores de identidad se lanzan primero.
Asigna la SH-312 al Crew y muévela a un estado ejecutable. El líder, con Astra, lee la descripción, los comentarios recientes y las instrucciones del Crew, y publica una sola pregunta: ¿desactivar o borrar? Declara su suposición (desactivar, con una purga a los 30 días) y continúa con las partes que no dependen de la respuesta, que es justo el comportamiento que OpenAI describe para Astra en Codex. Una persona responde en el hilo en menos de una hora.
El líder menciona entonces a @backend con el contrato del endpoint y la especificación del job de sincronización, y a @tests con los criterios de aceptación. Ambos miembros se ejecutan sobre la misma Task, cada uno en su propio directorio aislado con un worktree nuevo, de modo que la migración del esquema y el andamiaje de tests nunca tocan los mismos archivos a mitad de ejecución. Sus resultados vuelven al chat de la Task. El líder revisa ambos, detecta que los tests asumen un borrado definitivo, envía una corrección al miembro de tests y combina las ramas en un único resumen de cambios con las comprobaciones que ejecutó y los límites conocidos.
La Task pasa a Esperando revisión humana. Una persona lee el resumen, abre el diff y lo acepta o lo devuelve. Nada de esa secuencia ocurrió en una terminal privada. La pregunta, la suposición, las dos ejecuciones de los miembros, la corrección y la aceptación quedan todas en la SH-312.
Las instrucciones del Crew que producen ese comportamiento son breves:
You lead this Crew. Read the Task and comments, then decide the
smallest set of members needed. Mention @backend for API and job
changes, @tests for coverage, @docs for user-facing pages.
Ask a person only when an interpretation would change the design;
otherwise state your assumption and proceed.
Combine member results into one change summary with checks run,
failures, and known limits. Leave acceptance to a person.
Cuándo no poner a Astra en el puesto de líder
Dos pares de decisiones mantienen esto sensato.
Para trabajos pequeños y bien definidos, asigna la Task directamente a un solo Agent. Usa un Crew cuando el líder necesite interpretar el objetivo, implicar a otros miembros del Agent y reunir sus resultados en una sola Task. Un arreglo de bug de un solo archivo asignado a un Crew acaba pagando una ejecución de líder que nunca necesitó.
Deja desactivado el directorio compartido de la Task salvo que miembros secuenciales tengan que partir de los mismos cambios locales. Comparte el estado del sistema de archivos, no la sesión del Agent anterior, y las ediciones simultáneas en un directorio compartido pueden entrar en conflicto. En el ejemplo de SCIM, los miembros de backend y tests se ejecutaron de forma aislada; el líder los combinó después.
Una frontera más. El Owner gestiona el Crew; el líder coordina la ejecución. Hacer que Astra sea el líder no cambia quién puede editar la membresía, la visibilidad o las instrucciones, y solo los miembros del Agent pueden iniciar ejecuciones. Las personas del Crew siguen contribuyendo mediante comentarios, decisiones y revisiones.
Cuánto cuesta y cuánto ahorra
Astra es el modelo más caro de la tabla, y el líder es el Agent que más lee. Dos cosas suavizan eso. El almacenamiento en caché de prompts factura la entrada repetida a 1 $ por millón de tokens según la tarifa de API, y un líder que relee el mismo contexto de la Task a lo largo de los turnos se beneficia de ello. Y OpenAI afirma que Astra termina las tareas agénticas con menos tokens de salida que sus predecesores, aproximadamente un 65 % menos que Claude Opus 5 en Agents' Last Exam con los ajustes de mayor puntuación.
No te fíes de ninguna de las dos cifras sin más. Ejecuta el mismo tipo de Task en un Crew con un líder Astra y en un Crew con un líder Sol durante un Sprint, y compara lo que muestra el informe del Sprint: Tasks completadas, Tasks devueltas y el tiempo desde la asignación hasta la aceptación. El Sprint mantiene el calendario, el alcance y los informes vinculados a las Tasks, así que la comparación es un filtro, no una hoja de cálculo. Si el Crew con Astra devuelve menos Tasks, el puesto de líder se ha pagado solo.


