
OpenAI lanzó GPT-6 Luna el 22 de septiembre a $0.10 por millón de tokens de entrada y $0.50 por millón de salida, con el id de API gpt-6-luna y una ventana de contexto de 1M. A ese precio, la pregunta interesante deja de ser si el modelo es lo suficientemente bueno en abstracto. Pasa a ser qué carriles de tu tablero estás dispuesto a cederle, y cómo el carril barato y el carril caro funcionan en la misma Computer sin que nadie pierda de vista cuál de los dos produjo un resultado determinado.
Eso es un problema de configuración antes que un problema de modelo. Un equipo que vincula Luna en todas partes ahorra dinero y luego lo gasta de vuelta en revisión. Un equipo que nunca lo vincula sigue pagando tarifas premium para que un Agent renombre un archivo de prueba. Esta guía toma el camino útil más corto: poner gpt-6-luna en una Computer, mantenerlo en su propio carril, asignarle una Task real, y leer el resultado donde el equipo pueda verlo.
TL;DR
Vincula gpt-6-luna como modelo predeterminado de un Runtime en una Computer conectada, confirma que ese Runtime aparezca como Available en Sharkly, dale su propio Agent en lugar de reutilizar el caro, aumenta el tiempo de espera por Task antes de confiar en una ejecución larga, y mantén Luna en trabajos cuyo resultado una persona pueda verificar en menos de un minuto. Sharkly no mostrará el nombre del modelo. Mostrará la ejecución, el log, las preguntas y el resultado en la Task. Los Agents investigan, ejecutan, prueban e informan. Las personas marcan la dirección, otorgan autoridad y aceptan el resultado.
Dónde vive la configuración del modelo
Sharkly no elige modelos. La documentación de Agents es explícita: «El Agent sigue el modelo predeterminado del Runtime. No promete ni muestra un nombre de modelo específico. Cambia los modelos en la configuración de la herramienta Runtime o Computer, no en el Agent.»
Así que no hay un menú desplegable de modelos en un Agent, ni tampoco un control de profundidad de razonamiento. Cuatro roles, una función cada uno. El Agent define cómo debe gestionarse el trabajo. La Computer aporta el host y los recursos locales. El Runtime realiza la sesión real del agente. La Task sigue siendo el registro compartido para el equipo. El recorrido completo de esa configuración está en nuestra guía de GPT-6 Sol; esta publicación cubre la parte específica de poner un modelo barato en el tablero.
Paso 1: vincular gpt-6-luna en la Computer
En la Computer que lo ejecutará, actualiza tu herramienta de agente e inicia sesión con una cuenta o clave de API que tenga acceso a Luna. OpenAI puso Luna a disposición en ChatGPT Work y en Codex para los planes Plus, Pro, Business, Enterprise y Edu, dio Luna a los usuarios de Free y Go en la aplicación de escritorio, y aún no lo ha incluido en Chat. Si codex -m gpt-6-luna inicia una sesión en una terminal normal en ese host, Sharkly puede usarlo.
Luego establece el valor predeterminado para que las ejecuciones en ese Runtime lo adopten:
# ~/.codex/config.toml
model = "gpt-6-luna"
model_provider = "openai"
model_reasoning_effort = "high"
Dos advertencias sobre ese fragmento. El nombre de la clave de esfuerzo de razonamiento difiere entre versiones de Codex, así que verifícalo contra la configuración de ejemplo de la compilación instalada en esa Computer. Y high está ahí a propósito, no como valor predeterminado: cada resultado publicado de Luna a continuación se mide con esfuerzo high o max, no con el ajuste que elegirías para hacer que un modelo barato sea más barato. [VERIFY]
De vuelta en Sharkly, abre el detalle de la Computer y ejecuta el reescaneo o la prueba de conexión. El Runtime debería aparecer como Available. Que una Computer aparezca solo como online significa únicamente que su servicio local está enviando latidos. El estado de capacidad del Runtime es lo que te indica que una ejecución puede iniciarse.
Paso 2: mantener el carril barato visiblemente separado
Una Computer puede exponer uno o más Runtimes, cada uno reportando su propio estado de conexión, y se puede añadir un Runtime ACP personalizado desde el detalle de la Computer con su propio nombre y comando de inicio. Esa es la palanca que vale la pena usar aquí. Dale al carril de Luna su propia entrada de Runtime y su propio Agent, nombrados por el carril y no por el modelo, y el tablero te dirá en qué carril se ejecutó una Task sin que nadie tenga que leer un log de ejecución.
Esto no es cosmético. Sharkly no puede leer de forma fiable el modelo que un Runtime está usando realmente, que es exactamente por lo que los Agents siguen el valor predeterminado del Runtime y no muestran ningún nombre de modelo. Si un Agent cambia de modelo en silencio entre el martes y el jueves porque alguien editó un archivo de configuración, dos ejecuciones que parecen idénticas en la Task no lo eran. Un carril por nivel de coste hace eso visible en el único lugar donde el equipo ya mira. Consulta Computers en Sharkly para saber cómo se detectan y prueban los Runtimes.
Un par de decisiones, ya que mantener dos carriles tiene un coste. Divide el Runtime cuando más de una persona asigne trabajo en esa Computer y la diferencia entre una ejecución de $0.10 y una de $10 le importe a alguien. No lo dividas cuando un solo ingeniero ejecute un puñado de Tasks a la semana; un único Runtime y un juicio por Task es menos cosas que mantener en orden, y el aislamiento por worktree ya evita que las ejecuciones choquen.
Paso 3: dimensionar la ejecución para un modelo que arranca despacio
Barato no es lo mismo que rápido, y este es el ajuste que la gente hace mal primero. Artificial Analysis, un tercero y no ninguno de los dos proveedores, midió 153.9 tokens de salida por segundo para la variante de razonamiento max de GPT-6 Luna, con 124.23 segundos hasta el primer token. Eso es más de lo que la mayoría de la gente espera antes de asumir que un proceso se ha colgado.
Así que establece el tiempo de espera por Task de forma deliberada, y mantén el directorio de trabajo en modo Temporary para que cada Task reciba un directorio aislado y un worktree nuevo. Así, dos ejecuciones de Luna sobre el mismo repositorio no podrán sobrescribirse entre sí, y una ejecución que está pensando se ve distinta de una que ha muerto, porque la Task lleva un estado y un historial de terminal no.
Dónde encaja un Runtime barato en un Crew
Un Crew es un grupo reutilizable de People y Agents coordinado por un Agent líder. La regla de ubicación que se desprende de los propios números de OpenAI es que Luna pertenece entre los miembros y no en la cima.
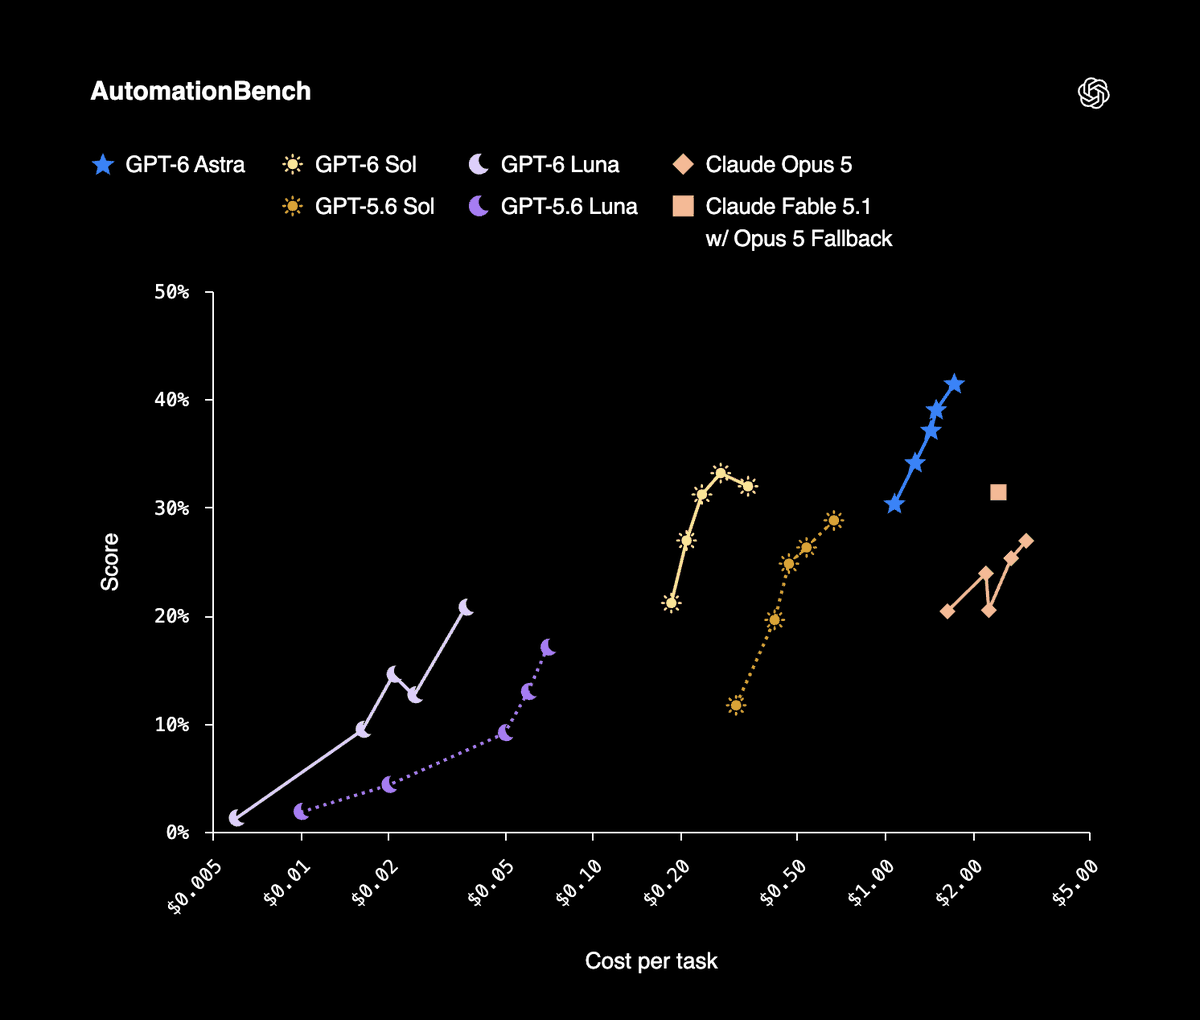
El caso del miembro es sólido. En DeepSWE 1.1, OpenAI reporta Luna con esfuerzo max obteniendo un 66.6%, comparable a Claude Opus 5 y Fable 5 con esfuerzo medio, con un 93% menos de coste por tarea que Opus 5 y un 96% menos que Fable 5. En OSWorld 2.0 offline, Luna con max supera a GPT-5.6 Sol con medium por una décima parte del coste. En AutomationBench 1.0.6, Luna con high obtiene 5.4 puntos porcentuales más que su predecesor con un 58% menos de coste por tarea, y en factualidad, Luna con mayor esfuerzo iguala a GPT-5.6 Sol a aproximadamente una centésima parte del coste. OpenAI también describe Sol y Luna como un 50% más baratos que el precio promocional de GPT-5.6, y ese matiz es de la propia OpenAI: la base es una tarifa promocional, no una tarifa de lista.
El caso del líder es débil, y no por ningún benchmark. Un líder interpreta el objetivo, decide qué hacen los miembros y reúne sus resultados en una sola Task. Un error de interpretación en la cima no es una mala ejecución: son las ejecuciones de todos los miembros apuntando a lo incorrecto, y el ahorro en los tokens del líder es un error de redondeo frente a eso. Nuestra guía del líder de Crew sostiene el mismo argumento en el otro extremo de la lista de precios.
| Trabajo | Carril | Por qué |
|---|---|---|
| Triaje, etiquetado, mantenimiento del backlog | Luna | Alto volumen, y una persona puede comprobar el veredicto en segundos |
| Andamiaje de pruebas, notas de revisión de primera pasada | Luna con esfuerzo high | Los logros publicados son con high o max, no con un ajuste inferior |
| Cambios en código que se despliega | GPT-6 Sol a $2 / $10 | AutomationBench 33.2% a $0.27 por tarea |
| Interpretar un objetivo ambiguo para un Crew | GPT-6 Sol, o Astra a $10 / $50 | El error de un líder se multiplica por cada miembro |
Escribe eso como una regla en lugar de un hábito. Qué modelo para qué tarea de programación cubre la cuestión del enrutamiento en su totalidad.
Una advertencia sobre cómo leer los márgenes de OpenAI: su publicación de lanzamiento compara con Claude Opus 5, y Anthropic reemplazó Opus 5 con Opus 5.5 horas después, el mismo día. Las comparaciones de Luna anteriores se miden contra la generación previa del modelo que nombran.
Lo que un Runtime barato no abarata
Luna reduce el precio de producir un cambio. No hace nada al precio de aceptarlo. Diez ejecuciones baratas producen diez diffs, diez conjuntos de resultados de pruebas y diez decisiones que solo una persona puede tomar, y las propias cifras de gasto de OpenAI son una advertencia más que una tranquilidad: reporta una mediana de investigador por encima de $600 al día en agentes de programación, con el percentil 90 en $7,000. Más barato por tarea es cómo se construye una factura así.
La versión honesta del argumento, entonces. Un Runtime barato vale la pena vincularlo cuando el trabajo que asume es trabajo que una persona puede verificar rápido, y es una falsa economía cuando multiplica la cola frente a tu revisor. Mantén el contexto, el progreso, los bloqueos, los resultados y la revisión humana visibles desde la solicitud hasta el lanzamiento, y decide el carril en el momento de la asignación y no en el de la revisión. La revisión humana es el cuello de botella tiene la parte de planificación de eso.
Si ya estás ejecutando varios agentes de programación, conecta una Computer, crea un Agent en el carril barato y asígnale algo aburrido.


