
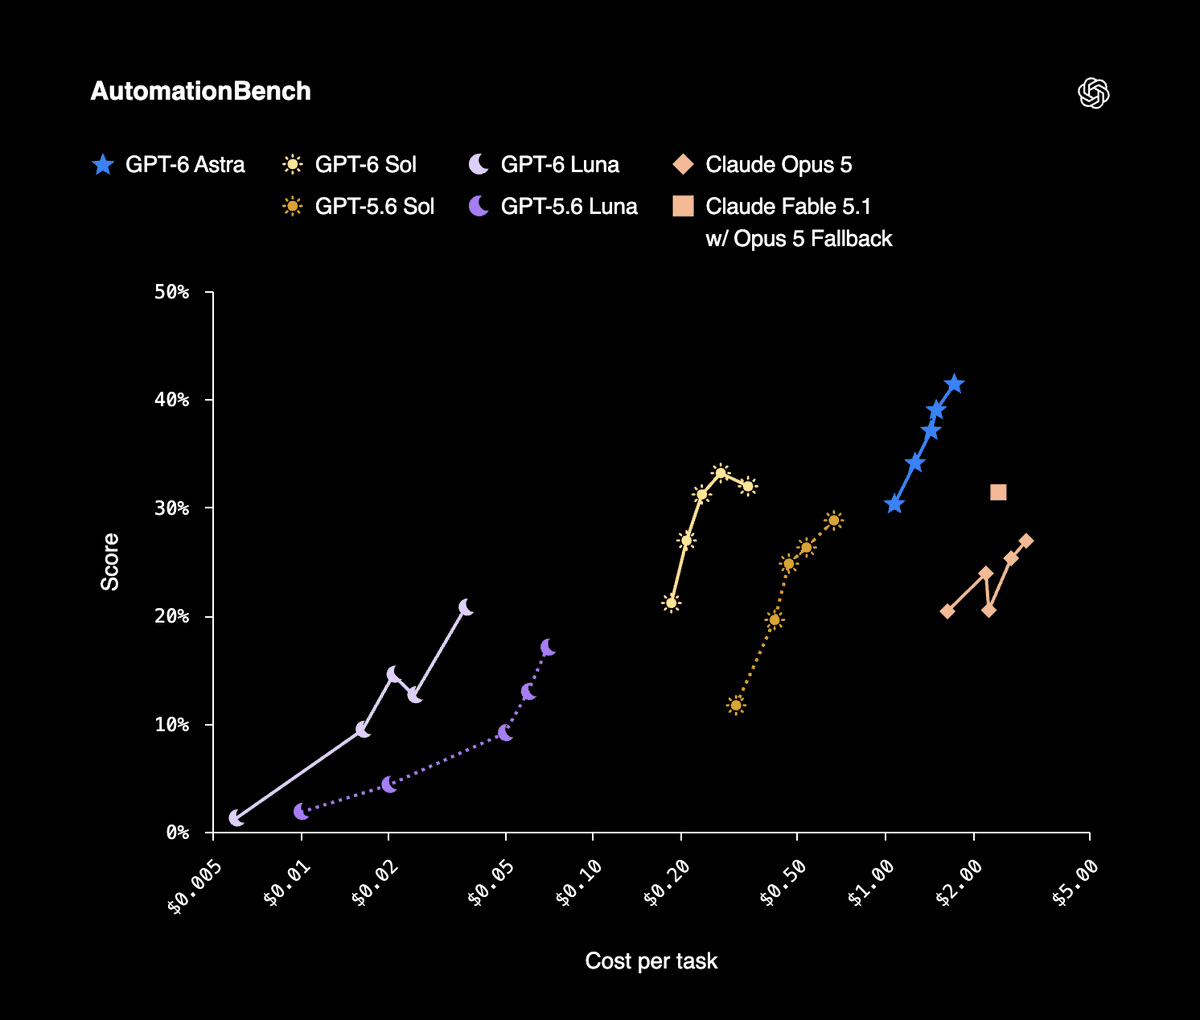
OpenAI lanzó GPT-6 Sol el 22 de septiembre a 2 dólares por millón de tokens de entrada y 10 dólares por millón de salida, con el id de API gpt-6-sol y una ventana de contexto de 872k. La cifra que debería cambiar cómo se ve tu tablero no es el precio por token. Es el coste por tarea terminada: según los resultados de AutomationBench 1.0.6 de OpenAI, Sol con esfuerzo de razonamiento xhigh obtiene un 33,2 % a 0,27 dólares por tarea, mientras que Claude Opus 5 con esfuerzo máximo obtiene un 26,9 % a 11,1 veces el coste por tarea de Sol.
Léelo como una declaración presupuestaria más que como una tabla de clasificación. Si tu equipo ha estado racionando las ejecuciones de agentes porque una ejecución completa salía cara, esa restricción acaba de moverse. La siguiente restricción es la que nadie puede sortear a base de talonario: una persona sigue teniendo que leer el diff y aceptar el trabajo. Esta guía recorre el camino útil más corto por la configuración y luego es sincera sobre la parte que la bajada de precios no resuelve. Pon Sol en Codex en un Computer, crea un Agent y asigna una Task real.
TL;DR
Configura model = "gpt-6-sol" en Codex en un Computer conectado, confirma que el Runtime de Codex aparece como Available en Sharkly, mantén el directorio de trabajo del Agent en modo Temporary, sube el timeout por Task antes de fiarte de la primera ejecución larga y asigna una Task. Sharkly no mostrará el nombre del modelo. Mostrará la ejecución, el log, las preguntas y el resultado en la Task. Los agentes investigan, ejecutan, prueban e informan. Las personas marcan la dirección, conceden autoridad y aceptan el resultado.
Dónde se configura el modelo
Sharkly no elige modelos. La documentación de Agents lo dice sin rodeos: «El Agent sigue el modelo predeterminado del Runtime. No promete ni muestra un nombre de modelo concreto. Cambia los modelos en la configuración de la herramienta Runtime o Computer, no en el Agent».
En un Agent no hay ningún desplegable de modelos ni tampoco un control de profundidad de razonamiento, así que no los busques. Cuatro roles, una función cada uno. El Agent define cómo debe gestionarse el trabajo. El Computer aporta el host y los recursos locales. El Runtime ejecuta la sesión de agente propiamente dicha, y aquí el Runtime es Codex. La Task sigue siendo el registro compartido del equipo.
Paso 1: pon GPT-6 Sol en Codex en el Computer
En el Computer que vaya a ejecutarlo, actualiza Codex e inicia sesión con una cuenta o una clave de API que tenga acceso a Sol. OpenAI puso Sol a disposición en ChatGPT Work y en Codex para los planes Plus, Pro, Business, Enterprise y Edu, y todavía no está en Chat. Si codex -m gpt-6-sol inicia una sesión en un terminal normal de ese host, Sharkly puede usarlo.
Después configura el valor predeterminado para que todas las ejecuciones de este Computer lo adopten:
# ~/.codex/config.toml
model = "gpt-6-sol"
model_provider = "openai"
model_reasoning_effort = "xhigh"
Dos advertencias sobre ese fragmento. El nombre de la clave de esfuerzo de razonamiento varía entre versiones de Codex, así que compruébalo con la configuración de ejemplo de la build de Codex que haya en ese Computer. Y el nivel de esfuerzo es una decisión de coste, no un dial de calidad que se deja al máximo: los resultados publicados por la propia OpenAI usan niveles de esfuerzo distintos para cada benchmark, y la cifra de 0,27 dólares por tarea de arriba es la fila de xhigh. [VERIFY]
De vuelta en Sharkly, abre el detalle del Computer y ejecuta el reescaneo o la prueba de conexión. El Runtime de Codex debería aparecer como Available. Que un Computer aparezca como online solo significa que su servicio local está enviando latidos. Lo que te dice que una ejecución puede arrancar es el estado de capacidad del Runtime.
Paso 2: configura la caché antes de escalar el Crew
Este es el cambio de GPT-6 que más importa en cuanto hay más de un Agent trabajando en el mismo repositorio, y es el que la mayoría de los equipos se saltará.
OpenAI informa de tasas de acierto de caché más altas por defecto en GPT-6, un descuento del 90 % en las lecturas de entrada en caché, un panel de prompt caching y una herramienta de diagnóstico y, lo que es importante para el trabajo con agentes, que cambiar el esfuerzo de razonamiento o la disponibilidad de herramientas ya no invalida la caché. Los breakpoints explícitos te permiten elegir dónde termina un prefijo en caché. OpenAI menciona el caso de GitHub, que ha visto más de un 50 % menos de tokens de prompt que necesitan procesarse de nuevo a lo largo de miles de millones de peticiones.
En un crew, la forma práctica es esta. Cada ejecución de un Agent sobre el mismo repositorio reenvía un prefijo grande y casi idéntico: la estructura del repositorio, las reglas internas, el comando de pruebas, las convenciones. Ese prefijo es exactamente para lo que sirve una caché, y es la razón por la que una flota de agentes puede costar mucho menos por ejecución que el primer agente.
Un par de decisiones, porque esto no es trabajo gratis. Fija un prefijo estable y define un breakpoint explícito cuando varios Agents se ejecuten repetidamente contra una misma base de código y el texto de tus Skills e instrucciones ya esté asentado. No te molestes cuando un Agent se ejecute un puñado de veces a la semana o sus instrucciones sigan cambiando cada semana, porque pasarás más tiempo manteniendo el límite de lo que ahorras.
Paso 3: construye el Agent pensando en una ejecución que arranca despacio
Abre Agents, selecciona New Agent, elige el Computer y el Runtime de Codex y luego configura tres cosas.
Timeout por Task. Configúralo a conciencia, porque una ejecución de Sol en un modo de razonamiento alto puede parecer muerta antes de parecer ocupada. Artificial Analysis, un tercero independiente de ambos proveedores, midió 102,15 segundos hasta el primer token en la variante de razonamiento máximo de GPT-6 Sol. Eso es más de lo que espera la mayoría de la gente antes de dar por hecho que algo se ha colgado, y es exactamente el fallo que evita un estado en un tablero compartido y que no evita una terminal. Una ejecución que está pensando y una que se ha caído se ven idénticas en el historial de una consola. Consulta observabilidad de agentes de programación para saber qué tiene que incluir un estado para merecer la pena leerlo.
Directorio de trabajo. Modo Temporary. Cada Task recibe un directorio aislado, y las ejecuciones respaldadas por un repositorio preparan un worktree nuevo, de modo que dos ejecuciones de Sol sobre el mismo repositorio no pueden escribirse una encima de otra. La concurrencia predeterminada para directorios temporales es el 50 % del límite del Computer. Déjala ahí hasta que ese Computer haya gestionado varias ejecuciones reales; una concurrencia mayor consume CPU, memoria, disco y capacidad del proveedor a la vez.
Instrucciones. Cortas y estables:
Read the Task description and recent comments before editing.
Keep changes limited to the requested behavior.
Ask a question only when different interpretations would
materially change the result; otherwise proceed with a stated
assumption and record it in your report.
Run the closest relevant checks and report failures without hiding them.
Stop and ask before anything destructive or outside the repositories
attached to this Agent.
Paso 4: asigna una Task y luego decide si un Crew se gana su sitio
Elige una Task con un criterio de aceptación claro. Selecciona el Agent como Assignee y saca la Task de Backlog a un estado cuya categoría sea la de listo para trabajar; una Task asignada que sigue en Backlog espera. La ejecución pasa por queued, dispatched y running, y la pestaña Executions va mostrando el log en streaming. Si el Agent necesita una decisión, la pregunta vuelve a la Task como comentario, la Task muestra que está a la espera de una respuesta humana y eso se enruta a tu Inbox.
Para un cambio acotado, un solo Agent es la decisión correcta y las piezas móviles se quedan en cero. Un Crew es un grupo reutilizable de People y Agents coordinado por un Agent líder, y se gana su sitio cuando el líder tiene que interpretar un objetivo y reunir los resultados de varios miembros en una sola Task.
Sol cambia esas cuentas, porque un líder sobre todo lee, planifica, asigna y revisa, y ese era el trabajo más difícil de justificar en lo más alto de una lista de precios:
| Modelo del Runtime | id de API | Entrada / salida por 1M | Dónde encaja en un Crew |
|---|---|---|---|
| GPT-6 Astra | no indicado | 10 $ / 50 $ | Líder cuando el propio plan es la parte difícil |
| GPT-6 Sol | gpt-6-sol |
2 $ / 10 $ | Líder y los miembros que hacen cambios reales |
| GPT-6 Luna | gpt-6-luna |
0,10 $ / 0,50 $ | Miembros de alto volumen: triaje, etiquetado, scaffolding |
Escribimos esta misma configuración para Astra en cómo usar GPT-6 Astra como líder de Crew. El argumento sigue en pie; lo que se ha movido es el precio que lo sustenta.
Lo que la bajada de precios no compra
OpenAI describe Sol como un 50 % más barato que el precio promocional de GPT-5.6. Ese matiz es de la propia OpenAI y es importante, porque la base de comparación es una tarifa promocional y no una tarifa de lista. Hay dos advertencias más que merecen estar en la misma página. Los benchmarks de lanzamiento de OpenAI se comparan con Claude Opus 5, al que Anthropic sustituyó por Opus 5.5 unas horas después, ese mismo día, así que esos márgenes hay que leerlos como medidos contra la generación anterior. Y el nivel de esfuerzo es el que hace el trabajo: Sol alcanza un 68,8 % en DeepSWE 1.1 y un 56,4 % en Agents' Last Exam V1 con esfuerzo máximo, no con el ajuste que dejarías puesto para tareas rutinarias.
Y luego está la parte que no tiene nada que ver con el modelo. OpenAI informa de que su investigador medio se gasta más de 600 dólares al día en agentes de programación, y el percentil 90 supera los 7000. Que algo sea más barato por tarea es la forma en que se construye una factura así, no la forma de evitarla. Cada ejecución sigue produciendo un cambio que una persona tiene que leer, cuestionar y aceptar, y esa cola no se ha abaratado 11 veces esta semana. Planifica en torno a la capacidad de revisión y no en torno a la elección de modelo, deja el enrutamiento por escrito como regla en lugar de como preferencia y mantén la asignación, el progreso, los bloqueos, los resultados y la revisión humana en un mismo sitio desde la petición hasta el despliegue.
Si ya tienes varios agentes de programación en marcha, conecta un Computer, crea un Agent y asígnale algo aburrido.


