
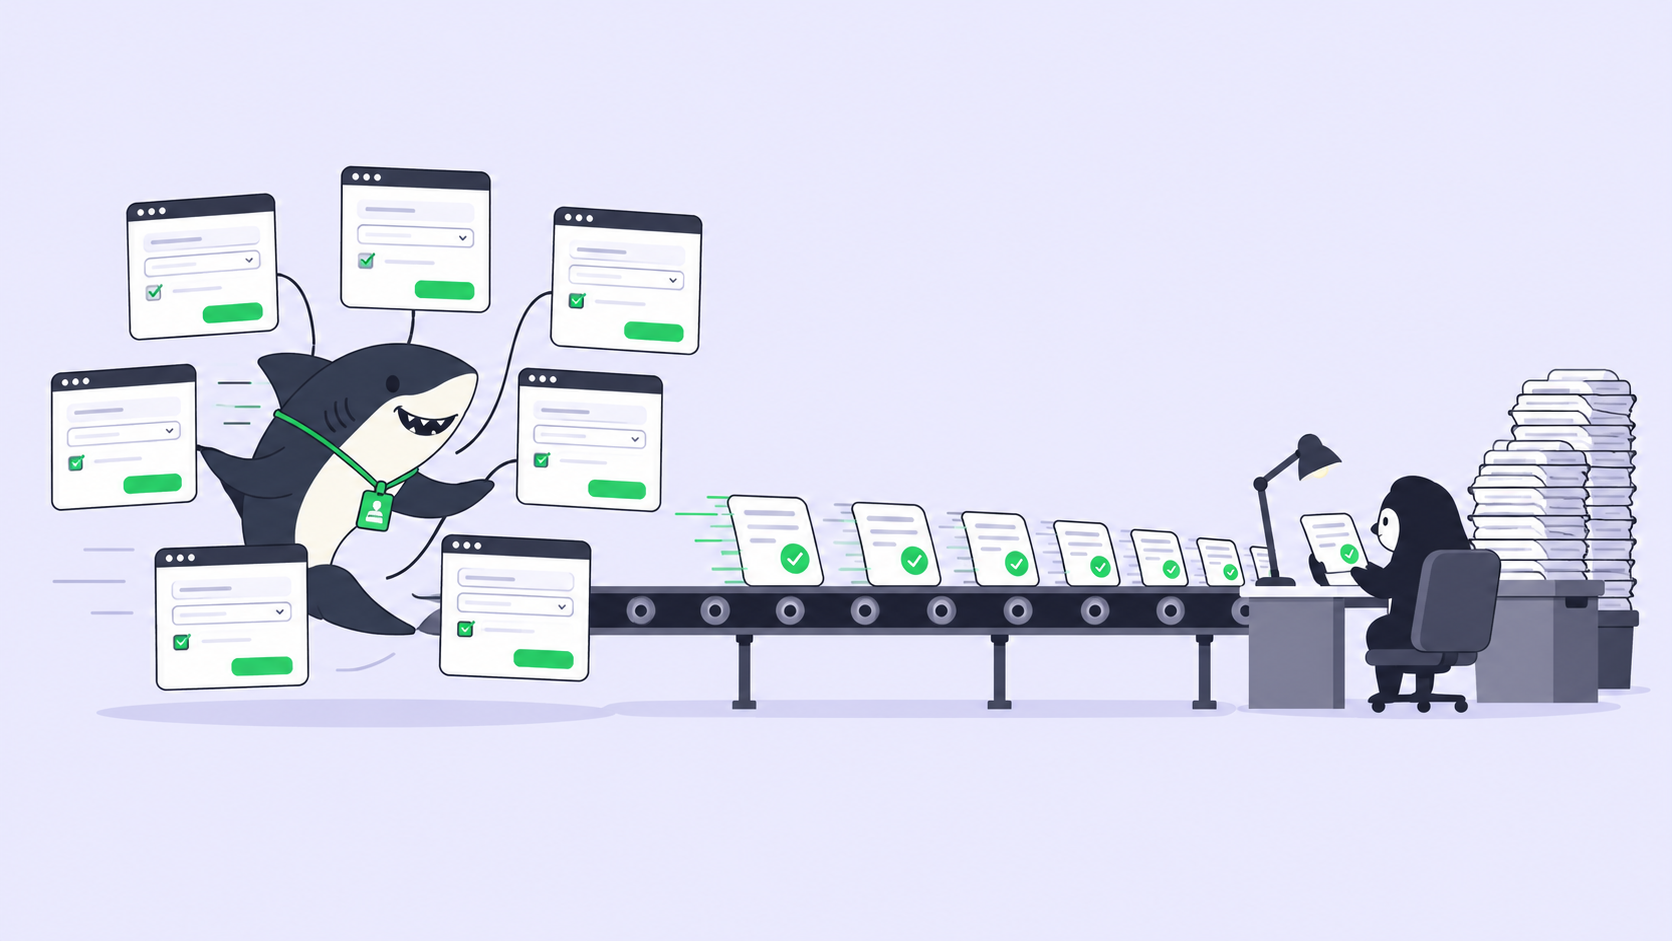
Anthropic lanzó Claude Haiku 5.5 el 7 de octubre y lo orientó de lleno a tareas de navegación web. El artículo de lanzamiento lo presenta como una excelente opción para «tareas donde la velocidad es crítica, como atención al cliente en tiempo real y uso del navegador»; la página del producto destaca el llenado de formularios, la introducción de datos y la transferencia de información entre aplicaciones. Además, esta misma versión incorporó en fase beta las capacidades de computer use y browser use a los SDK de Python y TypeScript de Anthropic. En OSWorld 2.1, el benchmark de computer use que cita Anthropic, Haiku 5.5 obtiene una puntuación del 72.4% por unos $0.61 por intento con esfuerzo máximo, y un 53.3% por unos $0.13 con el nivel de esfuerzo medio predeterminado.
La cifra destacada corresponde a una puntuación con crédito parcial. Si revisas la system card, esas mismas ejecuciones tienen una tasa de éxito estricta de solo el 37.1%. Por lo tanto, un equipo que integre Haiku 5.5 en un flujo de navegador obtiene una ejecución que cuesta unos pocos centavos y un resultado que, la mayoría de las veces, queda a medio hacer. La ejecución se volvió barata; revisarla, no. Para un equipo que opera múltiples agentes, esto traslada el costo real de la automatización en el navegador a quien deba revisar los resultados.
TL;DR
En el subconjunto offline de OSWorld 2.1 de Anthropic, Haiku 5.5 promedia un 72.4% de crédito parcial, pero completa con éxito estricto apenas el 37.1% de los intentos; Sonnet 5.5 y Opus 5.5 muestran la misma brecha de 34 a 35 puntos a precios más altos. Trata cada ejecución de navegador como incompleta hasta que sea verificada: incluye un criterio de aceptación estricto en la Task, haz que el Agent se detenga antes de cualquier acción de envío y reporte lo completado, lo pendiente y las evidencias, y permite que una persona autorice el paso final mediante un comentario que mencione con @ al Agent. Invierte en esfuerzo del modelo para ahorrar tiempo de revisión: la ejecución es la parte barata. Los agentes investigan, ejecutan, prueban y reportan. Las personas marcan el rumbo, otorgan autorización y aceptan el resultado.
El crédito parcial no significa haber terminado
Anthropic evaluó OSWorld 2.1 en 82 de sus 108 tareas a 1080p, con hasta 500 pasos por intento en el nivel de esfuerzo máximo y promediado a lo largo de cinco ensayos. Reportó dos cifras por modelo, y la segunda es con la que realmente tiene que lidiar quien revisa.
| Modelo (esfuerzo máximo) | Crédito parcial | Aprobación estricta | Diferencia | Costo por intento | Costo por aprobación estricta (nuestros cálculos) |
|---|---|---|---|---|---|
| Haiku 5.5 | 72.4% | 37.1% | 35.3 pts | $0.61 | alrededor de $1.65 |
| Sonnet 5.5 | 83.9% | 48.8% | 35.1 pts | $5.73 | alrededor de $11.75 |
| Opus 5.5 | 87.2% | 53.2% | 34.0 pts | no registrado | no registrado |
En primer lugar, esta brecha no es un problema exclusivo de Haiku. Cada modelo de la familia deja unos 35 puntos de distancia entre «se realizaron la mayoría de los pasos» y «la tarea está terminada», e incluso Opus 5.5 solo aprueba por completo alrededor de la mitad de las veces. Una gran proporción de los intentos de computer use, según estas mediciones, terminan a medio hacer. En segundo lugar, Haiku 5.5 hace que producir trabajo parcialmente terminado sea sumamente barato. Por aprobación estricta, cuesta aproximadamente una séptima parte de Sonnet 5.5, y por intento, alrededor de una novena parte.
Quedar a medias es el escenario más peligroso en las tareas de navegador. Una ejecución que falla por completo no deja rastro alguno. En cambio, una ejecución que transfiere 31 de 40 registros al CRM, o que completa el formulario de un proveedor hasta llegar al campo de impuestos, deja cambios en una aplicación externa que a simple vista parecen terminados. Quien deba revisarlo tendrá que localizar los nueve registros faltantes sin ninguna indicación en pantalla que señale cuáles son.
Hacia dónde se desplaza el costo cuando la ejecución cuesta centavos
Un flujo de navegación económico cambia la partida presupuestaria a la que debes prestar atención. A $0.13 por intento, cien ejecuciones de llenado de formularios son apenas un error de redondeo en la factura del modelo. Sin embargo, cien ejecuciones que requieran que una persona confirme lo que se introdujo pueden consumir la jornada laboral completa de alguien. Haiku 5.5 tiene un precio un 90% inferior al de Haiku 4.5 en prompts de hasta 100K tokens; la persona que revisa, no.
También hay un matiz importante en los precios. Haiku 5.5 cuesta $0.10 por millón de tokens de entrada y $0.50 por millón de salida para prompts de hasta 100K tokens, y sube a $0.50 y $2.50 respectivamente para prompts que superen los 100K. Una sesión de navegador prolongada puede hacer crecer el prompt más allá de ese límite y, a partir de ese momento, cada solicitud pagará la tarifa más alta. Esa es otra razón de peso para mantener breves las Tasks de navegador: un formulario, un lote de registros, una Task.
La revisión humana es el cuello de botella y jornadas laborales de agentes por jornada humana ya habían planteado este argumento. Lo que Haiku 5.5 cambia es la proporción: a $0.13 por ejecución, el costo del modelo apenas se nota, y los modelos económicos pueden salir más caros una vez que se contabiliza la cola de revisión. La única palanca disponible es acelerar cada verificación.
Revisión de agentes de computer use: qué debe contener la Task
Una Task asignada a un agente de navegación es revisable cuando verificarla toma menos tiempo que rehacer el trabajo. Esto depende de tres elementos que el Agent no puede improvisar a posteriori: un criterio de aceptación estricto definido antes de la ejecución, un reporte que distinga lo completado de lo pendiente y evidencias que una persona pueda consultar sin tener que reproducir toda la sesión.
En Sharkly, la Task ya funciona como el registro compartido: almacena la descripción, los comentarios, los archivos adjuntos y la actividad; los mensajes del Agent para el equipo quedan guardados en la Task como un comentario vinculado a la ejecución; y el registro de ejecución recopila las llamadas a herramientas y los eventos del Runtime. Así pues, el diseño de la revisión reside en dos lugares: la descripción de la Task define qué significa «terminado», y las instrucciones del Agent establecen el contenido que debe incluir el reporte. Un buen punto de partida para las instrucciones de un Agent encargado de introducir datos en el navegador:
Restate the acceptance check from the Task description before you start.
Work up to, but not including, any submit, send, publish, pay, or delete action.
Then stop and report, in this order:
  Done: every record or field you completed, by its identifier.
  Not done: everything you skipped or could not complete, and why.
  Check: the acceptance check, and whether your own count meets it.
  Evidence: the paths of the screenshots you saved in the task directory.
Leave the Task waiting for human review. Do not take the final action
until a person @ mentions you in a comment on this Task to release it.
Define el criterio de aceptación como algo cuantificable: «40 filas en el CRM, cada una con su correo electrónico correspondiente», en lugar de «importar la hoja de cálculo». La lista «Not done» es justo lo que el crédito parcial oculta; detallar qué se omitió convierte una ejecución al 72% en una ejecución al 72% con un remanente claramente identificado. Nuestra guía sobre cómo revisar el trabajo de agentes con evidencias a nivel de tarea profundiza en los formatos de reporte.
Según la documentación de Agents de Sharkly, el Agent utiliza el modelo predeterminado del Runtime; para cambiarlo, especifica uno en Custom arguments dentro del Agent o del Runtime (claude-haiku-5-5 para Claude Code). No hay un menú desplegable para seleccionar modelos. La configuración detallada se encuentra en cómo ejecutar agentes de Claude Haiku 5.5 en Sharkly.
Detenerse antes de enviar
Un resultado parcial es aceptable para un borrador, pero totalmente inaceptable para un formulario ya enviado. Por eso, conviene separar el paso irreversible de la ejecución en lugar de confiar en que el modelo lo haga bien.
Este patrón aprovecha funcionalidades que Sharkly ya incluye. El Agent avanza hasta la acción final y deja la Task a la espera de revisión humana, lo que aparece en la bandeja de entrada (Inbox) del revisor. Quien revisa abre el reporte y las capturas de pantalla, corrige o rechaza, y luego menciona con @ al Agent en un comentario dentro de la Task para autorizar el paso. Un comentario simple no activa al Agent; la mención inicia o continúa su conversación en la Task, y su respuesta queda registrada como otro comentario vinculado a la ejecución. El envío se produce dentro de la misma Task, bajo el mismo registro, únicamente después de que una persona haya dado el visto bueno. Nuestra guía sobre compuertas de aprobación explica en qué otros puntos conviene establecer esa pausa.
Esta compuerta también mitiga el otro gran riesgo en la navegación web: un agente de navegador lee páginas que no ha redactado. La system card de Anthropic señala que Haiku 5.5 resiste la inyección de prompts mejor que cualquier Haiku anterior, igualando en gran medida a sus modelos de vanguardia frente a atacantes adaptativos en entornos de computer use. No obstante, eso es el resultado de un benchmark, no una garantía sobre el portal de tu proveedor; además, una instrucción inyectada que no puede alcanzar el botón de envío sin un comentario humano representa un incidente mucho menor. El límite en el host (una Computer dedicada, credenciales asignadas por Agent mediante sus variables de entorno secretas y una sola ejecución de navegador a la vez) es idéntico al descrito en nuestra guía sobre barreras de contención para computer use, y el artículo sobre inyección de prompts y barreras para agentes cubre los aspectos restantes.
Un criterio doble para decidir en este flujo: utiliza un Agent de navegador con Haiku 5.5 cuando el resultado pueda comprobarse frente a un recuento o una lista en menos de un minuto, y la acción final sea reversible o esté condicionada a un comentario. Mantén el trabajo en manos de una persona, o de un modelo más potente con esa misma compuerta, cuando verificar implique tener que rehacer la tarea, ya que en ese caso una tasa de éxito estricta del 37% solo servirá para obligarte a hacer una segunda pasada.
Pagar por esfuerzo para ahorrar en revisión
Haiku 5.5 es el primer Haiku de Anthropic que incorpora un ajuste de esfuerzo, siendo el valor predeterminado el nivel medio. En OSWorld, incrementar el esfuerzo eleva notablemente la puntuación de crédito parcial por un costo ínfimo:
| Esfuerzo | Crédito parcial | Costo por intento |
|---|---|---|
| Bajo | 42.0% | $0.07 |
| Medio (predeterminado) | 53.3% | $0.13 |
| Alto | 61.3% | $0.18 |
| Extra alto | 67.6% | $0.28 |
| Máximo | 72.4% | $0.61 |
Pasar de medio a máximo añade unos $0.49 por intento y 19 puntos de crédito parcial. Si esos puntos logran reducir el tiempo de revisión, aunque sea mínimamente, el nivel máximo resulta la opción más económica para cualquier Task de navegador supervisada por una persona. La system card grafica la tasa de éxito estricta según el esfuerzo, pero solo especifica el valor numérico en el nivel máximo, de modo que conviene medir los resultados estrictos en tus propias Tasks antes de elegir un nivel inferior. El esfuerzo se configura en Claude Code dentro de la Computer: el Agent no ofrece un selector de modelo ni un control para la profundidad de razonamiento. Reserva el flujo económico para tareas donde nadie vaya a leer el resultado, tal como se explica en Luna para el aburrido ochenta por ciento; un flujo de navegador no pertenece a esa categoría.
Las tareas de navegador que escriben en sistemas de terceros deben tener su propia Task en lugar de formar parte de una ejecución más amplia, ya que alguien tiene que aprobarlas; el artículo sobre Haiku 5.5 como subagente o como su propio Agent aborda esta regla general.
Un agente de navegador más económico se traduce en más ejecuciones, y más ejecuciones significan más resultados a medio terminar a la espera de que alguien los revise. Si ya estás ejecutando varios agentes, Sharkly te ofrece un único lugar para gestionar todas sus tareas y resultados.


