
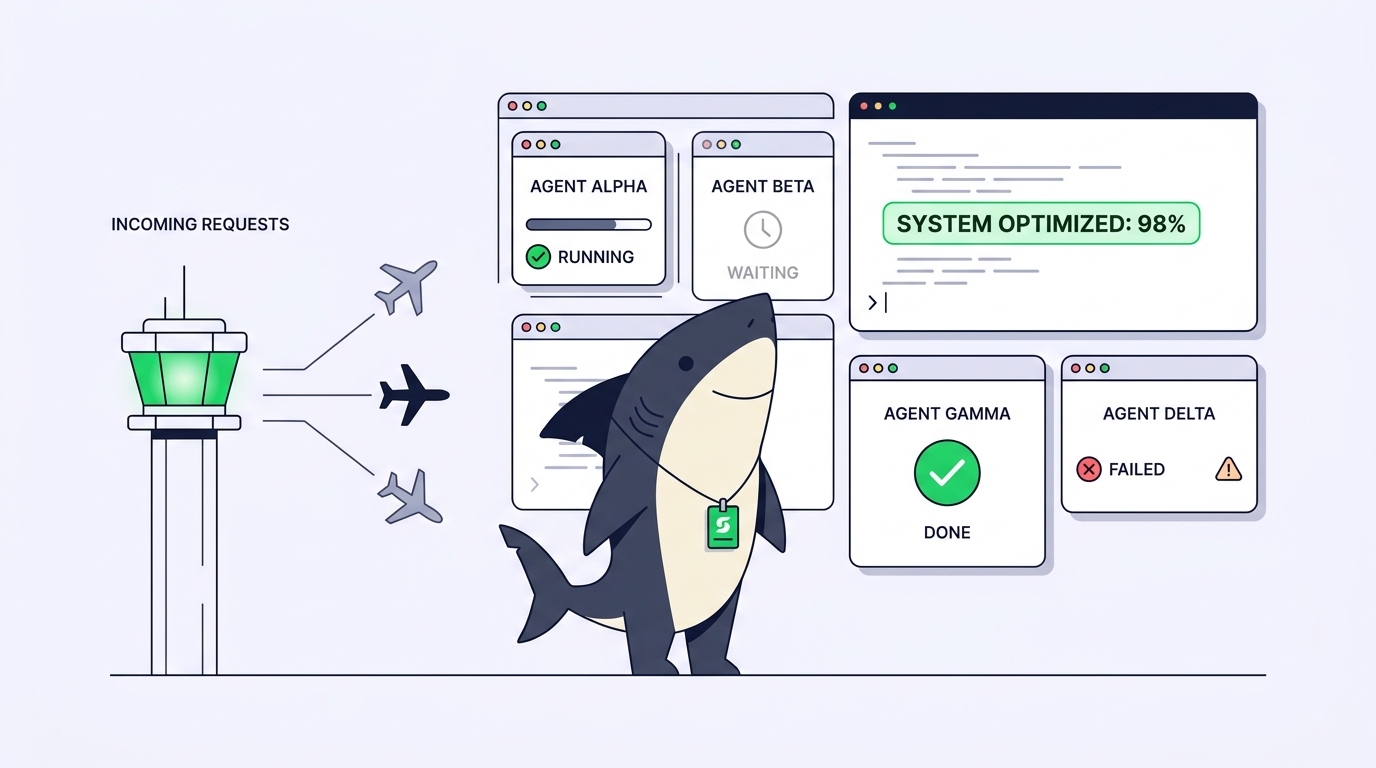
Esta mañana pusiste a trabajar tres agentes de programación. Uno está refactorizando un módulo de autenticación, otro está escribiendo pruebas y el tercero está lidiando con un fallo intermitente en la CI. Una hora después, tienes cinco terminales abiertas, dos paneles desconectados de tmux y la molesta sospecha de que al menos uno se detuvo hace rato y ha estado inactivo sin que te dieras cuenta. Haces alt-tab, revisas un log y tratas de adivinar qué pasa.
Esa incertidumbre es el verdadero coste de ejecutar agentes en paralelo. Lanzar varios agentes de programación a la vez hoy en día es sencillo. Lo que realmente te consume la tarde es averiguar cuál necesita tu intervención, cuál se ha quedado atascado y cuál ha terminado en silencio. Monitorizar agentes de programación en paralelo implica responder a cuatro preguntas en tiempo real sin tener que abrir cinco ventanas distintas: qué está haciendo cada agente, cuánto ha avanzado, qué lo está bloqueando y qué resultados están listos para revisión.
Esta guía aborda primero la configuración artesanal de monitorización, identificando los puntos de fallo en cada etapa; luego, muestra dónde deja de escalar ese enfoque y qué aporta una capa compartida de tareas. Esa capa compartida es Sharkly: ya cuentas con agentes de programación, y Sharkly los coordina como un equipo al mantener el progreso, los bloqueos y los resultados de cada agente visibles en un solo lugar en vez de dispersos en múltiples terminales. Puedes montar casi todo el sistema de monitorización por tu cuenta; el objetivo de repasar ambas opciones es tener muy claro cuándo la solución casera empieza a costar más de lo que ahorra.
Las cuatro señales a las que conviene prestar atención
Monitorizar no se reduce a una sola variable. Cuando alguien dice que la ejecución de un agente «parece ir bien», suele referirse a una de cuatro señales distintas, y cada una de ellas falla de forma diferente.
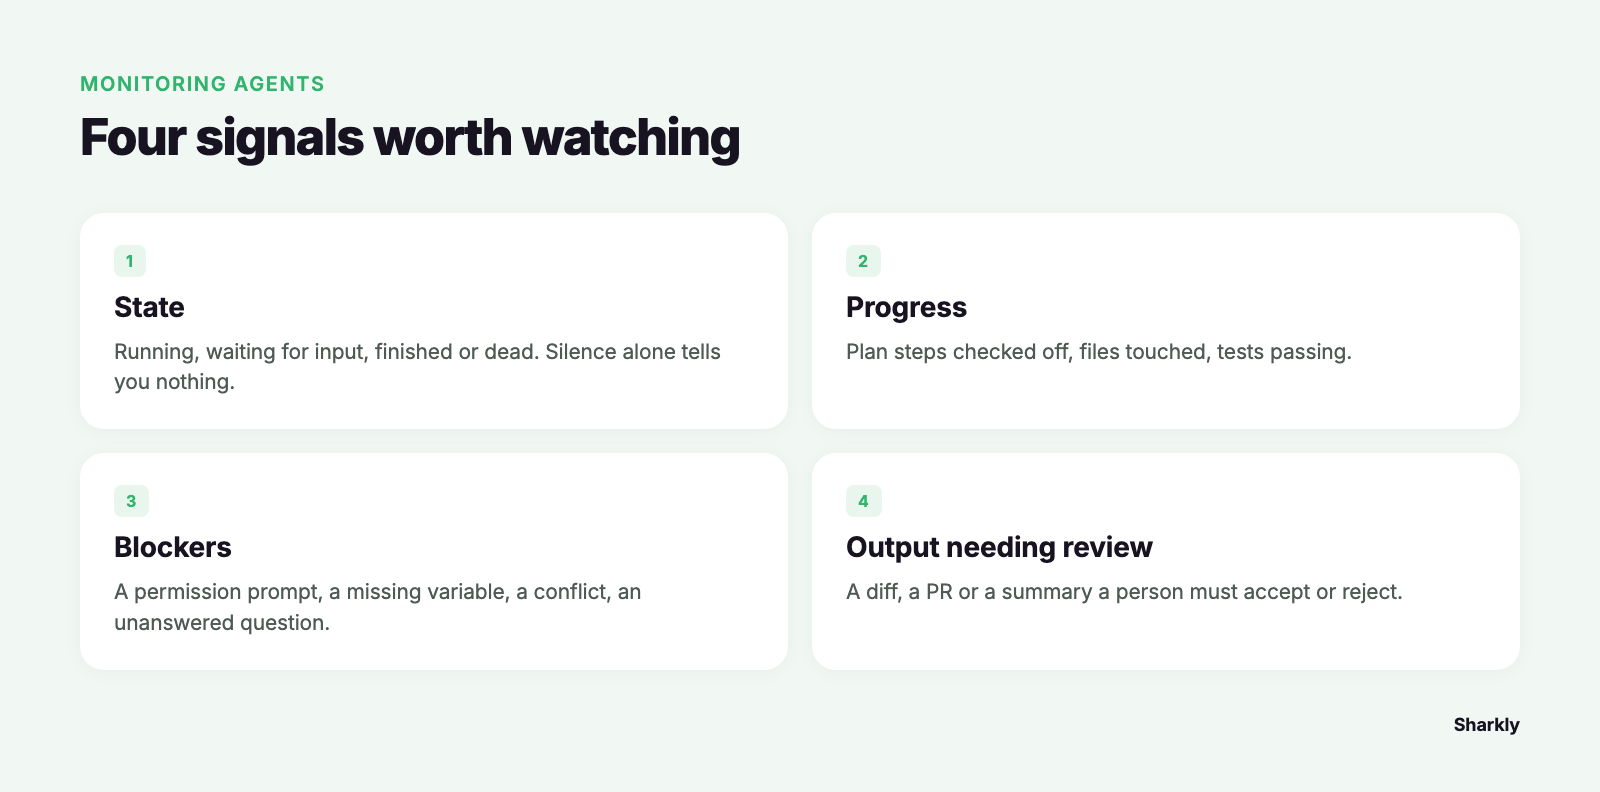
- Estado. ¿El proceso está en ejecución, esperando una entrada, finalizado o colgado? Tanto un agente que ha terminado como uno congelado dejan de generar salida, por lo que el silencio no te dice nada por sí solo.
- Progreso. ¿Cuánto de la tarea se ha completado? Pasos de un plan marcados como listos, archivos modificados, pruebas superadas. El progreso es lo que indica si un agente en ejecución realmente avanza o si está atrapado en un bucle.
- Bloqueos. ¿Qué está esperando el agente? Una confirmación de permisos, una variable de entorno que falta, un conflicto de fusión o una pregunta que hizo y nadie ha respondido.
- Resultados pendientes de revisión. ¿Qué ha generado el agente que un humano deba aceptar o rechazar? Un diff, una PR o un resumen de cambios.
Si solo vigilas el estado, pasarás por alto al agente que sigue ejecutándose pero está atrapado en un bucle de reintentos. Si solo vigilas el progreso, no verás al que terminó hace veinte minutos. Un buen sistema de monitorización debe mostrar las cuatro señales para cada agente de un solo vistazo.
Paso 1: monitorización artesanal y las fisuras de cada método
El enfoque casero utiliza herramientas con las que ya cuentas. Esta es la versión honesta, mostrando las carencias que deja cada solución.
Saber qué se está ejecutando. Si cada agente corre en su propio worktree de git, puedes listarlos junto con sus ramas:
git worktree list
tmux ls   # if each agent runs in a tmux session
Punto de fallo: esto te dice que una sesión existe, no si el agente dentro de ella está trabajando o esperando. Un panel de tmux bloqueado en una pregunta de Continue? (y/n) se ve exactamente igual que uno en plena tarea. Solo te enteras cuando te conectas a la sesión.
Supervisar el progreso. Puedes hacer un tail a la salida de cada agente y consultar periódicamente los cambios en su worktree:
tail -f /path/to/agent-1.log
watch -n 5 'git -C ../wt-auth status --short'
Punto de fallo: esto escala linealmente con el número de agentes. Tres logs son legibles; seis flujos de logs simultáneos no lo son, y los bucles con watch solo muestran movimiento de archivos, no significado. Ves archivos cambiar sin tener idea de si el cambio es correcto o si el agente está dando vueltas sobre lo mismo.
Detectar finalizaciones. Puedes envolver la ejecución de cada agente para que te avise cuando el proceso termine:
your-agent-command "$TASK"; \
  curl -s -X POST "$WEBHOOK_URL" -d "agent-1 exited $?"
Punto de fallo: un código de salida 0 solo significa que el proceso concluyó, no que el trabajo esté bien hecho o si siquiera está completo. Muchos agentes finalizan sin errores tras formular una pregunta que nunca viste. Una notificación de «completado» te acostumbra a confiar en una señal que en realidad no garantiza que esté terminado.
Detectar conflictos. Cuando varios agentes comparten el mismo repositorio, los worktrees mantienen separados sus directorios de trabajo, pero si dos agentes editan el mismo archivo en dos ramas distintas, colisionarán inevitablemente al fusionar.
git worktree list --porcelain | grep branch
Punto de fallo: descubres el solapamiento al intentar hacer el merge, que es el momento más costoso para enterarte.
Nada de esto está mal. Para dos o tres agentes con tareas independientes, un par de paneles de tmux y un bucle con watch forman un sistema de monitorización razonable, y no necesitas complicarte con nada más pesado. Mantén las partes móviles al mínimo hasta que te topes con el muro.
Dónde deja de escalar la monitorización casera
El muro aparece cuando ejecutas tantos agentes que ya no caben en una sola pantalla. En ese punto, tres problemas se potencian entre sí:
El sondeo indica el estado, no la causa. git status y un seguimiento de logs te muestran que algo cambió o que la salida se detuvo. No pueden aclararte si el agente está bloqueado esperando una respuesta, detenido por una dependencia que falta o si ya terminó. Terminas conectándote a cada sesión una por una para diagnosticar el problema, lo que reproduce exactamente el constante cambio de terminales que el paralelismo debía eliminar.
No existe un estado compartido. Tu monitorización vive en tu portátil, en tu servidor de tmux o en el historial de tu shell. Un compañero de equipo no puede ver qué agente se encarga de cada tarea, y tú tampoco podrás hacerlo una vez que cierres la tapa del portátil. Cuando un agente se ejecuta en una máquina remota, el método de inspección local deja de servir por completo.
La revisión se convierte en el cuello de botella. Este es el factor que más se subestima. Ejecutar agentes en paralelo no sirve de mucho si la revisión de sus resultados vuelve a serializarse en una cola de uno en uno. Cinco diffs completados sin un lugar centralizado para seguir los estados «revisado / cambios solicitados / fusionado» se reducen a cinco pestañas del navegador y una nota mental. Los agentes se volvieron más rápidos; el humano se volvió más lento.
Llegado a ese punto, no te hacen falta más terminales: te hace falta un registro compartido.
Qué aporta un tablero de tareas: centralizar los resultados en un solo lugar
Una capa de tareas transforma la unidad de monitorización: en lugar de vigilar «un proceso en un panel», pasas a gestionar «una Tarea con un estado». Esta es la premisa sobre la que se diseñó Sharkly, y encaja a la perfección con las cuatro señales.
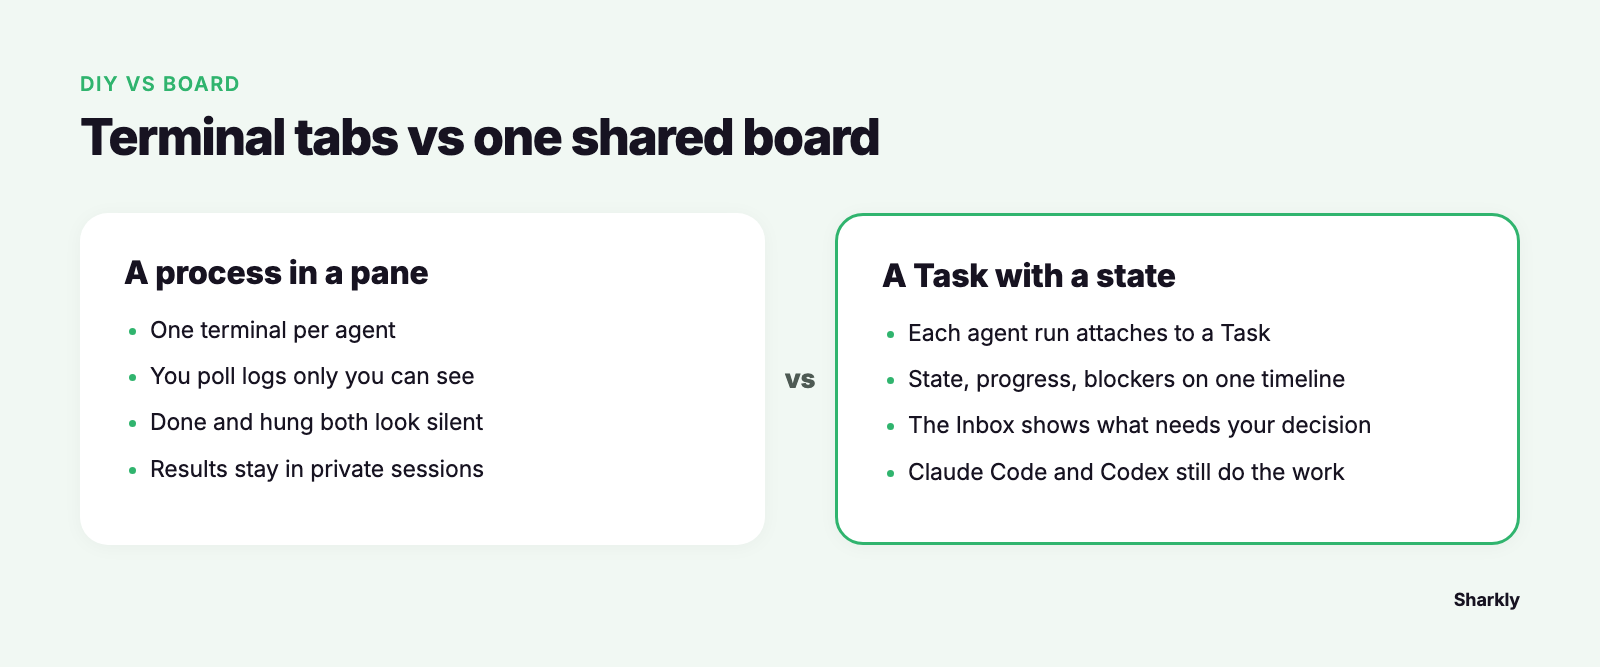
Cada ejecución de un agente se vincula a una Tarea. El estado, el progreso, los bloqueos y los resultados quedan registrados en la cronología de esa Tarea en lugar de quedar confinados en un log que solo tú puedes ver. En vez de consultar manualmente una y otra vez, observas un tablero: qué Tareas están en progreso, cuáles están bloqueadas y cuáles han finalizado y esperan tu visto bueno. El Inbox de Sharkly saca a la superficie las ejecuciones que requieren intervención humana; así, la pregunta ya no es «¿terminó algo?», sino «esto es lo que requiere mi decisión». Los agentes investigan, ejecutan, prueban y reportan; las personas marcan el rumbo, otorgan permisos y validan el resultado. La automatización se detiene donde entra en juego el criterio humano.
Este límite es fundamental, ya que es fácil caer en el error: Sharkly no ejecuta el agente ni escribe el código. Claude Code, Codex y el resto de los entornos que ya utilizas siguen encargándose de la ejecución. Sharkly añade la capa compartida de tareas, cómputo, contexto y revisión a su alrededor, de modo que el progreso de cada ejecución y su correspondiente diff queden registrados a la vista de todo el equipo, desde la solicitud hasta el despliegue. Además, mantiene cada ejecución en su propio worktree aislado, conteniendo por Tarea los conflictos en un mismo archivo que de otro modo solo descubrirías durante el merge.
La regla para decidir con honestidad: si ejecutas uno o dos agentes en tareas no relacionadas y nunca delegas trabajo a nadie, la monitorización casera basta y Sharkly sería una complicación innecesaria. La ecuación cambia cuando los agentes superan la capacidad de tus pantallas, cuando las tareas corren en máquinas a las que no tienes acceso físico inmediato o cuando otras personas necesitan consultar el mismo tablero. Si prefieres seguir utilizando múltiples agentes de programación en vez de atarte a un único ecosistema, esa vista unificada es precisamente el problema que Sharkly busca resolver. Para tener una visión más amplia de lo que debería incluir ese panel, consulta qué debe mostrar realmente un panel para agentes de programación con IA.
Una lista de comprobación de monitorización aplicable hoy mismo
Tanto si mantienes una solución casera como si pasas a una capa compartida, el sistema de monitorización de agentes en paralelo debería responder a estos puntos sin que tengas que conectarte a una sola sesión:
- Cada agente está asociado a una tarea con nombre. Nada de un «agente-3» anónimo: debes poder identificar para qué sirve cada uno.
- El estado se visualiza de un vistazo. En ejecución, esperando confirmación, terminado o fallido; diferenciados con claridad, sin tener que deducirlos por la falta de actividad.
- Los agentes bloqueados piden paso. Un aviso a la espera de un
y/n, un secret ausente o una pregunta sin responder se te notifican de inmediato en vez de quedar estancados en silencio. - Finalizado significa listo para revisión, no solo proceso terminado. Una ejecución completa apunta a un diff o una PR, no a un simple código de salida.
- La revisión cuenta con su propio estado. Se hace seguimiento de si está revisado, con cambios solicitados o fusionado, evitando que el trabajo en paralelo vuelva a convertirse en un embudo secuencial.
- La vista persiste con el portátil cerrado y se puede compartir. La información de estado reside en un lugar ajeno al historial de tu shell.
- El trabajo en el mismo repositorio está aislado. Cada agente cuenta con su propio worktree, y los solapamientos de archivos se detectan antes del merge, no durante el mismo.
Compara esa lista con tu configuración actual. Los puntos que hoy no puedas marcar son los que te costarán una tarde entera más adelante. Si ya estás ejecutando varios agentes, Sharkly te ofrece un único lugar para gestionar sus tareas y resultados. También puedes ejecutar tus agentes de programación actuales mediante Sharkly conservando los mismos entornos de ejecución que ya utilizas.


