
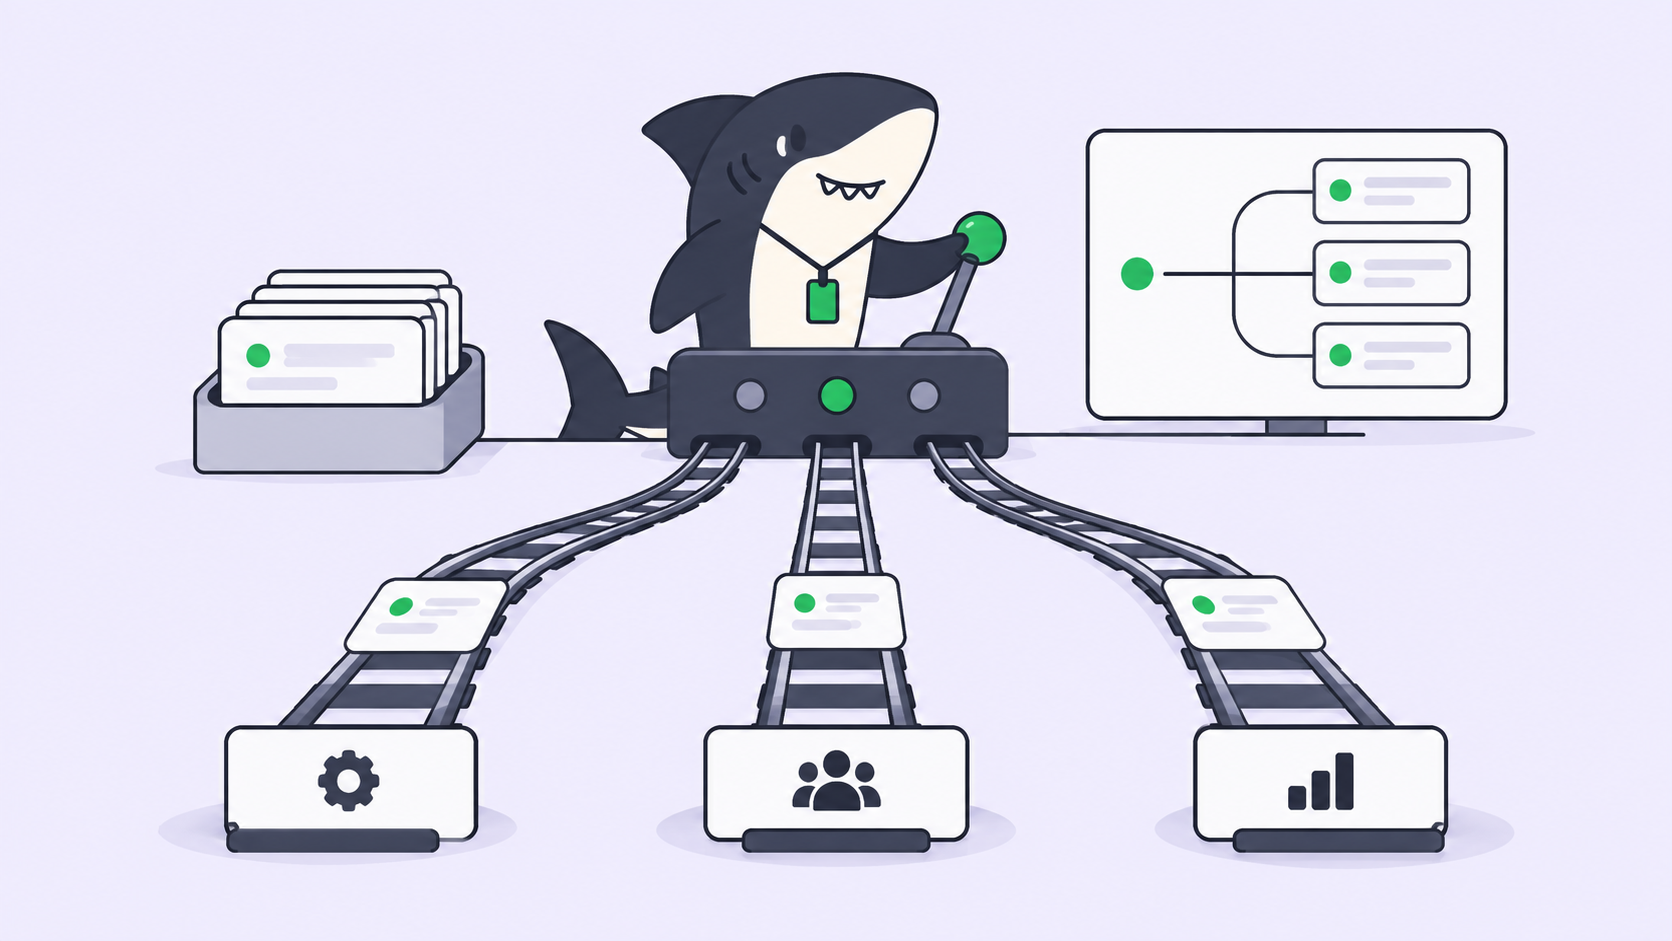
Tu equipo ya reparte el trabajo entre modelos. Lo único es que lo hace dentro de la cabeza de cada persona. Un ingeniero lo ejecuta todo en el nivel caro porque falla menos. Otro se pasó a uno barato el mes pasado y no se lo contó a nadie. Un tercero sigue con lo que la herramienta traía por defecto desde que se instaló. Eso se aguanta mientras una sola persona ejecuta un solo agente. Se rompe en el momento en que cinco Agentes se ejecutan en paralelo y nadie sabe decir cuál se está gastando cuarenta veces más de lo necesario en un docstring, ni cuál está fallando en silencio una tarea para la que nunca tuvo fuerzas.
El 22 de septiembre de 2026, la diferencia entre niveles se volvió lo bastante grande como para importar. Anthropic lanzó Claude Opus 5.5. OpenAI lanzó GPT-6 Sol y GPT-6 Luna. La brecha entre el más barato y el más caro de los tres es de un factor de cuarenta en tokens de entrada, y cualquiera de ellos es lo bastante bueno como para encargarle una Tarea real.
Una regla de enrutamiento es una declaración por escrito, no una preferencia
Una regla de enrutamiento es una declaración por escrito de qué clase de Tarea se ejecuta en qué Runtime, y va asociada al Agente que hace el trabajo, no a la persona que por casualidad inició la ejecución.
Esa es toda la idea, y la mitad importante es «por escrito». Una preferencia vive en la terminal de una persona y caduca cuando esa persona se va de vacaciones. Una regla vive junto al Agente, así que quien toma una Tarea como Assignee la hereda, quien revisa puede ver qué nivel produjo el diff que está leyendo, y cambiar de opinión el próximo trimestre es una edición en lugar de seis conversaciones.
Una regla de enrutamiento no es un ranking de modelos. No declara un ganador, y no lo necesita. Dice a dónde va por defecto cada tipo de trabajo y qué pasa cuando ese valor por defecto resulta estar equivocado.
Cuánto cuestan los tres niveles
| Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | |
|---|---|---|---|
| ID de API | claude-opus-5-5 |
gpt-6-sol |
gpt-6-luna |
| Entrada / salida por 1M | $4 / $20 | $2 / $10 | $0,10 / $0,50 |
| Entrada en caché | $0,20 lectura, $5 escritura | 90% de descuento en lecturas | 90% de descuento en lecturas |
| Contexto | 1M | 872k | 1M |
Como referencia: Claude Opus 5 a $5 / $25, y GPT-6 Astra a $10 / $50. OpenAI describe Sol y Luna como un 50% más baratos que el precio promocional de GPT-5.6. La palabra «promocional» es de OpenAI y cambia el significado: la base de ese titular es una tarifa con descuento, no una tarifa de lista. OpenAI también dice que Astra «sigue siendo nuestro mejor modelo en todos los frentes», lo cual es un recordatorio útil de que Sol es el nivel de valor dentro de su propia familia, y no su buque insignia.
Una comprobación práctica antes de escribir un nivel en una regla: OpenAI lista Sol y Luna en ChatGPT Work y en Codex para Plus, Pro, Business, Enterprise y Edu, con Free y Go recibiendo Luna en la app de escritorio, y dice que ninguno está todavía en Chat. La disponibilidad condiciona una regla de enrutamiento tanto como el precio, porque un nivel al que la mitad de tu Crew no puede acceder no es un nivel.
Enruta según el costo por tarea completada, no según la tarifa por token
El precio por token es una aproximación al número que realmente pagas. Un modelo a una quinta parte de la tarifa que necesita cuatro intentos y un rescate humano no es más barato. OpenAI publicó el costo por tarea junto a la puntuación en este lanzamiento, algo inusualmente directo y que es la forma correcta de evidencia para tomar una decisión de enrutamiento.
| Benchmark, tal como lo publicó OpenAI | Resultado | Costo por tarea, relativo |
|---|---|---|
| AutomationBench 1.0.6, Sol en extra-high | 33,2% | $0,27 por tarea |
| AutomationBench 1.0.6, GPT-6 Astra en low | 30,3% | 3,9x Sol |
| AutomationBench 1.0.6, Claude Opus 5 en max | 26,9% | 11,1x Sol |
| AutomationBench 1.0.6, Fable 5.1 con fallback a Opus 5 en max | 31,4% | más de 8,9x Sol |
| Agents’ Last Exam V1, Sol en max | 56,4%, por encima del mejor resultado de Opus 5 | 60% menos que Opus 5 |
| OSWorld 2.0 offline, Sol en extra-high | 60,5% frente al 60,3% de Opus 5 en medium | alrededor de 80% más barato |
| DeepSWE 1.1, Luna en max | 66,6% | 93% más barato que Opus 5 |
| DeepSWE 1.1, Sol en max | 68,8%, a 1,1 pp de Fable 5 en extra-high | alrededor de 80% más barato |
En esa tabla hay dos cosas ciertas al mismo tiempo. Los márgenes son grandes, y están medidos contra Claude Opus 5, no contra Opus 5.5, que no existía cuando se escribió el post de OpenAI y se lanzó unas horas después con un 40% menos de costo de ejecución que Opus 5, según la propia Anthropic. Nadie ha vuelto a hacer la comparación. Toma las filas como las últimas cifras publicadas, y el ranking que implican como una hipótesis que hay que probar en tu propio repositorio.
Lo que sobrevive a esa salvedad es la forma, y la forma es justo lo que necesita una regla de enrutamiento. Los niveles baratos se defienden bien en trabajo acotado y repetible a una fracción mínima del costo. Las propias afirmaciones de Anthropic sobre Opus 5.5 no van de precio por tarea: 40% menos de costo de ejecución que Opus 5, una salida alrededor de un 30% más rápida, 128k de salida máxima y mantenerse en la tarea durante 18 horas o más. Eso describe un modelo al que apuntas a trabajo largo y feo, no uno al que apuntas a cien trabajos pequeños.
La regla, por escrito
Este es el artefacto. Es deliberadamente aburrido, y su sitio es donde el equipo lo lee, no un archivo de configuración privado en el portátil de alguien.
ROUTING RULE  (owner: platform, review: end of Sprint)

Tier 1  Runtime: Codex on gpt-6-luna
  Triage, labelling, changelog and release notes, first-pass review
  comments, test scaffolding, dependency bumps, doc edits.
  Rule of thumb: if a wrong answer costs a reviewer one minute, route here.

Tier 2  Runtime: Codex on gpt-6-sol           <- default
  Bounded feature work, bug fixes with a reproduction, refactors inside
  one module, anything repeated many times a day and cheap to retry.

Tier 3  Runtime: Claude Code on claude-opus-5-5
  Migrations, cross-cutting refactors, work that must hold context for
  hours, anything where stopping halfway costs more than the tokens.

ESCALATION
  A Tier 1 or Tier 2 Task that fails twice returns to the Task with its
  log and does NOT silently re-run on Tier 3. A person moves it.

EXCEPTIONS
  Named on the Task, with a reason, by the Assignee. Not in a DM.
Tres líneas hacen el trabajo de verdad. El nivel por defecto está nombrado, así que una Tarea en la que nadie pensó aterriza en algún sitio sensato. La escalada es explícita, así que un fallo barato no puede convertirse en cascada en uno caro sin que nadie se entere. Las excepciones quedan registradas en la Tarea, que es la diferencia entre una regla y una sugerencia.
La escalada es la mitad que los equipos se saltan
Los ahorros de la tabla anterior son reales por intento. Se evaporan si un intento barato se convierte de forma rutinaria en un reintento caro más un rescate humano, porque entonces pagas las dos ejecuciones y la interrupción. Ese es el modo de fallo de las cadenas de fallback automáticas: esconden el costo del nivel barato dentro de la factura del caro, y nadie puede ver el tipo de cambio.
Así que haz que la escalada sea manual y visible. Una ejecución fallida vuelve a la Tarea con su log, su diff hasta ese momento y la pregunta en la que se atascó. Una persona decide si la reencamina a un nivel superior, la divide o la aclara. Los Agentes investigan, ejecutan, prueban e informan. Las personas marcan la dirección, conceden autoridad y aceptan el resultado. Si tu ruta de escalada es un bucle de reintentos, has automatizado justo la decisión que necesitaba a una persona.
Una cosa más que conviene vigilar antes de enrutar trabajo sensible a la latencia hacia un nivel inferior. Artificial Analysis, un tercero y no ninguno de los dos proveedores, midió las variantes de razonamiento «max» en 115,2 tokens de salida por segundo para Sol, con 102,15 segundos hasta el primer token, y 153,9 tokens por segundo para Luna, con 124,23 segundos. Confírmalo con el listado actual antes de fiarte. [VERIFY] La forma es lo importante: con el máximo esfuerzo de razonamiento, los modelos baratos no son los de arranque rápido, y un Agente que lleva cien segundos pensando se ve exactamente igual que un Agente que se ha colgado. Sea cual sea el nivel al que enrutes, cómo señala el Runtime el progreso y el fallo decide si alguien nota la diferencia.
Cuándo no escribir una regla de enrutamiento
Si ejecutas un solo agente sobre un solo repositorio, no hagas nada de esto. Elige el nivel que encaje con tu trabajo y sigue adelante. El enrutamiento cuesta un documento que mantener y una discusión que tener, y solo compensa cuando varios Agentes se ejecutan a la vez y su costo o su patrón de fallo difieren.
El umbral es más o menos este: escribe la regla cuando dos o más personas puedan iniciar una ejecución, o cuando un solo presupuesto cubra varios Agentes en simultáneo. Por debajo de eso, la regla es sobrecarga. Por encima, su ausencia es la razón por la que nadie sabe explicar la factura del mes pasado.
El número que no se mueve
El costo por tarea completada cayó con fuerza en ambos lados de este lanzamiento. Para que te hagas una idea de la escala, OpenAI informa que su investigador mediano gasta más de $600 al día en agentes de programación, con el percentil 90 en $7.000. Los equipos por debajo de esa línea acaban de obtener varias veces más trabajo de agente terminado por el mismo presupuesto, algo que vale la pena medir por Runtime y no por factura.
No obtuvieron ni una hora extra de revisión. El enrutamiento es una palanca de costo y de fiabilidad, y no una palanca de rendimiento, porque la cola de trabajo esperando a que una persona lo acepte no cambia. Lo que sí puede hacer el enrutamiento es volver legible esa cola: qué nivel produjo este diff, cuánto costó, cuántos intentos necesitó y si la Tarea que falló dos veces está en la bandeja de entrada de alguien o no está en ninguna parte. Mantén el objetivo, la ejecución, el costo, los bloqueos y la revisión en la Tarea desde la petición hasta la entrega, y la regla de enrutamiento pasa a ser un ajuste que el equipo edita en lugar de un hábito que seis personas guardan para sí mismas.
Sharkly no ejecuta el modelo ni lo elige por ti. Es la capa compartida de Tarea, Computer, contexto y revisión alrededor de las herramientas que sí lo hacen, que es donde tiene que vivir una regla de enrutamiento si quiere sobrevivir a la persona que la escribió. Si ya ejecutas varios agentes de programación, qué modelo se lleva qué tarea y qué agente se la lleva son la misma decisión vista desde dos lados. Conecta un Computer, crea un Agente por nivel y dale al barato algo aburrido.


