
TL;DR: el equipo de agentes de IA de OpenAI convirtió 5034 objetivos de auditoría en el kernel de Linux en 948 exploits únicos de escalada local de privilegios con un coste de unos 1,2 millones de dólares en créditos de API; posteriormente, investigadores humanos revisaron los resultados. Puedes replicar este mismo esquema en tu propio código: los agentes exploran qué partes son accesibles, las analizan, demuestran de forma aislada cada hallazgo y redactan una solución, que finalmente un humano aprueba.
El 4 de noviembre de 2026, OpenAI publicó «A thousand fewer paths to root». El titular llamativo son los 948 exploits en Linux, pero la verdadera lección para cualquier equipo de software está en el trasfondo: el resultado se logró gracias a agentes especializados que trabajaron por fases, transfiriendo evidencias de uno a otro, con la intervención de una persona al final del proceso.
Este diseño no depende de tener conocimientos profundos del kernel, por lo que puedes aplicar la misma estructura a tus propios servicios. La urgencia es real: OpenAI afirma que su flujo de trabajo fue «netamente rentable» en comparación con las recompensas públicas de los programas de bug bounty. Los atacantes también pueden hacer esos mismos cálculos, así que conviene empezar ya.
Qué descubrió el equipo de agentes de IA de OpenAI
OpenAI ejecutó este pipeline a mediados de octubre de 2026 contra la versión más reciente del kernel de Linux, empleando un próximo modelo enfocado en ciberseguridad. Los objetivos fueron máquinas virtuales aisladas que ejecutaban un sistema operativo de escritorio estándar con las protecciones habituales activadas.
| Fase | Resultado | Coste de API |
|---|---|---|
| Exploración (Scout) | 5034 objetivos de auditoría, aprox. 2,8 M de líneas, cerca del 7 % del kernel | $3426 |
| Análisis (Analyze) | 2308 hallazgos candidatos | $316 549 |
| Validación (Validate) | 1724 reproducidos (aprox. 74,7 %) | $73 330 |
| Evaluación de explotabilidad | 948 exploits únicos de LPE, 291 PoC de fuga de información | $820 123 |
| Total | $1 213 430 |
Estas cifras corresponden a la escala del kernel analizado por OpenAI, no a una estimación para tu repositorio. OpenAI califica sus costes como «más bien un límite superior», ya que midió capacidad y no eficiencia.
Conviene tener en cuenta tres limitaciones:
- Se trata de fallos de escalada local de privilegios (LPE). El atacante necesita haber obtenido acceso local previo; no son exploits remotos por sí mismos.
- Muchos aún no están corregidos. Cuando concluyeron los 10 días de escaneo y análisis, se habían aplicado parches upstream a 61 LPE, 43 contaban con parches en fase de prueba (staging) y 299 se encontraban en discusión pública. OpenAI ha enviado cientos de informes y parches para fallos críticos y está remitiendo el resto de forma gradual junto con sus colaboradores de Patch the Planet.
- La publicación de OpenAI no indica que estos fallos se estén explotando activamente de forma real.
Aun así, la advertencia de OpenAI es contundente: en un sistema operativo que no cuente con los últimos parches, una cuenta con pocos privilegios «debería considerarse funcionalmente equivalente a tener acceso root para un atacante con recursos suficientes». Por tanto, aplica los parches y reduce el radio de impacto mediante aislamiento con herramientas como Firecracker y gVisor.
Las cinco fases de un flujo de trabajo de seguridad con agentes de IA
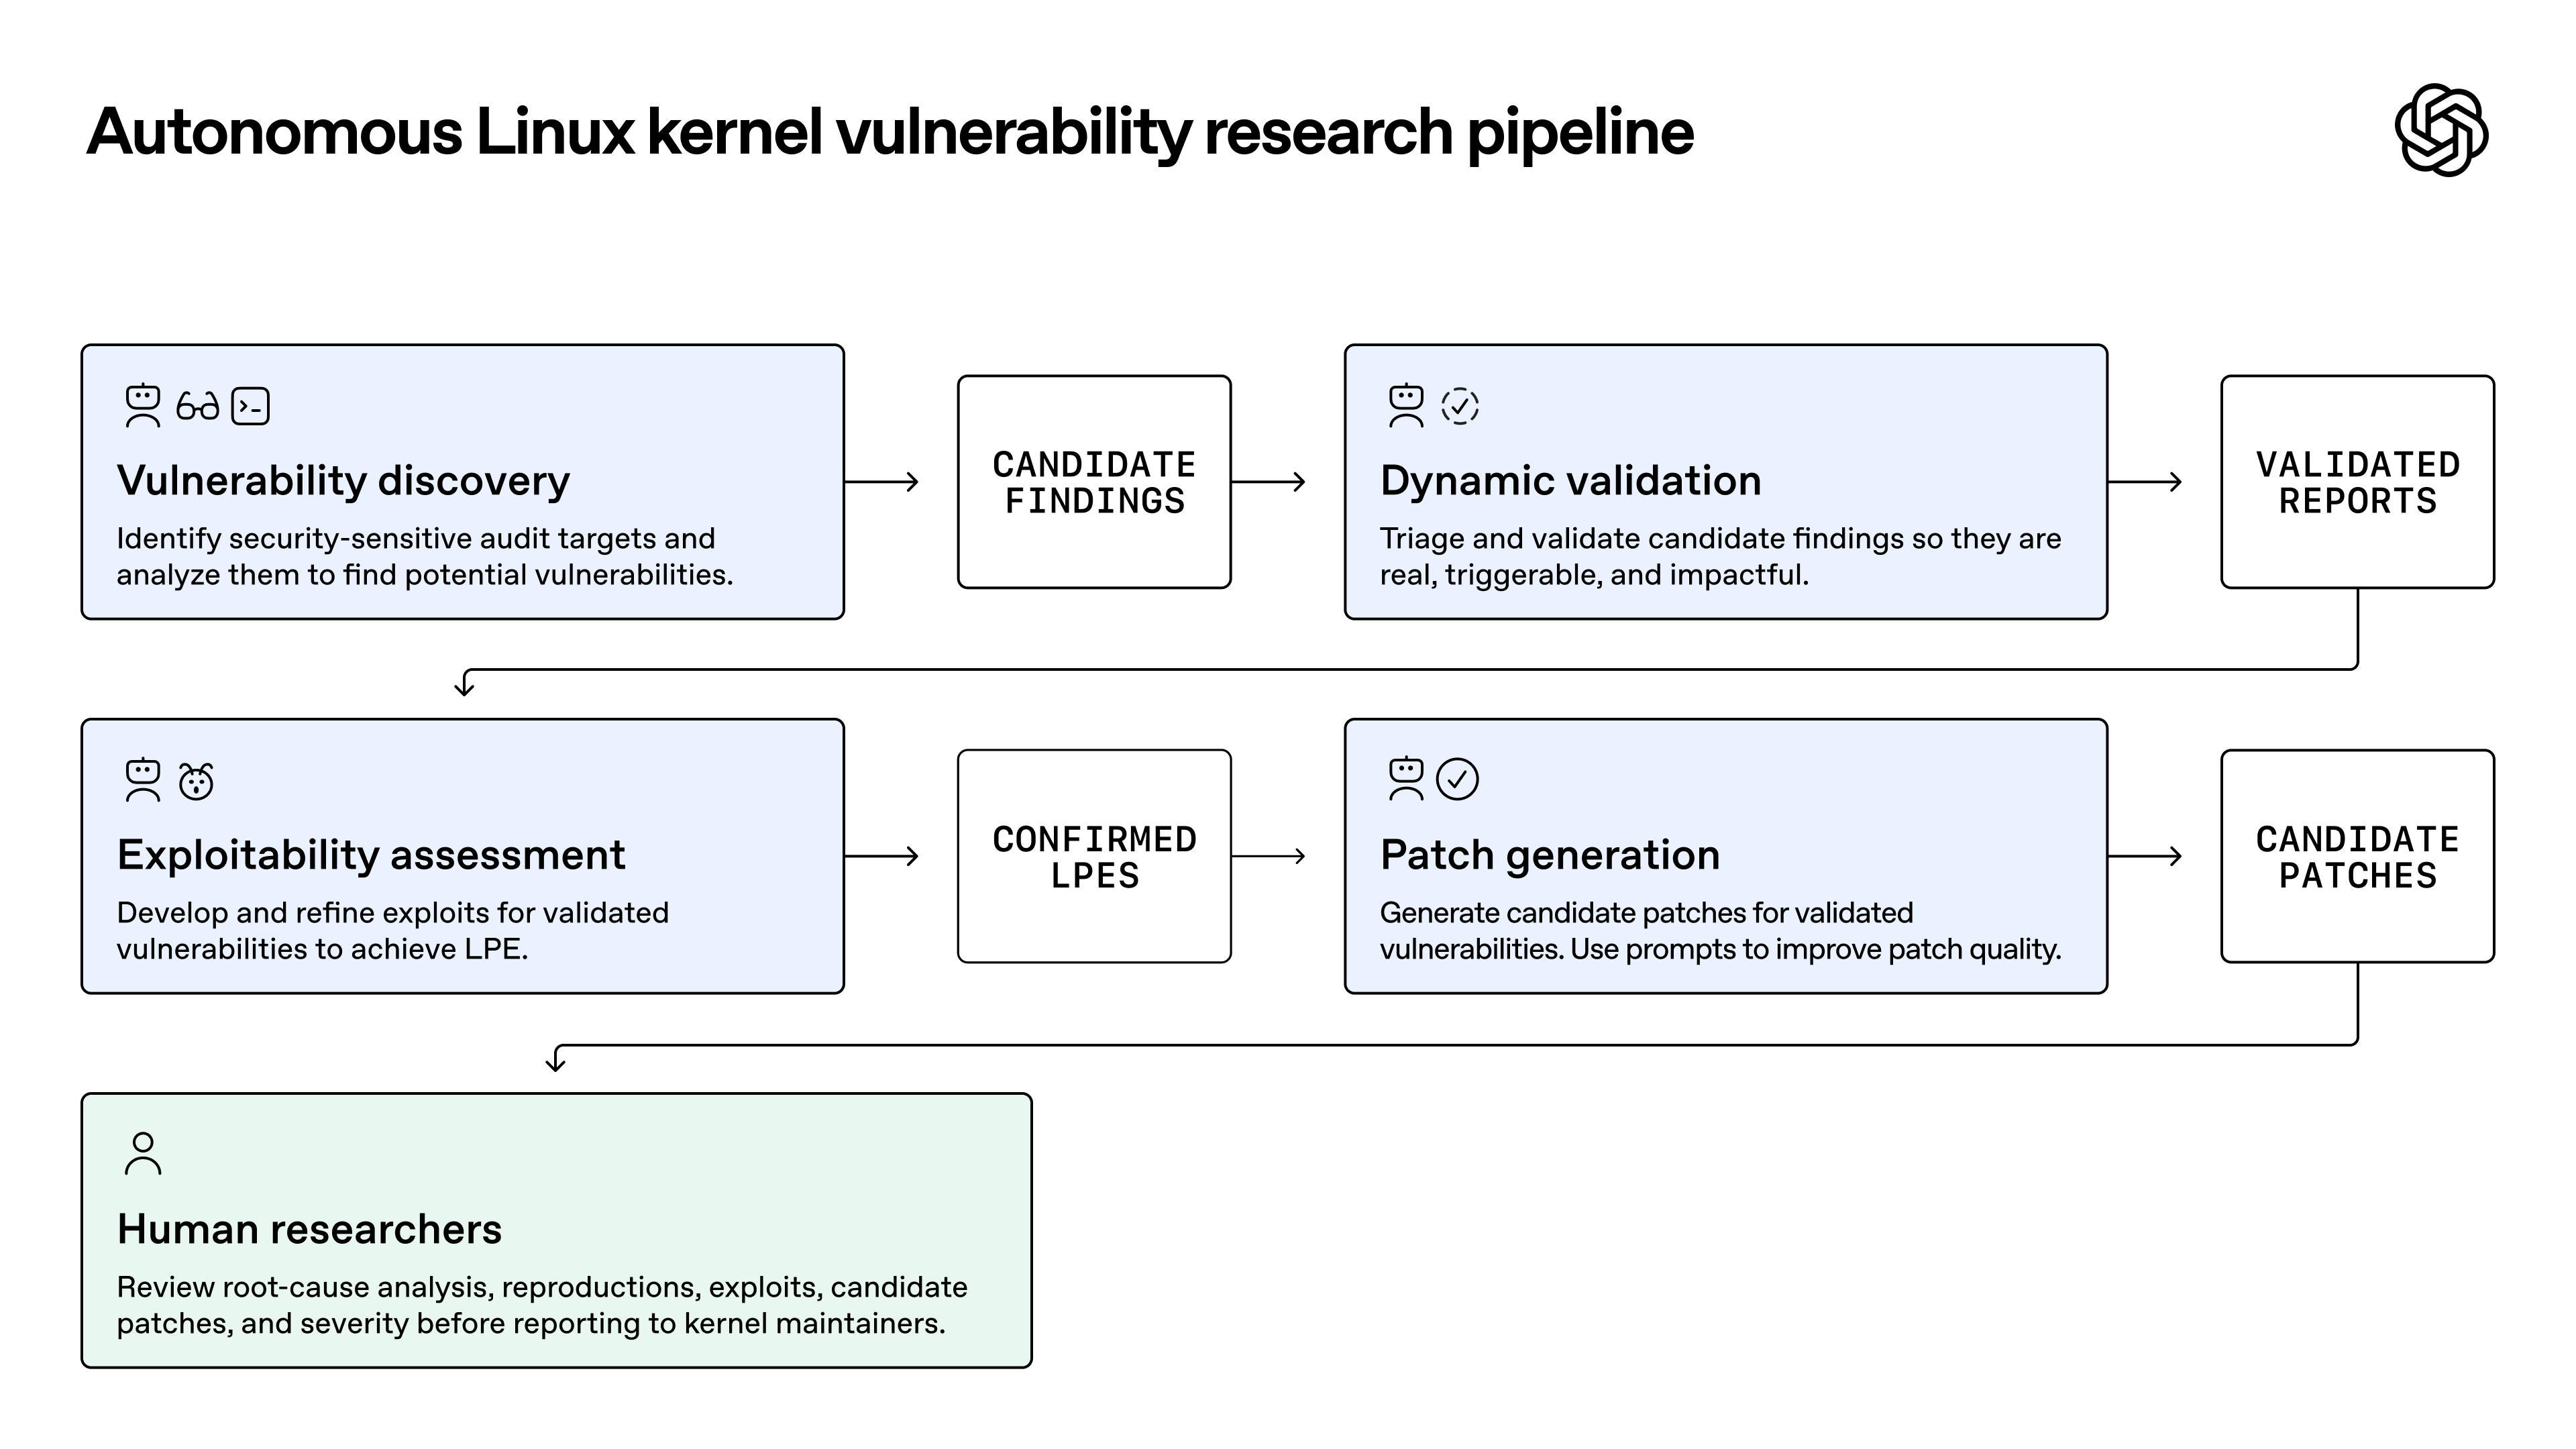
Un flujo de trabajo de seguridad basado en agentes de IA divide la revisión en fases, donde cada una acota el trabajo y genera evidencias para la siguiente. La versión de OpenAI consta de cinco:
- Descubrimiento. Los agentes de exploración (scout) seleccionan objetivos de auditoría según su accesibilidad y relevancia para la seguridad. Los agentes de análisis examinan cada objetivo, elaboran un modelo de amenazas y reportan los hallazgos candidatos.
- Validación dinámica. Los agentes de triaje redactan una prueba de concepto y la ejecutan en una máquina virtual aislada con KASAN, un detector de errores de memoria del kernel, ajustándola hasta reproducir el fallo o agotar las alternativas.
- Evaluación de explotabilidad. Un agente de filtrado descarta los hallazgos que no presentan una vía de explotación plausible. Los agentes de desarrollo de exploits (ExploitDev) ponen a prueba el resto.
- Generación de parches. Los agentes elaboran un borrador de parche para cada vulnerabilidad validada, respetando las convenciones del código circundante y comprobando si existen variantes del problema.
- Revisión humana. Investigadores de seguridad examinan el exploit, el parche y la gravedad antes de remitir nada a los mantenedores del proyecto.
Cada traspaso de información aporta pruebas tangibles y no meras suposiciones, de modo que la persona que interviene al final toma decisiones basadas en hechos.
Cómo trasladar cada fase a tu propio repositorio
Aplica este flujo de trabajo únicamente en código de tu propiedad o en el que cuentes con autorización para realizar pruebas. En tu repositorio, puedes prescindir por completo de la fase de creación de exploits: una prueba automatizada que falle demuestra el defecto sin necesidad de generar una herramienta de ataque.
| Fase de OpenAI | Tu versión | Resultado |
|---|---|---|
| Exploración (Scout) | Identificar puntos de entrada accesibles para usuarios anónimos o con pocos privilegios: rutas, webhooks, subidas de archivos, analizadores sintácticos, consumidores de colas | Lista de auditoría |
| Análisis (Analyst) | Un objetivo por ejecución: leer el código, redactar un breve modelo de amenazas y reportar posibles fallos | Hallazgos candidatos |
| Validación (Validate) | Escribir una prueba mínima que falle en un entorno desechable | Prueba y registros de ejecución |
| Evaluación (Assess) | Clasificar el impacto en función del límite de confianza vulnerado | Nivel de gravedad justificado |
| Parche (Patch) | Redactar la solución en una pull request que incluya la prueba correspondiente | Pull request |
| Revisión humana (Human) | Revisar y, a continuación, fusionar o descartar | Solución integrada o hallazgo cerrado |
Definir bien el alcance sale a cuenta. Los agentes de exploración de OpenAI costaron 3426 dólares y redujeron la auditoría a aproximadamente el 7 % del kernel. Empieza por un único servicio y sus puntos de entrada públicos. La tarea para un solo hallazgo puede ser tan concisa como esta:
Title: Validate finding: path traversal in /api/exports/download

Scope: this repository only. Disposable test environment only.
No production credentials, no external network targets.

Goal: write a minimal failing test that proves or disproves the finding.
Evidence: test file, command output, code path from entry point to flaw.
Give up: stop after two approaches with no new evidence. Report what you tried.
Do not: fix the bug here, build an attack payload, or merge anything.
Verifica el camino recorrido, no solo el resultado
En una ejecución inicial, la fase de explotación de OpenAI notificó 200 casos de éxito. La revisión humana descubrió que 20 de ellos habían obtenido permisos de root mediante un día cero distinto al asignado. El pipeline dio por buena la tarea basándose en el desenlace, pero el desenlace era correcto por los motivos equivocados.
OpenAI ajustó las restricciones de las tareas y añadió una verificación independiente para comprobar que cada exploit aprovechase la vulnerabilidad asignada. La conclusión es clara: hay que verificar tanto la vía empleada para llegar al resultado como el resultado en sí.
En tu caso, la situación resulta familiar: un agente asegura que su prueba demuestra un fallo de autenticación, pero el test falla en realidad por la ausencia de una fixture. Añade un agente verificador que no haya escrito la prueba y plantéale una sola pregunta: ¿este fallo procede realmente de la ruta de código reportada?
Valida cuanto antes: los falsos positivos cuestan lo mismo
OpenAI descubrió que el coste de intentar validar un verdadero positivo y un falso positivo era prácticamente idéntico. En consecuencia, cada candidato erróneo que pasa a la fase de validación consume una ejecución completa innecesariamente.
Filtra antes de demostrar. OpenAI validó aquellos hallazgos a los que un usuario con pocos privilegios pudiera acceder, que no requirieran permisos especiales y que produjeran pruebas medibles. Define filtros equivalentes para tu código, como «accesible sin rol de administrador». Los hallazgos que no superen este filtro se cierran indicando el motivo.
A continuación, vuelve a contrastar los hallazgos con la versión más reciente del código antes de reportarlos, tal como recomienda OpenAI, para evitar duplicidades o informes obsoletos.
Establece una condición de parada antes de iniciar la ejecución
Los intentos fallidos fueron los más caros. En los candidatos a LPE, los 69 fallos costaron una media de 3922 dólares cada uno, mientras que los 1169 éxitos promediaron 360 dólares. Según nuestros cálculos, eso significa que aproximadamente el 6 % de los intentos consumió cerca del 39 % de los 691 000 dólares destinados a esa fase.
La solución propuesta por OpenAI consiste en definir una condición de interrupción, como detenerse tras una hora sin avances. Incorpora esa regla en las instrucciones de la tarea y compleméntala con un límite estricto de tiempo para la ejecución.
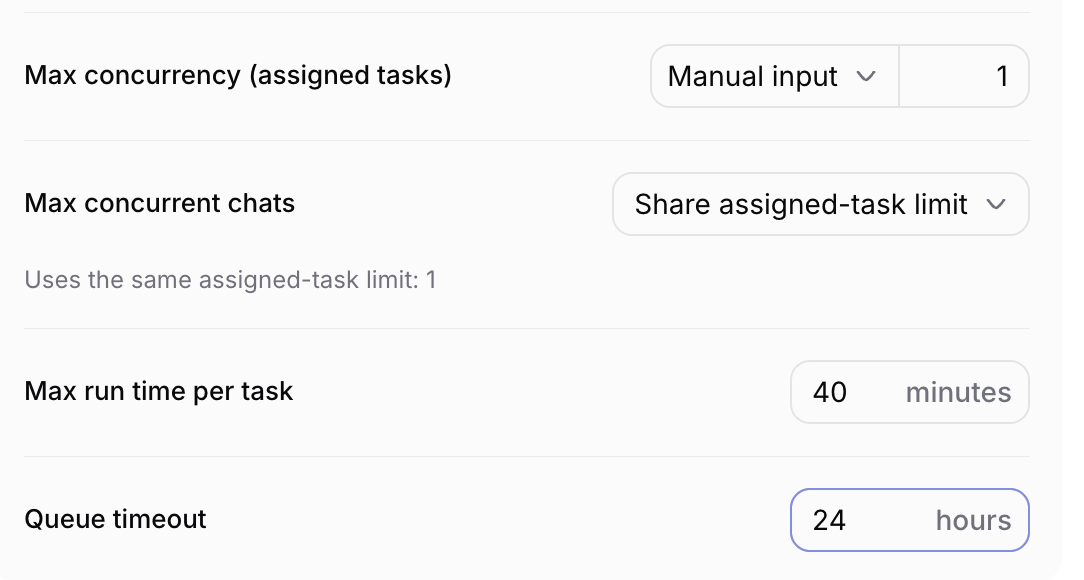
En Sharkly, el tiempo límite por tarea se gestiona en los ajustes de ejecución (Run settings) del agente. Se trata de un tope de tiempo y no de un detector de progreso, por lo que es importante mantener la regla de «detenerse si no hay nuevas evidencias» en las instrucciones.
Mantén una orquestación ligera a medida que mejoren los modelos
OpenAI desarrolló una capa con 103 técnicas de explotación para GPT-5.5 Cyber, lo que elevó su tasa de éxito del 76,2 % al 88,9 %. Sin embargo, esa misma capa apenas aportó 1,5 puntos porcentuales en GPT-5.6 Cyber, por lo que OpenAI decidió prescindir de ella.
Vuelve a evaluar tu propia infraestructura cada vez que cambies de modelo. Reitera también los escaneos: la ejecución de octubre detectó más de 5 veces más LPE inéditos que la de julio con GPT-5.6 Sol, sobre un código que acumulaba tres meses más de mejoras y blindaje.
Mantén la supervisión humana antes del despliegue
Los agentes elaboran las soluciones en forma de pull requests, pero es una persona quien las fusiona. OpenAI observó que los parches de primera pasada podían ser más extensos de lo necesario, omitir variantes o saltarse convenciones de estilo, y que someterlos a más revisiones mejoraba su calidad.
Asimismo, recomienda recurrir a modelos para llevar a cabo revisiones adversarias tanto de parches creados por humanos como por IA. Así pues, haz que un agente intente eludir la corrección y deja que una persona tome la decisión final. Si las revisiones ya suponen un cuello de botella en tu equipo, consulta cómo diseñar la revisión para agentes en paralelo antes de añadir un flujo constante de nuevas pull requests.
Cómo implementar este flujo de trabajo como tareas en Sharkly
En Sharkly, la unidad principal de trabajo es la tarea (Task). A continuación se explica una forma de articular este flujo:
- Crea un tipo de tarea. Un tipo de tarea cuenta con un flujo de trabajo (Workflow) compuesto por estados ordenados. Un tipo denominado «Hallazgo de seguridad» podría estructurarse en: Candidato, Reproducido, Parche redactado, En revisión y Cerrado.
- Crea un Crew. Un Crew es un grupo reutilizable de personas y agentes coordinado por un agente líder. Incorpora agentes de exploración, análisis, verificación y parcheo. El líder se inicia primero y menciona a los miembros para asignarles trabajos específicos.
- Aísla las ejecuciones. Utiliza un directorio temporal para que cada tarea disponga de su propio árbol de trabajo (worktree), y consulta nuestra guía sobre árboles de trabajo aislados si vas a trabajar de forma distribuida en paralelo. Desactiva el directorio compartido del Crew en los casos en que el agente verificador requiera total independencia.
- Automatiza las transiciones. Una automatización activada por el cambio de estado de una tarea puede iniciar el agente de parcheo en cuanto la tarea pase a Reproducido. Estas ejecuciones no son supervisadas y no pueden formular preguntas, y la coincidencia de estados afecta a toda la organización, por lo que conviene que las instrucciones verifiquen la tarea que originó el disparo.
- Vincula las pull requests. Mediante la integración con GitHub, incluir el identificador de la tarea en la rama, el título o la descripción vincula automáticamente la pull request. Como fusionarla no altera el estado de la tarea, corresponde al revisor marcarla como cerrada.
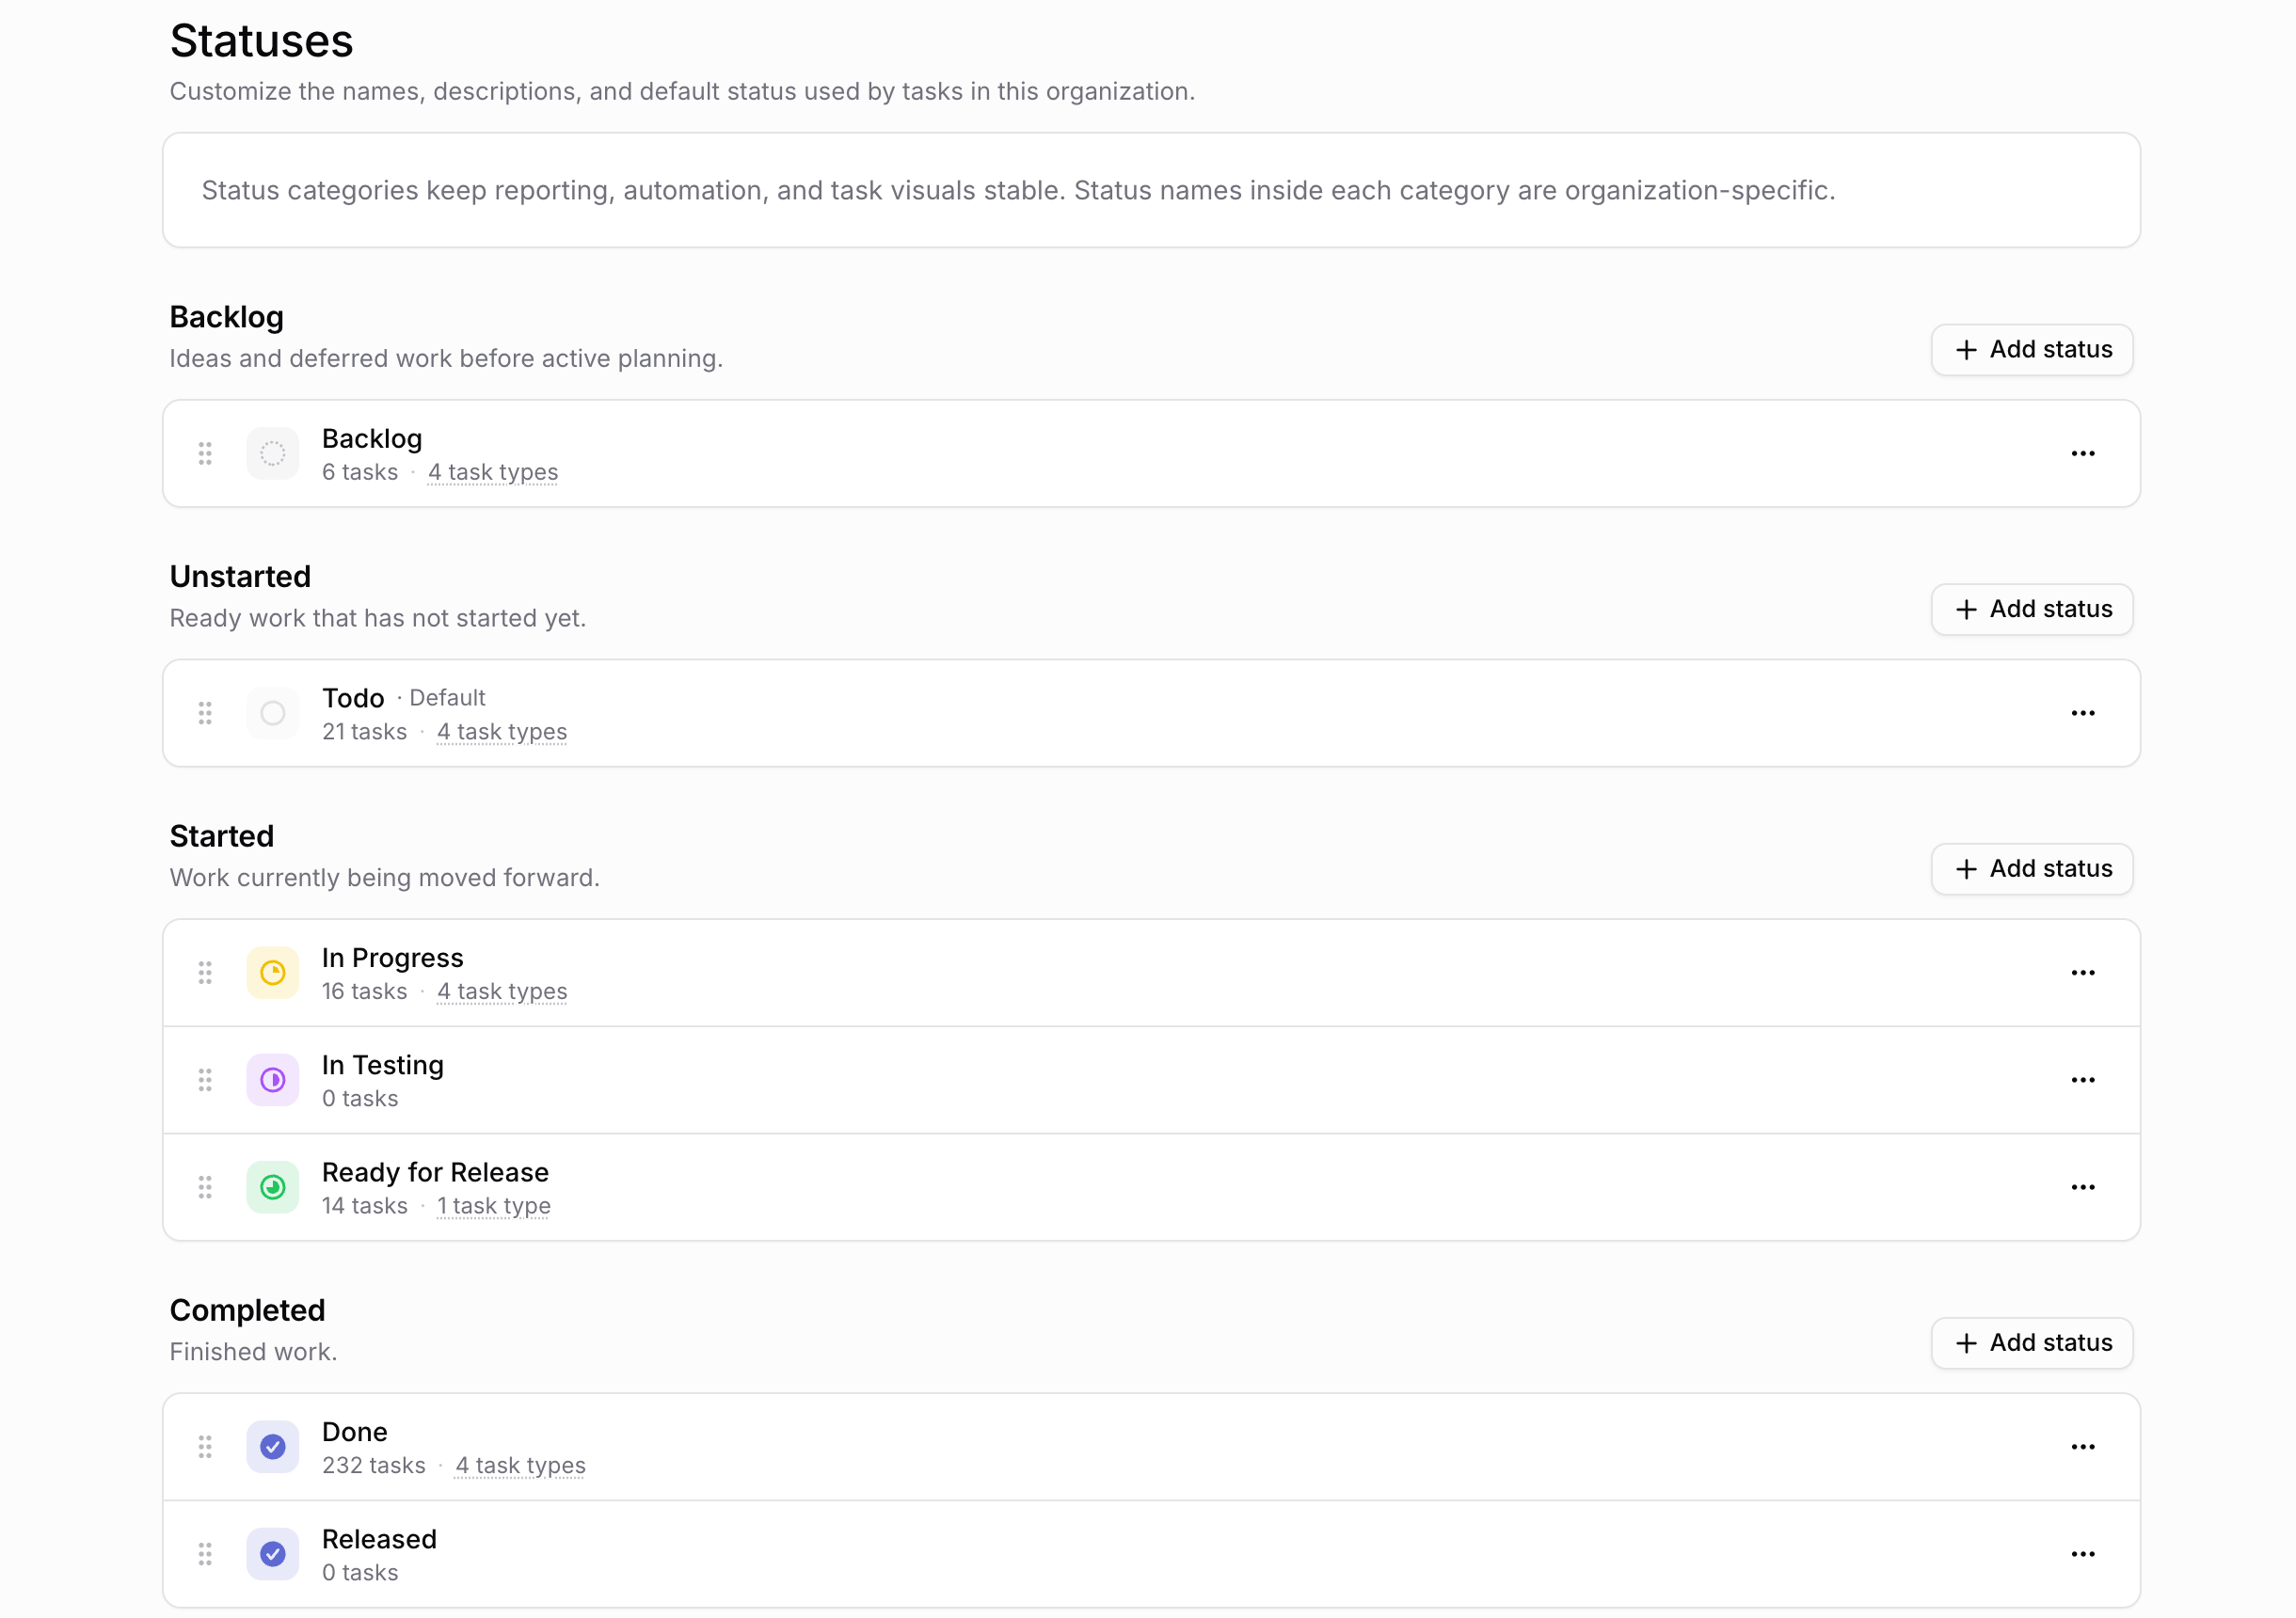
Los estados se comparten en toda la organización, por lo que es preferible crear estados nuevos para este flujo de trabajo en lugar de renombrar los existentes.
Hay un límite crucial que conviene recordar: un árbol de trabajo evita colisiones entre tareas, pero no constituye un entorno de aislamiento de seguridad. Ejecuta las pruebas de reproducción en un contenedor o máquina virtual desechable sin credenciales de producción, y otorga a los agentes los permisos mínimos imprescindibles en Git.
Sharkly se encarga de coordinar estas tareas. Herramientas como Claude Code, Codex y similares asumen la ejecución, y el consumo de modelos se canaliza a través de las suscripciones o claves de API configuradas en dichas herramientas. Si necesitas escalar la operativa, consulta cómo ejecutar 10 agentes de programación con IA simultáneamente.
Para repositorios pequeños, basta con asignar un agente a cada tarea y prescindir del Crew. Utiliza un Crew cuando un líder deba secuenciar varios roles e integrar los resultados en una única tarea.
Conclusión
El resultado obtenido por OpenAI ofrece un modelo a seguir para tu equipo: acota el alcance, exige evidencias en cada entrega, verifica el recorrido, detén a tiempo las ejecuciones infructuosas y mantén siempre a una persona al mando de la aprobación final.
Empieza esta misma semana. Elige un servicio propio, elabora la lista de sus puntos de entrada públicos y registra una tarea de validación por cada posible fallo detectado. La guía de inicio rápido de Sharkly te permitirá poner en marcha tu primer agente en un equipo conectado, y en sharkly.ai descubrirás cómo se articula la capa de tareas y revisión en torno a tus agentes.
Preguntas frecuentes
¿Atacaron los agentes de OpenAI sistemas Linux en producción?
No. Los exploits se ejecutaron en máquinas virtuales aisladas dentro de un entorno de investigación controlado, e investigadores humanos examinaron los resultados antes de emitir cualquier reporte.
¿Están corregidas las 948 vulnerabilidades de Linux?
No. Muchas de ellas aún se están notificando y solucionando. Al concluir el escaneo de 10 días, 61 estaban parcheadas upstream y 43 contaban con parches en fase de prueba (staging).
¿Pueden estos exploits comprometer un servidor de forma remota?
No por sí solos. Son vulnerabilidades de escalada local de privilegios, por lo que el atacante necesita disponer previamente de acceso local. Mantén los sistemas actualizados y aísla las cargas de trabajo que no sean de confianza.
¿Cuánto costaría aplicar este flujo de trabajo en mi repositorio?
Las cifras de OpenAI no son directamente extrapolables, ya que corresponden a una ejecución a escala de todo el kernel. Comienza con un único servicio, fija límites de ejecución y mide el coste por cada hallazgo validado.
¿Necesito el modelo enfocado en ciberseguridad de OpenAI?
Por ahora no es posible utilizarlo, ya que OpenAI lo presenta como un desarrollo próximo. Las distintas fases son independientes del modelo utilizado, de modo que puedes ponerlas en práctica con los agentes de programación que tu equipo ya utilice y evaluar los resultados a partir de las evidencias obtenidas.


