
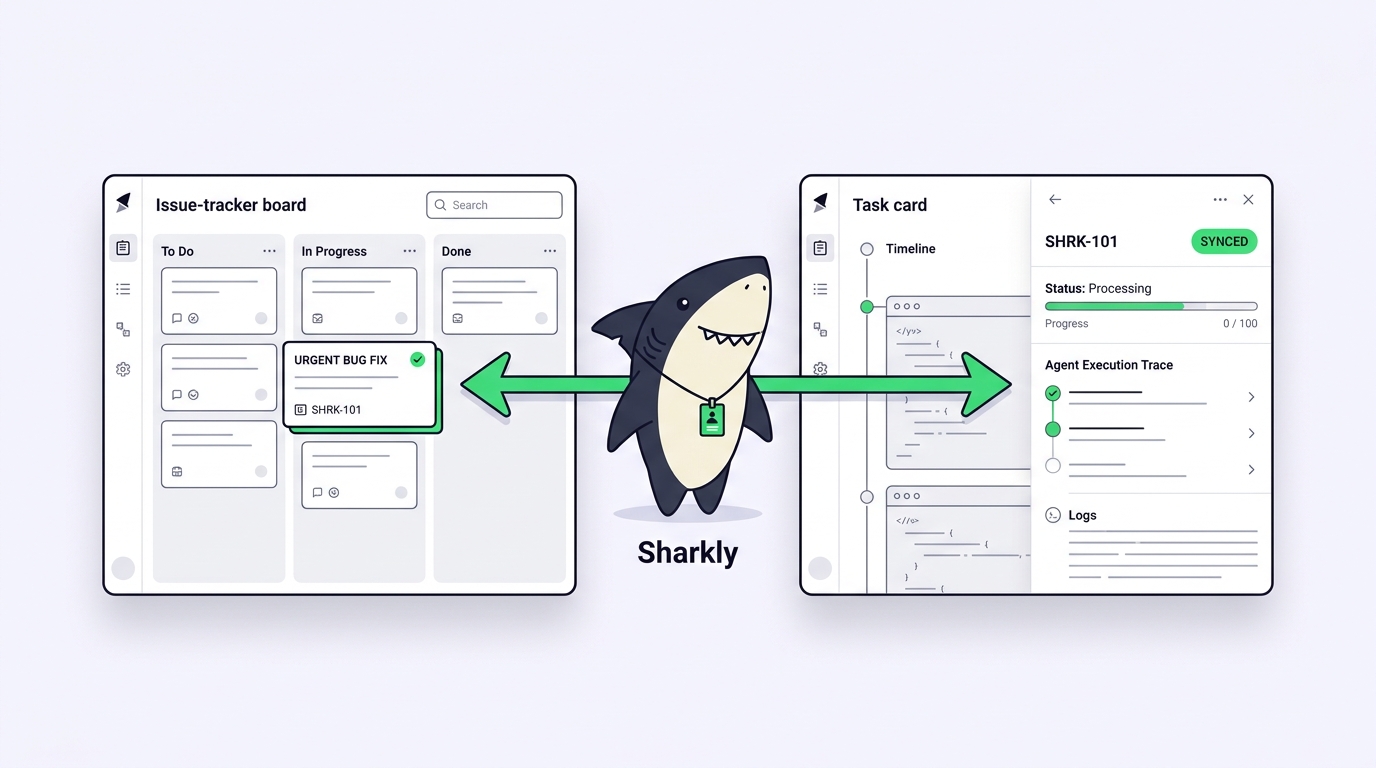
Tu backlog vive en Jira y nadie tiene previsto moverlo de ahí. Las épicas están allí, los informes de sprint llegan a la dirección y otros tres equipos dependen de esos IDs de elementos de trabajo. Así que cuando alguien pregunta si un agente de programación con IA debería encargarse de JIRA-4821, la cuestión no es «¿deberíamos sustituir Jira?». Es algo más concreto y práctico: ¿dónde se ejecuta realmente el agente, quién revisa lo que ha producido y vuelve algo de eso a la incidencia?
Esa es la comparación que de verdad importa. Jira ya tiene agentes, y funcionan. Sharkly también ejecuta agentes, en computadoras que tú conectas, y sincroniza el resultado de vuelta con Jira. Esta guía traza la frontera entre ambos con honestidad, incluidos los casos en los que añadir Sharkly sería excesivo.
TL;DR
Jira es un sistema de registro al que se le ha añadido la ejecución de agentes. Sharkly es una capa de ejecución que se conecta a tu sistema de registro. Rovo Dev de Atlassian se encarga de la planificación, la programación y la revisión dentro de los entornos de Atlassian, y puedes asignar elementos de trabajo a agentes desde el menú desplegable de asignado. Sharkly ejecuta cualquier Runtime que tu equipo ya pague en los Computers que conectes, conserva la traza de ejecución en una Tarea compartida y se sincroniza de forma bidireccional con Jira Cloud, Server o Data Center. Si el trabajo de tus agentes encaja dentro de los entornos compatibles de Atlassian, con Jira te basta. Si tus agentes necesitan ejecutarse en tus propias máquinas, con tus propios runtimes y tu propio control de revisión, Sharkly añade esa capa sin desalojar a Jira.
Lo que Jira hace bien, sin rodeos
Concedamos a Jira su mejor versión, porque la versión honesta ya es sólida.
Jira es el lugar donde una empresa acuerda qué trabajo existe. Ese acuerdo tiene un valor real: IDs compartidos, modelos de permisos, historial de auditoría, informes que finanzas y la dirección ya leen. Cualquier herramienta que pida a un equipo abandonarlo está pidiendo algo caro.
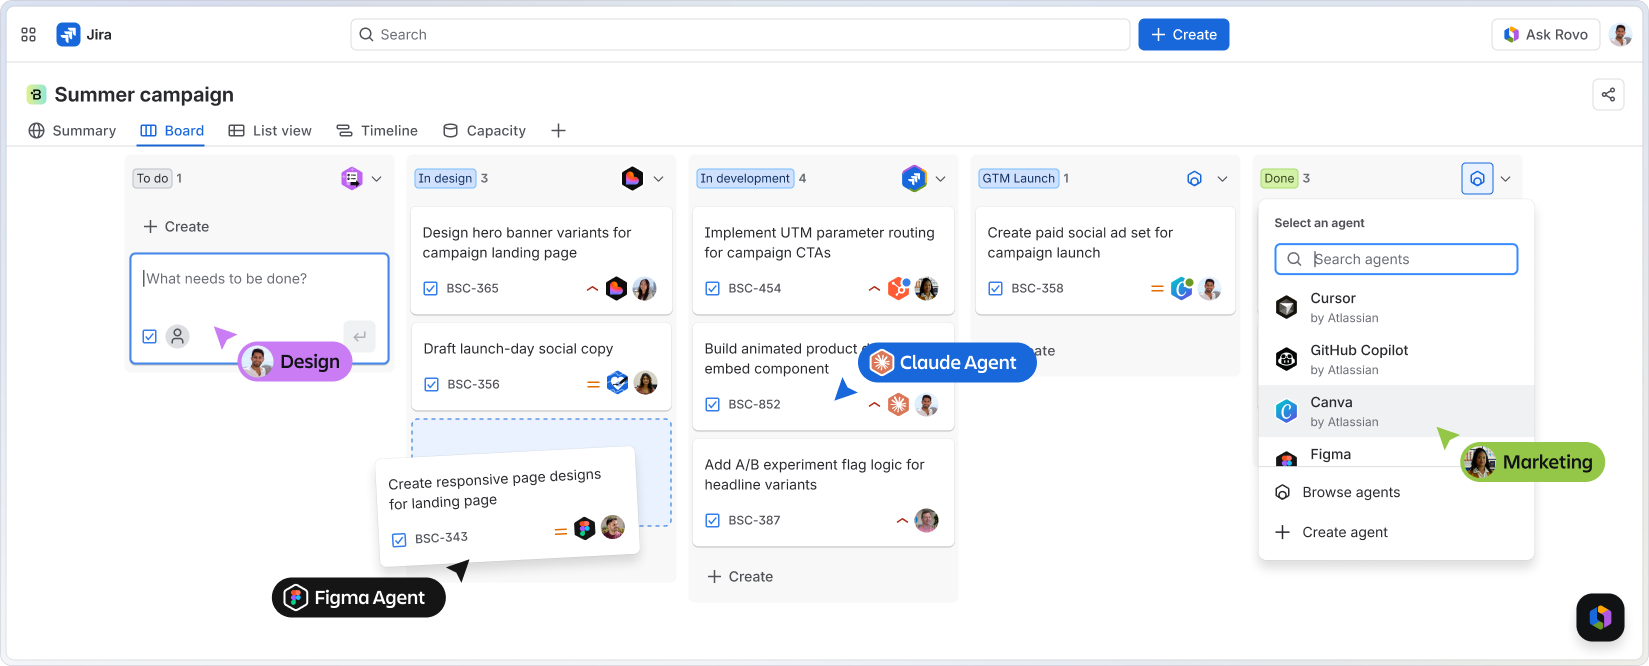
Atlassian tampoco se quedó de brazos cruzados con los agentes. Atlassian describe Rovo Dev como «un agente de IA consciente del contexto que acelera el ciclo de vida del desarrollo de software encargándose de la planificación, la programación y las revisiones, y automatizando el trabajo repetitivo a escala». Valida los cambios de código contra los criterios de aceptación de Jira y funciona en la CLI de terminal, Bitbucket Cloud, GitHub y VS Code. Atlassian afirma que Rovo Dev Standard está disponible de forma general para todos los clientes nuevos y existentes, con créditos mensuales que se están desplegando en los planes Standard, Premium y Enterprise Cloud.
El modelo de asignación es realmente bueno. Abres el menú desplegable de asignado en un elemento de trabajo y eliges un agente igual que elegirías a un compañero, y esa lista incluye agentes de terceros como el agente de programación de GitHub Copilot. El propio equipo de ingeniería de Atlassian publicó un relato sobre cómo entregaron 120 PR en dos semanas usando Rovo Dev en Jira. No es una cifra de demo. Es un equipo informando de su rendimiento en trabajo real.
Así que el punto de partida no es «Jira se ha quedado atrás», sino «Jira tiene una respuesta y conviene saber exactamente qué cubre esa respuesta».
Dónde termina la respuesta de Jira
La frontera tiene que ver con dónde ocurre la ejecución y a qué herramientas puede llegar.
La ejecución de agentes nativa de Jira vive dentro de los entornos que Atlassian admite. Es un diseño deliberado y, para muchos equipos, es el correcto. También significa que la pregunta sobre el runtime ya viene respondida. Si tus desarrolladores se han estandarizado en Claude Code con una configuración concreta de Skills, en Codex a través de una suscripción a ChatGPT, en Gemini CLI, en OpenCode o en algo que habéis construido contra un protocolo propio, la ruta nativa de Jira no los ejecuta como lo hacen tus desarrolladores en local.
Hay una segunda frontera que importa más de lo que admiten la mayoría de las comparativas: la máquina. El trabajo de un agente no es solo una llamada a un modelo. Necesita un checkout, un gestor de paquetes, variables de entorno, una base de datos local, la ruta VPN hacia tu API de staging y las veinte pequeñas cosas que hacen que tu repositorio compile en tu portátil pero no en un contenedor genérico. Los equipos se topan con esto en la segunda semana, no en la primera.
Y hay una cuestión de revisión. Cuando un agente produce un cambio, el artefacto útil no es solo el pull request. Es la traza: qué se le indicó al agente, qué leyó, qué intentó, dónde se atascó y qué decidió una persona al respecto. Ese registro necesita un lugar donde la siguiente persona pueda consultarlo.
Las dos decisiones
La propia documentación de Sharkly es directa sobre el reparto de tareas, y aquí aplicamos la misma franqueza.
Usa solo Jira cuando el trabajo de tus agentes encaje dentro de los entornos compatibles de Atlassian, tus repositorios estén en Bitbucket o GitHub y los agentes que quieras sean los que Jira ya puede asignar. Tienes un sistema de registro y una ruta de ejecución en un único producto, con una sola factura. Añadir otra capa solo te aporta una complejidad que no necesitas. Es una recomendación de verdad, no una salida por la tangente.
Añade Sharkly cuando la ejecución tenga que ocurrir en hardware y runtimes que tú controles. Un Computer de Sharkly proporciona el host de ejecución para el trabajo de los Agentes, y puede ser una computadora local, un servidor remoto, un contenedor o un host en la nube compatible. Un pequeño servicio local conecta ese Computer con Sharkly, detecta los Runtimes disponibles, recibe trabajo, prepara el directorio de la tarea, inicia el Runtime seleccionado y transmite el progreso de vuelta. Esa es la pieza que Jira no intenta ser.
Una definición, porque el resto depende de ella. Una Tarea es la unidad principal de trabajo en Sharkly. Contiene el objetivo y la descripción, la persona responsable, el Agente o Crew asignado para ejecutarla, los comentarios, el estado de ejecución, la traza y el resultado. Mientras que una incidencia de Jira registra que el trabajo existe, una Tarea de Sharkly registra cómo se hizo el trabajo, qué agente lo hizo y en qué máquina.
No tienes que elegir: la ruta de sincronización
Esta es la parte en la que más se equivocan la mayoría de los planteamientos «Sharkly vs Jira». No son mutuamente excluyentes, y la integración está documentada, no es una promesa.
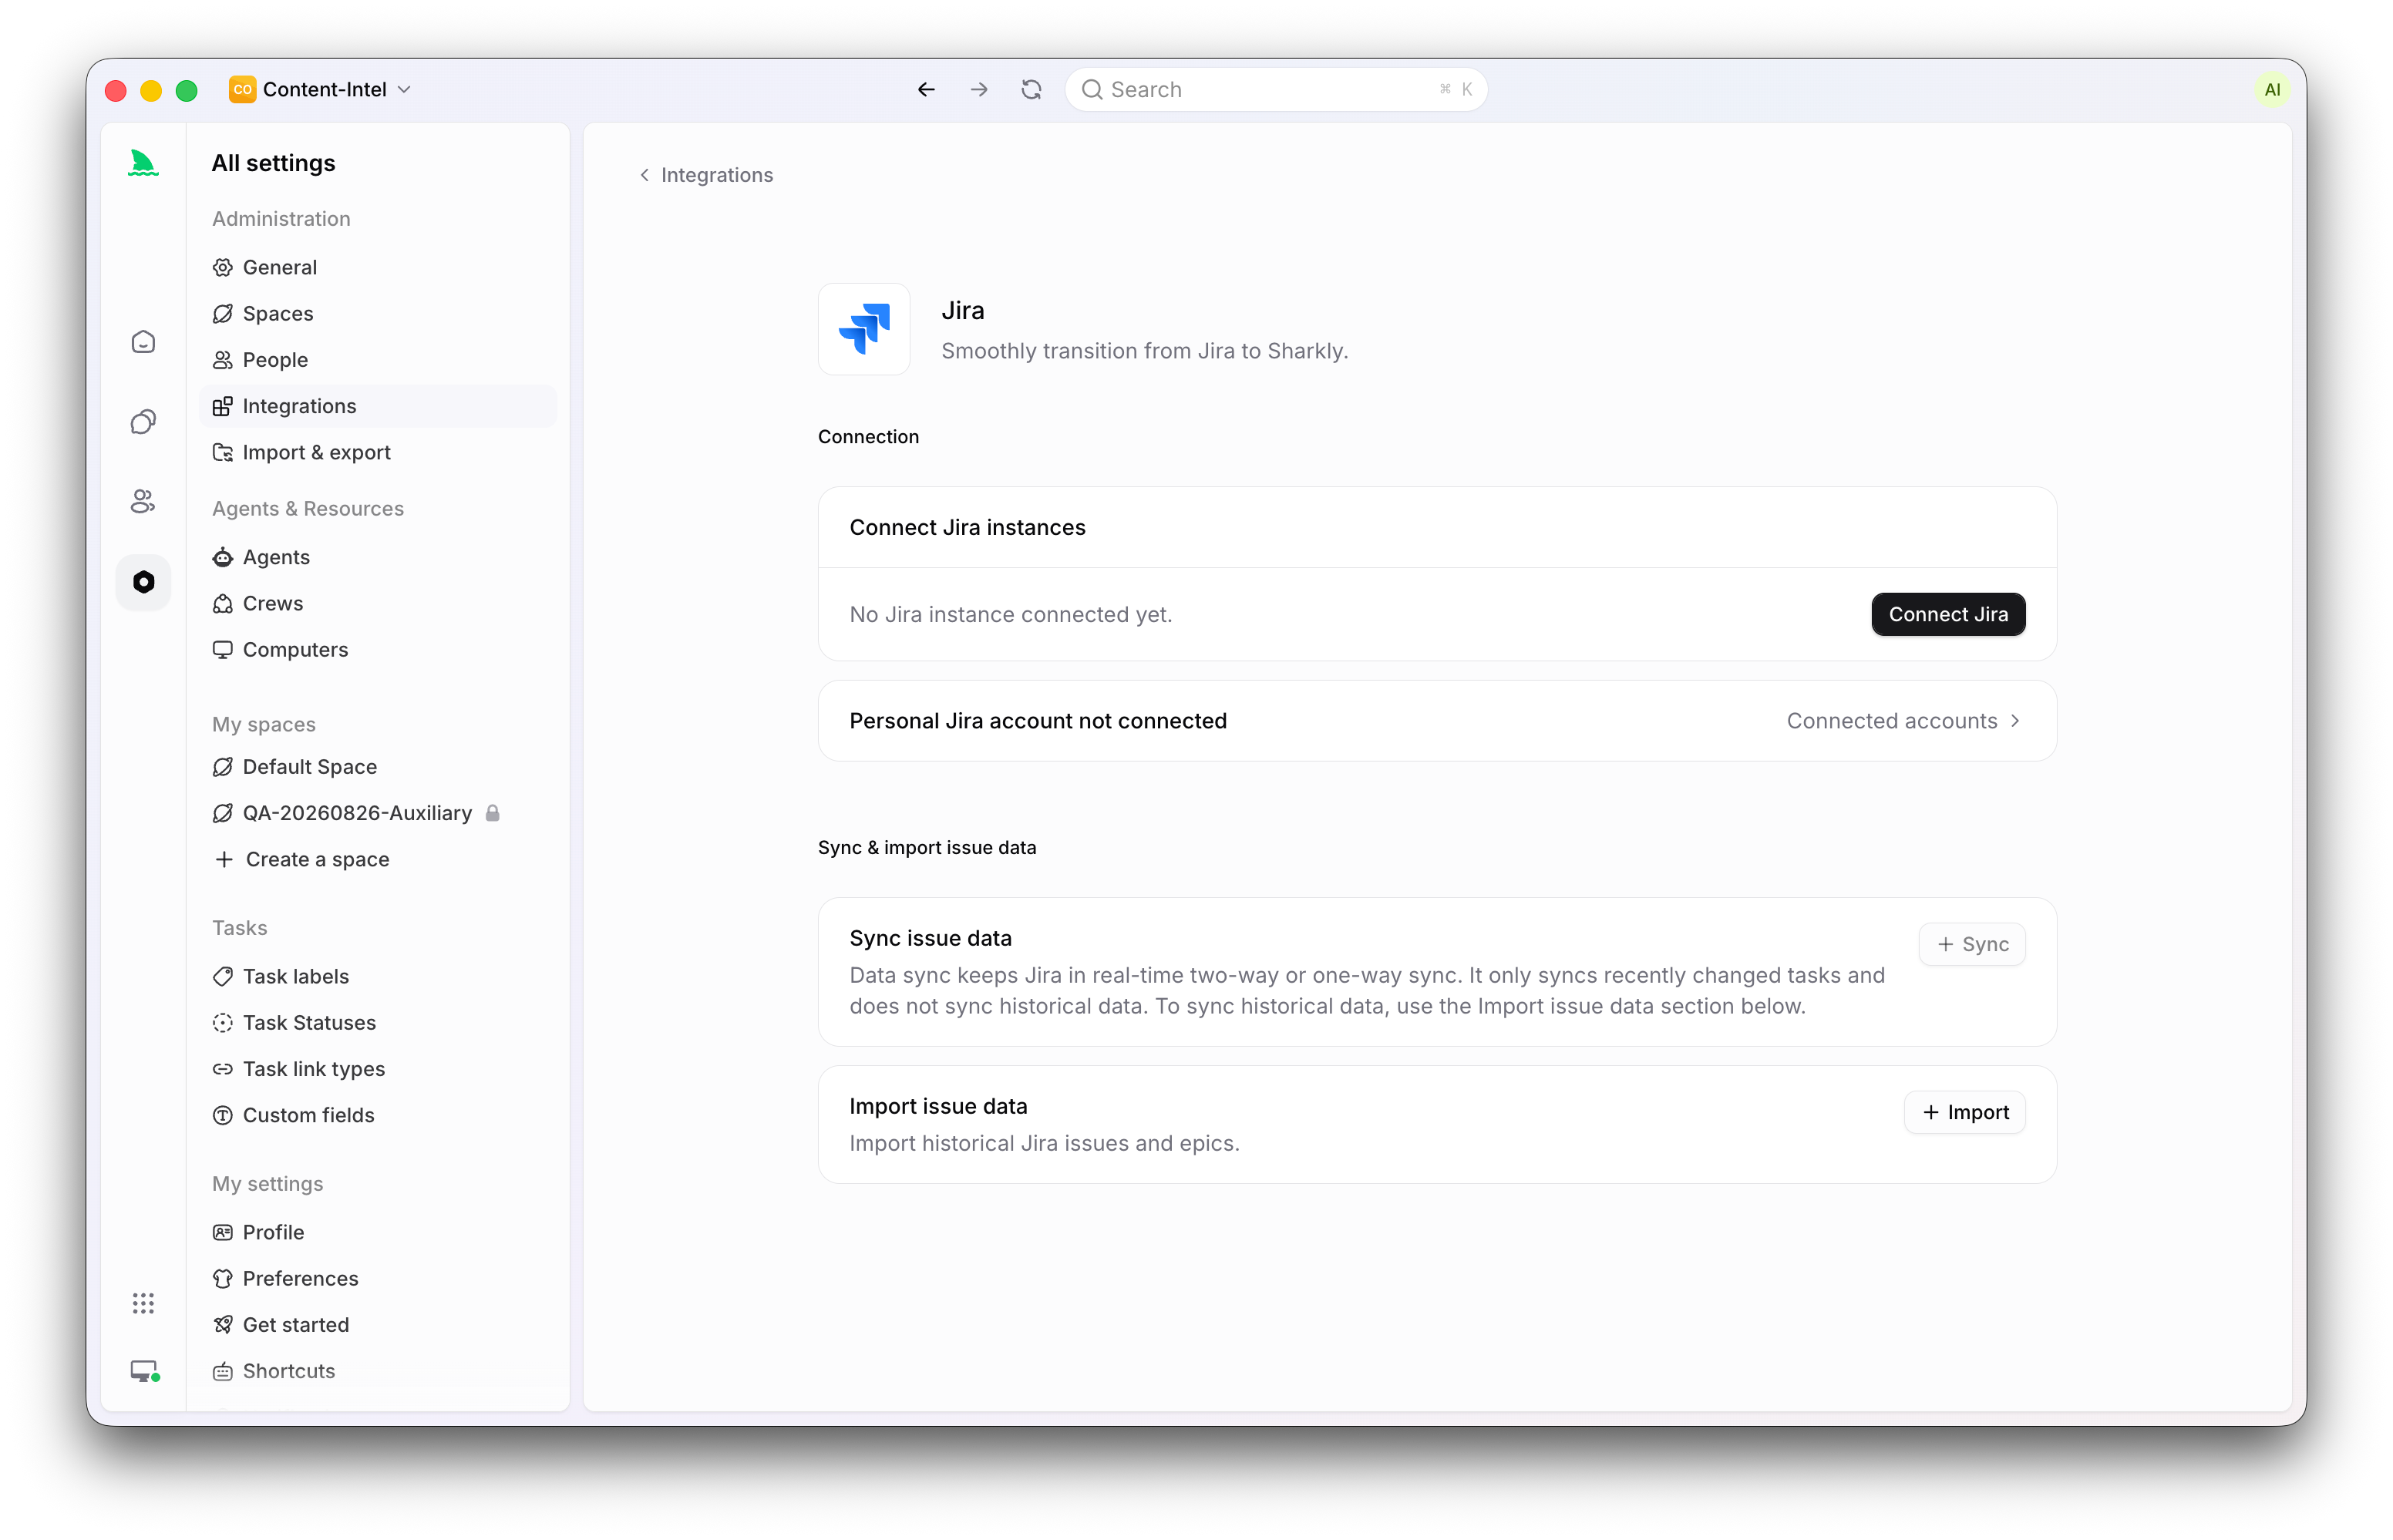
La integración de Sharkly con Jira es compatible con Jira Cloud y con Jira Server o Data Center, y ofrece tres modos:
- Importar copia los datos existentes de Jira en Sharkly. Úsalo para trabajo histórico o una migración controlada.
- Sincronizar vincula un proyecto de Jira con un Espacio de Sharkly y mantiene conectados los cambios recientes. La sincronización no importa datos históricos por sí sola.
- Importar y luego sincronizar traslada el historial seleccionado y puede activar la sincronización continua con las credenciales que ya hayas introducido en el asistente.
Un enlace de sincronización empareja un proyecto de Jira con un Espacio de Sharkly. Un proyecto de Jira solo puede tener un enlace activo, aunque varios proyectos de Jira pueden enlazar con el mismo Espacio. En el modo bidireccional, las incidencias y épicas de Jira se sincronizan con las Tareas y Proyectos de Sharkly en ambos sentidos, y las nuevas Tareas y Proyectos del Espacio vinculado pueden crear incidencias y épicas en Jira. Si prefieres que Jira siga siendo la fuente autorizada, el modo Jira a Sharkly crea y actualiza los registros vinculados de Sharkly sin enviar nuevos registros de vuelta.
Dos notas operativas que conviene conocer antes de empezar. La instalación automática del webhook requiere permisos de administración de Jira, y la falta de permisos para webhooks no bloquea la conexión, pero impedirá que lleguen los cambios de Jira. Eliminar un enlace detiene la sincronización futura sin borrar nada en ninguno de los dos lados, lo que hace que esto sea reversible si decides no seguir adelante.
Para el flujo de trabajo a nivel de incidencia, nuestro tutorial sobre cómo asignar una incidencia de Jira a un agente de IA cubre el ciclo completo de principio a fin.
Un ejemplo práctico
Un equipo de pagos usa Jira como estándar de la empresa. Soporte abre JIRA-4821: una tormenta de reintentos de webhook está cobrando dos veces a un número reducido de clientes.
El líder técnico lo triajea en Jira, fija la prioridad y lo vincula con la épica del incidente. Como el Espacio vinculado se sincroniza de forma bidireccional, el mismo trabajo aparece en Sharkly como una Tarea con la descripción y los criterios de aceptación intactos.
Ahí el enrutamiento se vuelve concreto. La Tarea va a un Agente configurado para arreglos de backend: un rol definido, el repositorio de pagos y Claude Code como Runtime, ejecutándose en un Computer conectado que ya tiene las credenciales de staging y la ruta VPN. Un segundo Agente se encarga de la cobertura de pruebas en un worktree aislado, de modo que los dos nunca toquen los mismos archivos. Nuestra guía sobre cómo ejecutar agentes en paralelo en worktrees aislados explica por qué ese aislamiento importa cuando hay más de un agente trabajando.
El agente lee la incidencia, reproduce la tormenta de reintentos contra una réplica local, propone un cambio en la clave de idempotencia, ejecuta la batería de pruebas y reporta. Todo lo que leyó, intentó y en lo que falló queda en la Tarea, en la traza, junto a los comentarios. El líder revisa el diff, plantea una pregunta de seguimiento en un comentario de la Tarea, lo que inicia otra ejecución, y luego acepta.
El resultado vuelve a JIRA-4821 para quienes nunca salieron de Jira: la incidencia se cierra, el informe de sprint es exacto y soporte ve la resolución en la herramienta que ya usa. Nadie tuvo que moverse de su sitio.
Sharkly vs Jira: una comparación justa
| Jira (con Rovo Dev y agentes asignables) | Sharkly | |
|---|---|---|
| Función principal | Sistema de registro para el trabajo de toda la organización | Capa de ejecución y revisión para Personas y Agentes |
| Asignación de agentes | Menú desplegable de asignado, agentes Rovo y agentes de terceros compatibles | Tarea asignada a un Agente o a un Crew |
| Dónde se ejecutan los agentes | Entornos compatibles con Atlassian, incluidos CLI, Bitbucket Cloud, GitHub y VS Code | Computers que tú conectas: máquina local, servidor remoto, contenedor o host en la nube compatible |
| Elección de Runtime | Los agentes que admite Jira | El Runtime detectado en ese Computer, incluido un Runtime ACP personalizado que configures |
| Facturación del modelo | A través de tu plan y tus créditos de Atlassian | A través de las suscripciones o claves de API que ya tengas configuradas en tus herramientas |
| Registro de ejecución | Historial del elemento de trabajo y PR vinculados | Tarea con estado de ejecución, traza, resultado y comentarios |
| Hosts multiplataforma | Gestionados por Atlassian | Instaladores para macOS, Linux y Windows de la CLI y el servicio local |
| Relación | El registro sobre el que todos informan | Se sincroniza de forma bidireccional con Jira en lugar de sustituirlo |
Errores comunes
Tratar esto como una migración. El error más común es plantear la ejecución de agentes como un motivo para abandonar Jira. Finanzas, soporte y otros tres equipos leen esos informes. Sincroniza, no desalojes.
Saltarse la conversación sobre el webhook. El enlace con Jira necesita permisos de administrador para instalar su webhook automáticamente. Si no los tienes, haz llegar cuanto antes al administrador de Jira el paquete de configuración única, en lugar de tener que depurar un silencio más adelante.
Apuntar varios proyectos de Jira a un mismo Espacio por accidente. Un proyecto de Jira solo puede tener un enlace de Espacio activo, y el emparejamiento no se puede cambiar una vez creado. Decide la correspondencia antes de crear enlaces, porque corregirlo implica eliminarlos y volver a crearlos.
Asignar trabajo que no está listo para un agente. Una incidencia que dice «arreglar el bug de pagos» produce una mala ejecución sea cual sea la plataforma. Los criterios de aceptación son lo que marca la diferencia, la misma disciplina que las buenas incidencias siempre han necesitado. Nuestro repaso sobre la gestión de proyectos con agentes de IA cubre qué cambia cuando el asignado no es una persona.
Conclusión
Jira responde a «qué trabajo existe y de quién es». Con Rovo Dev y los agentes asignables, ahora también responde en parte a «quién hace el trabajo», dentro de los entornos que admite Atlassian. Si eso cubre tu stack, ya has terminado, y deberías dejar de leer comparativas.
Sharkly responde a una pregunta distinta: dónde ocurre la ejecución de los agentes cuando necesita tus máquinas, tus runtimes y tu control de revisión, y cómo ese registro se mantiene legible para el equipo. No sustituye a Claude Code ni a Codex, y tampoco sustituye a Jira. Añade la tarea compartida, el Computer conectado, el contexto, el control y la capa de revisión alrededor de las herramientas que tu equipo ya usa, y después sincroniza el resultado de vuelta con la incidencia que lee todo el mundo.
Si esa es la brecha que estás notando, empieza por Sharkly y conecta un proyecto de Jira con un Espacio antes de tocar nada más.
Preguntas frecuentes
¿Sharkly sustituye a Jira? No. Se conecta a Jira mediante importación, sincronización unidireccional o sincronización bidireccional. Eliminar un enlace detiene la sincronización futura sin borrar incidencias de Jira, épicas de Jira, Tareas de Sharkly ni Proyectos de Sharkly.
¿Puedo mantener Jira como fuente de la verdad? Sí. La dirección Jira a Sharkly crea o actualiza los registros vinculados de Sharkly sin crear nuevos registros de Jira desde Sharkly. Las actualizaciones compatibles de registros ya vinculados sí se pueden escribir de vuelta.
¿Funciona esto con Jira autoalojado? Tanto Jira Cloud como Jira Server o Data Center son compatibles. Las instalaciones de Server y Data Center además ofrecen una opción de proxy de red privada que Jira Cloud no muestra.
¿Y los costes del modelo? El uso del modelo sigue pasando por las suscripciones o claves de API configuradas en tus herramientas de programación. La cuota del modelo depende de las herramientas de programación con IA, los planes y las cuentas de API que conecte tu equipo.
¿Qué agentes puede asignar Jira de forma nativa? Agentes Rovo y agentes de terceros compatibles, como el agente de programación de GitHub Copilot, seleccionados desde el menú desplegable de asignado del elemento de trabajo. Consulta la documentación actual de Atlassian, porque la lista de compatibles cambia.
¿Necesito ambas herramientas para empezar? No. Puedes usar Sharkly con sus propios Espacios primero y conectar Jira más adelante. Los equipos que ya viven en Jira suelen encontrar la sincronización más fácil de justificar cuando un equipo ya tiene un ciclo de agentes en funcionamiento. Nuestra comparativa de alternativas a Jira para equipos de personas y agentes cubre el caso en el que Jira aún no está arraigado.


