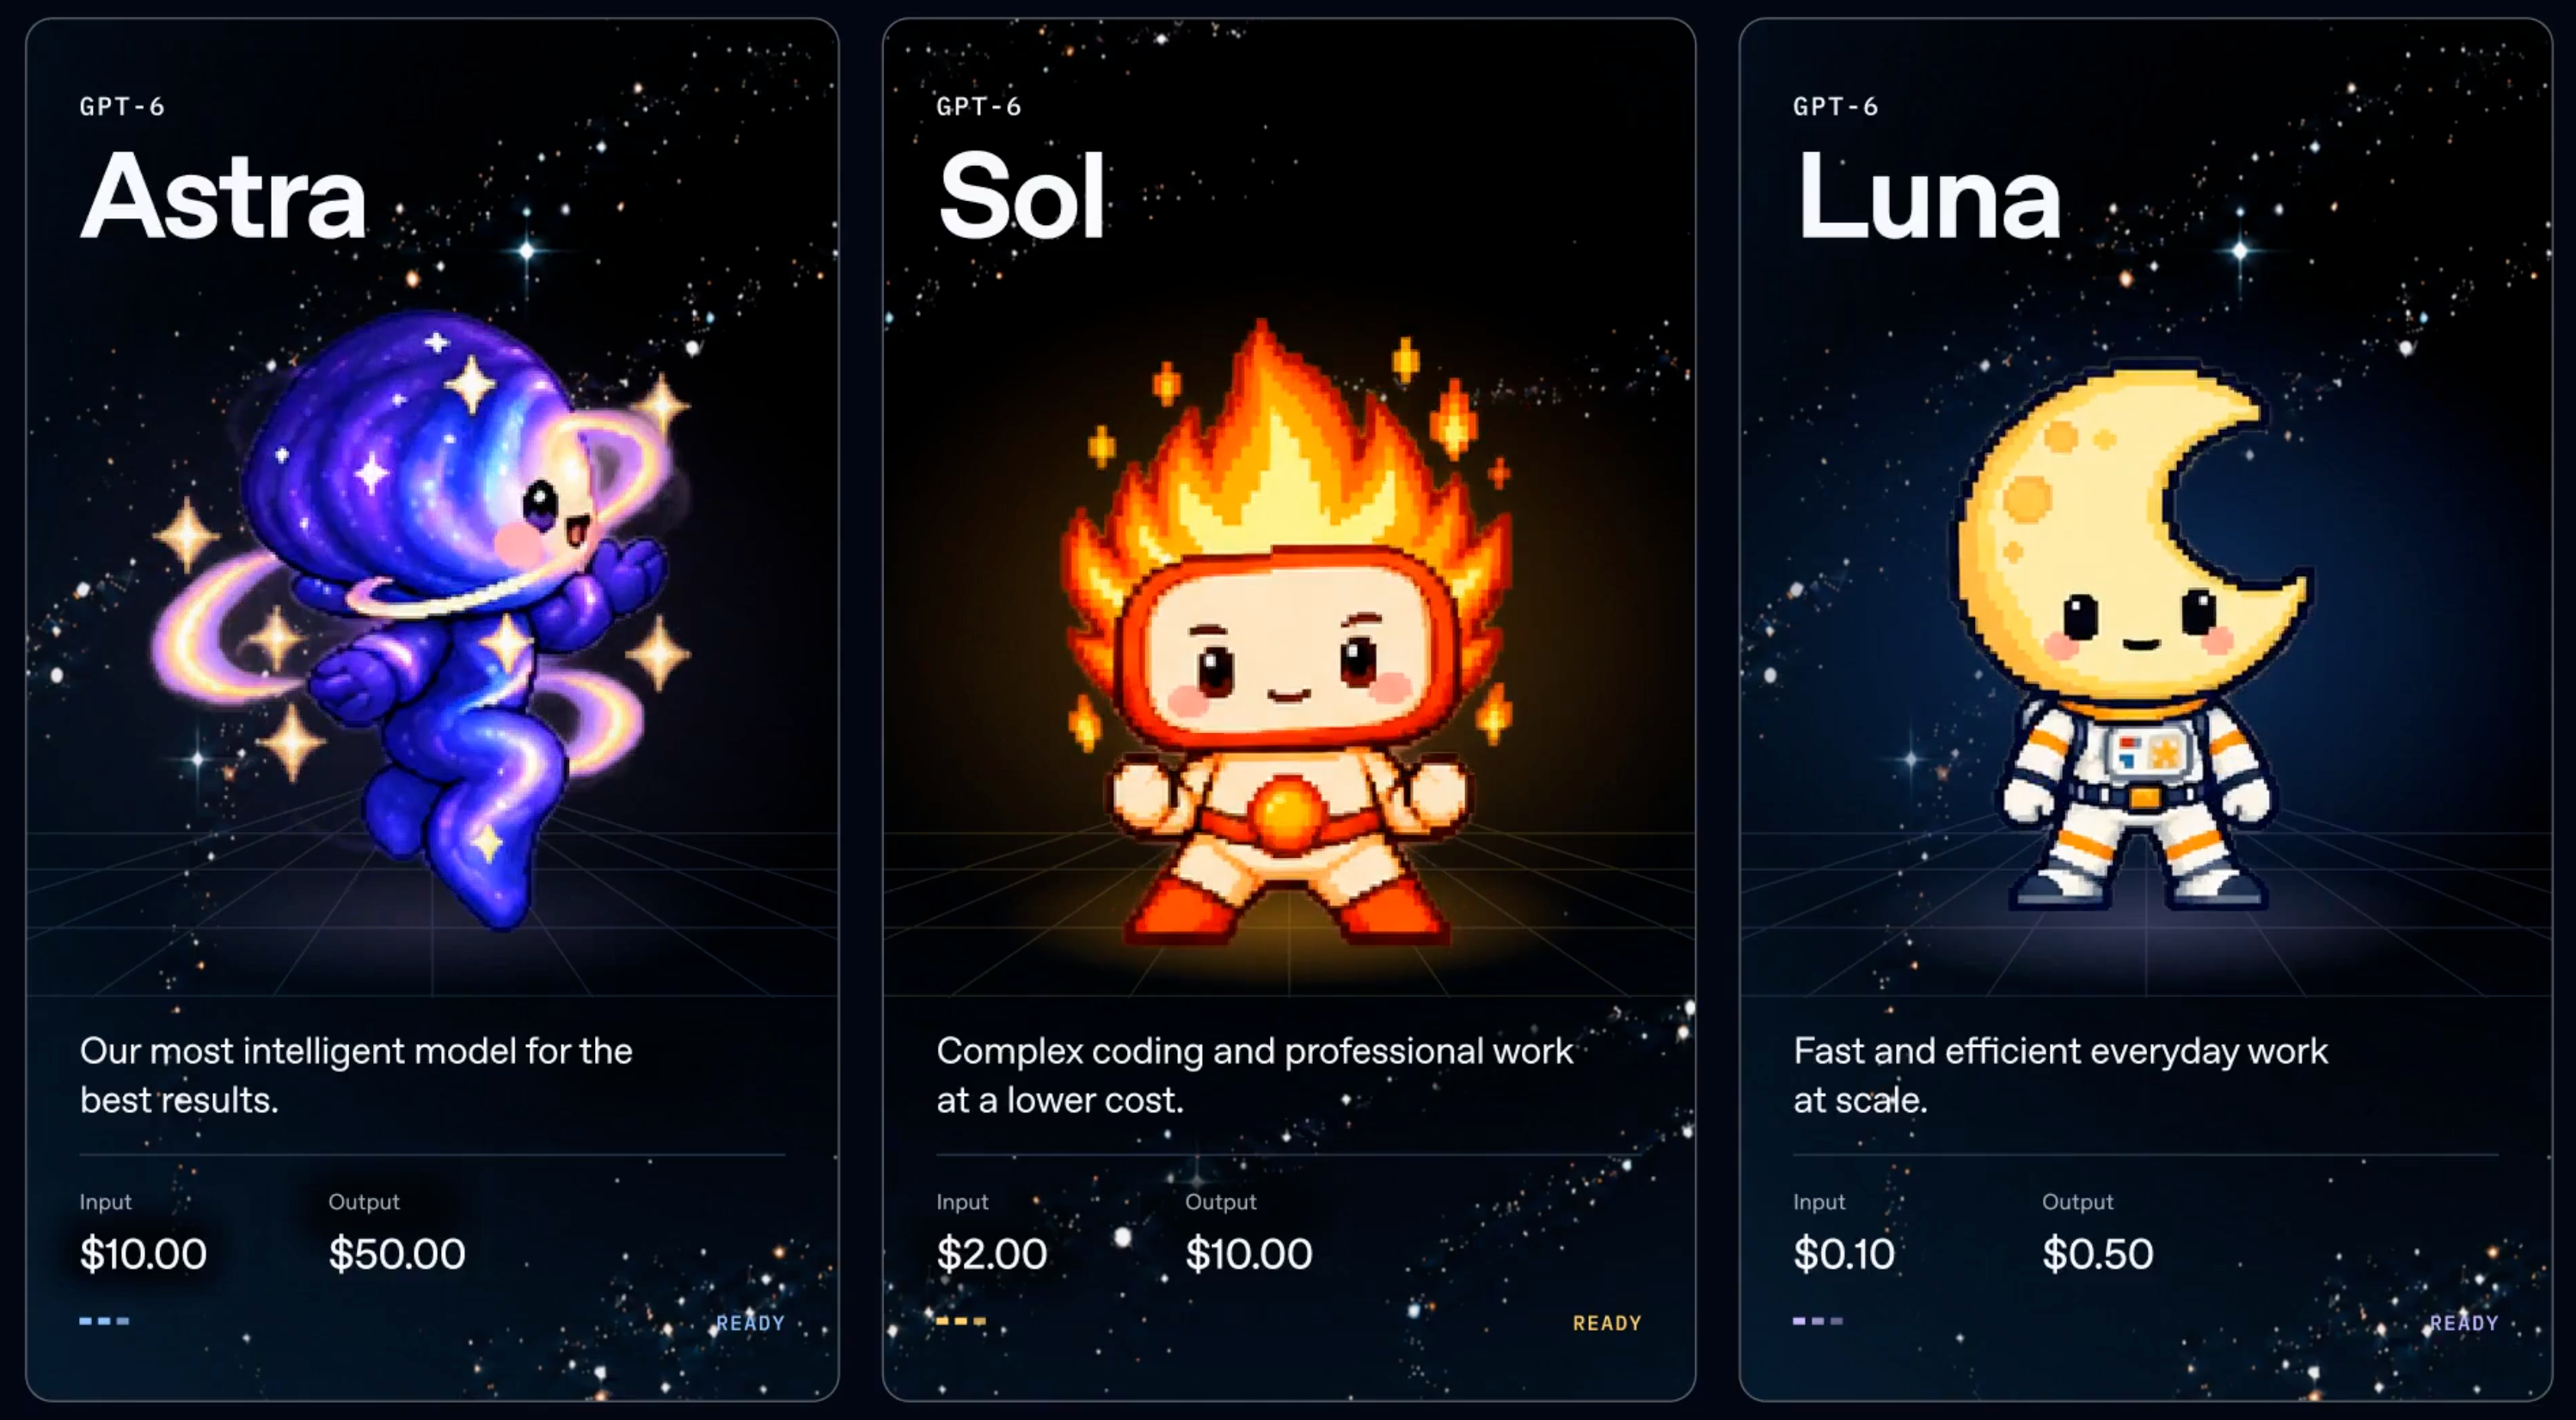
La factura es la cifra más fácil de modificar y la menos interesante de analizar. Si desvías el trabajo rutinario de tu Crew a GPT-6 Luna a 0,10 $ y 0,50 $ por millón de tokens, la partida de gasto en modelos se desploma en cuestión de un día. Dos semanas después, la factura sigue baja, el tablero acumula más ejecuciones finalizadas que nunca y los cuatro cambios del martes pasado siguen esperando a que alguien los acepte.
No ha fallado nada. Simplemente trasladaste el coste de una partida que tenías bajo control a otra a la que nadie le pone precio.
El coste por cambio aceptado es la suma total de dinero y tiempo humano invertido en cada intento que derivó en un cambio aprobado por una persona. Tiene en cuenta las ejecuciones fallidas, el código generado que nadie integró y los minutos que alguien dedicó a evaluar ambos. Ningún proveedor lo publica, ningún benchmark lo mide y, sin embargo, es la única métrica que avanza al compás de lo que tu equipo entrega a producción.
En resumen (TL;DR)
Un modelo más barato reduce el coste por intento, pero incrementa tres factores que se pagan con la atención del revisor: los intentos por cambio entregado, el volumen generado por intento y las decisiones necesarias por cada cambio aprobado. La atención humana no se abarató el 22-09-2026. La gama económica es realmente más barata allí donde una máquina decide si un intento fue exitoso, pero resulta discretamente costosa donde debe intervenir una persona. Los agentes investigan, ejecutan, prueban y reportan. Las personas definen la dirección, otorgan autorizaciones y aceptan el resultado. La solución pasa por un cambio de contabilidad antes que por un cambio de enrutamiento: mide los intentos y los minutos de trabajo humano por cambio aceptado, para cada Runtime, y convierte el trabajo que espera revisión humana en un estado cuantificable en vez de en una sensación que te invade los viernes.
Tres métricas, y solo una te pertenece
| Unidad | Quién la usa | Qué te dice | Qué deja fuera |
|---|---|---|---|
| Por millón de tokens | Páginas de precios de los proveedores | Lo que cuesta una entrada y una salida | Cuántos tokens requiere tu tarea |
| Por tarea completada | Tablas de benchmarks | El coste de un intento evaluado | Intentos fallidos, tu base de código, la revisión |
| Por cambio aceptado | Tu equipo | Lo que costó de principio a fin un cambio entregado | Nada; por eso nadie la publica |
Ambos laboratorios lanzaron novedades el 22-09-2026 y ambos publicaron cifras basadas en la columna central. No leas esas tablas como si fueran la columna de la derecha.
Cuánto cuesta y qué puntuación obtiene la gama económica
| GPT-6 Luna | GPT-6 Sol | Claude Opus 5.5 | |
|---|---|---|---|
| API id | gpt-6-luna |
gpt-6-sol |
claude-opus-5-5 |
| Input / output per 1M | $0.10 / $0.50 | $2 / $10 | $4 / $20 |
| Cached input | 90% de descuento en lecturas | 90% de descuento en lecturas | $0.20 lectura, $5 escritura |
| Context | 1M | 872k | 1M |
| DeepSWE 1.1 at max reasoning | 66.6% | 68.8% | No figura en el material de lanzamiento |
| Artificial Analysis index | 37 | 48 | 58, 1.º de 212 |
Anthropic reporta un 40,0% en AutomationBench para Opus 5.5. OpenAI reporta un 33,2% para Sol con razonamiento extra alto en AutomationBench 1.0.6, a 0,27 $ por tarea. Dos laboratorios, dos entornos de evaluación (harnesses), un solo coste publicado por tarea. Esa comparativa no es un enfrentamiento directo real, y la imposibilidad de convertirla en uno demuestra el punto clave: ninguna tabla de un proveedor te permite calcular el coste por cambio aceptado.
Primer factor oculto: intentos por cambio aceptado
OpenAI sitúa a Luna con razonamiento máximo en un 66,6% en DeepSWE 1.1 y a Sol al máximo en un 68,8%. Según nuestros propios cálculos, esto significa que aproximadamente uno de cada tres intentos de Luna no supera las pruebas. Tu repositorio no es DeepSWE y tus métricas variarán, pero la tendencia se mantiene: un modelo económico que puntúa unos pocos puntos por debajo no es solo «ligeramente peor» en cada ejecución; tiene una probabilidad unos puntos mayor de entregarte un resultado que requerirá otra vuelta de revisión.
El impacto económico de esa ronda adicional sigue siendo insignificante. OpenAI indica que Luna al máximo es un 93% más barato por tarea que Claude Opus 5 en el mismo benchmark. Duplica los intentos y, de nuevo según nuestras estimaciones, sigue siendo en torno a un 86% más económico. La partida del modelo nunca llega a ser el problema.
Sin embargo, el intento fallido no sale gratis en ningún otro aspecto. Generó una rama, un resumen de cambios y una decisión que recae sobre una persona. Una ejecución fallida no equivale a cero: es un elemento más por revisar sin ningún cambio útil al final del proceso.
Segundo factor oculto: los modelos económicos mejoran pensando más tiempo
Analicemos de dónde proceden las buenas cifras de Luna. Ese 66,6% se obtiene con razonamiento máximo, y la nota de precisión fáctica de OpenAI señala que Luna, con un mayor esfuerzo de razonamiento, iguala a GPT-5.6 Sol a una centésima parte del coste. La gama económica alcanza una calidad aceptable dedicando más esfuerzo, y ese esfuerzo se traduce en tokens de salida y tiempo de reloj transcurrido.
Artificial Analysis, una entidad independiente y no vinculada a ninguno de los proveedores, registra para las variantes con razonamiento máximo una velocidad de 153,9 tokens de salida por segundo en Luna con 124,23 segundos hasta el primer token, y 115,2 tokens por segundo en Sol con 102,15 segundos. Tómense como valores orientativos: provienen de un tercero, analizan específicamente las variantes máximas y varían a medida que los laboratorios actualizan sus mediciones.
Esto acarrea dos consecuencias directas sobre tu equipo, no sobre tu factura. Una ejecución que permanece en silencio durante dos minutos parece idéntica a una que se ha quedado colgada, por lo que alguien tiene que ir a comprobarla. Además, una traza más extensa con un diff más largo implica más lectura, por intento, antes de que alguien pueda dar el visto bueno. La capacidad de lectura es el recurso escaso, y acabas de adquirir más de aquello que lo consume.
Tercer factor oculto: decisiones, no diffs
Cuenta las decisiones humanas necesarias desde que se asigna una Task hasta que se acepta un cambio. Con un Runtime potente, el flujo habitual es directo: leerlo y aceptarlo. Con un Runtime económico que realiza tareas no verificables automáticamente, el flujo se ramifica, y cada bifurcación requiere a una persona:
- La ejecución ha fallado. ¿Se reintenta en el mismo Runtime o se escala a uno más potente?
- La ejecución superó las pruebas, pero adoptó un enfoque que tú no habrías elegido. ¿Se acepta o se devuelve?
- La ejecución produjo tres resultados parciales. ¿Cuál de ellos es el cambio definitivo?
- La ejecución se detuvo para hacer una pregunta. ¿Quién responde y dónde queda registrada la respuesta?
Nada de esto figura en la factura de tokens. Todo esto se refleja en el calendario de quien sea responsable de la revisión humana.
La fórmula con tus propios números
cost per accepted change
  = attempts per accepted change
      x (model cost per attempt + reviewer minutes per attempt x loaded cost per minute)
  + escalation cost when the cheap tier hands the job back
Rellénala con tus cifras, no con las nuestras. A 0,10 $ y 0,50 $ por millón de tokens, el coste del modelo dentro del paréntesis se reduce prácticamente a cero, por lo que la ecuación pasa a estar dominada por los minutos del revisor multiplicados por el número de intentos. Cambiar a un Runtime más barato reduce una partida que ya era pequeña y multiplica la que no lo era. A veces sigue siendo un intercambio ventajoso, pero nunca es algo que puedas evaluar limitándote a la página de tarifas.
Cuándo la gama económica resulta realmente más barata
Utiliza un Runtime económico cuando sea una máquina la que determine si el intento fue exitoso. Comprobación de tipos (typecheck), pruebas unitarias, compilación, reglas de linter, validación de esquemas: el veredicto llega antes de que una persona deba prestar atención, y los intentos adicionales los absorbe el arnés de pruebas y no la tarde de tu viernes. Ese es el grueso del volumen en un Crew operativo y el argumento genuino para enrutar el trabajo monótono a Luna.
No uses un Runtime económico cuando la aprobación dependa del criterio humano. Decisiones de arquitectura, migraciones de datos, cualquier aspecto relevante para la seguridad o cualquier escenario donde la pregunta «¿es correcto esto?» no pueda responderse con un comando. En esos casos, la diferencia de rendimiento se traduce directamente en minutos de revisión, y lo más barato que puedes comprar es un intento que solo tengas que leer una vez.
Define por escrito la regla de escalado en lugar de dejarla al criterio personal, porque una preferencia siempre pierde frente a un precio más bajo. El enrutamiento de modelos es una regla que prioriza la verificabilidad en primer lugar y el coste en segundo.
Por qué ningún proveedor te dirá esto
Ambos laboratorios publicaron benchmarks comparativos el mismo día, y la referencia con la que OpenAI comparó sus resultados fue Claude Opus 5, modelo que Anthropic reemplazó por Opus 5.5 apenas unas horas después. El modelo económico de cada proveedor es la parte superior de su propio embudo de ventas. Ninguno publicará la frase «nuestro modelo económico requerirá una ronda extra de revisión por parte de tu equipo», y ninguno se equivoca al omitirla: esa cifra depende de tu base de código y de tu equipo.
Sharkly no vende tokens de modelos. El uso de los modelos se gestiona a través de las suscripciones o claves de API configuradas en las herramientas que tu equipo ya utiliza, por lo que a nosotros no nos afecta qué Runtime elijas. Esta es la única posición desde la que se puede defender este argumento con total honestidad, y es el mismo motivo por el que tu flujo de trabajo debería ser capaz de incorporar el próximo modelo económico sin tener que rediseñarse por completo.
Qué deberías mostrar en el panel de control
Minutos humanos por cambio aceptado, según el Runtime. Si esa métrica aumentó tras el cambio, el modelo económico te está saliendo más caro y ahora tienes la prueba. El coste en dólares por ejecución responde a una pregunta que dejó de ser determinante el 22-09-2026.
Intentos por cambio aceptado, según el Runtime. Este factor lo determina todo y ningún proveedor te lo va a proporcionar. Lo obtienes registrando qué Runtime generó cada intento dentro de la Task correspondiente.
«En espera de revisión humana» como un estado real. La ejecución, los bloqueos, los resultados y los debates posteriores regresan a la cronología de la Task, de modo que la cola de elementos que requieren atención humana sea cuantificable en lugar de anecdótica. Exige que cada ejecución llegue acompañada de sus evidencias:
Before a run reaches a person, the Task carries:
- the change summary
- typecheck, test, and build results
- known limits and what was not attempted
- the attempt number and which Runtime produced it
A pequeña escala no necesitas nada de esto. Si una sola persona ejecuta dos agentes y revisa todo esa misma tarde, sigue haciéndolo así: los estados y las colas de espera suponen una sobrecarga innecesaria para un problema que aún no tienes. Este control empieza a ser crítico cuando ya nadie es capaz de recordar cuántas ejecuciones finalizadas están pendientes de revisión.
La parte que no se ha abaratado
Dos laboratorios redujeron el precio de un intento el mismo día. Ninguno lanzó nada que lea un diff por ti, y la responsabilidad última del cambio sigue recayendo en una persona. Un modelo más barato no equivale a un flujo de trabajo más económico. Se traduce en un intento más barato, y los intentos alimentan un proceso cuya fase costosa sigue siendo humana.
Si ya utilizas varios agentes de programación, Sharkly te ofrece un punto centralizado para ver qué Runtime generó cada intento, qué evidencias adjuntó y cuánto trabajo está esperando la atención de una persona en este preciso instante.