
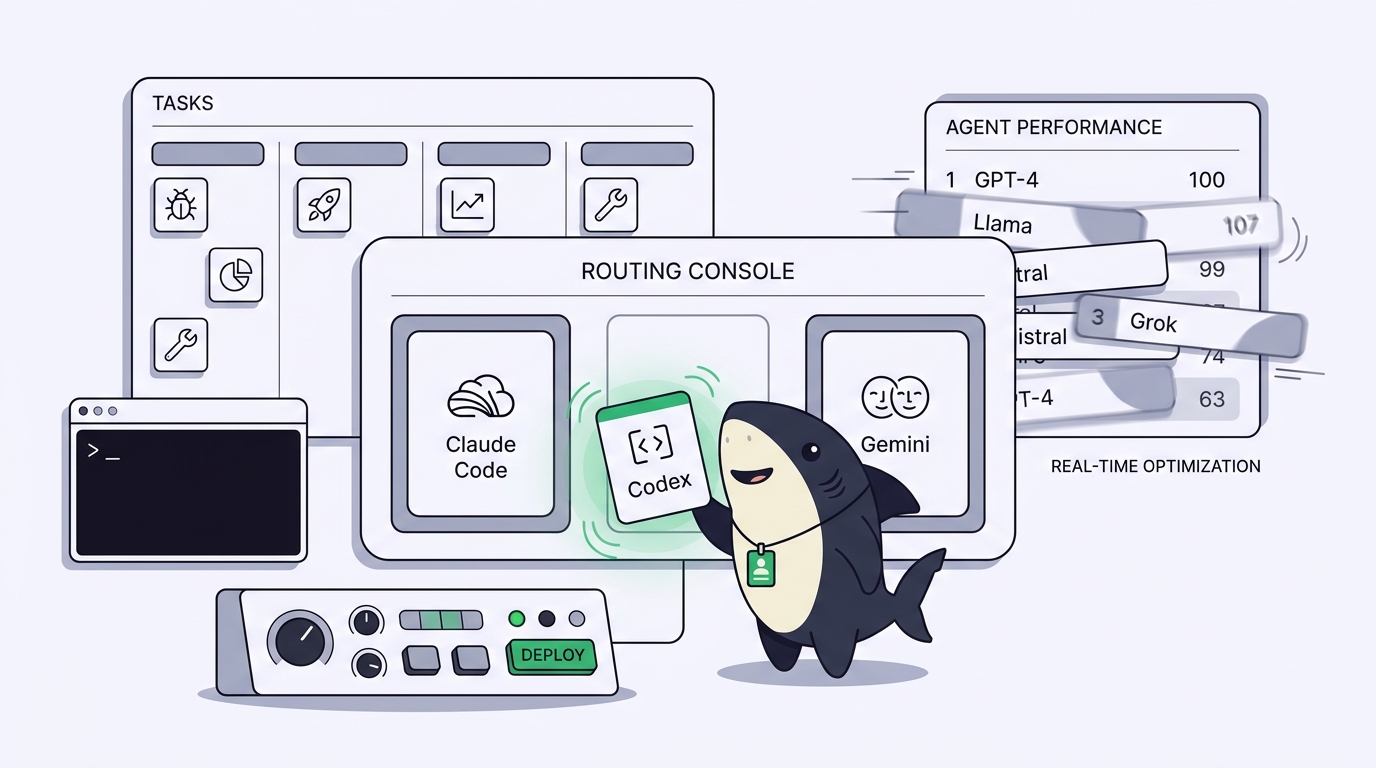
Estás intentando elegir el mejor agente de programación. Lees la tabla de clasificación, sigues las publicaciones de lanzamiento y lanzas el mismo prompt en Claude Code, Codex y Gemini CLI para ver cuál parece más preciso. Luego sale un modelo nuevo, la clasificación se reorganiza y el agente que estandarizaste el mes pasado pasa de repente a la mitad de la tabla. Así que vuelves a cambiar.
Esta es la parte incómoda: el agente que eliges cambia menos tu semana de lo que crees. Lo que determina cuánto trabajo entregas de verdad es lo que ocurre alrededor del agente. Qué agente tiene qué tarea, qué terminó, qué falló, qué está esperando tu revisión. La mayoría de los desarrolladores siente la atracción de la clasificación y nunca se da cuenta de que la clasificación nunca fue el cuello de botella.
Sharkly se basa en esa observación. Sharkly es una plataforma integral de gestión y control de agentes: conectas tu propio Computer, asignas una Task a cualquier Agent que ya uses y cada ejecución devuelve su diff, la salida de sus tests y su revisión a un mismo lugar. Se sitúa por encima de los agentes, no junto a ellos. Este artículo explica por qué la capa de gestión determina tu producción más que el modelo, y qué hacer al respecto este trimestre en lugar de perseguir la próxima clasificación.
El mejor agente es un blanco móvil
Una tabla de clasificación de agentes de programación mide un conjunto fijo y compartido de problemas en un momento concreto del tiempo. Esos dos hechos envejecen mal. El conjunto de problemas no es tu base de código, y el momento no es el mes que viene.
Mira el ritmo. Anthropic, OpenAI y Google han lanzado cada uno múltiples actualizaciones de modelos capaces de funcionar como agentes de programación durante el último año, y la clasificación relativa entre ellos ha dado la vuelta más de una vez [VERIFY: exact release cadence and current ranking change monthly; confirm before citing specifics]. Si tratas «usar el mejor agente» como una decisión, te estás comprometiendo a rehacerla cada vez que un laboratorio lance algo. Cada cambio conlleva un coste: nueva configuración, nuevos archivos de contexto, nuevas costumbres y un nuevo conjunto de modos de fallo que tu equipo tiene que aprender.
Ahí va una predicción, y la etiqueto como tal. La diferencia entre los mejores agentes de programación seguirá reduciéndose, no ampliándose. Cuando tres agentes resuelven el mismo bug en tu repositorio, la pregunta deja de ser «cuál es el mejor» y pasa a ser «a cuál le encargo esta tarea concreta y cómo veo el resultado». El factor diferenciador se desplaza del modelo al flujo de trabajo. Ese cambio ya se percibe en cómo los equipos hablan de los agentes; será la forma habitual de trabajar antes de ser la excepción.
La defensa contra un blanco móvil no es apuntar mejor, sino contar con un flujo de trabajo que sobreviva al movimiento del blanco. Comparar agentes en tu propia base de código te dice cuáles merece la pena ejecutar hoy; no te ata a esa respuesta mañana.
Qué decide realmente tu producción
Echa cuentas de en qué se le va el tiempo a una tarea. El agente genera un diff en minutos. Todo lo demás —decidir qué agente se lleva la tarea, mantener sus cambios aislados de los otros cuatro agentes, descubrir que se ha quedado atascado en un paso de compilación, leer lo que ha producido, aceptarlo o rechazarlo— es lo que te consume el día. Nada de eso es una propiedad del modelo.
Este es el problema de la gestión, y aparece en cuanto ejecutas más de un agente. ¿Qué agente está trabajando en qué? ¿Cuál debería recibir la siguiente tarea? ¿Qué terminó, qué falló, qué necesita que lo mire una persona? ¿Cómo evitas que tres agentes que editan un mismo repositorio toquen los mismos archivos? Cuanto más capaz es cada agente por separado, más agentes ejecutas a la vez y más urgentes se vuelven estas preguntas.
Sharkly las responde como una capa, no como una herramienta. Una Task es la unidad principal de trabajo: se la asignas a un Agent, el Agent se ejecuta en un Computer conectado dentro de un worktree aislado, y la ejecución, los bloqueos, los resultados y el seguimiento vuelven todos a la Task. El agente que hizo el trabajo es un ajuste de la Task, no la arquitectura de todo tu montaje. Cambia Claude Code por Codex en la siguiente tarea y nada más de tu proceso cambia. Eso es lo que te aporta la neutralidad de proveedor: tu flujo de trabajo sobrevive al agente que esté ganando en ese momento.
La capacidad de revisión es el verdadero techo
Un agente que imprime «done» no ha entregado nada. Una persona sigue teniendo que leer el diff, comprobar los tests y decidir. Ese paso de revisión, y no la generación de código, es la restricción con la que tropieza casi todos los equipos.
Las cuentas son crudas. Si un agente produce un día de trabajo revisable en veinte minutos, cinco agentes producen cinco días de revisión en esos mismos veinte minutos, y tú sigues teniendo un solo par de ojos. Un agente más rápido o más listo empeora esto, no lo mejora, porque llena tu cola más deprisa. Elegir el mejor agente optimiza el paso que nunca fue el cuello de botella y deja intacto el verdadero. La capacidad de revisión es el verdadero límite de cuánto trabajo de agentes en paralelo puede absorber un equipo, y ninguna mejora de modelo cambia esa aritmética.
Así que el par de decisiones que importa no es «Claude Code o Codex». Es este. Usa un agente más rápido cuando tu restricción sea generar un primer borrador de un cambio. Invierte en tu flujo de revisión cuando tu restricción sea decidir si un cambio es correcto. En la mayoría de los equipos que ejecutan agentes en paralelo, la segunda restricción aprieta mucho antes que la primera. La solución es hacer que cada ejecución sea revisable con evidencia a nivel de tarea: un diff, la salida del typecheck y de los tests, un resumen del cambio y los límites que el agente admite, todo en un mismo sitio en lugar de repartido entre terminales.
Aquí es donde el contrato entre persona y agente se gana su sitio. Los agentes investigan, ejecutan, prueban e informan. Las personas marcan el rumbo, otorgan autoridad y aceptan el resultado. La automatización se detiene donde se requiere el criterio del equipo. Un mejor agente hace más de la primera frase; no hace nada de la segunda. El techo está en tu lado de esa línea.
Haz que elegir agente sea un ajuste, no una arquitectura
Aquí está el límite, dicho con claridad para que nadie dé por sentado lo que no es: Sharkly no es un agente de programación ni un sustituto de Claude Code, Codex o cualquier entorno de ejecución. No escribe mejor código que ellos. Lo que hace es añadir la capa compartida de Task, Computer, contexto y revisión alrededor de las herramientas que tu equipo ya usa.
Esa distinción es justamente el objetivo. Cuando elegir agente es un ajuste, probar un agente nuevo te cuesta una tarea, no una migración. Conectas el entorno de ejecución, le asignas un requisito real y lees lo que devuelve, junto a los resultados del agente que usaste ayer. Cuando la elección del agente está incrustada en tu arquitectura, cada experimento es caro y cada reorganización de la clasificación es una amenaza.
Sé sincero sobre cuándo no necesitas esto. Si solo usas un agente de programación y vives feliz en una única terminal, una sesión de Claude Code bien ajustada en su propio worktree es suficiente, y la capa de gestión es un sobrecoste que puedes saltarte. La ecuación cambia en cuanto ejecutas dos o más agentes, en más de una tarea o repositorio, y quieres los resultados en un formato que un compañero pueda leer sin que tú le vayas narrando tu historial de desplazamiento. Ese es el umbral en el que la gestión de agentes de programación se convierte en una capa que de verdad necesitas y no en una buena idea.
Qué hacer de otra forma este trimestre
Deja de pasar la semana persiguiendo la clasificación. Pásala construyendo la capa que convierte la clasificación en un detalle.
Tres movimientos concretos. Primero, elige tus agentes de la forma más aburrida: pon a dos de ellos a trabajar en una tarea real de tu backlog y quédate con el que se lea mejor sobre tu código, sabiendo que volverás a revisarlo. Segundo, mide tu rendimiento de revisión con honestidad; si los agentes terminan más rápido de lo que puedes aceptar su trabajo, la próxima mejora de agente no te va a ayudar y un mejor flujo de revisión sí. Tercero, deja de incrustar un solo agente en tu proceso. Encauza el trabajo a través de una capa que trate al agente como intercambiable, para que el próximo lanzamiento de un modelo sea una opción que pruebas y no una reconstrucción que temes. Si todavía estás decidiendo a qué modelo apuntar cada agente, emparejar modelos con roles de agente es mejor uso de una tarde que refrescar una tabla de clasificación.
Si quieres seguir usando varios agentes de programación en lugar de comprometerte con un solo ecosistema, ese es justo el problema para el que Sharkly está diseñado. Descarga Sharkly, conecta un Computer y asigna la misma tarea real a dos agentes. El mejor cambiará. La forma en que los gestionas no tiene por qué cambiar.


