
En résumé : la tarification de Claude Fable 5.2 est de 8 $ par million de tokens en entrée et de 40 $ par million de tokens en sortie sur l'API standard d'Anthropic. Le mode Fast coûte respectivement 16 $ et 80 $. Prévoyez un budget pour l'ensemble du workflow : contexte répété, réflexion (thinking), nouvelles tentatives, coordination des agents, outils et revue humaine. Tarifs vérifiés le 10 novembre 2026.
Le prix au token indique ce que coûte un appel au modèle. Mais votre budget d'ingénierie doit s'évaluer au coût d'un résultat accepté. Une migration qui nécessite trois tentatives, la relecture par un autre agent et une correction humaine engendre plusieurs factures pour un seul et même livrable.
Si vous faites tourner plusieurs agents de code, Sharkly vous offre un espace partagé pour leurs Tasks et leurs résultats. Commencez votre analyse des coûts par là : définissez ce qui est considéré comme terminé avant de comparer les modèles.
Combien coûte Claude Fable 5.2 ?
Anthropic facture séparément les tokens d'entrée et de sortie, avec des tarifs distincts pour la mise en cache, le traitement par lots (batch) et le mode Fast. Un MTok correspond à un million de tokens. Les tarifs suivants en dollars américains sont issus de la documentation tarifaire officielle, vérifiée le 10 novembre 2026. Ils concernent l'utilisation de l'API et non un abonnement mensuel forfaitaire pour le développement.
| Catégorie de facturation | Entrée par MTok | Sortie par MTok |
|---|---|---|
| API standard | $8 | $40 |
| Mode Fast | $16 | $80 |
| API Batch | $4 | $20 |
| Écriture en cache standard (5 minutes) | $10 | Sans objet |
| Écriture en cache standard (1 heure) | $16 | Sans objet |
| Accès au cache standard (cache hit) | $0.20 | Sans objet |
Les écritures et les lectures en cache relèvent des catégories d'entrée, et non de remises sur les sorties. La tarification du cache en mode Fast applique les multiplicateurs de cache aux tarifs d'entrée du mode Fast. Le traitement par lots (Batch) offre une réduction de 50 % sur les entrées et les sorties, mais le mode Fast n'est pas cumulable avec Batch.
Fable intègre la fenêtre contextuelle complète d'un million de tokens aux tarifs standard par token. Cela rend néanmoins un contexte étendu onéreux : les entrées non mises en cache s'accumulent au fil des appels. Les plateformes cloud gérées par des partenaires peuvent appliquer des grilles tarifaires différentes ; vérifiez l'endpoint qui facture votre équipe.
Comment calculer le budget d'un workflow ?
Pour un appel standard sans cache, multipliez les tokens d'entrée par 8 $ par million et les tokens de sortie par 40 $ par million, puis additionnez les montants. Répétez le calcul pour chaque appel de chaque tentative. Ajoutez les coûts distincts liés aux outils et à l'infrastructure, ainsi que le temps de revue humaine, pour estimer le coût total de livraison.
# Hypothetical standard-API example, not a measured benchmark.
input_tokens = 100_000
output_tokens = 20_000
api_cost = input_tokens / 1_000_000 * 8
api_cost += output_tokens / 1_000_000 * 40
print(f"${api_cost:.2f}")  # $1.60
Ici, « sortie » désigne la totalité des tokens de sortie facturables, y compris le raisonnement (thinking) le cas échéant. Ne confondez pas la longueur de la réponse affichée avec la consommation réelle déclarée par le fournisseur.
Supposons que vous exécutiez 20 tâches avec ces volumes de tokens. Cinq d'entre elles nécessitent une seconde tentative identique. Admettons qu'un agent de coordination ajoute 2 $ au total, et qu'un relecteur y consacre 15 minutes pour un coût interne de 80 $ par heure.
| Composante hypothétique | Calcul | Coût |
|---|---|---|
| Tentatives initiales | 20 × $1.60 | $32 |
| Tentatives supplémentaires | 5 × $1.60 | $8 |
| Coordinateur | Estimation des dépenses cumulées du modèle | $2 |
| Revue humaine | 0,25 heure × $80 | $20 |
| Total | Hors outils, infrastructure et taxes | $62 |
Si l'ensemble des 20 tâches est validé, cet exemple revient à 3,10 $ par tâche acceptée. Si seulement 16 sont acceptées, les mêmes 62 $ représentent environ 3,88 $ par tâche validée. Le dénominateur change la donne.
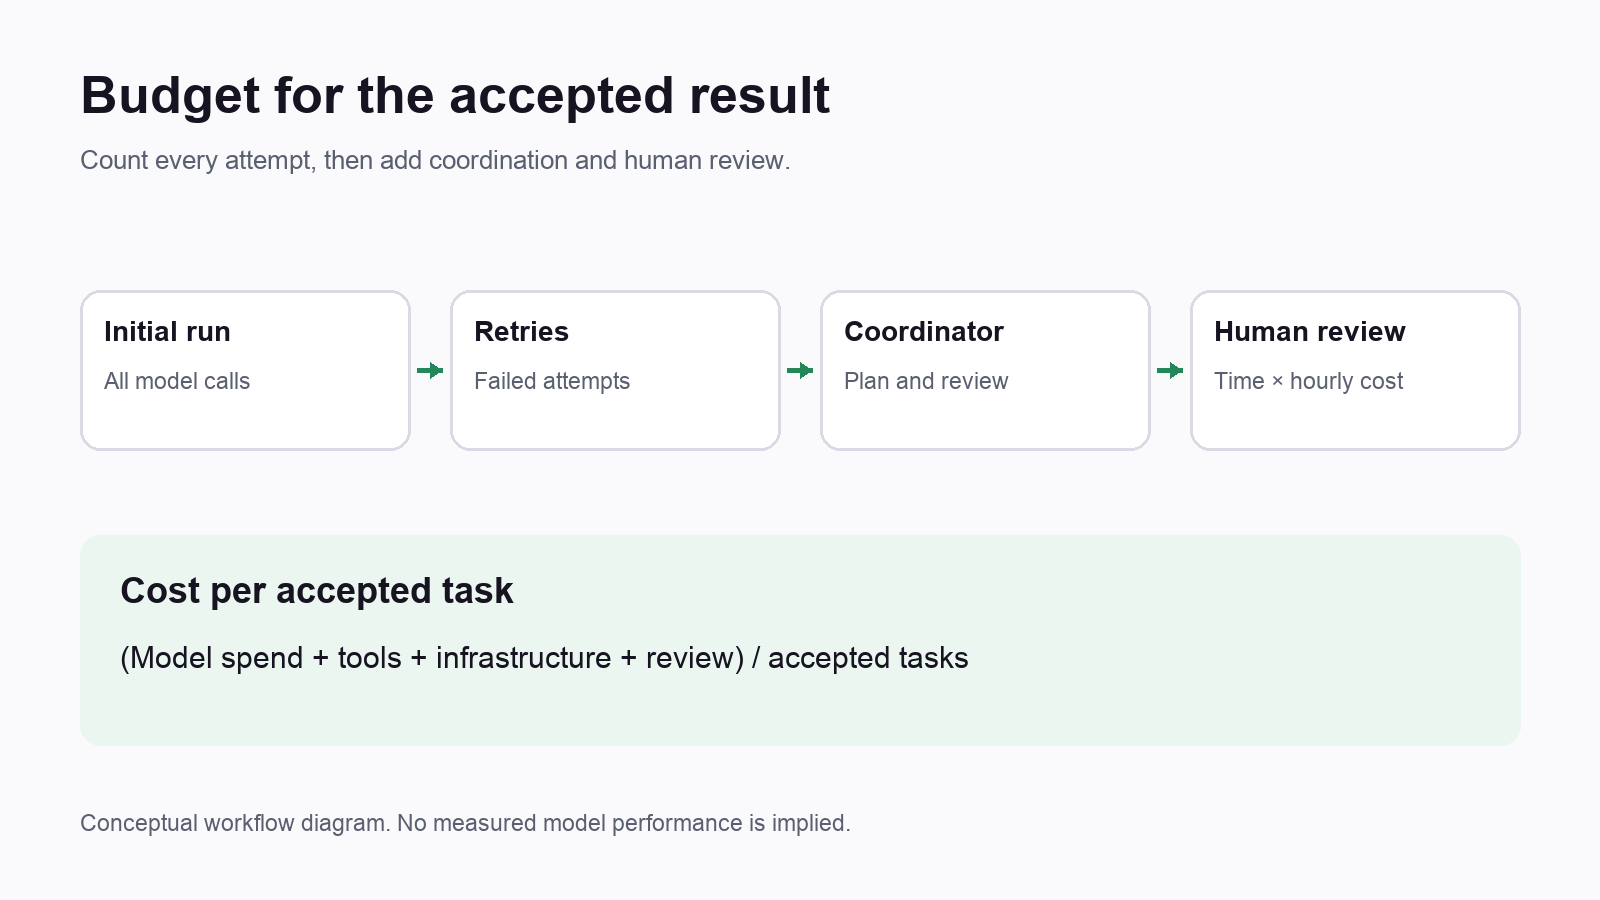
Il s'agit ici d'hypothèses d'évaluation et non de performances observées pour Fable. Remplacez-les par vos propres totaux de tokens, nombres de tentatives, taux d'acceptation et temps de relecture. Notre guide sur le calcul du coût des exécutions d'agents par modification acceptée explique pourquoi cette comparaison est essentielle.
Le mode Fast et les paramètres d'effort n'agissent pas sur les mêmes coûts
Le mode Fast augmente le tarif des tokens pour réduire le temps de génération. L'effort, quant à lui, modifie la quantité de travail effectuée par le modèle, notamment la réflexion et les appels d'outils. Considérez-les comme deux leviers distincts : une génération plus rapide ne garantit pas un workflow de bout en bout plus court, et un niveau d'effort plus faible ne fixe pas de plafond de dépenses garanti.
L'annonce de lancement d'Anthropic indique que le mode Fast génère des tokens jusqu'à 2,5 fois plus vite. Il s'agit d'une affirmation du fournisseur concernant la génération, et non d'une garantie que les builds, les tests, les appels réseau ou la revue humaine s'exécuteront 2,5 fois plus vite.
À nombre de tokens identique, l'exemple à 1,60 $ passe à 3,20 $ en mode Fast. Privilégiez le mode Fast lorsque le gain de temps compense ce surcoût. Utilisez le mode standard pour les tâches automatisées en arrière-plan lorsque le délai de génération ne freine pas la livraison.
La documentation sur l'effort répertorie les niveaux Low, Medium, High, Xhigh et Max pour Fable 5.2. La valeur par défaut de l'API est High. L'annonce précise que Medium est le niveau par défaut dans les applications Claude et Claude Code. Consignez le produit ainsi que le paramètre exact dans votre comparatif.
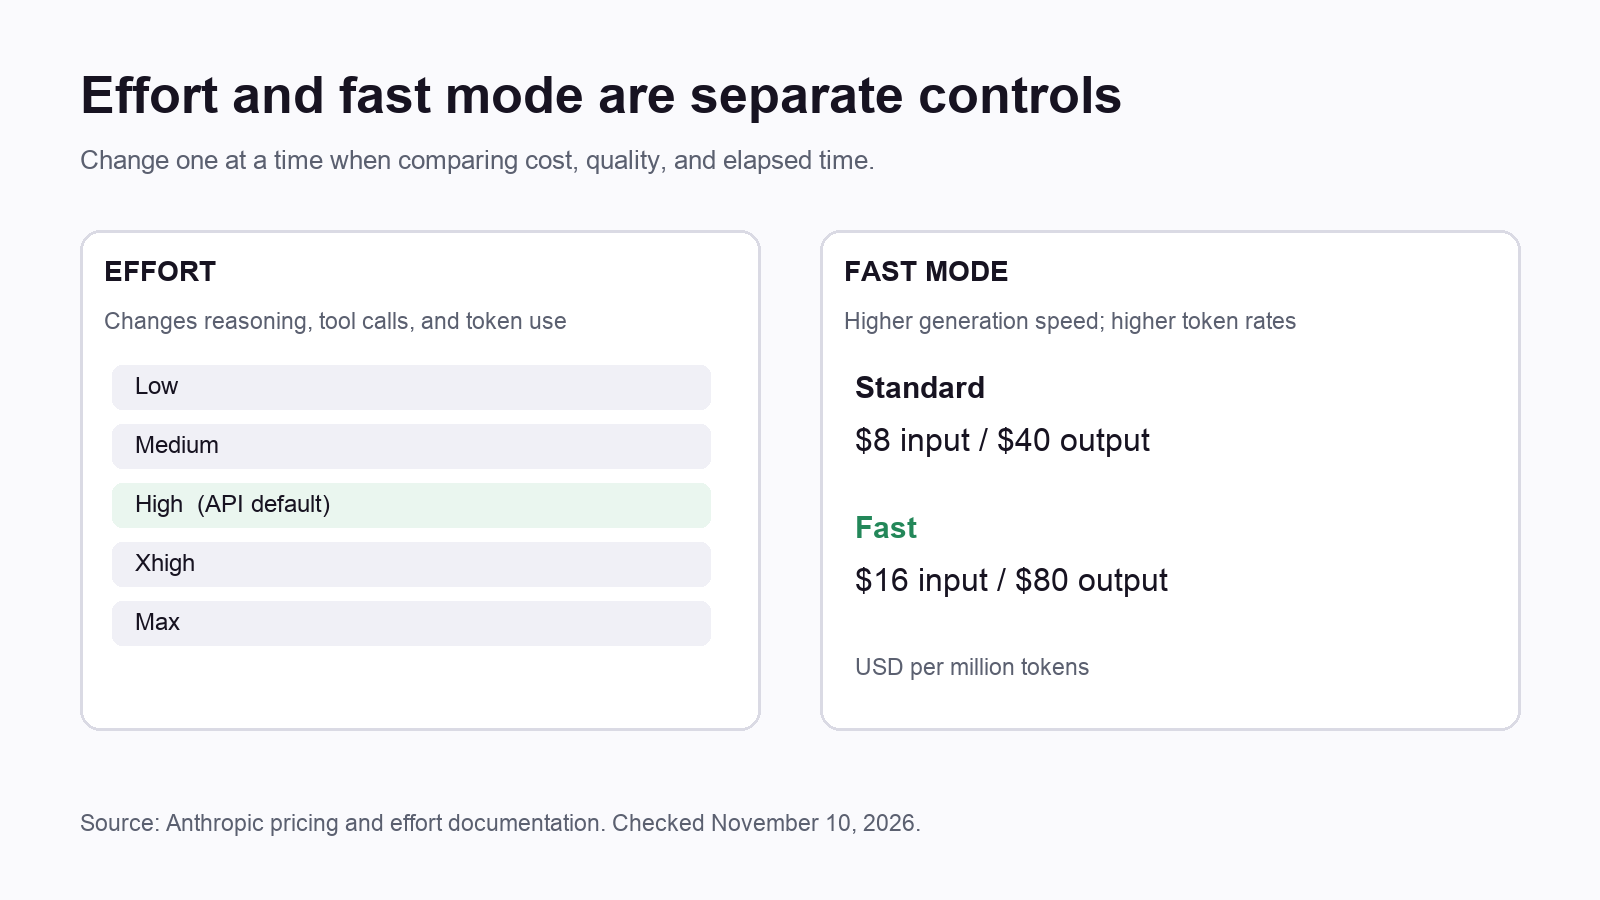
Anthropic conseille de démarrer les charges de travail sur l'API avec le réglage High, de réduire l'effort lorsque les évaluations confirment le maintien de la qualité, et de passer à Xhigh lorsque les tâches complexes affichent un gain mesurable. Le niveau Max privilégie la performance brute sans considération du coût en tokens. L'effort est une consigne de comportement ; veillez à appliquer de véritables limites de dépenses au niveau de votre application et de vos processus opérationnels.
Maîtriser le contexte répété, les nouvelles tentatives et l'orchestration
Appliquez ces six leviers de contrôle avant d'augmenter le nombre d'agents :
- Mesurez chaque tentative. Intégrez les tentatives échouées et abandonnées dans le coût global de la tâche.
- Mettez en cache le contexte stable. Réutilisez les instructions du dépôt et les documents inchangés lorsque la charge de travail est éligible au prompt caching.
- Limitez les nouvelles tentatives. Définissez un nombre maximal d'essais et exigez un diagnostic avant de relancer une tentative coûteuse.
- Acheminez selon la difficulté. Réservez l'escalade vers Fable aux raisonnements complexes non résolus au lieu de lui confier chaque étape d'extraction ou de mise en forme.
- Budgétisez la coordination. Intégrez la planification, la répartition des tâches, les résumés et les appels des relecteurs aux côtés des appels des agents exécutants.
- Régulez le flux des revues. Ajustez le volume de travail finalisé en fonction du nombre de modifications que vos relecteurs sont capables d'examiner.
Les définitions d'outils et leurs résultats viennent grossir les tokens d'entrée du modèle. Certains outils côté serveur font l'objet d'une tarification séparée, comme le précise le guide tarifaire d'Anthropic. Une commande qui renvoie un journal volumineux peut ainsi alourdir le coût du contexte lors des appels ultérieurs, même si son exécution propre n'a presque rien coûté.
La mise en cache doit également faire l'objet d'un suivi précis. Pour un préfixe hypothétique de 100 000 tokens, une écriture standard valable cinq minutes coûte 1 $. Une lecture ultérieure du cache (cache hit) coûte 0,02 $, contre 0,80 $ pour une entrée non mise en cache. Ces chiffres ne tiennent pas compte des nouveaux tokens d'entrée et de sortie. Vérifiez le taux réel d'utilisation du cache avant de tabler sur des économies.
Pour mettre en place une politique de routage reproductible, consultez la vue d'ensemble des modèles. Anthropic recommande Opus 5.5 pour la plupart des charges de travail, et Fable pour les raisonnements exigeants ou les tâches à long terme. C'est une stratégie de départ à évaluer, pas une garantie d'efficacité absolue sur votre propre base de code.
Que faut-il mesurer lors d'un projet pilote ?
Conservez un périmètre de tâche et des tests de validation identiques entre les différentes configurations. Distinguez bien le temps d'attente en file, la génération du modèle, l'exécution des outils et la revue humaine dans vos relevés temporels. Sinon, une suite de tests lente pourrait masquer le bénéfice d'une génération plus rapide, ou un ensemble de tâches trop simples pourrait donner l'illusion qu'une configuration coûteuse est économique.
Comptabilisez les entrées en cache séparément des entrées hors cache. Associez les volumes réels relevés chez le fournisseur à chaque tentative plutôt que d'estimer les tokens à partir de la taille des fichiers. Lorsque vous modifiez le paramètre d'effort, comparez non seulement la première réponse obtenue, mais aussi le résultat validé et le travail de reprise nécessaire. Une première exécution plus courte peut masquer une facture de corrections bien plus lourde.
Définissez une condition d'arrêt avant de lancer le pilote : un nombre limite de tentatives, un seuil de dépenses ou un point de contrôle humain. Un modèle qui poursuit ses investigations sans fin peut épuiser votre budget tout en produisant un travail que vous ne pouvez pas encore valider.
Rattacher le budget au travail accompli
La description officielle de Sharkly réunit les Tasks, les agents de code, les Computers connectés et les revues humaines au sein d'un même espace de travail. Vous conservez les comptes d'API ou les abonnements de code configurés dans vos outils. La consommation liée aux modèles reste imputée à ces comptes fournisseurs.
Utilisez cet historique de travail partagé pour consigner le modèle, le niveau d'effort, les tentatives, les éléments de preuve et l'issue de la revue. Pour une migration, demandez à l'Agent de fournir les résultats des tests ainsi que les limites identifiées avec ses modifications. Les intervenants humains peuvent ensuite valider le travail ou demander des corrections. Consultez notre article sur la revue de code généré par l'IA avec des preuves au niveau de la tâche pour découvrir une méthode de revue structurée.
Pour un correctif mineur, mobilisez un seul Agent. Faites appel à un Crew lorsque la tâche justifie l'intervention de spécialistes distincts et une réelle coordination. Multiplier les agents entraîne des appels et des transmissions supplémentaires : mesurez donc les résultats avant de faire du travail parallèle votre fonctionnement par défaut. Le guide sur les Crews combinant plusieurs modèles détaille ces passages de relais.
Commencez avec un échantillon représentatif de dix tâches. Pour chaque configuration, enregistrez la dépense totale, le temps écoulé, le taux d'acceptation et les minutes passées en relecture. Connectez un Computer dans Sharkly, assignez une Task bien délimitée et demandez des éléments de preuve lors de la livraison. Vous pourrez monter en charge une fois capable d'expliquer le coût par résultat accepté.
FAQ
Le mode Fast de Claude Fable 5.2 est-il deux fois plus cher ?
Les tarifs affichés pour les tokens d'entrée et de sortie sont effectivement deux fois plus élevés que les tarifs standard. Néanmoins, le coût total de votre workflow dépend également du volume de tokens, de la mise en cache, des outils utilisés et des éventuelles nouvelles tentatives.
Le niveau d'effort Medium modifie-t-il le prix des tokens ?
L'effort modifie le comportement du modèle et sa consommation de tokens. Il ne remplace pas les tarifs d'entrée et de sortie indiqués par une grille tarifaire distincte indexée sur l'effort.
Un budget d'abonnement est-il identique à un budget d'API ?
Non. Cet article évalue une utilisation facturée à l'usage via l'API. Vérifiez séparément les conditions et les quotas associés à votre abonnement d'outils de code.
Le traitement par lots (Batch) permet-il de réduire la facture ?
L'API Batch affiche un tarif de 4 $ en entrée et 20 $ en sortie par million de tokens pour Fable. Optez pour le traitement asynchrone dès que le workflow le permet ; notez que le mode Fast n'est pas disponible avec Batch.
Un coût par appel plus faible garantit-il une livraison plus économique ?
Uniquement si les nouvelles tentatives, le taux d'acceptation, l'orchestration et la revue préservent cet avantage. Comparez les dépenses globales par rapport aux tâches validées, en appliquant rigoureusement les mêmes critères de validation.
Ressources complémentaires
Pour approfondir la planification de vos workflows, consultez nos articles sur la gestion des coûts des agents de code et la capacité de revue humaine pour les agents parallèles. Pensez à vérifier la documentation d'Anthropic sur les tarifs et l'effort avant d'appliquer ces montants à un nouveau budget.


