

GPT-6.2 Astra vs Fable 5.2 : l’écart est plus serré que ne le laissent croire les gros titres. Les deux sont affichés à 8 $ par million de tokens en entrée et à 40 $ par million de tokens en sortie. Anthropic publie de meilleurs scores de codage agentique pour Fable 5.2 ; OpenAI ne publie aucun benchmark de codage pour Astra. Le prix du cache, les surcoûts de contexte long et votre propre taux de modifications acceptées décideront du gagnant pour votre équipe.
OpenAI a publié GPT-6.2 Astra le 17 novembre 2026, huit jours après la sortie de Claude Fable 5.2 par Anthropic. Les deux sont des modèles de pointe destinés à un travail agentique long et exigeant. Si vous faites tourner des agents de codage, vous avez désormais deux options phares au même prix affiché.
Un classement ne peut pas trancher à votre place. Vos dépendances, votre suite de tests et vos relecteurs, si. Ce guide compare les chiffres publiés, montre où les factures divergent et vous propose un test comparatif à exécuter sur votre propre dépôt. Si vous utilisez déjà Codex et Claude Code côte à côte, Sharkly est l’endroit où confier la même tâche aux deux et conserver les résultats ensemble.
GPT-6.2 Astra vs Fable 5.2 : les caractéristiques côte à côte
GPT-6.2 Astra est le modèle de pointe d’OpenAI dans la famille GPT-6.2 ; GPT-6.2 Sol est son petit frère moins cher pour l’usage quotidien. Claude Fable 5.2 est le modèle le plus haut de gamme d’Anthropic généralement disponible, Mythos 5.2 étant réservé à une version à accès limité. Voici ce que publie chaque fournisseur, vérifié le 20 novembre 2026.
| GPT-6.2 Astra | Claude Fable 5.2 | |
|---|---|---|
| Date de sortie | 17 novembre 2026 | 9 novembre 2026 |
| ID du modèle API | gpt-6.2-astra |
claude-fable-5-2 |
| Entrée, pour 1 M de tokens | 8 $ | 8 $ |
| Sortie, pour 1 M de tokens | 40 $ | 40 $ |
| Entrée en cache (succès de cache) | 0,40 $ | 0,20 $ |
| Écriture de cache | 10 $ (30 minutes) | 10 $ (5 minutes), 16 $ (1 heure) |
| Batch | 50 % du tarif standard | 4 $ en entrée, 20 $ en sortie |
| Mode rapide | 2 × le tarif standard | 16 $ en entrée, 80 $ en sortie |
| Fenêtre de contexte | 1 050 000 tokens (922 000 en entrée max) | 1 M de tokens au tarif standard |
| Sortie maximale | 128 000 tokens | 128 000 tokens |
| Surcoût d’entrée longue | Au-delà de 272 K en entrée : les tarifs d’entrée et de cache doublent, la sortie passe à 1,5 × | Aucun indiqué |
| Agent de codage habituel | Codex | Claude Code |
Sources : la page du modèle GPT-6.2 Astra d’OpenAI, la documentation de tarification et la présentation des modèles d’Anthropic.
Deux lignes comptent surtout pour les agents. Un agent de codage renvoie son contexte à chaque tour, donc le taux de succès du cache détermine l’essentiel de la facture. Et un agent qui a lu un gros dépôt peut dépasser 272 K tokens en entrée, seuil où les tarifs d’Astra changent.
Ce que disent les benchmarks de codage, et ce qu’ils ne disent pas
L’annonce de Fable 5.2 par Anthropic rapporte 69,9 % sur FrontierSWE v2 et 49,1 % sur FrontierCode 2.0 avec un effort Xhigh. Dans le même tableau, la colonne de comparaison OpenAI est intitulée GPT-6 Astra, la génération précédente, à 65,5 % et 42,8 %.
Ce tableau n’inclut pas GPT-6.2 Astra. La page modèle d’OpenAI ne liste d’ailleurs aucun score de codage de type SWE pour celui-ci. Le compte rendu de lancement de Simon Willison note que « Astra 6.2 n’obtient pas des scores tout à fait aussi élevés que Fable 5.2 sur divers benchmarks » et que certains utilisateurs trouvent son style de communication « parfois déroutant ».
L’interprétation honnête comporte donc trois volets :
- Fable 5.2 a des scores de codage agentique publiés, réalisés par le fournisseur, supérieurs à ceux du dernier Astra.
- Aucun fournisseur n’a publié de comparaison directe en codage avec GPT-6.2 Astra.
- Tous les chiffres ci-dessus ont été produits par le fournisseur du modèle lui-même, sur son propre harnais, aux niveaux d’effort choisis.
Considérez les benchmarks comme un filtre de présélection. Cet article ne contient aucun résultat de test indépendant sur l’un ou l’autre modèle.
Où les factures divergent
Des prix affichés identiques ne signifient pas des factures identiques. Trois mécanismes les séparent.
Succès de cache
Fable 5.2 facture 0,20 $ par million de tokens en cas de succès de cache. Astra facture 0,40 $. Pour un agent qui renvoie 50 fois dans une session un préfixe en cache de 100 000 tokens, ce préfixe coûte 1,00 $ avec Fable et 2,00 $ avec Astra, avant les nouvelles entrées et sorties. Simon Willison qualifie tout de même le prix du cache d’Astra de « bonne nouvelle pour les sessions agentiques plus longues » ; il reste bien en dessous du tarif hors cache de 8 $.
Contexte long
Les tarifs d’Astra augmentent dès qu’une requête dépasse 272 K tokens en entrée. Anthropic indique le contexte complet de 1 M au tarif standard pour Fable. Si vos agents chargent régulièrement la moitié d’un monorepo, modélisez ce seuil avant de vous engager.
Effort et tokens par tâche
Les deux modèles exposent des niveaux d’effort, et un effort plus élevé consomme plus de tokens. Le test SVG informel de Simon montre l’écart sur un seul prompt : GPT-6.2 Astra a coûté 11,55 cents en effort High et 88,71 cents en effort Max. Il s’agit d’un prompt jouet, pas d’un benchmark de codage, mais l’écart de 7× montre pourquoi il faut fixer le niveau d’effort avant de comparer les coûts.
Notre analyse détaillée des tarifs de Fable 5.2 passe en revue les nouvelles tentatives et le temps de relecture ; le guide des limites de débit de GPT-6.2 couvre le plafond de tokens par minute que les agents Astra atteignent en premier.
Comment lancer un test GPT-6.2 Astra vs Fable 5.2 sur votre propre dépôt
Un duel sur votre propre code vaut mieux que n’importe quel tableau publié. La méthode ci-dessous s’appuie sur notre guide plus complet pour évaluer Fable 5.2 sur votre base de code ; ici, elle se déroule comme un duel entre deux modèles.
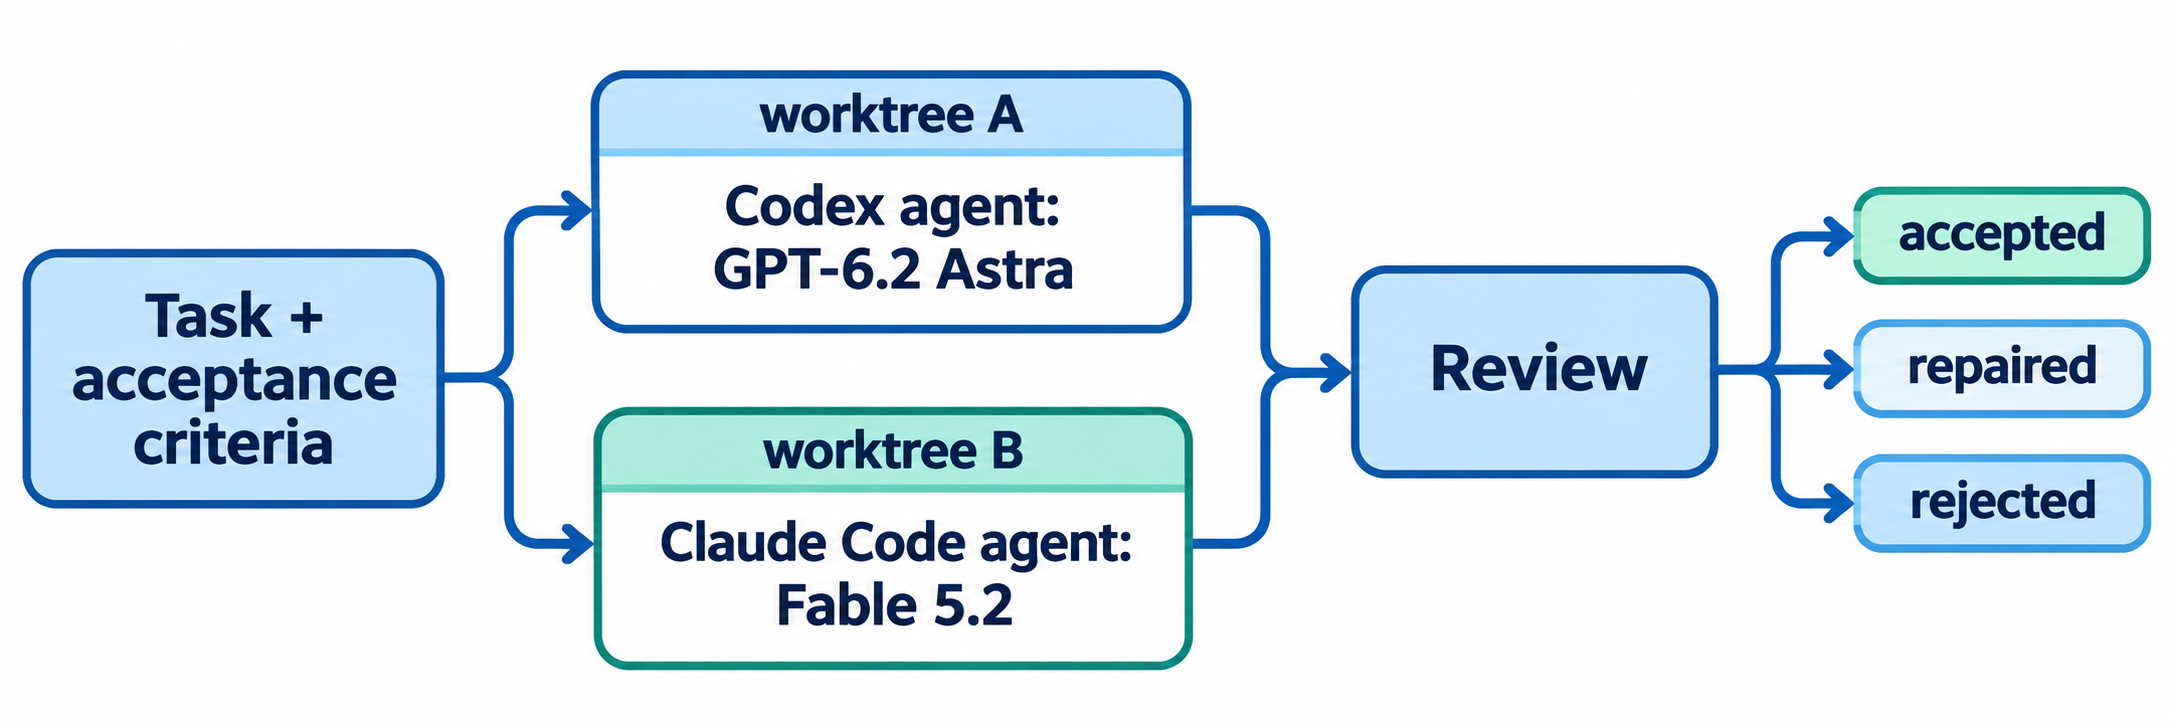
- Choisissez 10 à 12 tâches récentes dans votre backlog : corrections de bugs, petits ajouts, une refactorisation et une investigation.
- Rédigez d’abord les critères d’acceptation, avant que l’un ou l’autre agent ne s’exécute, afin qu’aucun résultat n’influence la barre d’acceptation.
- Figez le harnais. Astra fonctionne mieux dans Codex et Fable dans Claude Code ; vous comparez donc deux workflows complets. Mentionnez-le dans votre compte rendu.
- Figez le niveau d’effort. Choisissez High sur les deux, ou indiquez les réglages exacts utilisés.
- Isolez chaque tentative dans un nouveau worktree git, afin qu’aucun agent n’hérite des modifications de l’autre.
- Exécutez chaque tâche sur les deux modèles, en alternant celui qui passe en premier.
- Faites une revue à l’aveugle lorsque c’est possible, et classez chaque résultat comme accepté, accepté après réparation ou rejeté.
- Divisez la dépense totale par les modifications acceptées, tentatives échouées comprises.
Le coût par modification acceptée est le chiffre décisif. Un modèle 20 % moins cher au token mais qui nécessite un cycle de réparation supplémentaire par tâche est le modèle le plus coûteux pour votre équipe.
Faites tourner les deux modèles comme Agents dans Sharkly
Sharkly fait tourner les agents de codage que vous utilisez déjà ; il ne les remplace pas. Un Agent dans Sharkly est un coéquipier IA configuré qui exécute des Tasks via un Runtime, comme Codex ou Claude Code, sur un Computer que vous connectez.
Configurez le duel avec deux Agents :
- Astra Agent : un Runtime Codex configuré pour
gpt-6.2-astra. - Fable Agent : un Runtime Claude Code configuré pour
claude-fable-5-2.
Chaque Agent a un modèle par défaut, choisi sous Computer, Runtime et Working directory parmi les modèles que son Runtime déclare. Consultez le centre d’aide Sharkly pour les réglages actuels des Agents.
Définissez les mêmes limites d’exécution sur les deux Agents, afin qu’aucun n’obtienne plus d’exécutions parallèles ou un budget de temps plus long que l’autre.

Utilisez le mode Temporary working-directory, afin que chaque Task dispose d’un répertoire isolé et que les exécutions adossées à un dépôt puissent préparer un worktree neuf. Placez les critères d’acceptation dans la description de la Task. Chaque Agent renvoie son patch et ses vérifications à sa propre Task, ce qui garde chaque tentative à côté du verdict du relecteur.
L’utilisation des modèles reste sur vos propres abonnements et clés API. Sharkly ne vend pas de tokens, et le quota de modèles dépend des outils, des offres et des comptes API que votre équipe connecte.
Alternatives à un choix binaire Astra ou Fable
Vous n’êtes pas obligé de couronner un seul modèle.
- Répartissez par type de tâche. Utilisez Fable 5.2 sur les catégories où il gagne dans votre test, Astra sur le reste.
- Confiez le pilotage à l’un et l’exécution à l’autre. Un modèle de pointe planifie et relit ; un modèle moins cher prend en charge les éléments routiniers, le schéma décrit dans GPT-6 Astra comme chef de votre Crew.
- Descendez d’un cran. GPT-6.2 Sol est affiché à 2 $ en entrée et 10 $ en sortie par million de tokens. Pour la maintenance courante, il peut passer votre barre au quart du prix.
- Gardez les deux en service. La neutralité vis-à-vis des fournisseurs est l’objectif : aucun modèle ne reste le meilleur longtemps, comme l’ont soutenu Argon, Astra et Opus.
Cas d’usage concrets
- Migrations longues. Anthropic rapporte qu’une équipe d’agents Fable 5.2 a migré un service de production de Python vers Rust. Testez ce type de travail sur votre propre extrait avant de faire confiance à l’un ou l’autre modèle pour cela.
- Investigations sur de grands dépôts. Dépassez 272 K tokens en entrée et la tarification d’Astra change. Lancez le modèle de coût à votre taille de contexte réelle.
- Files de bugs en parallèle. Dix petites corrections réparties entre les deux Agents vous donnent un taux de modifications acceptées par modèle en une semaine.
Conclusion
GPT-6.2 Astra et Fable 5.2 coûtent le même prix au token sur le papier. Fable affiche de meilleurs scores de codage publiés et des succès de cache moins chers ; Astra a une fenêtre de contexte légèrement plus grande, mais des tarifs plus élevés au-delà de 272 K tokens en entrée. Aucun de ces faits ne vous dit lequel livre le plus de code accepté dans votre dépôt.
Lancez le duel. Connectez un Computer à Sharkly, créez un Agent Codex sur GPT-6.2 Astra et un Agent Claude Code sur Fable 5.2, puis confiez aux deux les mêmes cinq tâches cette semaine. Gardez le modèle qui gagne sur le coût par modification acceptée.
FAQ
GPT-6.2 Astra est-il moins cher que Claude Fable 5.2 ?
Non. Les deux sont affichés à 8 $ par million de tokens en entrée et à 40 $ par million de tokens en sortie. Les succès de cache de Fable sont moins chers (0,20 $ contre 0,40 $), et les tarifs d’Astra augmentent au-delà de 272 K tokens en entrée.
Lequel est meilleur pour le codage, GPT-6.2 Astra ou Fable 5.2 ?
Anthropic rapporte des scores de codage agentique plus élevés pour Fable 5.2 que pour le précédent GPT-6 Astra. Aucun benchmark publié ne compare directement Fable 5.2 à GPT-6.2 Astra ; testez donc les deux sur vos propres tâches.
Quelle est la fenêtre de contexte de GPT-6.2 Astra et Fable 5.2 ?
GPT-6.2 Astra affiche 1 050 000 tokens avec un plafond d’entrée de 922 000 tokens. Fable 5.2 inclut un contexte de 1 M de tokens au tarif standard. Les deux plafonnent la sortie à 128 000 tokens.
Puis-je utiliser GPT-6.2 Astra dans Claude Code ou Fable 5.2 dans Codex ?
Chaque modèle est généralement utilisé dans l’agent de codage de son propre fournisseur : Astra dans Codex, Fable dans Claude Code. Les comparer revient souvent à comparer deux workflows complets, modèle et harnais.
Comment comparer deux modèles de codage équitablement ?
Utilisez les mêmes tâches, des critères d’acceptation rédigés, des niveaux d’effort fixés et des worktrees isolés. Classez les résultats acceptés, réparés et rejetés, puis divisez la dépense totale par les modifications acceptées.
Sharkly choisit-il le modèle pour mon Agent ?
Non. Vous choisissez le modèle par défaut de chaque Agent parmi ceux que son Runtime déclare. Sharkly ne route pas automatiquement les tâches entre les modèles.


