

Demandez à votre agent de codage où une fonction est appelée, et observez ce qui se passe. Il lance un grep, lit trois fichiers, relance un grep avec un autre motif, lit quatre fichiers de plus, et finit par répondre correctement, après avoir rempli son contexte de code source qu'il oubliera dès la fin de la session. Posez une question de suivi, et il recommence tout depuis le début.
codebase-memory-mcp met fin à cette boucle. Avec 41 536 étoiles, une licence MIT et un code écrit en C, c'est l'outil de la vague 2026 dédié aux agents qui offre le meilleur retour pour le moins de changement dans votre façon de travailler. Il donne à un agent une mémoire de votre code. Il ne donne pas à votre équipe une mémoire du travail accompli, et ce sont deux problèmes différents.
En bref
Ceci est l'une des cinq analyses approfondies issues de notre panorama des outils open source qui étendent les agents de codage.
codebase-memory-mcp indexe un dépôt sous forme de graphe de connaissances persistant regroupant fonctions, classes, chaînes d'appels et routes, puis répond aux questions structurelles à partir du graphe plutôt qu'en lançant des greps. Le projet mesure cinq requêtes structurelles à environ 3 400 tokens via le graphe, contre environ 412 000 en lisant fichier par fichier. C'est un binaire natif unique, sans runtime ni clé API, entièrement local, et compatible avec n'importe quel client MCP. Installez-le en premier. Ensuite, décidez séparément où sera conservé l'historique de ce que vos agents ont fait.
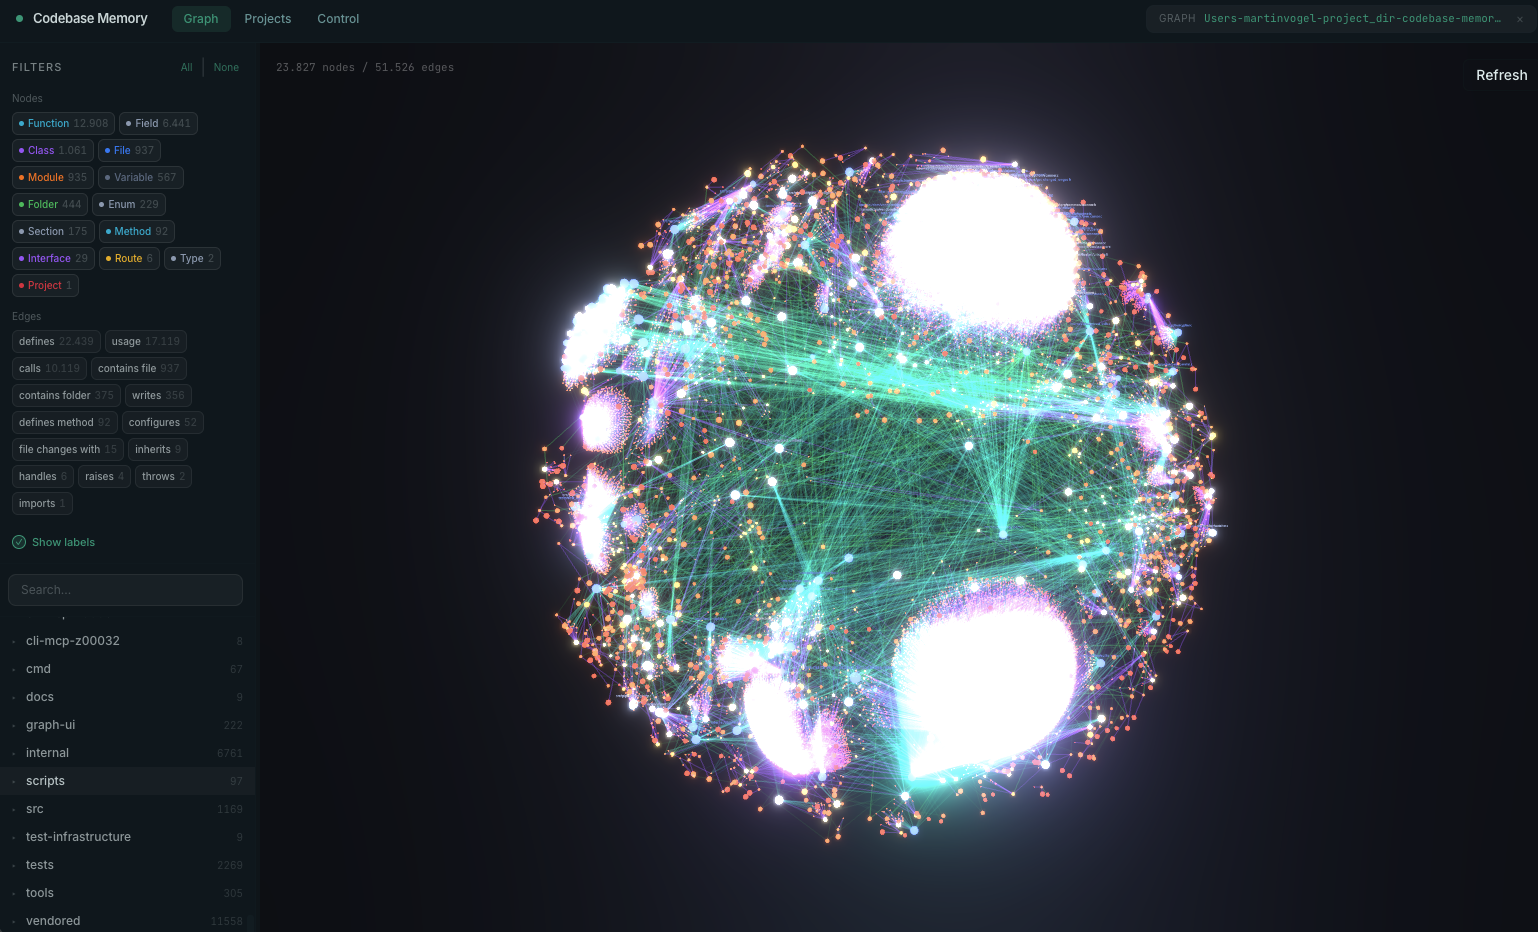
Ce qu'il fait
L'analyse syntaxique s'appuie sur tree-sitter pour plus de 160 langages, avec une résolution sémantique des types ajoutée pour un noyau de langages incluant Python, la famille TypeScript et JavaScript, Go, Java, Rust, C# et C++. Le résultat est exposé via 15 outils MCP couvrant la recherche, le traçage des chaînes d'appels, la vue d'ensemble de l'architecture, l'analyse d'impact, la détection de code mort, les requêtes sur le graphe et la liaison HTTP entre services. Tout client qui parle le Model Context Protocol peut l'utiliser, et le projet recense 45 surfaces d'agents prises en charge.
| Mesure | Valeur rapportée |
|---|---|
| Cinq requêtes structurelles | ~3 400 tokens vs ~412 000 fichier par fichier |
| Comparaison évaluée par les pairs | 10x moins de tokens, 2,1x moins d'appels d'outils, 83 % de qualité de réponse |
| Index du noyau Linux | 28 M de lignes, 75 K fichiers, 3 minutes |
| Latence des requêtes structurelles | Moins de 1 ms |
Lisez ces deux chiffres de tokens ensemble. La réduction de 99 % correspond à cinq requêtes structurelles, soit le meilleur cas pour le graphe. Le chiffre de la prépublication, sur 31 dépôts, est de 10x. Prévoyez 10x et considérez tout ce qui est meilleur comme un bonus.
L'installer
curl -fsSL https://raw.githubusercontent.com/DeusData/codebase-memory-mcp/main/install.sh | bash
Windows dispose d'un installeur PowerShell, et le projet recommande de le lire avant de l'exécuter. L'installeur détecte vos agents de codage et écrit leurs entrées MCP. Redémarrez l'agent et demandez-lui d'indexer le projet.
Deux réglages à appliquer dès le premier jour :
codebase-memory-mcp config set auto_index true
codebase-memory-mcp --ui=true --port=9749
Le visualiseur de graphe est intégré au binaire et constitue une vérification utile pour s'assurer que l'index couvre bien ce que vous attendiez.
Deux réserves que le projet documente lui-même, et qui valent trente secondes chacune. Microsoft Defender peut signaler un binaire de version comme faux positif, le projet précisant que, typiquement, 61 moteurs sur environ 62 le déclarent sain et que la même famille de détections touche le CLI GitHub et la propre chaîne d'outils Go de Microsoft. Et l'outil lit votre base de code et écrit dans vos fichiers de configuration d'agent, ce qui est son rôle, dit sans détour. Lisez le script d'installation avant de le passer à un shell.
Pourquoi commencer par celui-ci
Tout le reste de la vague d'outils actuelle vous demande de changer votre façon de travailler. Les bibliothèques de rôles changent votre façon de formuler vos prompts. Les worktrees parallèles changent votre organisation. L'accès web change ce que vous demandez.
Celui-ci ne change rien et rend chaque session moins coûteuse. Il n'y a aucune habitude à prendre.
L'effet sur la qualité est la moitié sous-estimée. Un agent qui dépense 400 000 tokens à lire des fichiers dispose d'autant moins de marge pour raisonner sur votre problème, et sa mémoire de ce qu'il a lu au début se dégrade au fil d'une longue session. Répondre à partir d'un graphe garde le contexte libre.
Le changement se manifeste dans ce que vous demandez. Les questions que vous évitiez auparavant parce qu'elles coûtaient 50 000 tokens et deux minutes sont désormais quasi gratuites. L'analyse d'impact avant de modifier une signature transforme le « je pense que c'est sans risque » en une liste. Le traçage des chaînes d'appels sur un dépôt inconnu vaut mieux que remonter cinq fichiers en espérant tomber sur le point d'entrée.
La mémoire du code n'est pas la mémoire du travail
Voici la frontière, et elle est nette.
Le graphe est construit à partir de votre code, il sait donc ce qu'est votre code. Il peut vous dire que le helper de retry appelle le client de paiement. Il ne peut pas vous dire pourquoi le backoff a changé en juillet, qui l'a décidé, quelle était l'alternative, ni si quelqu'un l'a relu. Cette histoire existait dans une session de terminal qui a disparu.
Les équipes ressentent cela comme une étrange asymétrie : l'agent a une meilleure mémoire de la base de code que n'importe quel humain de l'équipe, et aucune mémoire des décisions qui l'ont produite.
L'index est également propre à chaque machine. Il réside dans un répertoire de cache sous un seul compte, partagé entre vos sessions locales via un démon de coordination, et il s'arrête aux limites de cette machine.
Où réside l'historique du travail
Une Task est l'unité de travail principale dans Sharkly. Elle porte la demande, le contexte, l'exécution, les blocages et le résultat en un seul endroit partagé, au lieu de les disperser entre prompts privés et sessions de terminal.
Chaque élément a un rôle précis. L'Agent définit comment le travail doit être traité. Le Computer fournit l'hôte et les ressources locales. Le Runtime exécute la session d'agent proprement dite, en utilisant l'outil de codage déjà installé sur place. La Task reste l'historique partagé.
Cette séparation rend le couplage concret. L'index est une ressource locale sur un Computer, donc le Computer qui héberge un dépôt indexé est celui où un graphe chaud existe, plutôt qu'un démarrage à froid de trois minutes. Un Agent est une configuration enregistrée, donc la configuration où votre agent dispose de l'index et des bonnes permissions est réutilisée plutôt que reconstruite machine par machine. Et l'exécution, les blocages, les résultats et les discussions de suivi reviennent dans la timeline de la tâche, là où le raisonnement derrière un changement perdure.
Sharkly ne remplace ni Claude Code, ni Codex, ni codebase-memory-mcp. Il ajoute la couche de tâche partagée, de Computer, de contexte, de contrôle et de revue autour d'eux. L'utilisation des modèles continue via les abonnements ou clés API configurés dans ces outils.
Mémoire du code plus mémoire du travail, voilà la combinaison. L'une donne à un agent la mémoire du dépôt. L'autre donne à une équipe la mémoire de ce que les agents y ont fait.
Quand vous avez besoin de l'une ou de l'autre
Installez codebase-memory-mcp dès maintenant, quelle que soit la taille de votre équipe. C'est local, cela ne demande aucun changement de méthode de travail, et la réduction des coûts profite autant à un développeur seul qu'à vingt.
Ajoutez un système de travail partagé quand le raisonnement doit survivre à la session : quand la revue a lieu avant la mise en production, quand plus d'une personne touche au même dépôt, ou quand quelqu'un demandera dans trois mois pourquoi un changement a été fait. Un graphe répondra à ce que fait le code. Il ne répondra jamais au pourquoi.
Les agents recherchent, exécutent, testent et rendent compte. Les humains fixent la direction, accordent l'autorité et acceptent le résultat.
Questions fréquentes
Fonctionne-t-il avec d'autres agents que Claude Code ? Oui. C'est un serveur MCP, donc n'importe quel client MCP fonctionne, et le projet recense 45 surfaces d'agents prises en charge, dont Cursor, Codex, Windsurf, OpenCode et Aider.
Mon code quitte-t-il ma machine ? Non. Le traitement est entièrement local, et le projet indique qu'il n'effectue aucune requête réseau de sa propre initiative et ne vérifie pas les mises à jour en arrière-plan. Le code source est disponible si vous préférez vérifier plutôt que faire confiance.
La réduction de 99 % des tokens est-elle réaliste ? Ce chiffre correspond à cinq requêtes structurelles, le meilleur cas. Le chiffre évalué par les pairs sur 31 dépôts est de 10x moins de tokens et 2,1x moins d'appels d'outils. Prévoyez 10x.
Quelle taille de dépôt peut-il gérer ? Le cas plafond annoncé est le noyau Linux, avec 28 millions de lignes en trois minutes. Les dépôts applicatifs ordinaires s'indexent en quelques millisecondes.
Est-ce utile quand plusieurs agents tournent en même temps ? Oui, et plus que d'habitude. Cinq agents qui lancent des greps sur le même dépôt, c'est cinq fois le gaspillage. Chaque exécution de Task dispose toujours de son propre worktree isolé, tandis que l'index structurel est partagé sur le Computer.
En résumé
C'est l'outil le moins visible de la vague 2026 et celui au meilleur retour. Un seul binaire natif, aucun changement de méthode de travail, et une réduction d'un ordre de grandeur mesurée sur les tokens qu'un agent dépense à répondre à des questions pour lesquelles il ne devrait pas avoir à lancer de grep. Installez-le, indexez votre projet et ouvrez une fois le visualiseur de graphe pour voir ce qu'il a construit.
Ensuite, soyez clair sur la limite. Il se souvient du dépôt, pas du travail, et les décisions derrière un changement meurent avec la session si rien ne les conserve. Sharkly les conserve : la Task est l'historique partagé, l'exécution tourne sur les Computers que vous connectez via les runtimes que vous payez déjà, et les résultats reviennent là où une personne peut les examiner et les accepter.


