

Jev est un nouveau modèle de TypeSafe AI, et il n'écrit ni code ni texte. Vous lui fournissez un état de programme, vous déclarez les questions auxquelles vous avez besoin de réponses, et il renvoie des réponses typées avec des probabilités calibrées. TypeSafe le qualifie de System One Model. Il a débarqué sur Vercel AI Gateway le 16 septembre 2026, ce qui explique pourquoi il apparaît soudainement dans tous les fils d'actualité.
Pour une équipe qui fait tourner plusieurs agents de codage, l'intérêt n'est pas le modèle en lui-même. C'est la place d'un modèle de décision dans la stack. Vos agents génèrent le travail. Le vrai problème, comme nous l'avons défendu dans pourquoi la revue humaine est le goulot d'étranglement, c'est de décider quoi faire du résultat de cinq exécutions en même temps : laquelle nécessite un humain, laquelle peut être fusionnée, laquelle est bloquée. Jev est conçu exactement pour ce type de question. Cet article explique ce qu'il est, ce qu'il n'est pas, et où il se situe au-dessus de vos agents.
Ce qu'est Jev
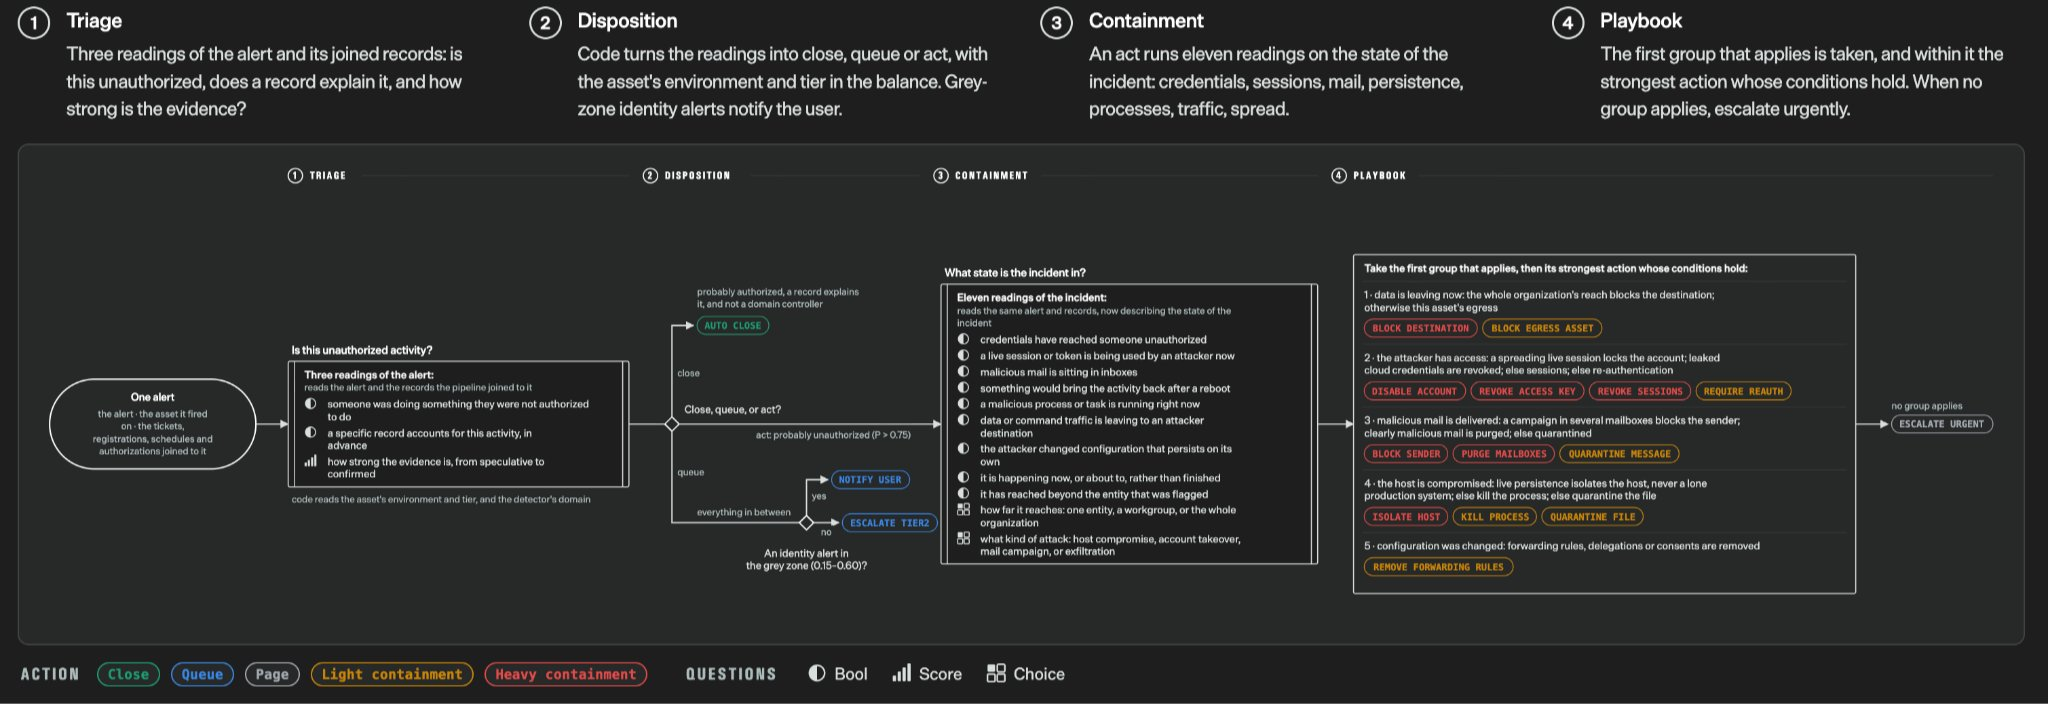
Un System One Model est un modèle qui renvoie des décisions plutôt que du texte. Le billet de lancement de TypeSafe le résume ainsi : « un état non structuré en entrée, des décisions probabilistes typées en sortie ». Trois propriétés comptent.
La forme de la sortie est déclarée avant l'appel. Vous définissez le type de chaque question en amont, et le modèle ne peut répondre qu'à l'intérieur de ce cadre. Il n'y a aucun texte à parser ni aucune incompatibilité de schéma à rattraper.
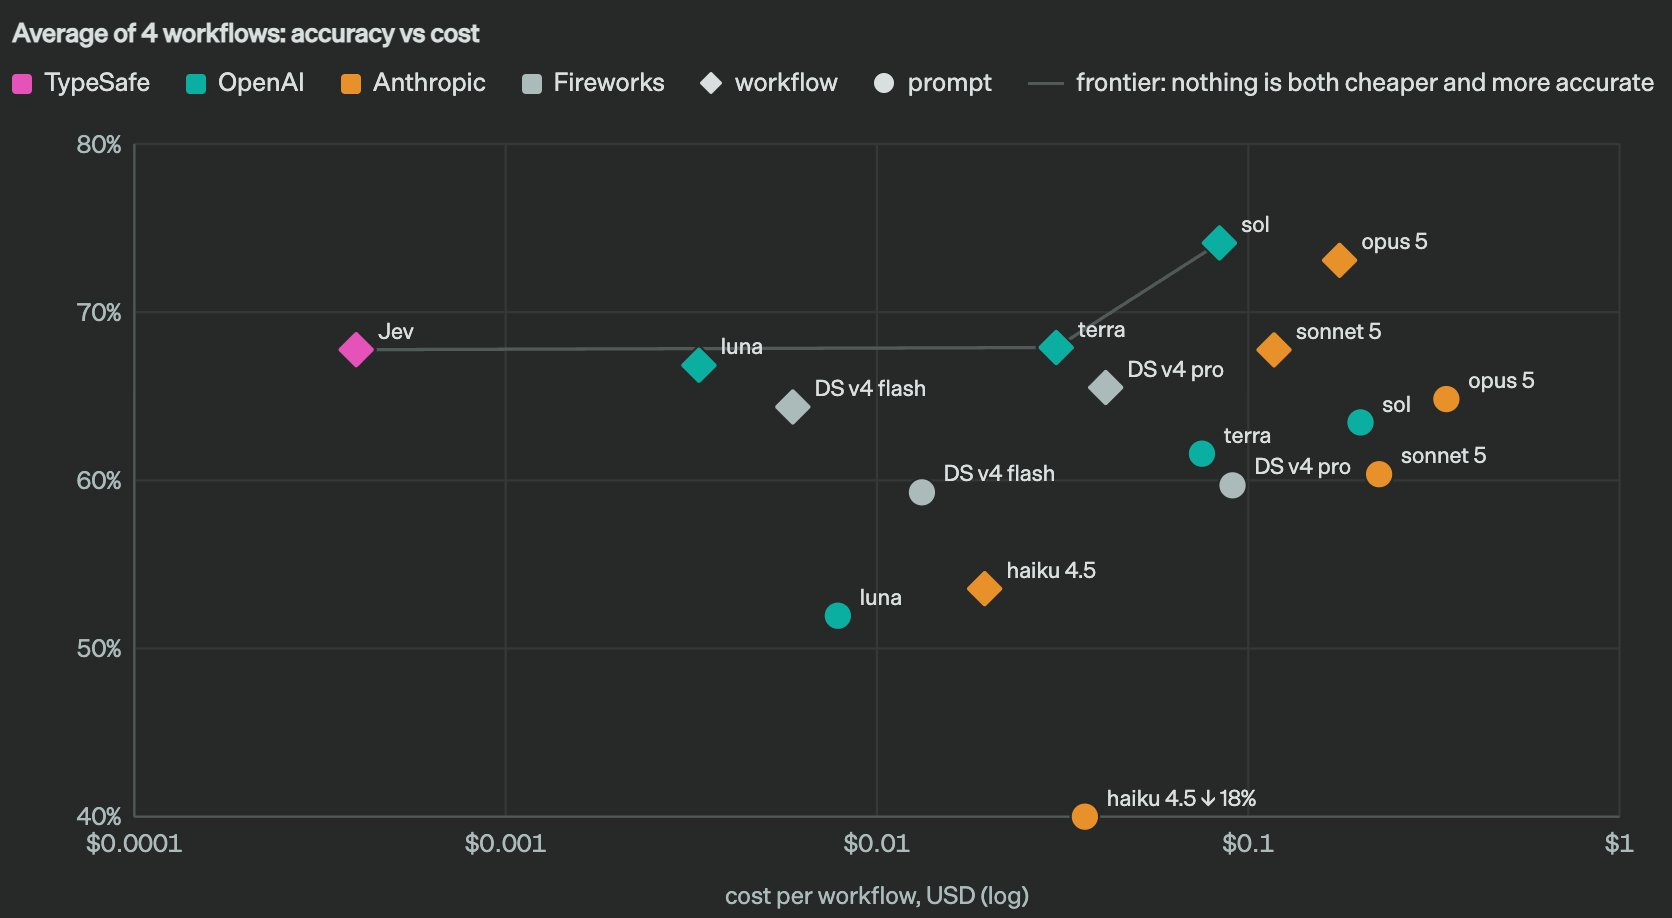
Chaque réponse est accompagnée d'une probabilité. Une question oui/non renvoie 0.97, pas true. Un choix renvoie la distribution complète sur l'ensemble des options. TypeSafe l'a entraîné avec une méthode qu'il appelle Reinforcement Learning for Calibrated Decisions, et l'affirmation est qu'une confiance plus élevée signifie une précision plus élevée, ce qui vous permet de fixer un seuil : automatiser au-dessus, envoyer le reste à une personne.
Toutes les questions reçoivent une réponse en parallèle, en une seule requête. C'est pourquoi TypeSafe annonce des temps de bout en bout de 70 ms à 500 ms. Ce sont les chiffres du fournisseur, pas un benchmark indépendant, mais l'architecture les explique : rien n'est généré token par token.
Les trois types de questions
L'API de Jev expose trois primitives. Chacune est un objet JSON sous une clé que vous choisissez, toutes évaluées par rapport au même state.
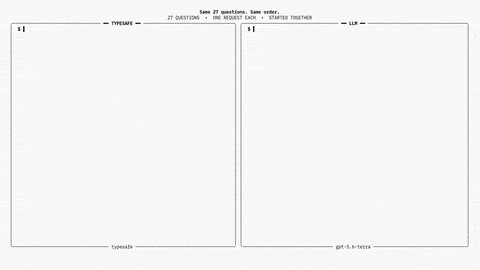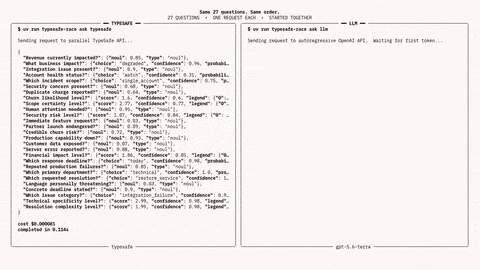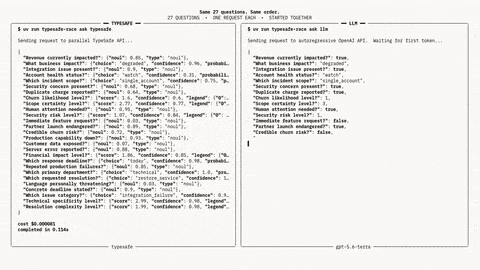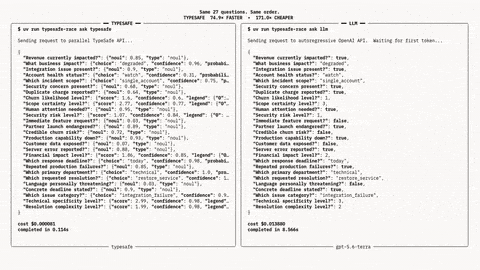
Noul est une probabilité oui/non. {"type": "noul", "instructions": "Does this run need a human before merge?"} renvoie {"noul": 0.91}. Vous appliquez le seuil dans le code.
Choice sélectionne une option parmi un ensemble nommé pouvant aller jusqu'à 255. Vous passez un criteria qui associe les noms d'options à des descriptions, et la réponse contient le choix, la distribution complète et un indice de confiance.
Score positionne l'état sur une grille ordonnée de 2 à 10 niveaux. La réponse est une position pondérée par les probabilités, ce qui permet à un bug d'obtenir un score de 1.3 entre « un contournement existe » et « bloquant ».
Via le Vercel AI SDK, le type oui/non s'appelle boolean et le champ probability ; sur le point de terminaison propre à TypeSafe, c'est noul. Même idée, clé différente.
Où se situe un modèle de décision au-dessus de vos agents
Voici le modèle mental que nous utilisons. Les modèles produisent des tokens. Les agents de codage (Claude Code, Codex, Gemini CLI, OpenCode) transforment les tokens en modifications sur un Computer. La couche de gestion décide qui travaille sur quoi et ce qu'il advient du résultat. Jev appartient à cette couche supérieure, pas à celle du milieu. Ce n'est pas un agent et il ne peut pas modifier un fichier. C'est une réponse rapide et typée à une question de gestion.
Trois questions reviennent sur chaque tableau qui fait tourner des agents en parallèle, et chacune correspond à une primitive de Jev.
Quel Assignee devrait prendre cette Task ? Un Choice sur vos Agents, avec un criteria décrivant les points forts de chacun. L'état, c'est le titre de la Task, sa description et le dépôt lié. C'est l'étape de triage que nous avons décrite dans gestion et triage du backlog par IA, réalisée en un seul appel de 100 ms au lieu d'une personne qui lit quarante tickets.
Cette exécution nécessite-t-elle un humain avant sa fusion ? Un Noul sur le résumé du diff de l'exécution, les résultats de tests et les chemins touchés. Au-dessus de 0.85, on la retient pour revue ; en dessous de 0.15, on laisse le point de contrôle d'approbation la laisser passer ; entre les deux, on la signale. L'objectif n'est pas de supprimer le relecteur. C'est de faire en sorte que son après-midi soit consacré aux exécutions qui en ont besoin.
Quel est le risque de ce changement ? Un Score allant de « cosmétique » à « touche à l'authentification ou aux paiements », appliqué au même état. Ce chiffre trie la file de revue, ce qui constitue l'essentiel de ce à quoi sert le suivi du travail réalisé par les agents de codage.
La communauté est arrivée là avant nous. Dans la semaine suivant le lancement, des développeurs ont publié un workflow de revue de code par étapes bâti sur Jev, un plugin Claude Code qui remplace les résumés de compaction par des décisions Jev sur les appels d'outils à conserver, et un « chef d'usine logicielle » qui route le travail avec lui. Chacun d'eux est une couche de décision au-dessus d'un agent, et c'est ce schéma qui compte.
Une règle de décision honnête
Utilisez Jev quand la question a un ensemble fixe de réponses et que vous avez besoin d'une probabilité associée : routage, gravité, « nécessite une revue », « est bloqué », « cette description de PR est-elle honnête ». Ce sont les questions qu'un tableau se pose cent fois par jour.
N'utilisez pas Jev quand la question exige un jugement qui n'est pas dans l'état. « Est-ce la bonne architecture » n'est pas un Choice. « Le client va-t-il accepter ceci » n'est pas un Score. Une probabilité sur ces questions, c'est un chiffre qui ressemble à une décision. Gardez une personne, ou un modèle de langage capable d'expliquer son raisonnement, de ce côté de la ligne.
Et ne laissez pas une probabilité remplacer le point de contrôle de revue. Un 0.96 sur « peut être fusionné sans risque » est un signal fort pour placer l'exécution en haut de la file d'un humain, pas une raison de se passer de l'humain. La limite que trace Sharkly, c'est que l'automatisation s'arrête là où le jugement de l'équipe est requis, et un modèle de décision ne déplace pas cette ligne. Il rend la file du côté humain plus courte et mieux ordonnée.
Comment l'appeler
En direct : POST https://api.typesafe.ai/v1/systemone avec une clé Bearer provenant de console.typesafe.ai, modèle jev-latest (actuellement jev-1.13.0). Via Vercel AI Gateway : modèle typesafe-ai/jev via experimental_evaluate dans AI SDK 7, et notez que la documentation du Gateway indique que l'évaluation n'est disponible que via le AI SDK, pas via les points de terminaison compatibles OpenAI.
Un appel de triage qui répond aux trois questions d'un coup :
{
  "model": "jev-latest",
  "state": { "task": "Fix double charge on retry", "diff_summary": "touches billing/retry.ts, adds idempotency key", "tests": "42 passed" },
  "questions": {
    "assignee": { "type": "choice", "instructions": "Which Agent should take this?",
      "criteria": { "codex": "backend and payments", "claude_code": "refactors and tests", "gemini_cli": "frontend" } },
    "needs_review": { "type": "noul", "instructions": "Does this change need a human before merge?" },
    "risk": { "type": "score", "instructions": "How risky is this change?",
      "criteria": ["cosmetic", "logic change with tests", "touches auth, billing, or data"] }
  }
}
Tarification selon la page des modèles de TypeSafe : 0,042 $ par million de tokens en entrée, sortie non facturée, 64k tokens par requête dont 32k pour l'état, texte uniquement. À ce prix, l'appel de triage ci-dessus coûte une fraction de centime, ce qui rend envisageable de l'exécuter sur chaque Task et chaque exécution.
Quel est le rapport avec Sharkly
Sharkly n'appelle pas Jev à votre place, et ce n'est pas un modèle de décision. C'est la couche partagée de tâches, de Computers, de contexte et de revue autour des agents que vous faites déjà tourner. Ce qu'un modèle comme Jev vous apporte, c'est un moyen peu coûteux et typé de prendre les décisions de routage et de revue que cette couche fait remonter : quel Assignee, quelle file, quel degré d'urgence. Branchez-le dans une Automation qui crée une Task et choisit l'Agent, ou exécutez-le sur la sortie d'une exécution terminée avant que le résultat n'atteigne un relecteur. Dans les deux cas, la décision atterrit à un endroit où une personne peut la voir, et c'est la partie qui doit rester vraie quoi que dise la probabilité.
Si vous faites tourner plus d'un agent et que c'est la file de revue qui vous fait mal, bien démarrer avec Sharkly couvre le tableau, les Computers et le flux de revue dans lesquels un modèle de décision vient s'intégrer.
FAQ
Jev est-il un agent de codage ?
Non. Il ne peut ni générer de code ni modifier un fichier. Il répond à des questions déclarées sur l'état que vous lui fournissez, avec une probabilité. Les agents produisent le travail ; Jev aide à décider quoi en faire.
Peut-il remplacer la revue de code ?
Non, et il ne le devrait pas. Il peut ordonner la file de revue et en extraire les cas évidents. La décision de fusionner reste à une personne, et c'est la limite dont dépend tout ce workflow.
Que signifie « calibré » ?
Si Jev dit 0.9, il devrait avoir raison environ 90 % du temps sur ce type de question. Testez-le sur vos propres exécutions avant de faire confiance à un seuil : quelques dizaines de diffs étiquetés suffisent pour voir si le chiffre veut dire ce qu'il prétend.
Ai-je besoin de Vercel pour l'utiliser ?
Non. L'API directe fonctionne avec une clé Bearer. Le Gateway est une commodité si vous utilisez déjà le AI SDK.


