
Le web scraping gratuit pour les agents IA tourne désormais sur votre propre matériel. Firecrawl Local, c'est un seul binaire Rust qui scrape, crawle et mappe des sites vers du markdown, s'intègre à Claude Code, Codex, Cursor ou Gemini CLI en tant que serveur MCP, et répond à l'API Firecrawl v2 sur localhost. Définissez FIRECRAWL_CLOUD=off et plus aucune page, requête ou URL ne quitte la machine.
En bref
- Installation :
cargo install firecrawl-local(Rust et un compilateur C). Notre compilation a pris 5 minutes et 55 secondes et a produit un binaire de 19 Mo. - Intégration :
firecrawl-local initajoute le serveur MCP à tous les outils d'agents pris en charge qu'il détecte. - Coût : 0 $ pour le scrape, le crawl, le map et le batch scrape. La recherche, les pages bloquées et les fournisseurs de données Alexandria passent par Firecrawl Cloud, sauf si vous désactivez ce recours.
- Interrupteur de confidentialité :
FIRECRAWL_CLOUD=offgarde tout en local. - Déploiement en équipe : installez-le une fois par Computer sur lequel tournent vos agents, et tous les agents de ce Computer disposent du même scraper.
Qu'est-ce que Firecrawl Local ?
Firecrawl Local est un binaire unique signé par l'équipe Firecrawl : il récupère des pages web, les nettoie pour en tirer un markdown propre et renvoie le même JSON que l'API Firecrawl hébergée. Il ne nécessite ni base de données, ni file d'attente, ni conteneur. Firecrawl l'a annoncé le 18 novembre 2026, et le crate sur crates.io est paru une semaine plus tôt, en version 0.1.0.
Le README décrit trois façons de l'utiliser : une CLI, un serveur MCP pour les agents, et une copie locale de l'API v2. Le code de nettoyage est compilé depuis les mêmes sources que celles utilisées par l'API hébergée : une page markdown obtenue sur votre portable est donc identique à ce que renverrait le cloud pour une page accessible aux deux.
Le post d'annonce de Firecrawl revendique une primitive de scrape 37 fois plus rapide que Firecrawl auto-hébergé et 230 fois moins gourmande en mémoire, à 11 Mo au repos. Ce sont les chiffres de Firecrawl ; le README ne publie aucune méthode. Nous avons mesuré nous-mêmes la partie mémoire, plus bas.
Si vous faites déjà tourner plusieurs agents de code, c'est le premier scraper que vous pouvez confier à tous sans facture à l'appel. La suite de ce guide couvre l'installation, l'interrupteur de confidentialité, et la manière de donner le même outil à toute une équipe d'agents sur Sharkly.
Pourquoi les agents ont besoin d'un scraper local
Un agent incapable de lire le web travaille sur des données d'entraînement périmées. Il devine le comportement d'une API qu'il n'a jamais vue, ou il vous demande de coller la doc dans le chat.
Les API de scraping hébergées règlent ce problème, mais elles ajoutent deux coûts. Chaque page est un appel facturé : crawler un site de documentation de 400 pages devient une ligne sur une facture. Et chaque URL ouverte par votre agent transite par les serveurs de quelqu'un d'autre, ce qui compte quand l'agent étudie le domaine d'un client ou une page concurrente non publiée.
Un scraper local supprime les deux. Les pages sont récupérées depuis votre propre réseau et nettoyées sur votre propre CPU. En contrepartie, c'est vous qui gérez l'installation et les limites propres à un portable.
Installer Firecrawl Local
Il vous faut Rust et un compilateur C. Sur macOS, xcode-select --install fournit le compilateur ; sur Debian ou Ubuntu, installez build-essential. Récupérez Rust via rustup.
cargo install firecrawl-local
firecrawl-local --version
# firecrawl-local 0.1.0
Deux compléments sont facultatifs. Chrome ou Chromium lui permet de rendre les pages qui ont besoin de JavaScript ; sans lui, les pages statiques fonctionnent toujours et une page très chargée en scripts revient avec un avertissement. Node.js 22 ou plus récent est nécessaire pour le serveur MCP, car firecrawl-local mcp exécute le paquet npm firecrawl-mcp via npx.
Scraper, crawler et mapper depuis la CLI
Trois commandes couvrent l'essentiel du travail des agents.
# One page as markdown
firecrawl-local scrape https://example.com --markdown

# Up to 50 pages, one markdown file each
firecrawl-local crawl https://docs.firecrawl.dev --limit 50 --out ./pages

# Every URL a site exposes
firecrawl-local map https://firecrawl.dev
Nous avons exécuté chacune d'elles le 19 novembre 2026, avec le cloud désactivé. Un scrape unique de example.com a pris 1,6 seconde. Un crawl de 10 pages de la doc de Firecrawl a pris 4,2 secondes et écrit 144 Ko de markdown. map a renvoyé la liste des URL de la doc en 3,9 secondes.
| Commande | Options utiles |
|---|---|
scrape |
--markdown, --format markdown,links, --full-page, --timeout |
crawl |
--limit (100 par défaut), --max-depth, --include, --exclude, --out |
map |
--search, --limit |
| Toute commande | --browser auto|never|always |
Un piège rencontré lors de notre test : sur un réseau qui n'accède au web que via un proxy, le premier scrape a échoué avec une erreur TLS. Définir HTTPS_PROXY a réglé le problème : le binaire respecte les variables de proxy standard.
Le brancher sur votre agent IA via MCP
MCP (Model Context Protocol) est le standard par lequel un outil d'agent charge des outils externes. Firecrawl Local s'enregistre comme tel.
firecrawl-local init --dry-run   # show what would change
firecrawl-local init             # write it, backing up each config first
Le dry run sur notre Mac a listé cinq cibles : Claude Code dans ~/.claude.json, Claude Desktop, Cursor dans ~/.cursor/mcp.json, Gemini CLI dans ~/.gemini/settings.json, et Codex dans ~/.codex/config.toml. Windsurf est aussi pris en charge lorsqu'il est installé. Redémarrez chaque outil après init pour qu'il charge le serveur. Utilisez --agent cursor pour ne configurer qu'un seul outil.
Pour l'ajouter à la main, enregistrez le binaire comme serveur stdio :
{
  "mcpServers": {
    "firecrawl": {
      "command": "/Users/you/.cargo/bin/firecrawl-local",
      "args": ["mcp", "--public-only"]
    }
  }
}
L'agent dispose des outils MCP Firecrawl standard. Scrape, crawl, map et batch scrape s'exécutent en local ; le reste part vers Firecrawl Cloud. L'option --public-only est de notre cru, expliquée dans la section sécurité ci-dessous.
Garder le cloud désactivé pour la confidentialité
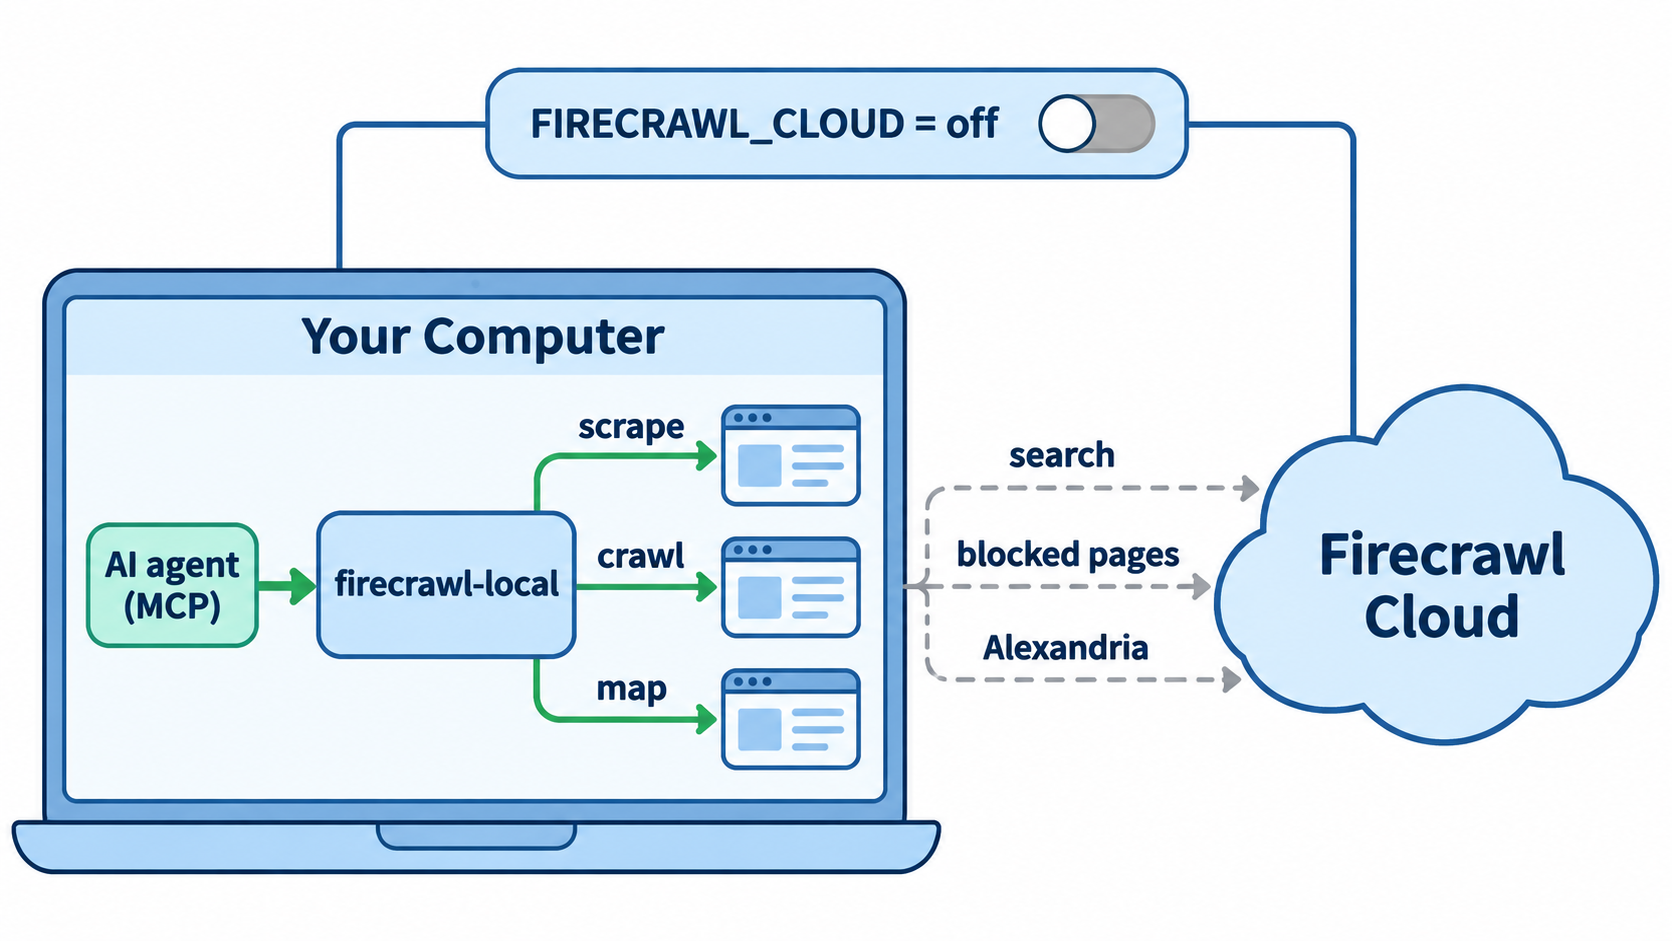
Trois tâches nécessitent Firecrawl Cloud, car un portable n'a ni index de recherche ni moyen de contourner un site qui le bloque.
| Envoyé à Firecrawl Cloud | Pourquoi | Compte |
|---|---|---|
| Requêtes de recherche | Aucun index de recherche local | Non ; la recherche sans clé est limitée en débit |
| URL d'une page qui vous a bloqué | Le cloud la récupère pour vous | Non |
| Fournisseurs de données Alexandria | Les fournisseurs tournent dans le cloud | Oui, un compte gratuit via firecrawl-local login |
| Un identifiant d'installation aléatoire et le nom de votre outil | Comptage des installations | Non |
La variable FIRECRAWL_CLOUD contrôle ce transfert. auto (la valeur par défaut) autorise tout ce qui précède. search n'envoie que les requêtes de recherche. off n'envoie rien, et une valeur non reconnue est également traitée comme off. Une page récupérée via le cloud est marquée "source": "firecrawl-cloud", ce qui vous permet d'auditer ce qui est sorti.
Pour un travail d'agent sur des sites clients ou de la recherche interne, commencez par off. Votre agent perd la recherche web : associez-le donc à l'outil de recherche auquel vous faites déjà confiance.
Faire tourner l'API Firecrawl en local
firecrawl-local serve répond à l'API Firecrawl v2 sur le port 3002, sans clé d'API pour les routes locales. Le code SDK existant bascule en changeant une seule URL.
from firecrawl import Firecrawl

app = Firecrawl(api_url="http://localhost:3002")
print(app.scrape("https://example.com").markdown)
Les routes locales sont POST /v2/scrape, POST /v2/map, le crawl et le batch scrape avec leurs endpoints de statut et d'annulation, ainsi que GET /health. Les autres routes /v2 comme /v2/search sont relayées vers le cloud ; v0 et v1 ne sont pas servies.
Nous avons mesuré la mémoire pendant l'exécution : le processus serve occupait 10 Mo résidents au repos et 16 Mo après un scrape. C'est proche des 11 Mo annoncés par Firecrawl. Un scrape via l'API a renvoyé "creditsUsed": 0 et "engine": "local-fetch".
Des réglages de sécurité par défaut qui comptent pour les agents
Un agent qui lit une page contenant des instructions cachées peut être amené à récupérer une URL interne. OWASP classe ce type d'attaque parmi les injections de prompt, et un scraper en est le chemin évident.
serveécoute sur127.0.0.1et refuse localhost ainsi que les adresses privées, sauf si vous passez--allow-private. Nous lui avons demandé de scraper127.0.0.1:22et avons obtenuBLOCKED_TARGET.- Écouter sur un autre hôte avec
--hostexige--token. - Les adresses link-local et de métadonnées cloud sont bloquées dans tous les modes, y compris après redirection.
scrape,crawletmcppeuvent atteindre votre réseau privé par défaut, car ils tournent pour la personne devant le clavier. Ajoutez--public-onlyquand un agent navigue sur des sites auxquels vous ne faites pas confiance.- Les crawls lisent
robots.txt(le standard RFC 9309), et les propriétaires de sites peuvent s'adresser au crawler sous le nomFirecrawlLocal.
Limites à anticiper
- Pas de formats
jsonousummary, ni d'actionsde navigateur en local. Notre requêtesummarya renvoyé des métadonnées plus un avertissement indiquant que le format avait été ignoré. - Les captures d'écran nécessitent Chrome.
- Les jobs de crawl et de batch vivent en mémoire, expirent une heure après leur démarrage et s'arrêtent avec
serve. - Licence : le dépôt est sous AGPL-3.0. Vérifiez avec votre service juridique avant de livrer une copie modifiée au sein d'un produit hébergé.
Pour les files d'attente, les workers et tous les formats, le guide d'auto-hébergement de Firecrawl couvre le serveur complet.
Donner le même scraper à tous les agents de l'équipe
Un développeur avec un seul agent peut s'arrêter là. Une équipe qui fait tourner plusieurs agents rencontre un autre problème : les outils de chaque agent vivent dans la configuration de la machine sur laquelle il tourne, et personne ne sait quel agent peut lire le web.
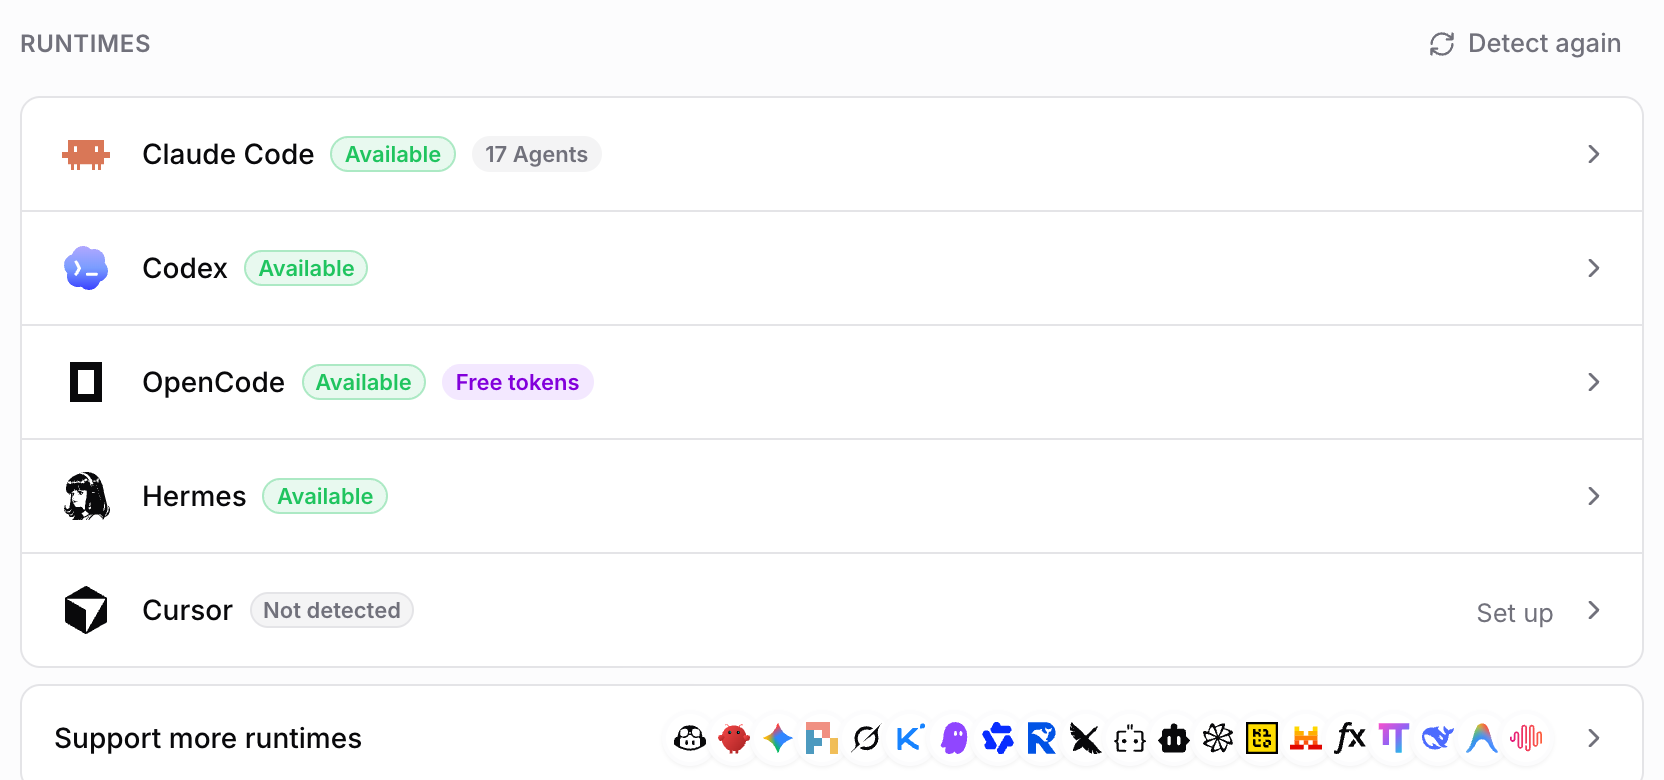
Dans Sharkly, un Agent tourne sur un Computer (un portable, un serveur ou un conteneur que vous connectez) via un Runtime, c'est-à-dire l'outil d'agent installé sur ce Computer, comme Claude Code ou Codex. Vous installez les outils sur le Computer exactement comme pour un usage direct. Les réglages Tools, Knowledge & MCP de l'Agent listent ensuite les serveurs MCP qu'il hérite de Claude Code sur ce Computer, y compris les serveurs stdio de configuration utilisateur, la portée dans laquelle init écrit.
La marche à suivre est donc la suivante : installez Firecrawl Local sur le Computer, lancez init, ouvrez les réglages de l'Agent et cliquez sur Check. Nous avons confirmé que le panneau liste bien les serveurs stdio de configuration utilisateur ; nous n'avons pas encore lancé de scrape Firecrawl dans une Task Sharkly, donc testez d'abord une Task en lecture seule.
Placez le scraper sur un Computer toujours allumé
Un portable s'endort. Un petit serveur Linux enregistré comme Computer (sharkly computer register avec un jeton d'installation sit_, comme expliqué dans la doc Computers) reste allumé : tous les Agents pointés dessus partagent alors un seul scraper et une seule politique FIRECRAWL_CLOUD. Définissez la variable dans l'environnement du Runtime de l'Agent, pour que la politique suive l'Agent et non la dernière personne connectée.
À partir de là, la recherche devient du travail assignable. Un chef de Crew découpe « mapper la doc de ces cinq éditeurs » en Tasks, chaque Agent crawle sa part en local, et les résultats arrivent sur le tableau pour relecture humaine. Sharkly est gratuit pour les organisations de 5 personnes maximum aujourd'hui, et les Agents comme les Computers ne consomment aucun siège ; les modèles restent sur vos propres abonnements.
Cas d'usage concrets
- Ingestion de doc : crawlez la documentation d'une bibliothèque en markdown avant qu'un agent ne mette à jour une dépendance.
- Recherche de prospects : associez le scraping local aux fournisseurs Alexandria, comme dans notre tutoriel sur les agents de création de listes de prospects.
- Veille sur les changelogs : une Task planifiée mappe chaque jour le site d'un éditeur et signale les nouvelles URL.
- Recherche confidentielle : scrapez des pages clients ou de pré-lancement avec le cloud désactivé, pour que rien ne sorte de votre réseau. Notre article sur pourquoi désactiver la recherche web ne suffit pas à empêcher les fuites de données des agents IA passe en revue les autres portes de sortie.
Conclusion
Firecrawl Local transforme le web scraping gratuit pour agents IA en une compilation de six minutes et une commande init. Gardez FIRECRAWL_CLOUD=off pour le travail confidentiel, ajoutez --public-only pour les sites non fiables, et considérez les promesses de vitesse comme celles de Firecrawl tant que vous ne les avez pas mesurées vous-même.
Votre prochaine étape : l'installer sur le Computer que vos agents utilisent déjà, puis connecter ce Computer à Sharkly pour que chaque Agent de l'équipe dispose du même scraper et des mêmes règles. Pour d'autres installations à 0 $, voir des agents IA gratuits pour les équipes.
FAQ
Firecrawl Local est-il gratuit ? Oui. Scrape, crawl, map et batch scrape tournent en local sans clé d'API, et notre scrape de test a rapporté 0 crédit utilisé. La recherche et Alexandria passent par Firecrawl Cloud.
Firecrawl Local a-t-il besoin de Docker ? Non. C'est un binaire unique, sans base de données, file d'attente ni conteneur. Docker n'est qu'une option, et le rendu JavaScript dans un conteneur exige un profil seccomp autorisant le sandbox de Chrome.
Quels agents firecrawl-local init prend-il en charge ? Claude Code, Claude Desktop, Cursor, Windsurf, Gemini CLI et Codex. Tout autre client MCP peut enregistrer firecrawl-local mcp comme serveur stdio.
Puis-je garder tout le scraping hors des serveurs de Firecrawl ? Oui. Définissez FIRECRAWL_CLOUD=off. Vous perdez la recherche, le repli sur les pages bloquées et Alexandria.
Firecrawl Local est-il plus rapide que Firecrawl auto-hébergé ? Firecrawl annonce 37 fois plus rapide et 230 fois moins de mémoire. Nous avons mesuré 10 Mo de mémoire au repos, ce qui correspond à l'annonce sur la mémoire ; nous n'avons pas comparé la vitesse à celle d'un serveur auto-hébergé.
Firecrawl Local est-il open source ? Le dépôt est sous licence AGPL-3.0. Lisez la licence avant de livrer une copie modifiée dans le cadre d'un service hébergé.


