
Le coût par tâche de Gemini 4 Neon dépend de bien plus que son prix de 3 $ / 15 $ par million de tokens. Google affirme que Neon, à son niveau de réflexion par défaut high, coûte 32 % moins cher par tâche que Gemini 4 Carbon. Par token, Neon coûte 50 % plus cher que le tarif d'introduction de Carbon et 25 % moins cher que le tarif de Carbon à partir du 1er décembre 2026. Lequel des deux sera le plus économique pour vos agents dépend du nombre de tokens par tâche et du nombre de tentatives que votre équipe accepte.
TL;DR
- Tarif officiel de Neon : 3 $ par million de tokens d'entrée, 15 $ par million de tokens de sortie (réflexion incluse), 0,15 $ par million de tokens d'entrée en cache. Tier payant uniquement.
- Tarif officiel de Carbon : 2 $ / 10 $ jusqu'au 30 novembre 2026, puis 4 $ / 20 $ à partir du 1er décembre.
- L'affirmation de Google : un coût par tâche 32 % inférieur à celui de Carbon en
high, issu d'un graphique de l'Artificial Analysis Intelligence Index. L'article ne précise pas quel tarif de Carbon le graphique a utilisé. - Ce que cela signifie : Neon ne bat le tarif d'introduction de Carbon que s'il termine la même tâche en consommant moins de deux tiers des tokens de Carbon. À partir du 1er décembre, il gagne, sauf s'il consomme un tiers de tokens de plus que Carbon.
- Ce qu'il faut mesurer : le coût par changement accepté, et non le coût par tentative.
La tarification de Gemini 4 Neon face à Carbon et Hydrogen
Gemini 4 Neon est le modèle intermédiaire de la famille Gemini 4 de Google, publié le 18 novembre 2026 sous le nom de gemini-4-neon. La fiche technique du modèle le décrit comme dérivé de Carbon et conçu pour équilibrer « profondeur et efficacité ». Voici les tarifs standards du tier payant par million de tokens, d'après la page de tarification de l'API Gemini :
| Modèle | Entrée | Sortie (réflexion incluse) | Entrée en cache | Entrée / sortie en batch | Tier gratuit |
|---|---|---|---|---|---|
| Gemini 4 Neon | 3,00 $ | 15,00 $ | 0,15 $ | 1,50 $ / 7,50 $ | Non |
| Gemini 4 Carbon, jusqu'au 30 nov. | 2,00 $ | 10,00 $ | 0,10 $ | 1,00 $ / 5,00 $ | Non |
| Gemini 4 Carbon, à partir du 1er déc. | 4,00 $ | 20,00 $ | 0,20 $ | 2,00 $ / 10,00 $ | Non |
| Gemini 4 Hydrogen (tier payant) | 1,50 $ | 7,50 $ | 0,075 $ | 0,75 $ / 3,75 $ | Oui |
Les trois modèles utilisent uniquement le caching implicite. Le guide AI Studio de Neon indique que le caching implicite s'applique aux prompts d'au moins 4 096 tokens et offre une remise de 95 % sur l'entrée en cache. Neon n'a pas de caching explicite : pensez donc à supprimer tout champ cached_content lors de la migration d'une configuration Carbon.
Google facture « chaque token que le modèle traite, y compris les tokens de réflexion, les instructions système de grounding interne et les déclarations de fonctions ». Pour un agent qui fait beaucoup d'appels d'outils, ces déclarations s'accumulent à chaque tour.
Comment Google mesure le coût par tâche de Neon
Le coût par tâche correspond à la dépense totale nécessaire pour qu'un modèle termine une tâche de benchmark : les tokens utilisés multipliés par son prix. L'annonce de lancement de Google indique qu'en high, Neon « associe un score élevé à l'Artificial Analysis Intelligence Index à un coût par tâche 32 % inférieur à celui de Carbon ». Le graphique est intitulé « AA Index v5.01 cost per task ».
Artificial Analysis est un acteur tiers, et non Google. L'article avance deux autres affirmations de coût, et aucune ne concerne Carbon :
- Neon fonctionne avec « un coût par tâche environ 50 % à 80 % inférieur à celui des meilleurs modèles frontière concurrents », sans que ces concurrents ne soient nommés.
- En
xhigh, Neon coûte toujours « 36 %+ moins cher par tâche que les modèles concurrents réglés à leur niveau maximum ».
L'article ne publie ni le nombre de tokens, ni le tarif de Carbon qui se cache derrière ces 32 %. Ce manque d'information compte plus que d'habitude, car le prix de Carbon double moins de deux semaines après le lancement de Neon.
Gemini 4 Neon est-il moins cher que Carbon ? Cela dépend de la date
Par token, Neon se situe entre les deux tarifs de Carbon : 1,5 fois le tarif d'introduction et 0,75 fois le tarif de décembre. Ces 32 % ne peuvent donc venir que d'une consommation moindre de tokens par tâche. Testons l'affirmation dans les deux cas :
| Si le graphique de Google tarifait Carbon à | Tokens de Neon implicites vs Carbon | Neon vs Carbon jusqu'au 30 nov. | Neon vs Carbon à partir du 1er déc. |
|---|---|---|---|
| 2 $ / 10 $ (introduction) | environ 45 % | 32 % moins cher | environ 66 % moins cher |
| 4 $ / 20 $ (décembre) | environ 91 % | environ 36 % plus cher | 32 % moins cher |
Les deux lignes supposent que les deux modèles répartissent les tokens d'entrée et de sortie dans le même ratio, ce qui est une simplification. Quoi qu'il en soit, à partir du 1er décembre, Neon est moins cher par tâche selon les propres chiffres de Google. Jusqu'au 30 novembre, la réponse dépend d'un détail que Google n'a pas publié.
Ce que coûte une tâche d'agent au tarif officiel
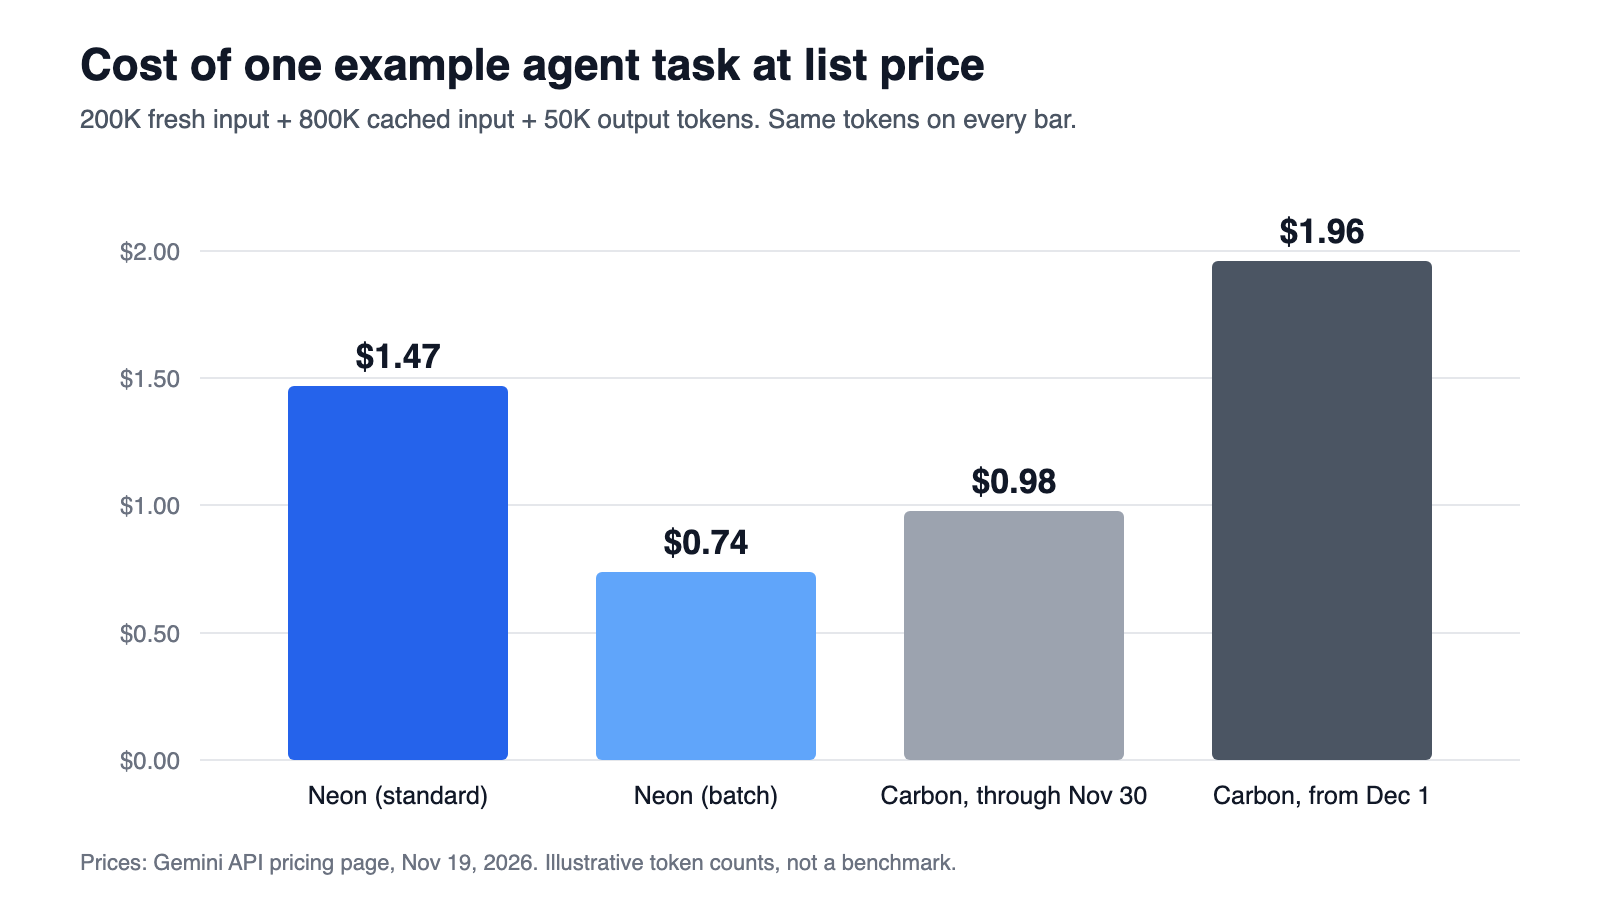
Voici un exemple chiffré avec des nombres ronds, pas un benchmark. Imaginez une session d'agent de codage qui envoie 200 K tokens d'entrée frais, obtient 800 K tokens de cache en relisant le dépôt et produit 50 K tokens de sortie, réflexion incluse.
| Modèle | Entrée fraîche | Entrée en cache | Sortie | Total |
|---|---|---|---|---|
| Neon (standard) | 0,60 $ | 0,12 $ | 0,75 $ | 1,47 $ |
| Neon (batch) | 0,30 $ | 0,06 $ | 0,375 $ | 0,74 $ |
| Carbon, jusqu'au 30 nov. | 0,40 $ | 0,08 $ | 0,50 $ | 0,98 $ |
| Carbon, à partir du 1er déc. | 0,80 $ | 0,16 $ | 1,00 $ | 1,96 $ |
À nombre de tokens identique, Neon perd face au tarif d'introduction de Carbon mais bat son tarif de décembre. La règle du point d'équilibre est simple. Face au tarif d'introduction, Neon doit terminer en consommant moins de 67 % des tokens de Carbon. Face au tarif de décembre, Neon reste moins cher tant qu'il n'a pas besoin de plus de 133 % des tokens de Carbon.
La sortie représente la moitié de la facture de Neon dans cet exemple, et les tokens de réflexion sont facturés comme de la sortie. C'est pourquoi le niveau de réflexion que vous choisissez influence le coût davantage que le tarif officiel.
Les niveaux de réflexion : le levier derrière le coût par tâche de Neon
Neon propose quatre niveaux de réflexion : low, medium, high (par défaut) et xhigh. Le guide de Google est limpide sur l'arbitrage : xhigh « augmente la latence et la consommation de tokens », et vous devriez « choisir le thinking_level le plus bas qui atteint votre seuil de qualité ».
Un routage adapté au travail des agents ressemble à ceci :
low: questions sur la base de code, résumés de diffs, notes de triage.medium: corrections ciblées où la suite de tests est le vrai juge.high: refontes, débogage et longues sessions d'appels d'outils. C'est ici que s'applique l'affirmation des 32 % de Google.xhigh: uniquement pour les tâches qui ont déjà échoué à la revue enhigh.
On le définit par requête dans le code :
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Find why test_checkout_retry flakes and propose a fix.",
    generation_config={"thinking_level": "medium"},
)

print(interaction.output_text)
Neon rejette l'ancien niveau minimal avec une erreur et ignore temperature, top_p et top_k. Google recommande également des timeouts côté client d'au moins 15 minutes pour les prompts difficiles — ce que les longues exécutions d'agents atteignent en premier.
Pourquoi le coût par tâche n'est toujours pas votre chiffre
Une tâche de benchmark se termine quand le grader la note. La vôtre se termine quand un humain fusionne le changement. Entre les deux se trouvent les tentatives, les diffs rejetés et le temps de revue — et aucun graphique de coût par tâche ne les montre.
Le chiffre qui correspond à votre budget, c'est le coût par changement accepté : la dépense totale du modèle sur une tâche, toutes tentatives confondues, divisée par les changements réellement livrés. Nous avons développé l'argument complet dans quand un modèle moins cher coûte plus cher. En résumé :
coût par changement accepté = coût par tentative / taux d'acceptation
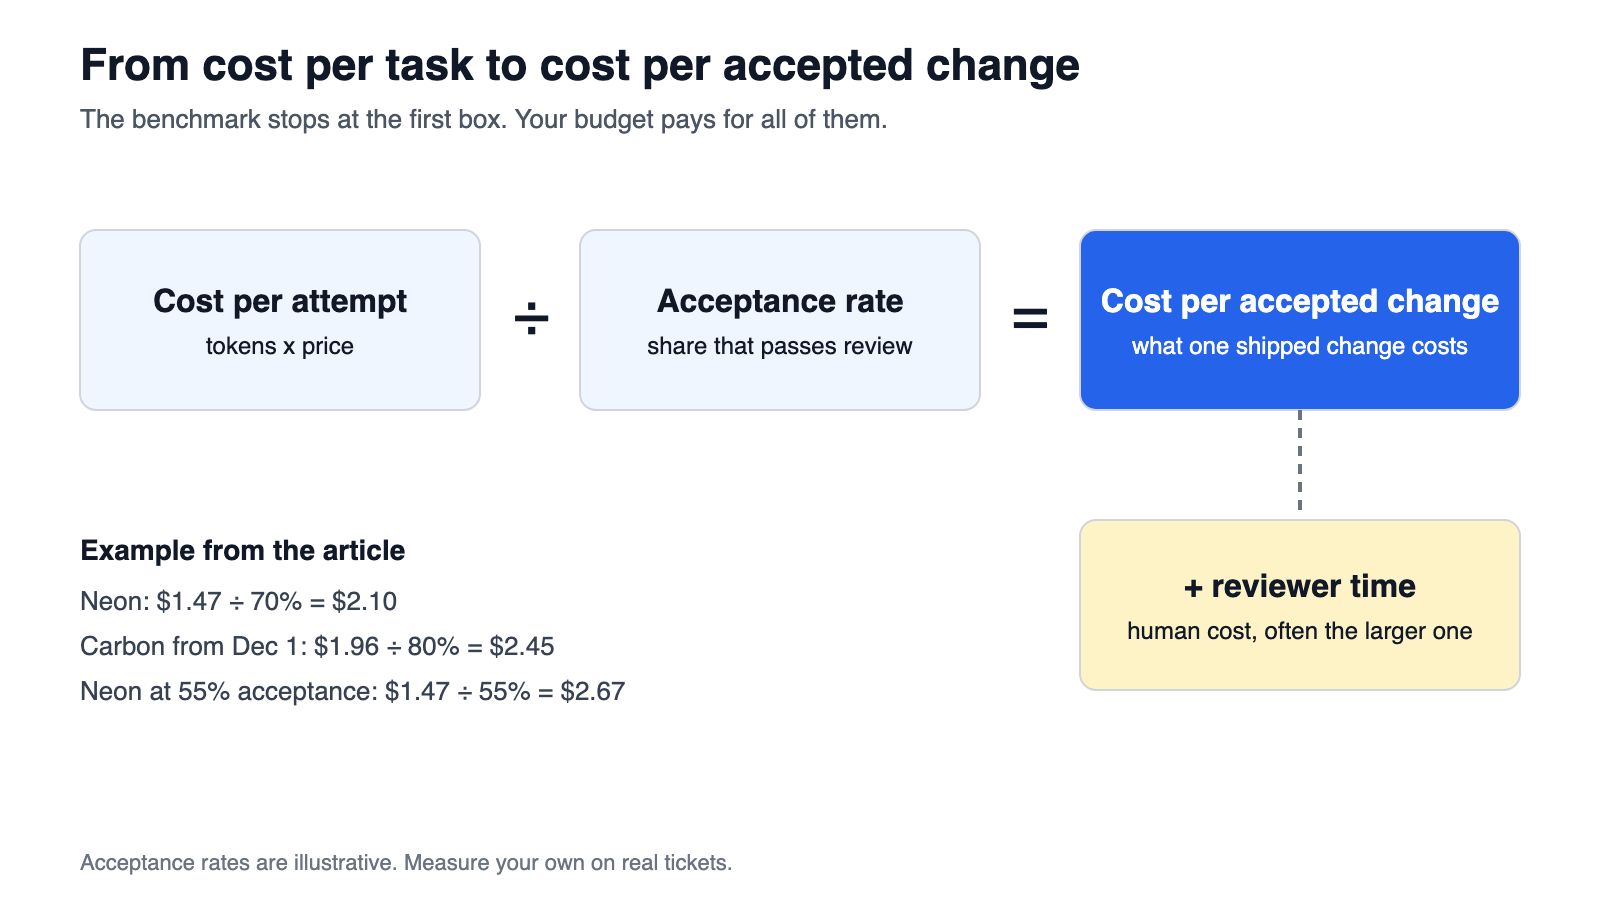
Reprenons l'exemple ci-dessus. Si Neon passe la revue à 70 % dès la première tentative, 1,47 $ par tentative devient 2,10 $ par changement accepté. Si Carbon, à son tarif de décembre, passe à 80 %, 1,96 $ devient 2,45 $. Neon gagne toujours. Mais si l'acceptation de Neon descend à 55 %, il coûte 2,67 $ par changement accepté, et Carbon l'emporte. Ce sont vos taux d'acceptation, et non le graphique de Google, qui décident du routage.
Le temps de revue se situe en dehors de cette formule et coûte généralement plus cher que les tokens. La revue humaine est le goulot d'étranglement pour les agents parallèles : moins de diffs rejetés, c'est l'élément le plus coûteux qu'on économise.
Comment tester Neon contre Carbon sur vos propres tâches
Vous n'avez pas besoin d'un nouveau benchmark. Vous avez besoin de deux semaines de tickets réels et d'un moyen de savoir quel modèle a fait quoi. Sharkly vous donne ce tableau : chaque tâche regroupe l'exécution de l'agent, son résultat et son statut de revue au même endroit.
- Choisissez 20 à 30 tâches ordinaires dans votre backlog : corrections de bugs, petites refontes, ajouts de tests.
- Créez deux Agents. Un Sharkly Agent suit le modèle par défaut de son Runtime et n'a pas de sélecteur de modèle, selon la documentation des Agents. Orientez donc chaque Agent vers un Runtime configuré avec un modèle différent : l'un sur
gemini-4-neon, l'autre surgemini-4-carbon. - Répartissez les tâches entre les deux Agents avec une difficulté similaire de chaque côté.
- Enregistrez trois chiffres par tâche : les tokens issus de votre consommation de l'API Gemini, le nombre de tentatives jusqu'à l'acceptation et les minutes de revue.
- Calculez le coût par changement accepté pour chaque modèle, aux deux tarifs de Carbon si votre test chevauche le 1er décembre.
Sharkly ne vend pas de tokens de modèle. Vos exécutions sont facturées sur la clé API Gemini déjà configurée sur le Runtime, ce qui garantit une comparaison honnête : rien dans la plateforme ne fausse le prix en faveur d'un modèle. Pour une vue d'ensemble, consultez pourquoi une plateforme d'agents ne devrait pas vous vendre de tokens et le suivi des dépenses entre Claude Code, Codex et Gemini.
Où Neon, Carbon et Hydrogen ont chacun leur place
La fiche technique de Google réserve Carbon aux « projets les plus difficiles, à long horizon » et Hydrogen à « l'exécution quotidienne rapide », avec Neon entre les deux. En matière de coût, cela donne trois voies à une équipe d'agents :
- Hydrogen à 1,50 $ / 7,50 $ pour le travail à haut volume et à faible risque. Voir Gemini 4 Hydrogen pour les agents de codage.
- Neon en
highcomme voie par défaut pour les tickets complexes, et comme chef d'orchestre qui dirige les sous-agents Hydrogen en parallèle. - Carbon pour le travail à long horizon où Neon échoue même en
xhigh. Notre revue de Carbon explique où il justifie son prix.
Le guide d'appariement Carbon et Hydrogen présente un tableau avec un planificateur et des travailleurs ; à partir du 1er décembre, Neon occupe le siège de planificateur pour moins cher. Pour le routage multi-fournisseurs, voir le routage de modèles pour les équipes d'agents.
Conclusion
À partir du 1er décembre, Gemini 4 Neon est moins cher que Carbon par tâche, quelle que soit la lecture des chiffres de Google. Avant cette date, tout dépend du tarif de Carbon qui se cache derrière le graphique des 32 %, et Google ne l'a pas précisé. De toute façon, le tarif officiel n'a jamais été le facteur décisif : ce sont les tokens par tâche, le niveau de réflexion et le taux d'acceptation.
Lancez le test de deux semaines sur votre propre backlog et chiffrez les deux modèles par changement accepté. Si vous utilisez déjà plusieurs agents de codage, Sharkly vous offre un tableau unique pour assigner les tâches, comparer les résultats des Agents et centraliser la revue dans une seule file. La documentation Sharkly vous guide pas à pas pour connecter un Computer et créer des Agents.
FAQ
Combien coûte Gemini 4 Neon ?
3 $ par million de tokens d'entrée, 15 $ par million de tokens de sortie (réflexion incluse) et 0,15 $ par million de tokens d'entrée en cache sur le tier payant de l'API Gemini. Le batch et Flex divisent ces prix par deux : 1,50 $ / 7,50 $. Il n'existe pas de tier API gratuit.
Gemini 4 Neon est-il moins cher que Gemini 4 Carbon ?
Par token, non jusqu'au 30 novembre (3 $ / 15 $ contre 2 $ / 10 $), et oui à partir du 1er décembre (3 $ / 15 $ contre 4 $ / 20 $). Par tâche, Google indique que Neon en high est 32 % moins cher que Carbon, sans préciser quel tarif de Carbon il a utilisé.
Gemini 4 Neon propose-t-il un tier gratuit ?
Non. La page de tarification indique « Non disponible » pour le tier gratuit de Neon à tous les niveaux de service. Gemini 4 Hydrogen en propose un, lui.
Les tokens de réflexion sont-ils facturés pour Gemini 4 Neon ?
Oui. Google facture les tokens de réflexion au tarif de sortie de 15 $ par million, ainsi que les déclarations de fonctions et les instructions système de grounding. Baisser le thinking_level est le principal levier pour réduire la consommation de tokens.
Quel niveau de réflexion est le plus économique pour les agents de codage ?
low consomme le moins de tokens et xhigh le plus. Google recommande de tester les quatre niveaux sur votre jeu d'évaluation et de choisir le plus bas qui atteint votre seuil de qualité. Commencez par high pour les changements de code complexes.
Quand le prix de Gemini 4 Carbon augmente-t-il ?
Le 1er décembre 2026. L'entrée passe de 2 $ à 4 $ par million de tokens et la sortie de 10 $ à 20 $, selon la page de tarification de l'API Gemini.


