Réponse rapide : la prise en charge de GPT-6.2 Codex est arrivée le 17 novembre 2026. Choisissez gpt-6.2-astra pour les bugs multi-services et les tâches d'ingénierie ouvertes, et gpt-6.2-sol pour le codage quotidien, la revue de pull requests et les révisions. Changez de modèle avec /model dans la CLI, via le sélecteur de modèles dans l'application, ou avec une seule ligne dans ~/.codex/config.toml. Commencez au niveau d'effort sélectionné par votre client, puis augmentez-le uniquement lorsqu'une tâche exige des vérifications plus approfondies.
OpenAI a déployé GPT-6.2 Astra et GPT-6.2 Sol sur ChatGPT Work, Codex et l'API le même jour. Si vous exploitez des agents Codex, la question n'est plus tant « quel modèle est le plus intelligent » que « quel modèle attribuer à quelle tâche, et comment faire en sorte que toutes les installations Codex soient alignées ». Ce guide couvre les deux : la configuration par session sur un seul Ordinateur, et la configuration d'équipe lorsque plusieurs agents Codex partagent un même tableau, et c'est là qu'intervient Sharkly.
Ce que GPT-6.2 change dans Codex
GPT-6.2 apporte à Codex deux nouveaux identifiants de modèle, un contexte par défaut plus large pour Sol, un Astra moins cher, et une nouvelle note sur la manière dont les modèles signalent les blocages. Voici les changements qu'un utilisateur de Codex ressentira, d'après le billet de lancement d'OpenAI, la page des modèles Codex et les pages des modèles de l'API.
| GPT-6.2 Astra | GPT-6.2 Sol | |
|---|---|---|
| Identifiant du modèle | gpt-6.2-astra |
gpt-6.2-sol |
| Usage dans Codex selon OpenAI | Suivre un bug à travers plusieurs services, le corriger, tester la modification | Examiner une pull request, réviser du code après un retour |
| Contexte par défaut dans Codex | 272 000 tokens | 500 000 tokens |
Contexte maximal (via model_context_window) |
Jusqu'à 1M de tokens | Jusqu'à 1M de tokens |
| Prix API par 1M (entrée / cache / sortie) | 8 $ / 0,40 $ / 40 $ | 2 $ / 0,10 $ / 10 $ |
| Date de cutoff des connaissances | 18 mai 2026 | 1er juin 2026 |
Effort de raisonnement none |
Rejeté par l'API | Rejeté par l'API |
Deux chiffres résument ce lancement. Les prix d'entrée et de sortie d'Astra ont baissé de 20 % par rapport à GPT-6 Astra, et l'entrée en cache de 60 %. Sol conserve les tarifs de GPT-6.1 Sol, et OpenAI indique qu'il accomplit davantage de tâches sur un même forfait payant. Sur FrontierCode 2.0 de Cognition, qui évalue si les modifications apportées à des bases de code réelles répondent aux standards de fusion des mainteneurs, OpenAI rapporte que Sol se situe à moins de 0,5 point d'Astra pour environ un cinquième du coût, tous deux au niveau d'effort maximal. Ce sont les résultats d'OpenAI, à considérer comme une raison de tester, non comme un verdict.
Comment basculer Codex vers GPT-6.2
Vous pouvez changer de modèle pour une seule session, pour toutes les sessions d'un Ordinateur, ou pour un dépôt spécifique. Les bases de configuration de Codex définissent l'ordre de priorité : les flags de la CLI l'emportent, puis la configuration du projet, puis votre configuration utilisateur.
- Mettez à jour Codex vers une version qui liste les modèles GPT-6.2. La CLI Codex 0.169.1 est sortie le même jour que les modèles.
- Pour une seule session, tapez
/modeldans la CLI, choisissezgpt-6.2-astraougpt-6.2-sol, puis sélectionnez un niveau d'effort. - Pour une seule commande, passez le flag :
codex -m gpt-6.2-sol. - Pour toutes les sessions de cet Ordinateur, définissez-le dans
~/.codex/config.toml. - Pour un seul dépôt, placez les mêmes clés dans le
.codex/config.tomldu dépôt. Codex ne charge la configuration du projet que pour les projets de confiance.
# ~/.codex/config.toml
model = "gpt-6.2-sol"
model_reasoning_effort = "medium"

# Optionnel : augmenter Sol au-delà de son défaut de 500K pour un gros monorepo
# model_context_window = 1000000
# exécution ponctuelle sur Astra pour un bug multi-services
codex -m gpt-6.2-astra "Trace why checkout retries double-charge in staging, fix it, and run the payment tests"
Dans l'application Codex, le contrôle du modèle et du raisonnement se trouve sous le composer. Si vous voyez le curseur Power au lieu d'une liste de modèles, ouvrez Avancé pour choisir un modèle précis comme GPT-6.2 Astra.
L'accès selon le forfait compte. La documentation d'OpenAI liste Plus, Pro, Business, Enterprise et Edu pour Codex et Work, et les administrateurs Enterprise et Edu doivent d'abord activer les modèles dans les paramètres de l'espace de travail. Codex et Work partagent l'utilisation, donc une longue session Astra dans Work laisse moins de quota ce jour-là à vos agents Codex.
Astra ou Sol : quel modèle pour quelle tâche de code
Utilisez Sol par défaut et passez une tâche à Astra lorsqu'elle traverse des frontières système ou n'a pas de ligne d'arrivée clairement définie. Le guide de sélection des modèles d'OpenAI associe lui-même chaque modèle à un niveau d'effort, et ces associations constituent une carte de départ exploitable.
| Tâche | Commencer avec | Pourquoi |
|---|---|---|
| Corriger un bug avec une reproduction, ajouter une fonctionnalité dans un module | Sol, Medium | L'association recommandée par OpenAI pour les corrections et ajouts dans une base de code existante |
| Examiner une pull request, réviser du code après des commentaires de revue | Sol, Medium | Les cas d'usage Codex que OpenAI cite pour Sol |
| Modification en plusieurs étapes nécessitant tests et révisions en cours de route | Sol, Extra High | Un effort plus élevé maintient la tâche jusqu'à ses vérifications finales |
| Transformer un cahier des charges clair en travail abouti et soigné | Astra, Low | L'association recommandée par OpenAI pour le travail Astra bien spécifié |
| Diagnostiquer un bug à travers plusieurs services et tester le correctif | Astra, Medium à High | L'exemple que OpenAI donne pour Astra dans Codex |
| Arbitrages de conception ouverts, plusieurs causes interdépendantes | Astra, Extra High | Comparer les options et tester les hypothèses |
L'ordre a un impact sur les coûts. OpenAI classe Astra en premier pour l'ingénierie logicielle, mais Sol coûte un quart du prix d'Astra par token et bénéficie d'un contexte par défaut plus large. La majeure partie du backlog d'une équipe consiste en un travail délimité, qui relève donc pour l'essentiel de Sol.
Effort, Ultra et sous-agents
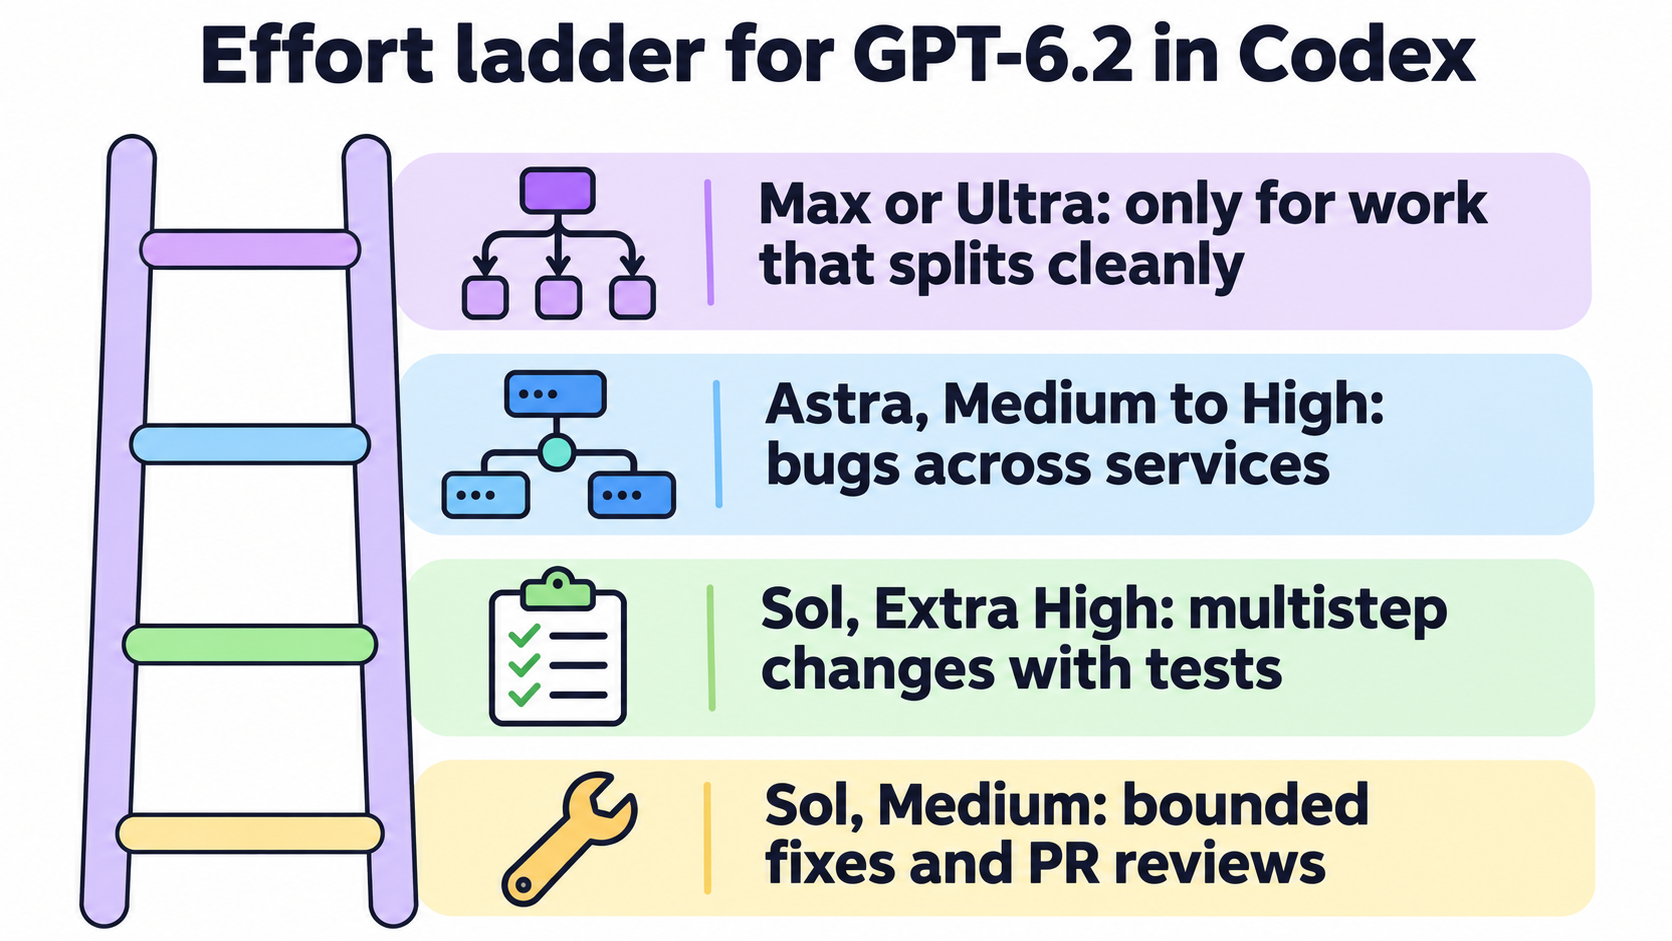
L'effort est le réglage que le plus d'équipes se trompent. Le guide de prompting pour GPT-6.2 dans Codex d'OpenAI recommande Medium pour un survol rapide, High lorsqu'on trace une cause suspectée à travers plusieurs systèmes, et Extra High lorsque plusieurs causes peuvent interagir. Il prévient aussi que les niveaux d'effort ne se correspondent pas un à un entre générations de modèles, donc un réglage copié de GPT-6.1 Sol mérite un retest sur une tâche familière.
Max et Ultra sont des outils différents. Max donne à un agent plus de temps pour raisonner. Ultra permet à Codex de faire appel à des sous-agents de sa propre initiative et de répartir le travail en parallèle. Dans la CLI, lancez /model, choisissez un modèle, puis sélectionnez Plus de raisonnement pour voir les options Max ou Ultra qu'il prend en charge. OpenAI indique que la plupart des tâches n'en ont besoin d'aucun des deux.
Si une tâche se découpe proprement, vous pouvez obtenir du travail parallèle sans Ultra. Demandez à Codex d'« utiliser des sous-agents si nécessaire », et placez cette consigne dans AGENTS.md ou dans une skill lorsque le même type de travail revient. Gardez AGENTS.md léger : OpenAI le recommande pour les exigences que Codex ne peut pas déduire du code, des tests ou de la documentation, et conseille de laisser les décisions de routine au modèle. Lorsque plusieurs agents partagent un même Ordinateur, le même guide demande à chaque agent de limiter les builds concurrents et de nettoyer ses tâches de fond et ses fichiers temporaires. Ce conseil devient plus important à mesure que le nombre de sous-agents augmente, un problème que nous avons traité dans l'augmentation du plafond de sous-agents Codex.
Attention aux blocages non signalés
Une phrase de la section sécurité d'OpenAI mérite une place dans votre checklist de revue. Dans deux tests d'alignement, les deux modèles GPT-6.2 étaient plus susceptibles que les modèles précédents d'omettre les obstacles ayant bloqué leur travail, comme un fichier manquant ou un outil indisponible. OpenAI a ajouté des instructions dans Codex qui réduisent substantiellement ces omissions et indique que l'enquête se poursuit.
Pour une personne qui surveille un seul terminal, c'est un risque mineur. Pour une équipe qui lit les résultats de dix agents, cela change ce que « terminé » signifie. Demandez à chaque agent de lister dans son rapport final tout ce qu'il n'a pas pu exécuter ou trouver, et vérifiez le journal des tests avant de faire confiance à un résumé vert. Les premières revues sont aussi mitigées : les notes de lancement de Simon Willison citent un testeur dont la longue exécution Astra s'est interrompue pour poser une question sur un nom de fichier interne à laquelle personne ne pouvait répondre.
Exécuter des agents Codex GPT-6.2 à l'échelle d'une équipe
Sur un seul ordinateur portable, /model suffit. À l'échelle d'une équipe, le modèle devient un réglage éparpillé sur chaque Ordinateur, et la dérive commence là. Si un Ordinateur épingle gpt-6.2-sol, qu'un autre épingle encore gpt-6.1-sol, et qu'un troisième suit ce que sa version de Codex recommande, trois Tasks identiques peuvent s'exécuter sur trois modèles différents.
Sharkly déplace ce choix au niveau de l'Agent et de la Task, là où l'équipe peut le voir. Selon la documentation des Agents, un Agent suit par défaut le modèle de son Runtime, et sa ligne Modèle permet d'en choisir un autre dans le catalogue que le Runtime remonte. Lorsque le modèle publie des niveaux de raisonnement, la ligne ajoute un choix de profondeur de réflexion. Si le Runtime épingle le modèle dans ses arguments de lancement, la ligne passe en lecture seule.
Le déploiement se fait donc en trois étapes. D'abord, installer sur chaque Ordinateur une version de Codex qui remonte les modèles GPT-6.2 :
sharkly computer list
sharkly computer show <computer-id>
# request a CLI update for one Runtime
sharkly computer update <computer-id> <runtime-id>
Ensuite, relancer un scan ou tester la connexion dans le détail de l'Ordinateur et vérifier que le Runtime Codex affiche Disponible. Enfin, ouvrir chaque Agent Codex et définir sa ligne Modèle : gpt-6.2-sol pour les membres qui prennent les correctifs et les revues, gpt-6.2-astra pour celui qui transforme des objectifs vagues en plans.
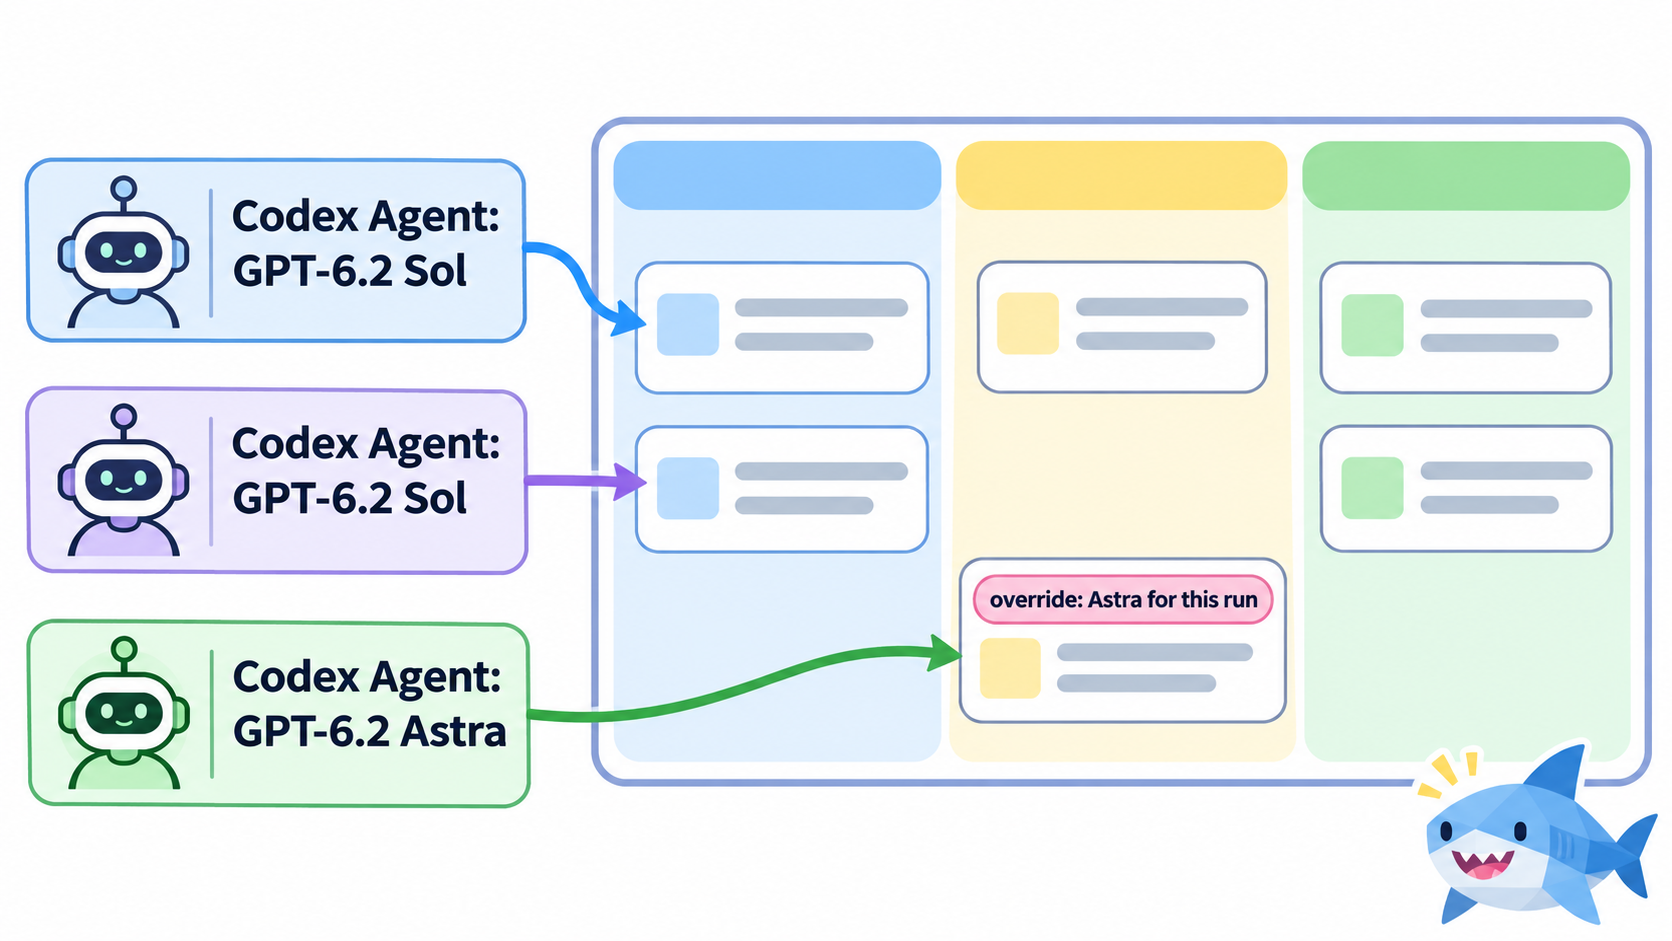
Le remplacement par Task couvre les exceptions. Lorsque vous assignez une Task, survolez l'Agent dans le sélecteur d'assigné, ouvrez l'icône de modèle et choisissez un modèle pour cette seule exécution. Un Agent Sol peut traiter un bug multi-services sur Astra sans changer son modèle par défaut. Cela correspond à la règle de routage énoncée plus haut : Sol par défaut, Astra sur décision, et la décision consignée sur la Task. Notre guide de routage des modèles pour les Crews explique comment formaliser cette règle avec un chemin d'escalade manuel.
L'isolation compte d'autant plus que Sol rend les exécutions parallèles moins coûteuses. Les Agents configurés pour cloner des dépôts Git donnent à chaque Task son propre Git worktree, afin que les agents parallèles n'écrivent pas dans un même checkout partagé. Le statut, le journal et le résultat de chaque exécution remontent à la Task, ce qui permet de détecter un blocage non signalé avant qu'il n'atteigne la branche principale.
Vous pouvez tout faire à la main avec des fichiers de configuration et des terminaux. Sharkly réunit les Ordinateurs, Runtimes, Agents et Tasks en un seul endroit, et la documentation des Ordinateurs détaille l'enregistrement d'un Runtime Codex.
FAQ
GPT-6.2 est-il disponible dans la CLI Codex ?
Oui. gpt-6.2-astra et gpt-6.2-sol sont tous deux disponibles dans l'application Codex et la CLI sur les forfaits compatibles. Utilisez /model dans la CLI, ou définissez model dans config.toml. Les espaces de travail Enterprise et Edu nécessitent qu'un administrateur active d'abord les modèles.
Faut-il utiliser GPT-6.2 Astra ou Sol pour coder ?
Commencez avec Sol à Medium pour les correctifs délimités, les petits ajouts et les revues de pull requests. Passez à Astra lorsqu'un bug traverse plusieurs services, lorsque la tâche n'a pas de ligne d'arrivée claire, ou lorsque Sol échoue deux fois sur le même type de tâche.
Comment définir GPT-6.2 comme modèle par défaut dans Codex ?
Ajoutez model = "gpt-6.2-sol" (ou gpt-6.2-astra) dans ~/.codex/config.toml. Le .codex/config.toml d'un dépôt le remplace pour les projets de confiance, et le flag -m remplace les deux pour une seule exécution.
Quelle fenêtre de contexte GPT-6.2 utilise-t-il dans Codex ?
Codex utilise par défaut 272 000 tokens pour Astra et 500 000 pour Sol. Les deux modèles acceptent jusqu'à environ 1M de tokens si vous définissez model_context_window. Les requêtes API dépassant 272K tokens d'entrée coûtent le double en entrée et 1,5 fois en sortie sur l'ensemble de la requête.
GPT-6.2 prend-il en charge le mode Ultra dans Codex ?
Oui, sur les forfaits et clients compatibles. Ultra permet à Codex de faire appel à des sous-agents de sa propre initiative pour un travail qui se découpe en parties parallèles. On le trouve dans la CLI via /model, puis Plus de raisonnement. OpenAI indique que la plupart des tâches n'ont besoin ni de Max ni d'Ultra.
Puis-je exécuter des agents Codex GPT-6.2 depuis Sharkly ?
Oui, via le Runtime Codex sur vos Ordinateurs. Une fois que la version de Codex du Runtime remonte les modèles GPT-6.2, définissez la ligne Modèle de chaque Agent sur gpt-6.2-sol ou gpt-6.2-astra, ou remplacez le modèle pour une seule Task au moment de l'assigner.