Réponse rapide : le code généré par l’IA doit-il être open source ? Aucune règle juridique ne l’impose. L’argument en faveur repose sur deux points : les modèles ont appris à partir de code open source, et le code écrit entièrement par une IA pourrait ne pas être protégé par le droit d’auteur. Quel que soit votre camp, votre équipe a d’abord besoin de la même chose : une trace de quel agent a écrit quoi, à partir de quelle tâche, et qui l’a relue.
Le 17 novembre 2026, un billet intitulé « All AI-generated code should be Open Source » s’est retrouvé en tête de Hacker News avec plus de 1 200 points et 650 commentaires. Le fil est animé, mais la question qui s’y cache est très concrète. Si vos agents écrivent une part croissante de votre base de code, à qui appartient ce code, sous quelle licence, et qui en répond quand il casse ?
Ce que dit l’argument « le code généré par l’IA doit être open source »
L’argument en faveur de l’open source pour le code généré par l’IA mêle un volet éthique et un volet juridique : les modèles ont été entraînés sur du code open source et Creative Commons, donc garder leurs sorties fermées revient à blanchir ces licences ; et le code sans auteur humain pourrait de toute façon ne pas être protégé par le droit d’auteur, donc il devrait être publié sous une licence ouverte ou sous CC0.
Le billet de Jakub Jankiewicz avance quatre arguments :
- Les données d’entraînement. Les modèles ont appris de décennies de code open source et de réponses Stack Overflow, qui sont sous licences Creative Commons exigeant une attribution. En faire du code fermé « ressemble à du blanchiment de licences », selon ses mots.
- La paternité. Le code purement généré par l’IA n’a pas d’auteur humain, donc il ne devrait pas être protégé par le droit d’auteur. Il cite le différend du selfie de singe et la position du Copyright Office américain sur l’IA.
- La juridiction. Certains pays, comme le Royaume-Uni, accordent une protection limitée aux œuvres générées par ordinateur ; les règles ne sont donc pas uniformes.
- Le remède. Les développeurs devraient publier le code généré par l’IA sous une licence open source ou le placer dans le domaine public via CC0, du moins lorsque les humains n’ont fait guère plus que rédiger des prompts.
Ce dernier point est le plus important pour les équipes : il vise le code que personne n’a relu ni modifié, pas le code qu’un humain a conçu et qu’un agent a tapé.
Droit d’auteur et code généré par l’IA : où en est la loi
La moitié juridique de l’argument trouve un réel appui aux États-Unis, et un soutien plus faible ailleurs.
En janvier 2025, le Copyright Office américain a publié la partie 2 de son rapport sur l’IA, consacrée à la protégeabilité par le droit d’auteur. Sa position : le droit d’auteur exige une paternité humaine, les prompts seuls ne confèrent généralement pas un contrôle suffisant sur la sortie, et les contributions humaines telles que la sélection, l’agencement ou la modification de la sortie peuvent rester protégées. En mars 2025, la cour d’appel du circuit de D.C. a confirmé dans Thaler v. Perlmutter que le Copyright Act exige un auteur humain.
Le Royaume-Uni suit une logique différente. La section 9(3) du Copyright, Designs and Patents Act 1988 considère que l’auteur d’une œuvre générée par ordinateur est la personne qui a pris les dispositions nécessaires à sa création.
Aux États-Unis, un fichier produit par un agent sans modifications humaines significatives peut donc bénéficier d’une protection faible, voire inexistante, par le droit d’auteur. Un fichier qu’un développeur a restructuré, allégé et étendu en bénéficie probablement. La plupart du code en production se situe entre les deux, et la frontière passe par votre processus de relecture.
Les contre-arguments, côte à côte
Les objections les plus fortes du fil ne disent pas « l’auteur se trompe sur le droit ». Elles portent sur ce qui en découle.
| L’argument | Le contre-argument |
|---|---|
| Les modèles sont entraînés sur de l’open source, donc la sortie devrait être ouverte | Les litiges sur les données d’entraînement sont portés devant les tribunaux ; une licence sur la sortie ne les tranche pas |
| Le code non protégeable devrait être publié | Non protégeable ne signifie pas publié ; rien dans le rapport du Copyright Office n’oblige à publier le code |
| Le code produit avec peu d’effort ne mérite aucune protection | Quasi aucun code en production ne sort de nulle part : spécifications, relecture, tests et modifications sont du travail humain |
| Les licences ouvertes honorent le bien commun | Un CC0 systématique peut faire perdre leur protection aux contributions humaines mélangées dans le même fichier |
| La règle devrait être uniforme d’un pays à l’autre | Le droit d’auteur est national ; la règle britannique évoquée plus haut diffère déjà de la règle américaine |
Notez ce que les deux colonnes supposent. Chaque ligne repose sur la connaissance de la part d’un changement donnée provenant d’un agent et de celle façonnée par un humain. Impossible de choisir une politique de licence, de répondre à la question d’un client sur la provenance ou de défendre une paternité sans cette trace.
Qui est responsable du code écrit par les agents ?
Le débat sur les licences reste ouvert. La responsabilité, non. La personne qui a fusionné le changement en est propriétaire, peu importe qui a écrit le premier jet.
C’est l’idée centrale de notre billet sur la propriété humaine du travail des agents. Un bug dans du code écrit par un agent reste votre bug. Un secret divulgué dans la pull request d’un agent reste votre incident.
Les agents recherchent, exécutent, testent et rendent compte. Les humains fixent la direction, accordent les autorisations et acceptent le résultat. Le débat sur l’open source ne change pas cette répartition ; il augmente le coût de la perdre de vue.
Traçabilité du code généré par l’IA : quoi enregistrer
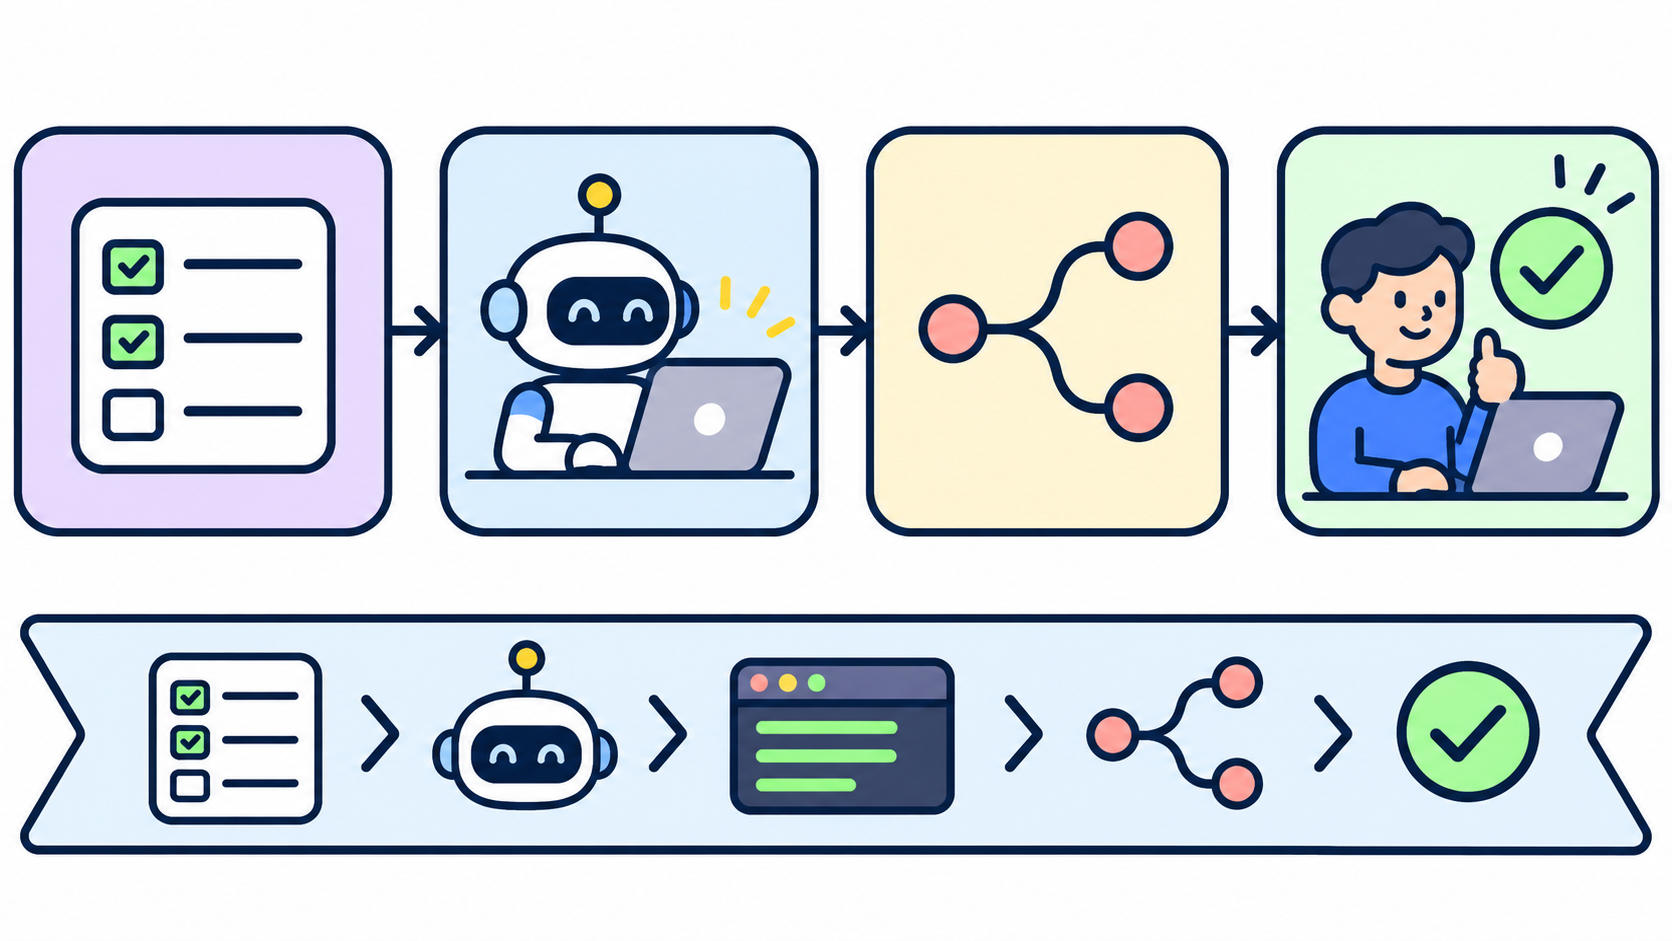
La traçabilité (provenance) est l’enregistrement de l’origine d’un changement. Pour le code écrit par des agents, une trace utile répond à six questions :
- Quelle tâche a demandé le changement, avec son exigence et ses critères d’acceptation.
- Quel agent a fait le travail, et sur quel runtime et quel modèle.
- Quelle exécution l’a produit, avec heure de début, heure de fin et source du déclencheur.
- Quelle pull request l’a intégrée au dépôt.
- Qui l’a relue, et ce qu’elle a modifié avant de l’accepter.
- Quelle licence le dépôt applique à ce code.
La plupart des équipes possèdent déjà des morceaux de ce tableau. La pull request contient le diff et le relecteur. Git peut transporter des métadonnées structurées via les commit trailers. Certains agents de code, dont Claude Code, ajoutent par défaut un trailer de co-auteur, et vous pouvez étendre cette convention avec vos propres clés :
fix(auth): return 401 instead of 500 on expired refresh token

Refresh tokens past their TTL threw an unhandled TokenExpiredError
in the session middleware. Map it to a 401 with a retry hint.

Co-Authored-By: Claude <[email protected]>
Agent-Task: COIN-1287
Agent-Run: 3f9c2a71-0b4e-4c8a-9d51-6e2f4b7a1c09
Reviewed-By: Priya Shah
Human-Edits: renamed handler, added regression test
Les trailers voyagent avec le commit, donc ils survivent aux migrations de dépôt. Ce qu’ils ne peuvent pas contenir, c’est l’exécution elle-même : les appels d’outils, les tentatives échouées, les discussions à l’origine de la forme finale.
Pour suivre les licences au niveau du fichier, les identifiants SPDX et les conventions REUSE donnent à chaque fichier un en-tête de licence vérifiable par des outils. Si votre équipe décide que certains actifs générés sortent sous CC0, c’est là que cette décision devient contrôlable.
Comment Sharkly conserve la trace au niveau de la tâche
Sharkly est un système de gestion du travail pour les humains et les agents de code. Vous assignez une tâche à un agent comme vous l’assigneriez à une personne, et la tâche reste l’enregistrement partagé de l’équipe.
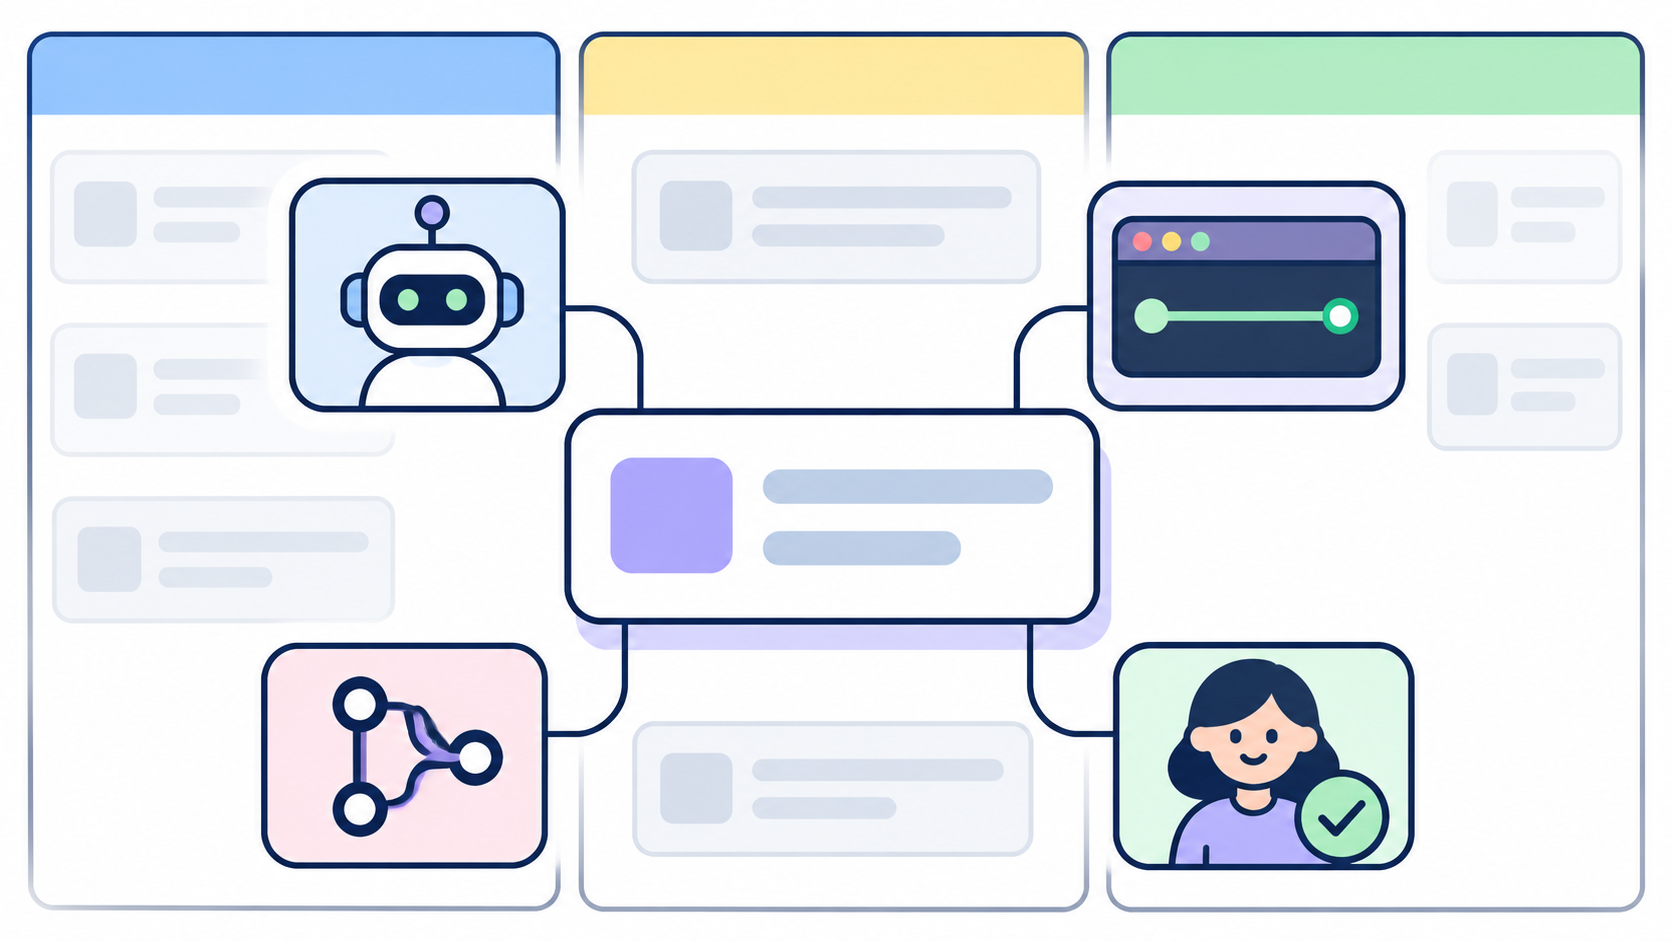
Cet enregistrement constitue la piste de traçabilité qui manque à la plupart des équipes :
- La tâche contient l’exigence, l’assigné, les commentaires, les pièces jointes et une chronologie d’activité des changements de la tâche.
- Le journal d’exécution montre, pour chaque exécution, pourquoi elle a été mise en file, quand elle a commencé et s’est terminée, les appels d’outils et les événements du runtime, la source du déclencheur et tout détail d’échec, comme le décrivent les docs d’exécution des tâches.
- Les commentaires d’agent destinés à l’équipe sont enregistrés comme des commentaires liés à l’exécution, pour que l’explication soit à côté de la preuve.
- Les signaux de relecture : un agent peut laisser une tâche en attente de relecture humaine, ce qui la route vers la personne responsable au lieu d’une fusion silencieuse.
- Les liens vers les pull requests : l’intégration GitHub lie les pull requests et synchronise les issues dans un Space, pour que le changement de code et la tâche se désignent mutuellement.
Sharkly ne décide pas de votre licence et n’est pas un produit de conformité. Il conserve au même endroit les faits dont dépend une décision de licence, au lieu de sessions de terminal privées.
Une politique de traçabilité à adopter dès cette semaine
Utilisez la politique la plus légère qui réponde aux six questions ci-dessus. Commencez par ceci :
- Une tâche par changement d’agent. Pas de travail d’agent sans identifiant de tâche. Le chat informel convient pour explorer ; tout ce qui part en production reçoit une tâche.
- Mettez l’identifiant de tâche dans la branche et le commit. Un trailer ou un préfixe de branche suffit pour retrouver l’information plus tard.
- Exigez un relecteur humain nommé. Le nom du relecteur figure sur la pull request et la tâche, et ses modifications sont notées.
- Écrivez une ligne de licence par dépôt. Décidez si le code écrit par les agents suit la licence existante du dépôt (le défaut pour la plupart des équipes) ou autre chose, et écrivez-le dans
CONTRIBUTING.md. - Étiquetez les fichiers dont la licence diffère. Utilisez des en-têtes SPDX si vous choisissez CC0 ou une autre licence pour les actifs générés.
- Conservez les journaux d’exécution aussi longtemps que les pull requests. Si vous gardez le fil de relecture, gardez l’exécution qui a produit le diff.
Pour aller plus loin sur la relecture, consultez comment relire du code généré par l’IA avec des preuves au niveau de la tâche et où placer les portes d’approbation pour les agents de code.
Utilisez une politique légère quand les agents ne touchent qu’à des outils internes et des tests. Utilisez les six étapes complètes quand le code d’un agent part chez les clients, tourne dans des environnements réglementés ou atterrit dans un dépôt que vous publiez déjà sous licence open source.
Votre équipe doit-elle rendre open source le code écrit par ses agents ?
Probablement pas par défaut, et pas seulement à cause de ce fil. Le droit évolue encore, la plupart des sorties d’agents dans un flux avec relecture comportent une véritable contribution humaine, et une publication CC0 systématique peut donner plus que prévu.
La meilleure approche est de rendre la question répondable. Quand un client ou votre équipe juridique demande « quelle part de ceci a été écrite par un agent, et qui l’a vérifiée », vous ouvrez un enregistrement et montrez la tâche, l’exécution, la pull request et le relecteur.
Si vous utilisez déjà Claude Code, Codex ou un autre agent de code, connectez un Computer à Sharkly, assignez une tâche à faible risque à un agent et voyez ce que montre l’enregistrement de la tâche une fois l’exécution terminée. Cet enregistrement est votre piste de traçabilité, quel que soit l’issue du débat sur l’open source.
FAQ
Le code généré par l’IA est-il protégeable par le droit d’auteur ?
Aux États-Unis, le code produit par une IA sans contribution humaine significative n’est probablement pas protégeable, selon le rapport 2025 du Copyright Office et l’affaire Thaler v. Perlmutter. La sélection, l’agencement et la modification humains de la sortie peuvent rester protégés. D’autres pays, dont le Royaume-Uni, traitent les œuvres générées par ordinateur différemment.
Suis-je obligé de rendre open source le code écrit par un agent d’IA ?
Aucune loi ne l’exige. Le billet de Hacker News soutient qu’on devrait le faire pour des raisons éthiques. Le code non protégeable n’est pas automatiquement public ; vous pouvez tout à fait le garder privé.
Qui est responsable des bugs dans le code généré par l’IA ?
L’équipe qui l’a fusionné. Un agent peut écrire le changement, mais la personne qui a accepté la pull request est responsable du résultat. Enregistrez cette personne sur la tâche et la pull request.
Comment suivre quel code a été écrit par un agent d’IA ?
Liez chaque changement d’agent à une tâche, ajoutez les identifiants de tâche et d’exécution en commit trailers, reliez la pull request à la tâche et enregistrez le relecteur humain. Un tableau de tâches qui conserve le journal d’exécution de l’agent fait le reste.
CC0 a-t-il du sens pour le code généré par l’IA ?
Cela peut être le cas pour des actifs générés clairement séparables, comme des fixtures ou du scaffolding. Appliquer CC0 à des fichiers mixtes risque de libérer aussi les parties écrites par des humains ; étiquetez plutôt ces fichiers avec des en-têtes SPDX au lieu de relicencer des dépôts entiers.